
JVM 笔记
JVM内存模型
以HotSpot JVM举例。
1.7

1.8
注意
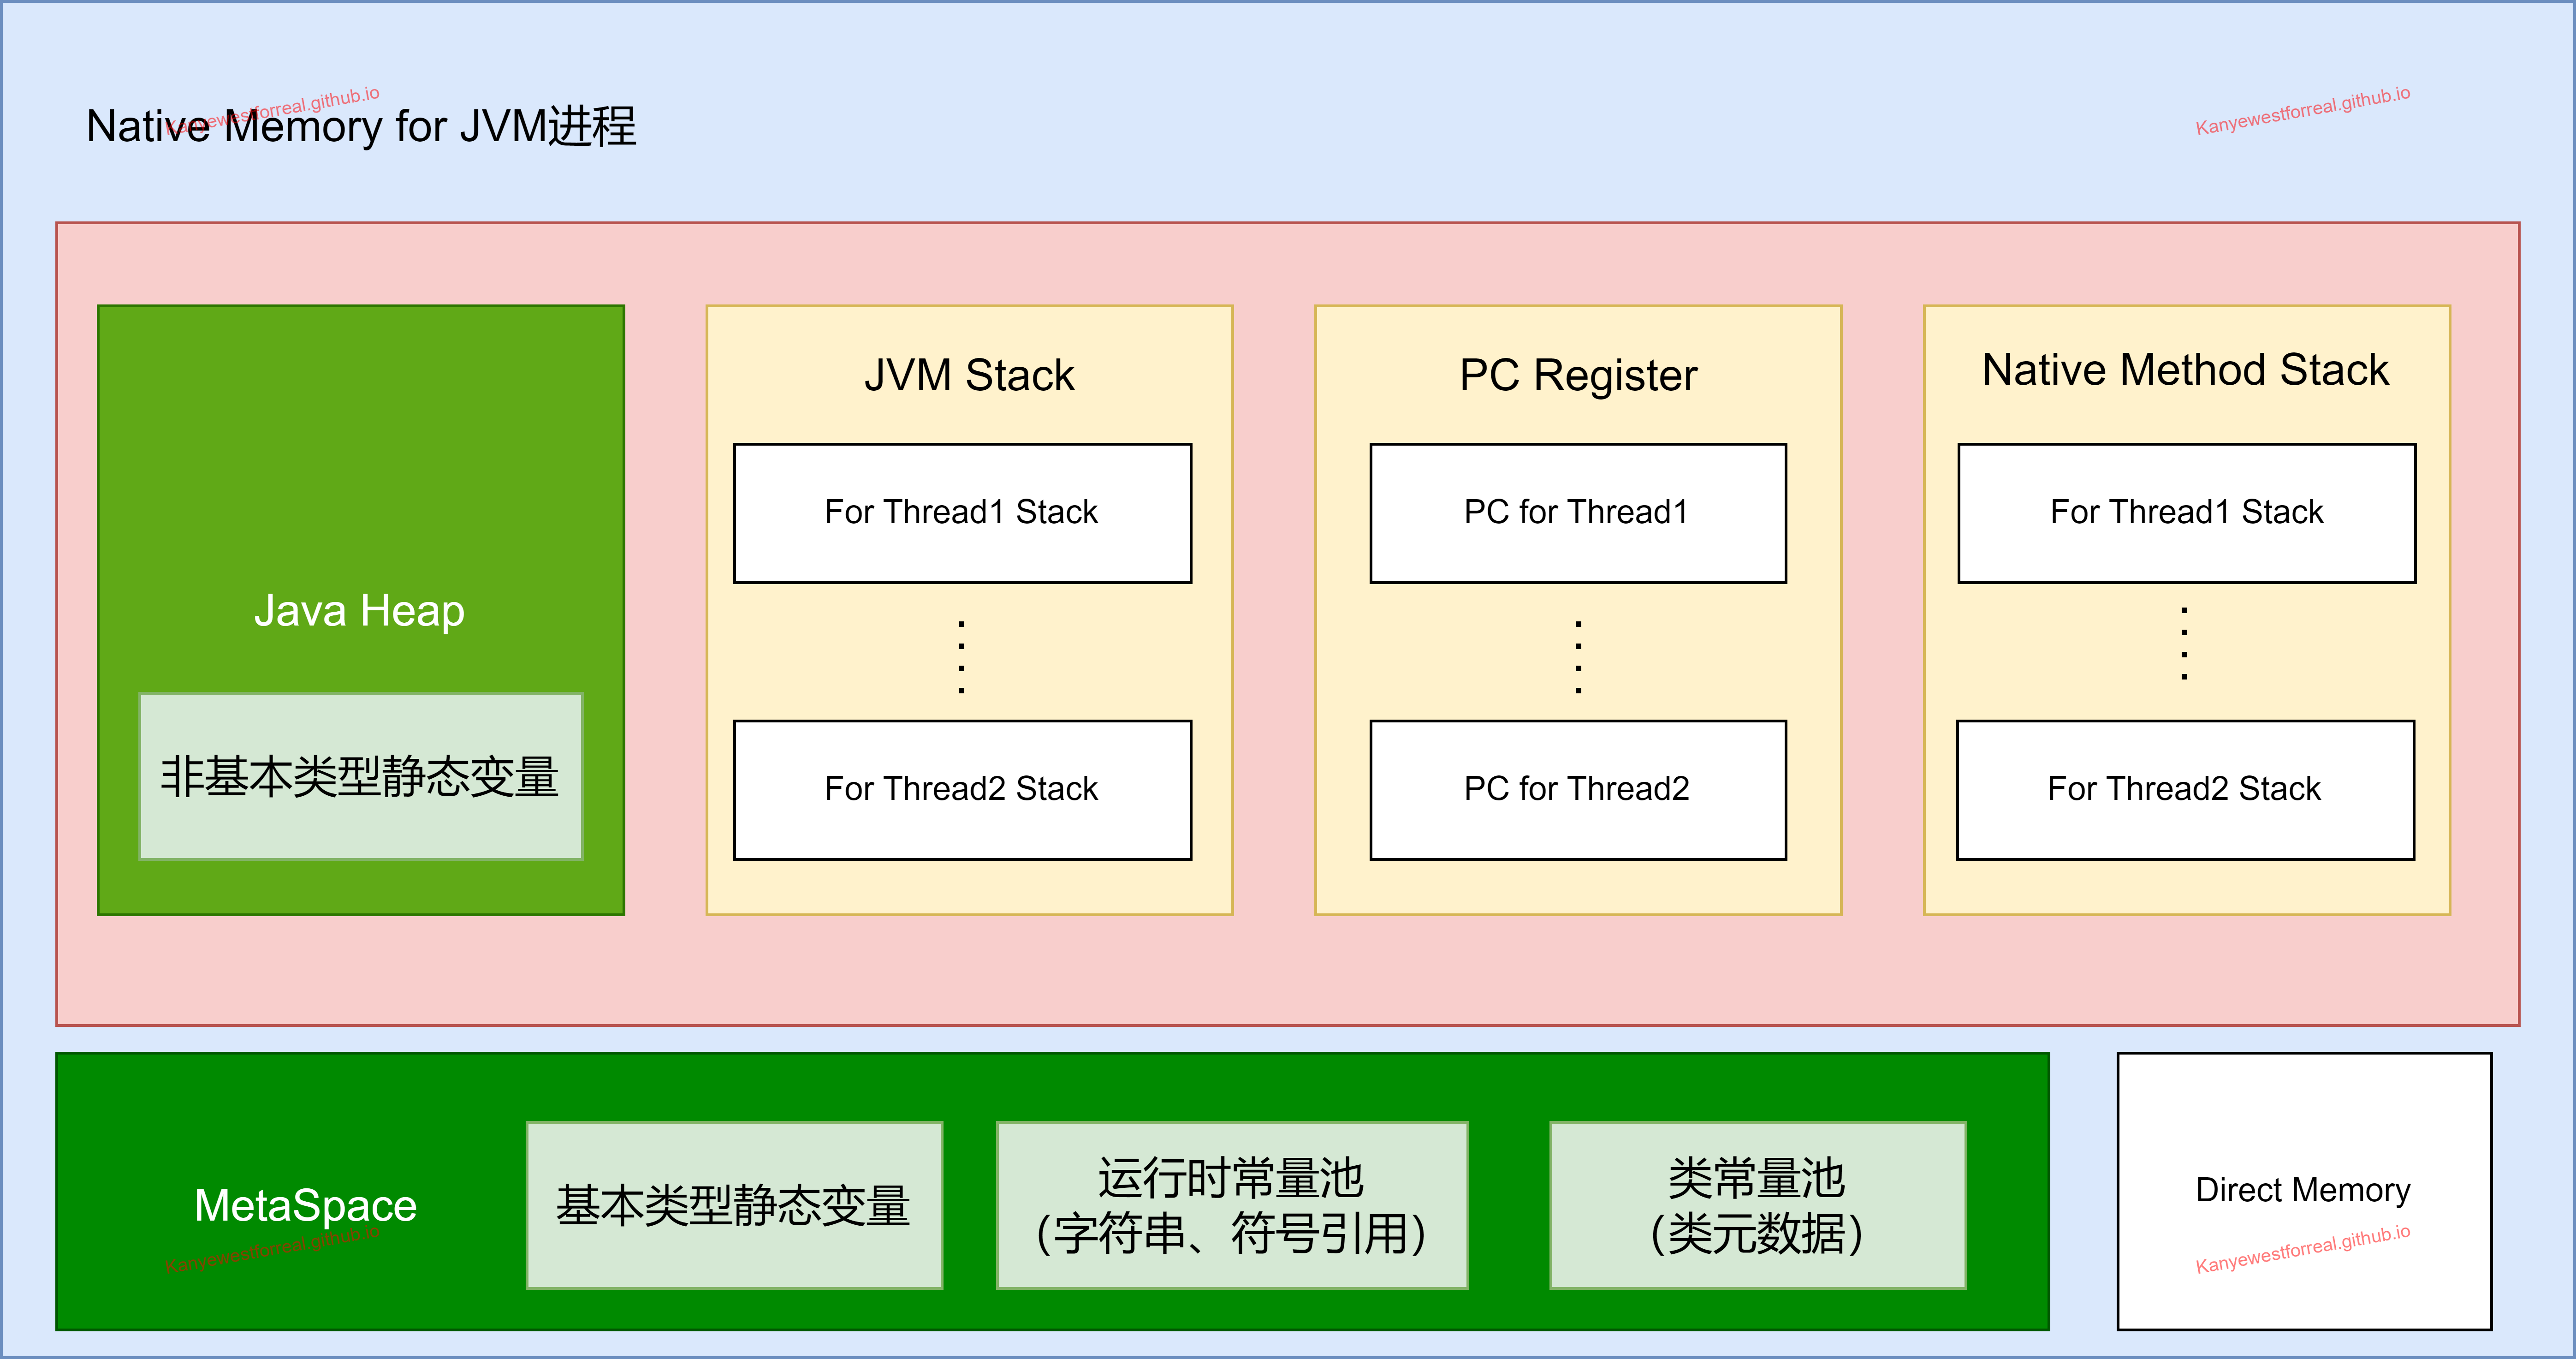
HotSpot JVM内存结构主要分为:堆内存(线程共享)、方法区(线程共享)、栈+程序计数器(线程私有)。
概念上:
堆内存:存放对象实例和数组。
方法区:存储类元数据、运行时常量、字符串常量、静态变量。
**方法区是JVM规定的一个概念,JVM必须要存在这么一个区域,但是实现可以由不同的方式实现(元空间、永久代 或者其他名字)。**甚至不同的实现,方法区保存的数据也不同。
比如JDK 1.7实现的永久代物理内存被设计在Java Heap中,但是实际上不属于堆。以及字符串常量池不在永久代,而在Java Heap中。
比如JDK 1.8实现的元空间物理内存不放在堆中,而放在本地内存Native Memory。
比如Android ART虚拟机实现的方法区放在堆中。
static静态变量本身(其作为类的一部分)的存储位置,分两种情况:
- 对于基本类型(
int、boolean等)的静态变量,其值直接存储在元空间的类定义中。 - 对于非基本类型的静态变量,引用(指针)存储在元空间,而被引用的对象实例存储在堆中。
堆(Heap)
被所有线程共享。对象实例、数组存储区域(GC主战场)。
大多数对象是朝生夕死,只有少数对象会存活很久,因此将堆分代可以大幅提高 GC 效率。
堆可以进一步细分为:
年轻代(Young Generation)
年轻代用于新生对象的分配与回收,它又细分为 3 个区;
Eden区:相对较小,当Eden区满时,会触发一次Minor GC(新生代垃圾回收,频率高)。
S0(Survivor 0)和S1(Survivor 1):两个 Survivor 区轮流作为“to/from”。from 区是上次GC的存活对象,to 区存本次 GC 后的Eden+Survivor活对象,每次 Minor GC 后,两块 Survivor 互换身份,确保始终有一块空白用于复制。(碎片化小,GC+复制算法不能在同一区域执行)
老年代(Old Generation)
经历过一次或多次Minor GC仍存活的对象会被移动到老年代。老年代的GC叫Major GC(也称为Full GC)发生的频率相对较低,执行时间通常比Minor GC长。老年代的空间通常比新生代大,以存储更多的长期存活对象。
大对象通常会直接分配到老年代,因为通常需要连续的内存空间,老年代比较大,防止分配失败。
如果在堆中没有内存完成实例分配,并且堆也无法扩展时会抛出 OutOfMemoryError 异常。
对象如何晋升到 Old 区?
晋升路径:
- 年龄超过阈值(默认 15)
- Survivor 放不下 → 直接晋升
- 动态年龄判断(Survivor 同龄对象占比超过 50%)
方法区(Method Area)
存储类元数据、运行时常量、字符串常量(JDK7及以后被移至堆)、静态变量(但被引用对象在堆)。方法区可以选择不实现垃圾收集。
虚拟机栈(JVM Stack)
每个线程都有自己独立的 Java 虚拟机栈,生命周期与线程相同。每个Java方法在执行时都会创建一个栈帧,用于存储局部变量表、操作数栈、动态链接、方法出口等信息。可能会抛出 StackOverflowError 和 OutOfMemoryError 异常。
本地方法栈(Native Method Stack)
每个线程都有自己独立的本地方法栈,生命周期与线程相同。与 Java 虚拟机栈作用类似。Native方法执行时也会创建栈帧,同样可能出现 StackOverflowError 和 OutOfMemoryError 两种错误。
程序计数器(PC Register)
可以看作是当前线程所执行的字节码的行号指示器,用于存储当前线程正在执行的 Java 方法的 JVM 指令地址。如果线程执行的是 Native 方法,计数器值为 null。是唯一一个在 Java 虚拟机规范中没有规定 OutOfMemoryError 情况的区域,生命周期与线程相同。
直接内存 Direct Memory
可以通过 NIO、Unsafe 类操作,可以显著提高 I/O 性能。直接内存是对Native Memory for JVM的再分配,使用受到本机总内存的限制,若分配不当,可能导致 OutOfMemoryError 异常。
Stack 和 Heap 的区别?
存放内容不同
- 栈:方法调用的栈帧、局部变量(基础类型)、操作数栈
- 堆:所有对象实例、数组
管理方式不同
- 栈:由线程自动分配和销毁(线程私有)
- 堆:由 JVM 的垃圾回收器(GC)管理(线程共享)
生命周期不同
- 栈:随线程创建,线程结束时销毁
- 堆:JVM 运行过程中一直存在
访问速度不同
- 栈:速度快(编译期确定结构)
- 堆:速度慢(需要 GC、对象查找)
线程共享性不同
- 栈:线程私有
- 堆:线程共享
注意
如果局部变量是基本类型(如int, double等)则在线程栈的局部变量表上;方法返回基本类型,是值传递,不会分配堆内存,值直接写入返回值寄存器(或返回值槽)
如果局部变量是非基础类型,**栈上只存引用;对象始终在堆上。**因为 Java 的对象生命周期不由方法结束来决定,可能方法结束后对象还在使用(比如返回值、闭包、线程间共享),因此对象必须放在 Heap(共享、可 GC)。
当程序中通过对象或类直接调用某个方法时,JVM执行了哪些操作?
预备知识
Java文件被编译成Class文件后,变量和方法的调用都作为符号引用保存在Class文件中的常量池中。
// 源代码
public class Demo {
    public int add(int a, int b) {
        return a + b;
    }

    public static void main(String[] args) {
        Demo demo = new Demo();
        int result = demo.add(1, 2);
    }
}

// main方法的字节码(简化版)
0: new           #2      // #2 = class com/example/Demo
3: dup
4: invokespecial #3      // #3 = Method "<init>":()V
7: astore_1
8: aload_1
9: iconst_1
10: iconst_2
11: invokevirtual #4     // #4 = Method add:(II)I ⬅️ 方法调用点
编译期只是产生符号引用(Symbolic Reference),编译器不会决定最终调用哪个类、哪个类的方法,真正运行时先写入MetaSpace常量池,执行某条字节码命令时才会解析Symbolic Reference确定类/方法。
所有方法的调用在Class文件里面都只是符号引用,非虚方法的调用在类加载时会被直接确定(一次性且最终的),虚方法的调用在字节码执行(运行期)期间才能确定,这是Java强大的动态扩展能力的基础。
非虚方法:
static 方法 不能覆写
private 方法 不能子类可见
final 方法 明确禁止覆盖
构造方法 只能属于本类
super 调用 语义明确定向父类
invoke的解析
invokevirtual #4 指向常量池的符号引用(声明类 + 方法名 + 描述符)。
// 字节码中的方法调用引用
invokevirtual #4  // 常量池索引4

// 常量池项结构
ConstantPoolEntry {
    tag: CONSTANT_Methodref (10)
    class_index: 指向类名
    name_and_type_index: 指向方法名和描述符
}
JVM 会解析该符号引用,
1.通过CONSTANT_Methodref 确定是方法的符号引用
2.解析 class_index → 如果类没被加载,就加载类。
// 类加载时构建方法表
class ClassLoader {
  void prepare_methods(Klass* klass) {
    for (Method* method : klass->methods()) {
      if (method->is_static() ||
          method->is_private() ||
          method->is_constructor()) {
        // 非虚方法,不放入vtable
        method->set_vtable_index(-1);
      } else if (method->is_final()) {
        // final方法:放入vtable,但不会被子类覆盖
        method->set_vtable_index(calculate_index());
      }
    }

    // 构建vtable(只包含虚方法)
    build_virtual_method_table(klass);
  }
}
3.解析 name_and_type_index → 获取方法名和描述符
4.检查类的方法表(MethodTable / methods 数组),找到对应的方法解析,得到ResolvedMethod。
struct ResolvedMethod {
    void* _entry_point;      // 方法入口地址
    int   _vtable_index;     // vtable索引(虚方法)
    bool  _is_virtual;       // 是否是虚方法
};
准备执行
如果是invokestatic/invokespeacil,那么接下来可以直接使用刚刚获取的ResolvedMethod,不走虚分派。
如果是 invokevirtual/invokeinterface,那么以刚刚的ResolvedMethod,作为起点方法。
1.获得对象的引用
2.检查对象的实际类型
3.通过对象头找到实际类型的Klass指针
4.访问实际类型的vtable
5.根据“起点方法”的slot index(只有相同的slot index才能保证覆盖方法),得到实际类型对应方法在其vtable的偏移量。
6.获取实际要执行的方法入口地址
这就是 动态绑定。
建立栈帧
方法调用过程非常简单,直接跳转到目标方法入口地址。
每一次方法调用都会创建一个新的栈帧,包括:
- 局部变量表(包括 this)
- 操作数栈
- 常量池引用
- 返回地址
- 方法返回值槽
栈帧入栈后,JVM 就开始按字节码解释执行。
执行
执行方式可能有两种:
解释执行(Interpreter)
逐条解释字节码。
JIT 编译成本地机器码
热点方法会被 C1/C2 编译器编译成本地代码,执行速度极快。
结束、销毁栈帧
栈帧弹出、返回值写到上层栈:
- 基本类型 → 写到返回值槽或寄存器
- 引用类型 → 返回对象引用
栈帧销毁,程序回到调用方。
总结
方法调用时,JVM 会前往MetaSpace的常量池,确认类加载,然后解析符号引用为方法的直接引用 → 准备执行,确定实际调用的方法版本(静态或动态分派) → 为方法创建栈帧 → 执行方法的字节码或 JIT 机器码 → 返回结果并销毁栈帧。
String的奇妙机制
String 是 Java 的字符串类型(类),而“字符串”是它的实例。
1. 字面量方式
String s1 = "abc";
String s2 = "abc";
查找字符串常量池(String Intern Pool)(在堆中),是否有"abc",
无:"abc" 会被放入字符串常量池
有:s2 指向常量池中的这个对象
特点:
- 常量池内的字符串具有 全局共享、唯一性
- 重复出现
"abc"时不会创建新的对象
2. new 创建方式
String s1 = new String("abc");
String s2 = new String("abc");
发生两件事:
"abc"→ 在常量池中创建/查找new String("abc")→ 在堆上创建一个新的 String 对象,这个String对象指向"abc"
因此:
- 常量池有一个对象
- 堆中有两个的对象
s1 和 s2 是两个引用变量,分别指向两个不同的堆对象,地址不同。但是分别指向的对象的内容相同。
s1 == s2  // false
s1.equals(s2) → true
引用类型
引用类型主要分为强软弱虚四种:
-
强引用:指的就是代码中普遍存在的赋值方式,比如
A a = new A()这种。只要有强引用指向对象时,GC 永远不会回收它,哪怕内存不足也会抛 OutOfMemoryError 也不回收。 -
软引用:可以用SoftReference来实现,指的是那些有用但是不是必须要的对象。**系统在发生内存溢出前会对这类引用的对象进行回收。**适合用作缓存。
SoftReference<byte[]> ref = new SoftReference<>(new byte[1024 * 1024]); -
弱引用:可以用WeakReference来实现,他的强度比软引用更低一点,**弱引用的对象下一次GC的时候一定会被回收,而不管内存是否足够。**被回收后,
get()方法会返回null,记得做check。WeakReference<MyObject> weakRef = new WeakReference<>(new MyObject()); -
虚引用:也被称作幻影引用,是最弱的引用关系,可以用PhantomReference来实现,其必须和ReferenceQueue一起使用,同样的当发生GC的时候,虚引用也会被回收。不能通过
get()得到其引用的对象,也就是不能使用其引用的对象。主要用途是跟踪对象被 GC 回收的时机。主要用于管理堆外内存、大对象的回收时机。PhantomReference<MyObject> phantom = new PhantomReference<>(new MyObject(), referenceQueue);
为了让开发者能够控制对象的生命周期强弱,减少缓存导致的内存泄漏(SoftReference),避免弱引用(WeakReference)关联的 key 泄漏(ThreadLocal、WeakHashMap),在对象被释放时做额外清理动作(PhantomReference 用于堆外内存清理)。
内存泄露、内存溢出的原因/例子
内存泄露
程序不再需要某些对象,但仍然保持对它们的强引用,导致 GC 无法回收,内存被长期占用。
在 JVM 中,只要对象还有“可达引用链”,GC 就不会回收它。因此,泄漏往往来自:
- 数据结构忘记清理
- 长生命周期的对象持有短生命周期对象的引用
- 注册、回调未注销;I/O资源未关闭。
- 静态变量持有大对象
- 线程池使用
ThreadLocal,且未手动remove
内存溢出
当 JVM 试图分配对象但找不到足够的内存空间时抛出。
Java Heap Space OOM
当出现Java.lang.OutOfMemoryError:Java heap space异常时,就是堆内存溢出了。准备分配内存给新对象,内存不够,在多次GC之后,还是无法找到一块足够大的内存容纳当前对象,就会抛出Java Heap Space OOM。
- 数据量过大
- 无限创建对象
- 集合未限制大小
- 缓存不当
- 内存泄漏引起堆满
StackOverFlowError
方法递归太深:可能是参数配置错误、边界条件没有考虑、没有退出条件。
就会导致不断地进行压栈。类似这种情况,JVM 实际会抛出 StackOverFlowError,此时如果 JVM 试图去扩展栈空间的的时候失败,则会抛出 StackOverFlowError。
MetaSpace OOM
元空间的溢出,系统会抛出Java.lang.OutOfMemoryError: Metaspace。出现这个异常的问题的原因是系统的代码非常多、引用的第三方包非常多、通过动态代码生成类加载等方法,导致元空间的内存占用很大,在拓展元空间时又失败了,则会抛出MetaSpace OOM。
Direct Buffer Memory
在使用ByteBuffer中的allocateDirect()的时候,或者使用JavaNIO(像netty)的框架超出当前内存限制,会抛出Java.lang.OutOfMemoryError: Direct buffer memory异常。
逃逸分析
HotSpot C2 编译器会对每个 new 进行逃逸分析,判断对象作用域,决定对象是否进入堆,或者分解对象为标量在栈/寄存器上分配内存。(在编译期就决定好了)
什么是逃逸?
对象在方法内是否“逃出当前作用域”。
逃逸类型
完全不逃逸(NoEscape)
对象只在方法内部使用
int f() {
    Point p = new Point(1, 2);
    //JVM 会把 p 拆成两个独立的 int(标量替换)
    //对象的所有字段都能单独分析
	//对象不会被需要“真实存在”
    //那么分配在寄存器上
    return p.x + p.y;
}

void test() {
    Foo f = new Foo();
    // this 传入可能用到完整对象结构(非标量)
    // 栈上分配
    f.bar(this);
}
优化结果:
不在堆上创建对象,直接分配在栈/寄存器上。
方法逃逸(ArgEscape)
对象作为参数传递出去:
void foo() {
    Bar b = new Bar();
    list.add(b); // 逃逸到方法外
}
b 被外部存储,逃逸。需要分配到堆上。
全局逃逸(GlobalEscape)
对象变成类字段、静态字段或被返回:
static Foo f;
f = new Foo(); // 全局逃逸
一定要在堆上分配。
逃逸优化策略
HotSpot C2 编译器可进行三种优化:
标量替换(Scalar Replacement)
如果对象内部字段都能单独处理,则:
- 对象完全消失,不会分配内存(堆或栈均不会使用)
- “new Point()” 会被优化掉
- 字段如
x、y会变成独立的局部变量或寄存器
例如:
Point p = new Point(1, 2);
int r = p.x + p.y;
最终不会产生任何对象,也不会调用构造方法。这节省最多的 GC 压力。
栈上分配(Stack Allocation)
如果对象不能标量化,但不会逃逸:
- 对象分配在 栈帧
- 方法结束自动回收
- 不需要 GC
真实 JVM 中:
HotSpot 使用 逃逸分析 + 线程栈/寄存器优化,但“纯栈上分配”不直接暴露给开发者,更多通过标量替换完成。
普通堆分配(TLAB / Eden)
对象逃逸,则必须进入堆,进入下面讲的堆分配策略。
创建对象过程
(假定逃逸分析后,对象仍需要分配在堆上)
解析类符号引用 → 类加载检查 → 分配内存 → 零值初始化 → 设置对象头 → 执行构造方法
Foo f = new Foo();

// #3 是常量池中 Foo 的 Class 符号引用
new #3
// dup 把刚创建但未初始化的Reference,再复制一份到操作数栈顶部。
//因为接下来 invokespecial 需要Reference作为参数初始化接收对象
//而 new 本身也需要返回Reference,一份要给构造函数做参数,一份留给用户代码。
dup
// 调用 Foo类 <init> 构造方法。
// #4 是 Foo类构造函数 的符号引用

// JVM 解析方法符号引用
// 1.进行类加载检查
// 2.接下来虚拟机将为新生对象分配内存,对象所需的内存大小在类加载完成后便可确定
// 3.零值初始化
// 4.设置对象头
// 在上面工作都完成之后,从JVM的视角来看,一个新的对象已经产生了
// 但从Java程序的视角来看,对象创建才刚开始——构造函数还没有执行,所有的字段都还为零。
// 定位到真正的构造方法,执行构造方法,初始化字段。
invokespecial #4
//将构造完成的Reference存入局部变量表 slot 1。
astore_1
类加载检查
若 Foo 尚未加载,立即进行类加载过程。
分配对象内存(堆 Heap)
否则,根据类计算出一个对象需要的内存大小,不同的内存大小影响着JVM的分配策略:
- fast-path:直接分配在TLAB上 (线程本地分配缓冲区,Thread-Local Allocation Buffer)
- slow-path:可能用到锁,在 Eden 全局区上分配(超过TLAB最大容量,只能分配在堆的共享区域)
分配的大小 = 对象头 + 实例字段总大小(含对齐),也就是说在堆分配对象需要的内存,需要类加载完成后进行。
指针碰撞、空闲列表、TLAB
指针碰撞和空闲列表是JVM分配内存的两种方式。
指针碰撞
JVM维护一个指向当前未使用内存起始位置的指针。当需要为新对象分配内存时,JVM只需将指针向前移动与对象大小相等的距离,并将这段内存分配给对象。这种分配方式就像是一个“碰撞”过程,因此得名指针碰撞。只适用于Java堆内存连续的情况。
空闲列表
空闲列表适用于Java堆内存不连续的情况。在这种情况下,已使用和未使用的内存块相互交错,无法简单地通过移动指针来分配内存。因此,JVM需要维护一个空闲列表,记录哪些内存块是可用的。空闲列表通常是一个链表结构,每个节点代表一个可用的内存块。
TLAB
假定只使用移动指针:
线程 A 检查某一内存区域可用,准备移动指针。但在它移动之前,线程 B 也检查到这一内存区域可用,并抢先移动了指针。这时线程 A 再移动指针,就会覆盖掉线程 B 分配的内存区域。
TLAB 的出现就是为了解决上述并发分配的性能瓶颈(只用锁效率太低)。它的核心思想非常直观:给每个线程分配一小块专属的内存区域(缓冲区),线程优先在自己的缓冲区里分配对象。
当然,如果 TLAB 剩余空间不足以容纳要分配的对象,或者 TLAB 完全用完,线程就需要申请一个新的 TLAB。申请新 TLAB 的过程需要同步,因为它涉及到从共享的 Eden 区获取一块新的内存。但相比于每次分配小对象都进行同步,申请 TLAB 的频率要低得多(只有当 TLAB 用完时才需要)。这大大减少了锁竞争的次数。
如果要分配的对象太大,超过了 TLAB 的容量(甚至可能超过了单个 TLAB 的最大允许大小),那么这个对象就不会在 TLAB 中分配。JVM 则会尝试直接在 Eden 区的共享部分(如果还有空间)进行分配。这个过程可能需要加锁。
类加载过程
加载 → 链接(验证、准备、解析) → 初始化
JVM的类加载过程是懒加载的,只有使用到的时候才会加载。
加载
JVM读取到对应的符号引用,查类加载器的内部哈希表是否存在对应 Klass 元数据。 否则,执行 classLoader 的 loadClass,通过类的全限定名(包名 + 类名),获取到该类的.class文件的二进制字节流,将二进制字节流所代表的静态存储结构,转化为方法区MetaSpace运行时的数据结构Klass,在堆中生成一个代表该类的Java.lang.Class对象,作为方法区Klass的访问入口(镜像对象)。
类加载器的内部哈希表(如 SystemDictionary):
- key = fully-qualified name(类的完全限定名)
- value = Klass 对象
因此,如果是同一完全限定下的类,被不同类加载器加载,可以说这两个类是不同的。Java判断一个类相同必须是:相同的完全限定名+相同的类加载器。
调用ClassLoader类的loadClass方法加载一个类,不算对类的主动使用,不会导致类的初始化。
连接
验证、准备、解析 3 个阶段统称为连接。
验证
确保class文件中的字节流包含的信息,符合当前虚拟机的要求,保证这个被加载的class类的正确性,不会危害到虚拟机的安全。验证阶段大致会完成以下四个阶段的检验动作:文件格式校验、元数据验证、字节码验证、符号引用验证。
准备
为类中的静态字段分配内存,并设置默认的初始值,比如int类型初始值是0。
被final修饰的static字段不会设置,因为final在编译的时候就分配了。
解析
解析 = 把运行时常量池中符号引用解析为指向“真实类、字段、方法”的直接引用。
符号引用是以一组符号来描述所引用的目标,符号可以是任何形式的字面量,只要使用的时候可以无歧义地定位到目标即可。
直接引用可以是直接指向目标的指针、相对偏移量、一个能间接定位到目标的句柄(由虚拟机决定)。如果有了直接引用, 那引用的目标必定已经存在在内存中了。
解析阶段 不会一股脑解析全常量池。
那解析阶段到底做了哪些“必须要做”的解析?
HotSpot 主要做下面几类:
解析类层级结构相关的符号引用
立即解析
例如:
- 父类(super class)
- 接口(interfaces)
- 注解类
- 需要验证的方法签名、字段类型引用
解析阶段会确保:
父类能成功加载
父类已通过验证
接口能成功加载
接口也完成验证
这些都属于结构性解析,不延迟。
解析“非虚方法”的引用
能静态绑定的都立即解析
包括:
- private 方法
- static 方法(invokestatic)
- 构造方法(
) - final 方法
- super 调用方法(invokespecial)
这些在类加载时即可确定,不依赖运行时对象的多态,所以 HotSpot 直接解析。
例如 Test 类中调用:
invokestatic #42
invokespecial #15
解析阶段就会解析。
解析方法句柄
invokedynamic 的 bootstrap method 必须解析,
因为 bootstrap 必须在链接时执行。
一些 MethodHandle 也需要提前检查合法性。
对某些符号引用进行“合法性验证”
例如:
- 字段签名是否存在对应类型
- 方法的参数类型是否存在
- 方法名是否与对应类匹配
- 子类是否正确实现了父接口的方法要求
这些属于 semantic check(语义检查),
是“解析检查”,但不是“解析成直接引用”。
也就是说:
解析阶段会验证符号引用的合法性,但不会生成 Method* 或 Field。*
准备 vtable/itable 的结构
HotSpot 在解析阶段会构建:
- vtable 大小
- itable slot
- 方法布局、重写关系
但不绑定具体 Method*
但不会在解析阶段解析每个虚方法引用。虚方法引用必须 Lazy Resolution。
哪些解析被延迟(Lazy Resolution)?
下面这些全部不在解析阶段做,而是字节码第一次执行时做:
A)invokevirtual 的方法解析(虚方法)
涉及运行时类型 + 动态绑定,不可能在解析阶段做完。
B)invokeinterface 的解析
需要查找接口方法在 itable 中的槽位。
C)getfield / putfield / getstatic / putstatic
字段 offset 的解析全部延迟。
D)new 指令中类引用(按需加载)
即使常量池里有 class A 的符号引用,也不会解析它,直到执行 new A 时。
初始化
初始化是整个类加载过程的最后一个阶段,要注意的是这里的构造器方法并不是开发者写的,而是编译器自动生成的。
执行类的
使用
方法调用:通过 Method* 或 vtable 入口执行
字段访问:通过 Field offset
实例创建:采用分配策略(TLAB → Eden → 老年代)
卸载
一个类要被JVM卸载,条件非常苛刻,需要同时满足以下三点:
- 该类所有的实例都已经被回收
- 加载该类的ClassLoader已经被回收:类与其加载器是双向绑定的共生关系。一个类由哪个类加载器加载,这个信息是存储在Class对象里的。要卸载一个类,必须先卸载加载它的类加载器。
- 类对应的Java.lang.Class对象没有任何地方被引用:不能在任何地方通过反射(如静态字段、全局变量)、静态变量、JNI等途径引用到这个Class对象。一旦这个Class对象还存在强引用,GC就不会回收它,那么这个类也就不会被卸载。
类加载器类型
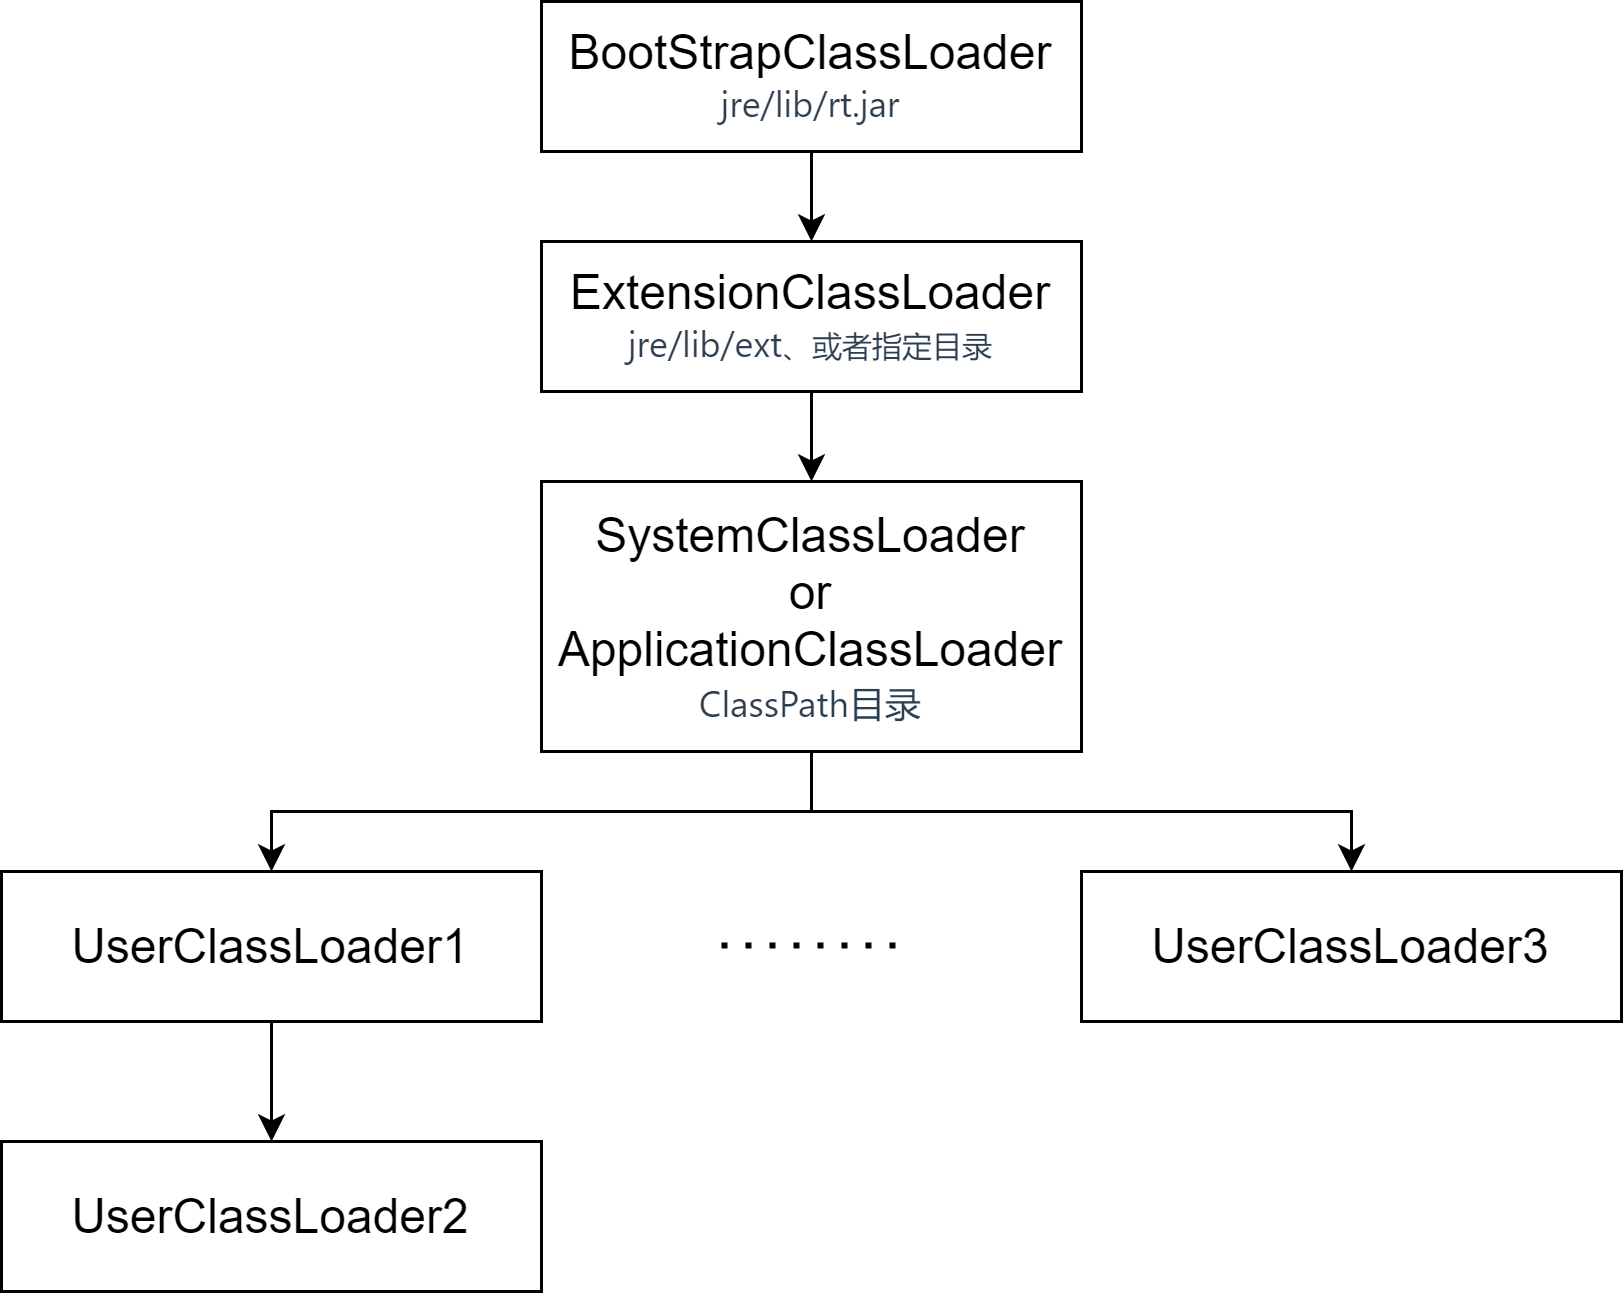
- 启动类加载器(Bootstrap Class Loader):这是最顶层的类加载器,负责加载Java的核心库(如位于jre/lib/rt.jar中的类),它是用C++编写的,是JVM的一部分。启动类加载器无法被Java程序直接引用,以
null指代。 - 扩展类加载器(Extension Class Loader):它是Java语言实现的,继承自ClassLoader类,负责加载Java扩展目录(jre/lib/ext或由系统变量Java.ext.dirs指定的目录)下的jar包和类库。
ExtensionClassLoader由BootstrapClassLoader加载,并且父加载器是BootstrapClassLoader。 - 系统类加载器(System Class Loader)/ 应用程序类加载器(Application Class Loader):这也是Java语言实现的,负责加载用户类路径(ClassPath)上的指定类库,是默认使用的类加载器。
ApplicationClassLoader的父加载器是ExtensionClassLoader。它可以通过ClassLoader.getSystemClassLoader方法获取到。 - 自定义类加载器(Custom Class Loader):开发者可以根据需求定制类的加载方式,比如从网络加载class文件、数据库、甚至是加密的文件中加载类等。自定义类加载器可以用来扩展Java应用程序的灵活性和安全性,是Java动态性的一个重要体现。
Java 9 引入了模块系统,并且略微更改了上述的类加载器。扩展类加载器被改名为平台类加载器(platform class loader)。Java SE 中除了少数几个关键模块,比如说 java.base 是由启动类加载器加载之外,其他的模块均由平台类加载器所加载。
上述类加载器之间的父子关系,使用组合关系来实现,代码层上没有通过继承实现。
public abstract class ClassLoader {
    private final ClassLoader parent;

    protected ClassLoader(ClassLoader parent) {
        this.parent = parent;
    }
}
类加载器的父子关系完全是 Java 层 ClassLoader.parent 字段构建出来的树形结构,其作用在于通过 loadClass 的递归调用来实现双亲委派。
双亲委派模型
类加载器之间的层级关系形成了双亲委派模型,其核心思想是当一个类加载器收到类加载的请求时,首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成,每一层次的类加载器都是如此,因此所有的加载请求最终都会传送到顶层的启动类加载器中。
只有当父加载器反馈自己无法完成这个加载请求(它的搜索范围中没有找到所需的类)时,子加载器才会尝试自己去加载。
ClassLoader 类有两个关键的方法:
findClass(String name):根据类的二进制名称来查找类,默认实现是空方法。loadClass(String name, boolean resolve):加载指定二进制名称的类 。name为类的二进制名称,resolve如果为 true,在加载时调用resolveClass(Class<?> c)方法解析该类。
如果需要自定义类加载器,同时沿用双亲委派机制,只需重写 findClass() 方法即可,无法被父类加载器加载的类最终会通过这个方法被加载。
但是,如果想破坏双亲委派模型,则需要重写 loadClass() 方法。
//ClassLoader#loadClass
protected Class<?> loadClass(String name, boolean resolve)
    throws ClassNotFoundException
{
    synchronized (getClassLoadingLock(name)) {
        //首先,检查该类是否已经加载过
        Class c = findLoadedClass(name);
        if (c == null) {
            //如果 c 为 null,则说明该类没有被加载过
            long t0 = System.nanoTime();
            try {
                if (parent != null) {
                    //当父类的加载器不为空,则通过父类的loadClass来加载该类
                    c = parent.loadClass(name, false);
                } else {
                    //当父类的加载器为空,则调用启动类加载器来加载该类
                    c = findBootstrapClassOrNull(name);
                }
            } catch (ClassNotFoundException e) {
                //非空父类的类加载器无法找到相应的类,则抛出异常
            }

            if (c == null) {
                //当父类加载器无法加载时,则调用findClass方法来加载该类
                //用户可通过覆写该方法,来自定义类加载器
                long t1 = System.nanoTime();
                c = findClass(name);

                //用于统计类加载器相关的信息
                sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0);
   			sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
            sun.misc.PerfCounter.getFindClasses().increment();
            }
        }
        if (resolve) {
            //对类进行link操作
            resolveClass(c);
        }
        return c;
    }
}
双亲委派模型的作用
- 保证类的唯一性、防止核心类被篡改:确保了所有加载请求都会传递到
BootstrapClassLoader,避免了不同类加载器重复加载相同类的情况,保证了Java核心类库的统一性,也保证了类的唯一性,同时还保证了不会加载非信任类路径外的类,防止了用户自定义类覆盖核心类库的可能。 - 安全隔离:不同层次的类加载器服务于不同的类加载需求,这种层次化的划分有助于实现沙箱安全机制,保证了各个层级类加载器的职责清晰,也便于维护和扩展。
- 提高类加载效率,减少冗余扫描:委派后父级通常已缓存大量常用类,不必每个
ClassLoader重复查找扫描。
如何破坏双亲委派模型
三种方式:
- 重写
loadClass(),不委派给parent - child-first:先
findClass,再parent.loadClass - 修改
parent(指向 Bootstrap 或其它 loader)
目的是让当前加载器优先加载类。
Android中插件化热修复
Android 的 ClassLoader 结构
常见的加载器链:
BootClassLoader
    ↑
PathClassLoader (加载 APK)
    ↑
DexClassLoader / InMemoryDexClassLoader (可加载补丁dex/插件dex)
PathClassLoader(系统): 负责加载 APK 中 classes.dex
DexClassLoader(第三方): 可加载任意PATH下的 dex、jar、apk
Android 热修复的三大主流方式
Tinker(主流,微信团队)
原理:向 PathClassLoader 插入“补丁 dex 的 DexPathList Element”
Android 的类查找流程:
PathClassLoader.pathList.dexElements = [x.dex, xx.dex, xxx.dex] //是按顺序查找类
Tinker 就是在这个数组前面插入补丁 dex。
示例(伪代码):
//反射
Field pathListField = findField(classLoader, "pathList");
Object pathList = pathListField.get(classLoader);

Field dexElementsField = findField(pathList, "dexElements");
Object[] oldElements = (Object[]) dexElementsField.get(pathList);

Object[] patchElements = makeDexElements(patchDexFiles);

Object[] newArray = concat(patchElements, oldElements);

dexElementsField.set(pathList, newArray);
效果:
- 补丁 dex 先被搜索
- 替换掉原有 class
- 不改逻辑,不改 loadClass,只改搜索顺序
这属于 class 优先级覆盖,而不是字节码替换。
优点:
- 最稳定
- 不破坏 ClassLoader 结构
- 支持任意类修复
缺点:
- 不支持资源修复(需额外方案)
- 不支持某些极端多 dex 情况
AndFix(即时替换方法实现)
直接修改方法指针,替换 ArtMethod。
Android ART 虚拟机中,每个方法包含一个结构体:
ArtMethod {
    entry_point_from_quick_compiled_code
}
AndFix 会:
- 从补丁中提取替代方法
- 将目标方法的 entrypoint 替换成补丁方法的入口地址
这是“方法级别”的替换,不是类加载器层面的。
优点:
- 不需要重启
- 修复速度快
缺点:
- 只能修复方法
- 不能新增字段
- Android 版本变动影响大(兼容性很差)
已经比较过时。
Robust(美团)
原理:插桩(Instrumentation)+ 代理逻辑
构建阶段对代码插桩,把所有方法入口改为:
if (PatchProxy.isSupport(...)) {
    return PatchProxy.accessDispatch(...);
} else {
    // 原代码
}
当有补丁时,PatchProxy 会进入替代逻辑。
特点:
- 不依赖 ClassLoader 或 Dex 替换
- 属于 AOP 插桩 + 代理方法分发
优点:
- 极稳定
- 不依赖 ART 实现
- 热修复兼容性最好
缺点:
- 插桩增加 App 体积与开销
- 语法受限制(某些方法不允许插桩)
垃圾回收(GC)机制
什么是垃圾回收
垃圾回收是 JVM 自动释放 不再被使用的对象 所占内存 的机制。
垃圾回收作用
- 自动释放无用对象,避免内存泄漏,减少手动管理带来的错误从而提高效率
- 避免系统内存耗尽,保证服务持续运行
- 把碎片化内存整理得更紧凑,使得创建对象更快
GC如何触发
- 内存不足时:当JVM检测到堆内存不足,无法为新的对象分配内存时,会自动触发垃圾回收。(堆被分成不同区域,不同区域的内存不足会触发不同类型的GC)
- 手动请求:虽然垃圾回收是自动的,开发者可以通过调用
System.gc()或Runtime.getRuntime().gc()建议 JVM 进行垃圾回收。不过这只是一个建议,并不能保证立即执行。 - 对象数量或内存使用达到阈值:垃圾收集器内部实现了一些策略,以监控对象的创建和内存使用,达到某个阈值时触发垃圾回收。这些阈值在启动 Java 应用时,可以设置,比如:
-Xmx(最大堆大小)、-Xms(初始堆大小)等。
判断垃圾算法类型
主要有两种。引用计数法和可达性分析算法。
引用计数
Python之类的使用。
- 原理:为每个对象分配一个引用计数器,每当有一个地方引用它时,计数器加1;当引用失效时,计数器减1。当计数器为0时,表示对象不再被任何变量引用,可以被回收。
- 缺点:不能解决循环引用的问题,即两个对象相互引用,但不再被其他任何对象引用,这时引用计数器不会为0,导致对象无法被回收。
可达性分析算法
这是JVM使用的算法,JVM不使用引用计数判断垃圾,因为无法处理循环引用问题。
从一组称为GC Roots(垃圾收集根)的对象出发,向下追溯它们引用的对象,以及这些对象引用的其他对象,以此类推。如果一个对象到GC Roots没有任何引用链相连(即从GC Roots到这个对象不可达),那么这个对象就被认为是不可达的,可以被回收。
GC Roots对象包括:
虚拟机栈(JVM Stack 栈帧中的局部变量表)中引用的对象
方法区中类静态属性引用的对象
本地方法栈中JNI(Java Native Interface)引用的对象
虚拟机内部的引用对象(活跃线程的引用)等。
GC的类型/GC的工作区域
根据其工作区域和触发条件的不同,可以将GC分为三种类型:Minor GC(也称为Young GC)、Major GC(有时也称为Old GC)、以及Full GC。
以下是这三种GC的区别和触发场景:
Minor GC (Young GC)
- 作用范围:只针对年轻代进行回收,包括Eden区和两个Survivor区(S0和S1)。
- 触发条件:当Eden区空间不足时,JVM会触发一次Minor GC,将Eden区和一个Survivor区中的存活对象移动到另一个Survivor区或老年代(Old Generation)。
- 特点:通常发生得非常频繁,因为年轻代中对象的生命周期较短,回收效率高,暂停时间相对较短。
Major GC
- 作用范围:只针对老年代进行回收。
- 触发条件:
- 当老年代空间不足时,触发Major GC。
- 大量对象在 Survivor 区活得太久,会迅速提前晋升 Old → Old 区变满 → 触发 Major GC。
- 特点:相比Minor GC,Major GC发生的频率较低,但每次回收可能需要更长的时间,因为老年代中的对象存活率较高。
Full GC
- 作用范围:对整个堆内存、元空间进行回收。
- 触发条件:
- 直接调用
System.gc()或Runtime.getRuntime().gc()方法时,虽然不能保证立即执行,但JVM会尝试执行Full GC。 - 大对象无法放入老年代,则会触发Full GC。
- 年轻代晋升老年代,但是空间不足,不足以容纳存活对象,触发Full GC。
- 当永久代(Java 8之前的版本)或元空间(Java 8及以后的版本)空间不足时。
- 直接调用
- 特点:Full GC是最昂贵的操作,因为它需要停止所有的工作线程(Stop The World),遍历整个堆内存来查找和回收不再使用的对象,因此应尽量减少Full GC的触发。
GC算法类型
按 回收基本策略 分类。
-
标记-清除算法(Mark Sweep):标记-清除算法分为“标记”和“清除”两个阶段,首先通过可达性分析,标记出所有需要回收的对象,然后统一回收所有被标记的对象。标记-清除算法实现简单,不需要移动对象,但有两个缺陷:清除阶段较慢、碎片化严重(空洞多),容易造成在申请大块内存的时候,因为没有足够的连续空间导致再次 GC。
-
复制算法(Copying):为了解决碎片空间的问题,出现了“复制算法”。将堆分为两个区域:From、To
GC 时:- 扫描 From
- 将存活对象复制到 To
- 清空 From
- 两者角色交换
复制算法解决了空间碎片的问题,但是也带来了新的问题,因为每次在申请内存时,都只能使用一半的内存空间,内存利用率严重不足。
-
标记-整理算法(Mark Compact):如果存活对象比较多时,复制算法会执行较多的复制操作,效率就会下降。而老年代的对象在 GC 之后的存活率就比较高,因此需要新算法。标记-整理算法的“标记”过程与“标记-清除算法”的标记过程一致,但标记之后不会直接清理。而是将所有存活对象都移动到内存的一端,移动结束后,直接清理掉一块区域。
-
分代回收算法:不算是算法,而是策略。把堆分为年轻代 + 老年代,分别用不同算法。
- Young 区:对象朝生夕死 → 使用复制算法
- Old 区:对象长寿、多对象 → 使用标记整理
JVM GC器类型
| 收集器 | 年轻代算法 | 老年代算法 | 是否并发 | 特点 |
|---|---|---|---|---|
| Serial | 复制 | 标记-整理 | 否 | 单线程,简单可靠 |
| Parallel | 复制 | 标记-整理 | 否 | 高吞吐 |
| CMS (Concurrent Mark-Sweep) |
复制 | 标记-清除 | 是 | 低停顿,但有碎片 |
| G1 | 复制(Region分区) | 标记-整理(Region) | 是 | 面向大堆、低停顿。服务端应用。 |
| ZGC | Region + 复制 | Region + 并发压缩 | 是(几乎全并发) | 子毫秒停顿 |
| Shenandoah | Region + 复制 | Region + 并发压缩 | 是 | 极低延迟 |
现代收集器 G1、ZGC、Shenandoah 基于 Region,同时使用并发标记、复制与压缩技术以降低停顿时间。
ART GC器类型
ART 虽然没有 HotSpot 那样的 Young / Old 物理分区,但仍是 逻辑分代 GC:
- Sticky GC 回 Young 部分
- Partial GC 回 Young + 部分 Old
- Full GC 回整个堆
这是一个软分代模型,不是 HotSpot 的硬分代模型。
ART 的 GC 不是一个收集器,而是 多个收集器协同 工作:
Sticky Mark-Sweep(粘性标记清除 GC)(最常触发)
作用:回收最近死亡的小部分对象(通常是当前 Young 区的小对象)
特征:
- 只扫描“自上次 GC 之后新增或修改过”的对象
- 非常快(<1ms)
- STW 时间极短
- 不移动对象(无 compact)
用途:
- 高频 GC,近年来 Android 优化最重要的一种 GC
你可以把它理解为 “增量式 Young GC”。
Partial Mark-Sweep(部分标记清除 GC)
回收部分堆(通常是 Young + 一部分 Old)
特征:
- Stop-The-World + 并发
- 速度比 Full GC 快
- 不整理碎片
用途:
- Sticky 扫不干净时,会触发它
Full Mark-Sweep(完整标记清除 GC)
回收整个堆的所有未引用对象
特征:
- 扫描全堆
- STW 较长
- 不 compact(早期版本)
- 触发时说明内存压力较高
用途:
- 汇总性的 GC,当其他 GC 效果不足时触发
Full Mark-Compact(完整标记整理 GC)
清除整个堆 + 整理碎片
特征:
- 标记整个堆
- 移动对象 → 内存连续
- 停顿较长(但比 Dalvik 时代短很多)
- 提高长期运行稳定性
用途:
- 防止碎片化
- ART 运行若干天后,也要偶尔 compact
你可以说它类似 HotSpot 的 Mark-Compact。
Concurrent Copying GC
Android 8.0 引入:
并发复制收集器(Concurrent Copying)
是移动端的“ZGC/Shenandoah 思路”,但更轻。
特征:
- 有读屏障(read barrier)
- 对象移动是并发完成的
- STW 时间进一步缩短
- 类似 HotSpot 的 G1/ZGC,但为移动设备优化
HotSpt JVM启动流程
启动器(Launcher)阶段
你执行 java 命令时,其实启动的是C++文件:
/bin/java -> C++ 写的启动器
它做几件事:
- 解析命令行参数(classpath、-Xmx、-XX… 等)
- 找到 libjvm.so / jvm.dll 并加载进去
- 使用 JNI Invocation API 创建 JVM
调用:
JNI_CreateJavaVM(JavaVM **pvm, JNIEnv **penv, void *args);
从这一刻起,JVM 虚拟机才真正开始运行。
JVM 初始化(JNI_CreateJavaVM)
JVM 线程开始执行,它内部依次初始化:
初始化内存模型
- Java 堆(Heap)
- 方法区 / 元空间(Metaspace)
- CodeCache(JIT 机器码区)
- JVM Stack 等
初始化 GC 子系统
不同 GC 器(G1、ZGC、Shenandoah)会在此完成内部结构建立。
初始化执行引擎
- 解释器模板生成(TemplateInterpreter)
- C1/C2 / JVMCI JIT 初始化
初始化类加载器子系统
加载器顺序:
- BootstrapClassLoader(C++ 实现)
- PlatformClassLoader(Java 9+)
- AppClassLoader
加载 JVM 基础类(Bootstrap 阶段)
JVM 必须先加载最基础的类,否则无法运行 Java 世界。
顺序通常如下:
- 加载
java.lang.Object:一切类的起点。 - 加载
java.lang.String:因为内部很多结构依赖 String(包括类名)。 - 加载
java.lang.Class:没有 Class 对象,类元数据无从表示。 - 加载
java.lang.Thread、java.lang.ThreadGroup:JVM 要靠这些表示 Java 层线程,因此启动过程必须提前加载。
加载这些类时都会触发 静态变量分配、
执行、常量解析等 。
创建“主线程”(Main Thread)
虽然底层启动有一个 Native Thread,通过其启动JVM,但 JVM 必须创建一个代表它的 Java Thread 对象作为映射。
执行:
//fake code
Thread t = new Thread()
并将其设为:
- 当前线程(main thread)
- 所属 ThreadGroup(main group)
然后这个线程成为执行你main()方法的载体,也就是主线程。
主类(Main-Class)的加载
现在 JVM 使用 主线程 + Application ClassLoader 去加载具有main方法的类。
流程:
- 字节码通过 classpath / modulepath 查找
- 加载 class 文件
- 解析类结构(constant pool、methods、fields)
- 为静态变量分配空间
- 初始化父类
- 执行
<clinit>(类初始化:static 语句块 + static 字段赋值)
解析 main 方法的符号引用
JVM 需要找到:
public static void main(String[] args)
编译器会在常量池中记录方法的 符号引用:
"main", "([Ljava/lang/String;)V"
JVM 解析后得到:
- 方法所在类
- 方法描述符
- 方法入口地址(解释器入口 or JIT 地址)
如果找不到,报错:
java.lang.NoSuchMethodError: main
执行 main 方法
启动器调用:
(*env)->CallStaticVoidMethod(env, mainClass, mainMethodID);
JVM 开始执行 main 方法的字节码:
- 解释器逐条解释执行指令(iload、invokestatic…)
- 或触发 JIT,生成机器码
- 调度 Java 层线程
- 执行整个程序生命周期
总结
java 命令启动
  → 解析参数
  → 加载 libjvm
  → 调用 JNI_CreateJavaVM
      → 初始化堆、元空间、GC、解释器、JIT、类加载器
      → Bootstrap 加载 Object/String/Class/Thread…
      → 创建 Java 主线程对象
      → 使用 AppClassLoader 加载主类
          → 类加载 → 验证 → 准备 → 解析 → 初始化
      → 解析 main 方法
      → 调用 main 方法(解释器/JIT 执行)
参考
https://www.xiaolincoding.com/interview/jvm.html
https://javaguide.cn/java/jvm/classloader.html