
Java多线程笔记(4)
线程之间协作工具类
并发容器
生产者-消费者模型
ConcurrentModificationException
| 类 | 作用 |
|---|---|
Semaphore |
限制同时访问资源的线程数量 |
Exchanger |
两个线程交换数据 |
CountDownLatch |
一个线程等待多个线程执行完 |
CyclicBarrier |
多个线程在同步点一起执行 |
Phaser |
增强的 CyclicBarrier,可以动态调整 |
Semaphore
Semaphore 是共享锁,其利用AQS实现, state 值为 permits,你可以将 permits 的值理解为许可证的数量,只有拿到许可证的线程才能执行。
因此,Semaphore 可以通过控制许可数量permits,来限制同时访问共享资源的线程数量。
acquire方法相关
用于获取permit的方法。
//Semaphore#acquire
public void acquire() throws InterruptedException {
    sync.acquireSharedInterruptibly(1);
}
//一次获取多个permit
//(控制优先级/资源分配数量)
public void acquire(int permits) throws InterruptedException {
    if (permits < 0) throw new IllegalArgumentException();
    sync.acquireSharedInterruptibly(permits);
}


//Semaphore#tryAcquire
//无论是公平策略的Sync,还是非公平Sync,都插队式的获取一次permit
public boolean tryAcquire() {
    return sync.nonfairTryAcquireShared(1) >= 0;
}
public boolean tryAcquire(int permits, long timeout, TimeUnit unit)
    throws InterruptedException {
    if (permits < 0) throw new IllegalArgumentException();
    return sync.tryAcquireSharedNanos(permits, unit.toNanos(timeout));
}

//AQS#acquireSharedInterruptibly
//可中断的acquire
public final void acquireSharedInterruptibly(int arg)
    throws InterruptedException {
    if (Thread.interrupted() ||
        (tryAcquireShared(arg) < 0 &&
         //AQS#acquire 中会调用 对应策略的tryAcquireShared
         //是ShareNode,所以如果获取成功一次,那么会一直传播,唤醒后续节点
         //后续节点会尝试获取permit,直到permit为0
         acquire(null, arg, true, true, false, 0L) < 0))
        throw new InterruptedException();
}

//Semaphore.NonfairSync#tryAcquireShared
static final class NonfairSync extends Sync {
    private static final long serialVersionUID = -2694183684443567898L;

    NonfairSync(int permits) {
        super(permits);
    }

    protected int tryAcquireShared(int acquires) {
        return nonfairTryAcquireShared(acquires);
    }
}

//Semaphore.Sync#nonfairTryAcquireShared
final int nonfairTryAcquireShared(int acquires) {
    for (;;) {
        int available = getState();
        //这里是减少permit数量
        int remaining = available - acquires;
        if (remaining < 0 ||
            compareAndSetState(available, remaining))
            return remaining;
    }
}

//Semaphore.FairSync#tryAcquireShared
static final class FairSync extends Sync {

    protected int tryAcquireShared(int acquires) {
        for (;;) {
            //比NonfairSync多判断:队列是否有节点
            //有返回-1,表示获取失败
            if (hasQueuedPredecessors())
                return -1;
            int available = getState();
            int remaining = available - acquires;
            if (remaining < 0 ||
                compareAndSetState(available, remaining))
                return remaining;
        }
    }
}
release方法相关
用于**释放/增加permit**的方法。
//Semaphore#release
public void release() {
    sync.releaseShared(1);
}
//可以一次性释放/增加多个permit
public void release(int permits) {
    if (permits < 0) throw new IllegalArgumentException();
    sync.releaseShared(permits);
}

//AQS#releaseShared
public final boolean releaseShared(int arg) {
    if (tryReleaseShared(arg)) {
        signalNext(head);
        return true;
    }
    return false;
}

//Semaphore#tryReleaseShared
protected final boolean tryReleaseShared(int releases) {
    for (;;) {
        int current = getState();
        //注意:这里是直接增加releases数量的permit
        int next = current + releases;
        //如果releases数量过大,会溢出为负数
        if (next < current) // overflow
            throw new Error("Maximum permit count exceeded");
        if (compareAndSetState(current, next))
            return true;
    }
}
CountDownLatch
CountDownLatch用于让一个或多个线程等待,直到其他线程完成一组操作。
关键特性:一次性,不可重用。计数count一旦归零,无法重置。若需要可重用,请使用 CyclicBarrier。
CountDownLatch使用了AQS实现其同步器Sync。
在CountDownLatch中, AQS#state只在Sync的构造函数中被设定。一旦初始化,CountDownLatch没有提供其他方法修改state。
//调用 AQS 的方法,将state 初始化为传入的 count。
Sync(int count) {
    setState(count);
}
AQS 的 state 在这里表示“剩余需要 countDown 的次数”。
核心
//CountDownLatch#countDown
public void countDown() {
    //releaseShared 会调用 子类实现的 tryReleaseShared
    sync.releaseShared(1);
}

//CountDownLatch#await
public void await() throws InterruptedException {
    //acquireSharedInterruptibly 会调用 子类实现的 tryAcquireShared
    sync.acquireSharedInterruptibly(1);
}

private static final class Sync extends AbstractQueuedSynchronizer {
    protected int tryAcquireShared(int acquires) {
        //使当前线程进入等待状态,直到计数器归零或线程被中断。
        //返回-1:
        //tryAcquireShared 方法会阻塞当前线程,使其入队等待
        //返回0:
        //直接返回,不发生阻塞。
        return (getState() == 0) ? 1 : -1;
    }

    protected boolean tryReleaseShared(int releases) {
        //将计数器的值减1。如果减1后计数器变为0,则释放所有等待的线程。
        for (;;) {
            int c = getState();
            //当计数已经为0时,再次调用 countDown() 不会产生任何效果,直接返回 false
            if (c == 0)
                return false;
            int nextc = c - 1;
            //如果 tryReleaseShared 返回 true(意味着计数刚刚归零)
            //AQS 会遍历其内部的同步队列,传播式地唤醒(unpark)等待的线程。
            if (compareAndSetState(c, nextc))
                return nextc == 0;
        }
    }
}
Exchanger
Exchanger 是一个用于在两个线程之间进行数据交换的同步点。当两个线程需要在某个时刻相互交换它们持有的数据时,可以使用 Exchanger。如果只有其中一个线程执行了 exchange() 方法,它将会等待,直到另一个线程也执行此方法,然后双方再安全地交换数据。
可以用于:
- 生产者-消费者模型中的“双缓冲”交换。
- 并行计算中,两个工作线程阶段性地交换中间结果。
基本思想
- 每个参与交换的线程,要么是“提供者(offer)”,要么是“释放者(release)”。
- 数据结构中有一个“槽位(slot)”。
- 如果槽位为空,当前线程把自己的数据放入槽位,然后等待。
- 如果槽位非空,当前线程取走槽位中的数据,把自己的数据放入,并唤醒等待的线程。
这种“请求-匹配”模型在理论上非常优雅,代码注释中的伪代码清晰地描述了这一点:
//@Contended :在变量前后填充字节,使变量独占一个或多个完整的缓存行
//确保不同线程的 Node 不会落在同一个 CPU 缓存行(Cache Line)上,
//避免因缓存一致性协议导致的性能抖动。
//一个 Node 实例内部有多个 volatile 和非 volatile 字段。
//如果三个不同的 Node 对象NodeA、NodeB、NodeC在同一缓存行上,
//A B 配对。
//那么线程A 修改 NodeB.match (volatile),由于store-fence的影响,
//线程C 准备读取/写入 NodeC 时,会发现缓存行失效,需要更新
//但实际上,只有NodeB发生了变化,NodeC根本不需要更新,从而影响操作 NodeC 的线程C的性能。
@Contended
static final class Node {
    // 当前线程在 arena 中的索引
    int index;
    // 上次记录的 Exchanger.bound 值
    int bound;
    // 当前 bound 下的 CAS 失败次数
    int collides;
    // 用于自旋的伪随机种子
    int hash;

    // 本线程要交换的数据
    //因为对 item 的读写总是在 CAS 操作之后(happens-before原则),所以无需 volatile。
    Object item;

    // 对方线程传来的数据
    volatile Object match;

    // 如果阻塞,记录当前线程
    volatile Thread parked;
}

for (;;) {
  if (slot is empty) {        // offer
    //slot为空
    //将要交换的数据(item)放入一个 Node 对象中。
    //CAS 将slot 上的 空 替换为 node
    if (CAS(slot, empty, node)) {
      //CAS成功
      //阻塞等待,一直检查 Node 对象,看是否有另一个线程将配对的数据写入了 match 字段。
      //从 Node 中取出配对线程放入的 match 并返回
    }
  }
  //CAS 将slot 上的 node 替换为 空
  else if (CAS(slot, node, empty) { // release
    //CAS成功
    //从node 获得 数据
	//将自己要交换的数据设置到 Node 的 match 字段中。
    //(由于 match 字段是 volatile 的,这个写入对等待线程是立即可见的。)
    //唤醒(释放)正在等待的线程。
  }
}
优点:逻辑简单,线程成对匹配;使用 CAS 保证原子性,无锁。
缺点:所有线程竞争同一个 slot,在高并发下,CAS 失败率极高,导致大量自旋重试,CPU 资源浪费,性能急剧下降。
为什么不让两个线程都写对方的 Node.item?
每个线程只拥有自己的 Node,不知道对方的 Node 是哪个,除非通过 slot 指针。
通过“offer → release”模型,先到者占据 slot,后到者负责写入 match 并唤醒,逻辑清晰且无竞态。
数据结构
//V 泛型,描述需要交换数据的类型
public class Exchanger<V> {

    // 与 @Contended 效果类似:使Node在arena数组中尽可能不相邻
    // 只不过ASHIFT没有填充,而是稀疏分布这些元素
    // 仍然占用堆内存,但是不访问空洞,就不会把空洞加载到Cache Line
    // 可有效减少 false sharing

    private static final int ASHIFT = 5;

	//arena 最大索引掩码。最大支持 256 个 slot(0~255)
    private static final int MMASK = 0xff;

	//用于 bound 字段的版本控制。
    //bound 的高 24 位存储“序列号”,每次 arena 大小变化时递增,
    //用于检测 stale(过期)状态。
    private static final int SEQ = MMASK + 1;

    // 获取 CPU 核心数,用于:
	//决定是否启用 arena(单核时不启用)
	//控制自旋次数(多核才自旋)
    private static final int NCPU = Runtime.getRuntime().availableProcessors();

 	//arena 的最大有效索引。例如:
	//若 CPU ≥ 512(几乎不可能),则 FULL = 255
	//否则 FULL = NCPU / 2(如 8 核 → FULL = 4)
    static final int FULL = (NCPU >= (MMASK << 1)) ? MMASK : NCPU >>> 1;

	//线程在阻塞前的自旋次数。多核下先自旋/让出 CPU,避免立即阻塞(上下文切换开销大)。
    //1024 次是经验值,可覆盖 99% 的快速交换场景。
    private static final int SPINS = 1 << 10;

	//NULL_ITEM:因为 null 是合法的交换值,但内部逻辑需要区分“未设置”和“null 值”,所以用特殊对象代替。
	//TIMED_OUT:超时标志,避免为 timed 和 untimed 版本写两套逻辑。
    private static final Object NULL_ITEM = new Object();
    private static final Object TIMED_OUT = new Object();

    static final class Participant extends ThreadLocal<Node> {
        public Node initialValue() { return new Node(); }
    }

    // 每个线程的 Node
    private final Participant participant;
    // 消除竞争的 slot 数组
    //// 一旦检测到竞争(CAS 失败),初始化 arena。
    private volatile Node[] arena;
    // 初始单 slot,默认使用 slot
    private volatile Node slot;
    // bound = arena当前大小 + 版本号
    // bound 的低 8 位是最大索引,高 24 位是版本号,用于同步 arena 状态。
    private volatile int bound;


}
示例
Exchanger 实现双缓冲机制。
public class SimpleDoubleBuffer<T> {
    private final Exchanger<T> exchanger = new Exchanger<>();
    private final Thread producerThread;
    private final Thread consumerThread;

    public SimpleDoubleBuffer(T buffer1, T buffer2,
                             Consumer<T> producerTask,
                             Consumer<T> consumerTask) {

        producerThread = new Thread(() -> {
            T currentBuffer = buffer1;
            try {
                while (!Thread.currentThread().isInterrupted()) {
                    // 生产数据
                    producerTask.accept(currentBuffer);
                    // 交换缓冲区
                    currentBuffer = exchanger.exchange(currentBuffer);
                }
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });

        consumerThread = new Thread(() -> {
            T currentBuffer = buffer2;
            try {
                while (!Thread.currentThread().isInterrupted()) {
                    // 交换缓冲区
                    currentBuffer = exchanger.exchange(currentBuffer);
                    // 消费数据
                    consumerTask.accept(currentBuffer);
                }
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });
    }

    public void start() {
        producerThread.start();
        consumerThread.start();
    }

    public void stop() {
        producerThread.interrupt();
        consumerThread.interrupt();
    }
}

// 使用示例
public class DoubleBufferExample {
    public static void main(String[] args) {
        SimpleDoubleBuffer<byte[]> doubleBuffer = new SimpleDoubleBuffer<>(
            new byte[1024],  // 缓冲区1
            new byte[1024],  // 缓冲区2
            buffer -> {      // 生产者任务
                // 填充缓冲区数据
                Arrays.fill(buffer, (byte)1);
                System.out.println("Produced data");
            },
            buffer -> {      // 消费者任务
                // 处理缓冲区数据
                System.out.println("Consumed data");
            }
        );

        doubleBuffer.start();
    }
}
CyclicBarrier
CyclicBarrier 是一个同步辅助工具,用于让一组固定数量的线程彼此等待,直到所有线程都到达某个“屏障点”后,才能继续执行。
和CountDownLatch类似,但是提供的特性更加现代化,而且实现原理却完全不同,CyclicBarrier 内部使用的是 ReentrantLock + Condition 实现的等待/通知模式。
关键特性:
- 可重用(Cyclic):一旦所有线程通过屏障,屏障可以被重置并再次使用。
- 屏障动作(Barrier Action):在最后一个线程到达屏障后、其他线程被释放前,可以执行一个
Runnable。 - 全有或全无(All-or-None)策略:如果任一线程因为中断、超时或异常提前离开屏障,所有其他等待线程也会失败(抛出
BrokenBarrierException),屏障进入“损坏”状态。
这种设计非常适合并行迭代算法,例如矩阵计算中每一轮所有线程处理完自己的部分后,需同步再进入下一轮。
数据结构
//使用 ReentrantLock 保证所有状态修改的线程安全。
//为什么不用 synchronized?因为需要配合 Condition 实现更灵活的等待/通知机制
private final ReentrantLock lock = new ReentrantLock();

//Condition 对象,用于让线程在未达到屏障时挂起等待。
//当最后一个线程到达时,调用 trip.signalAll() 唤醒所有等待线程。
private final Condition trip = lock.newCondition();

//固定值,表示必须调用 await() 的线程总数。
//构造时传入,不可变,确保屏障规模固定。
private final int parties;

//可选,
//在最后一个线程到达屏障、其他线程被唤醒 前 被 最后到达的线程 执行。
private final Runnable barrierCommand;


//指向当前轮次的 Generation 对象。
//屏障每次触发或重置时更新。
private Generation generation = new Generation();

//倒计数器,初始值为 parties。
//每有线程调用 await(),count--
private int count;
内部类 Generation
private static class Generation {
    Generation() {}
    //broken 字段表示当前这一代屏障是否已损坏(例如有线程中断或超时)。
    boolean broken;
}
Generation 表示一次屏障使用周期(即一轮等待)。
每次屏障被 触发 或 重置 时,会创建一个新的 Generation 实例。
核心方法dowait
public int await() throws InterruptedException, BrokenBarrierException {
    try {
        //调用dowait
        return dowait(false, 0L);
    } catch (TimeoutException toe) {
        throw new Error(toe); // cannot happen
    }
}


private int dowait(boolean timed, long nanos)
    throws InterruptedException, BrokenBarrierException,
           TimeoutException {
    final ReentrantLock lock = this.lock;
    lock.lock(); // (1) 获取锁
    try {
        final Generation g = generation; // (2) 捕获当前代

        // (3) 检查屏障是否已损坏
        if (g.broken)
            throw new BrokenBarrierException();

        // (4) 检查当前线程是否已被中断
        if (Thread.interrupted()) {
            breakBarrier(); // (4a) 破坏屏障
            throw new InterruptedException();
        }

        // (5) 当前线程到达,倒计数器减一
        int index = --count;
        if (index == 0) {  // (6) 当前线程是最后一个到达的
            Runnable command = barrierCommand;
            if (command != null) {
                try {
                    command.run(); // (6a) 负责执行屏障动作
                } catch (Throwable ex) {
                    breakBarrier(); // (6b) 动作失败,破坏屏障
                    throw ex;
                }
            }
            nextGeneration(); // (6c) 进入下一代,唤醒所有线程
            return 0; // (6d) 返回0,表示最后一个到达
        }

        // (7) 不是最后到达的线程,循环等待,直到被唤醒、屏障损坏、中断或超时
        for (;;) {
            try {
                if (!timed)
                    trip.await(); // (7a) 无限期等待
                else if (nanos > 0L)
                    nanos = trip.awaitNanos(nanos); // (7b) 限时等待
            } catch (InterruptedException ie) {
                // (8) 处理在等待中被中断的情况
                //g == generation:意味着屏障没有 成功触发nextGeneration 或 被重置而进入新的一代。
				//!g.broken:意味着屏障没有被其他原因破坏。
                //只有同时满足这两个条件,才说明是“本次等待”被中断了,因此需要破坏屏障
                if (g == generation && ! g.broken) {
                    breakBarrier(); // (8a) 如果屏障还在同一代且未损坏,则破坏它
                    throw ie;
                } else {
                    // (8b) 否则,认为中断属于后续操作(发生在await返回后),
                    // 只需设置中断状态
                    Thread.currentThread().interrupt();
                }
            }

            // (9) 检查被唤醒后的各种情况
            if (g.broken) // (9a) 屏障已损坏
                throw new BrokenBarrierException();

            if (g != generation) // (9b) 屏障已进入下一代(成功触发)
                return index;

            if (timed && nanos <= 0L) { // (9c) 限时等待超时
                breakBarrier();
                throw new TimeoutException();
            }
        }
    } finally {
        lock.unlock(); // (10) 释放锁
    }
}
示例
import java.util.concurrent.BrokenBarrierException;
import java.util.concurrent.CyclicBarrier;

public class WorkerExample {
    // 共享数据
    private static int[] globalData = new int[100];
    // 需要4个工人
    private static final int NUM_WORKERS = 4;
    // 每个工人负责处理的数据块大小
    private static final int CHUNK_SIZE = globalData.length / NUM_WORKERS;

    // 定义屏障动作:由最后一个到达的线程执行,用于汇总本轮结果
    private static Runnable barrierAction = () -> {
        int sum = 0;
        for (int value : globalData) {
            sum += value;
        }
        System.out.println("本轮处理完成,数据总和为: " + sum);
    };

    // 创建CyclicBarrier,指定4个参与者和屏障动作
    private static CyclicBarrier barrier = new CyclicBarrier(NUM_WORKERS, barrierAction);

    public static void main(String[] args) {
        // 初始化数据
        for (int i = 0; i < globalData.length; i++) {
            globalData[i] = 0;
        }

        // 创建并启动4个工人线程
        Thread[] workers = new Thread[NUM_WORKERS];
        for (int i = 0; i < NUM_WORKERS; i++) {
            workers[i] = new Thread(new Worker(i));
            workers[i].start();
        }

        // 等待所有工人完成
        for (Thread worker : workers) {
            try {
                worker.join();
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }

    static class Worker implements Runnable {
        private final int id;
        private final int startIndex;
        private final int endIndex;

        Worker(int id) {
            this.id = id;
            this.startIndex = id * CHUNK_SIZE;
            this.endIndex = (id == NUM_WORKERS - 1) ? globalData.length : (id + 1) * CHUNK_SIZE;
        }

        @Override
        public void run() {
            try {
                for (int round = 1; round <= 3; round++) { // 进行3轮处理
                    // 模拟工作:将自己的数据块中的值加1
                    for (int i = startIndex; i < endIndex; i++) {
                        globalData[i] += 1;
                    }
                    System.out.println("工人 " + id + " 完成第 " + round + " 轮工作");
                    // 等待所有工人完成本轮工作
                    barrier.await();
                }
            } catch (InterruptedException | BrokenBarrierException e) {
                e.printStackTrace();
            }
        }
    }
}
Phaser
Phaser 提供了对动态数量的线程的同步能力。
这与 CyclicBarrier 和 CountDownLatch 不同,因为它们都需要预先知道等待的线程数量。Phaser 是多阶段的,意味着它可以同步不同阶段的多个操作。
CyclicBarrier 和 CountDownLatch 指定完count/parties后,就无法修改,但 Phaser 可以动态地调整 count/parties !
核心方法
以下是 Phaser 的几个关键方法:
register() |
注册一个新参与者,增加parties数量 |
arrive() |
当前参与者到达同步点,但不阻塞 |
arriveAndAwaitAdvance() |
当前参与者到达并阻塞等待其他参与者,直到本阶段完成 |
arriveAndDeregister() |
到达并注销自己,不再参与后续阶段 |
getPhase() |
获取当前阶段编号(从 0 开始,每完成一阶段加 1) |
isTerminated() |
判断 Phaser 是否已终止(所有参与者都已注销) |
Party(参与者): 指的是注册到 Phaser 上的一个任务或线程。
Phaser:整个同步过程被划分为多个“阶段”(Phase)。所有注册的 Party 必须在当前 Phase 全部到达(arrive),才能触发 Phase 推进(advance)到下一阶段。Party只能通过arriveAndDeregister()注销,注册后必须到达一次。
当所有参与者都注销后,Phaser 进入终止状态,后续调用 arriveAndAwaitAdvance() 会立即返回,不再阻塞。
可通过重写 onAdvance(int phase, int registeredParties) 方法,在每个阶段结束时执行自定义逻辑(如判断是否终止)。
示例
Phaser phaser = new Phaser(1); // 初始1个参与者(主线程)

// 启动工作线程
for (int i = 0; i < 3; i++) {
    phaser.register(); // 注册新参与者
    new Thread(() -> {
        System.out.println("Phase " + phaser.getPhase() + ": do work");
        phaser.arriveAndAwaitAdvance(); // 等待本阶段结束

        System.out.println("Phase " + phaser.getPhase() + ": do more work");
        phaser.arriveAndDeregister(); // 完成并注销
    }).start();
}

phaser.arriveAndAwaitAdvance(); // 主线程等待第一阶段
phaser.arriveAndAwaitAdvance(); // 等待第二阶段(此时工作线程已注销)

System.out.println("Phaser terminated: " + phaser.isTerminated());
HashTable
Hashtable 的大多数公有方法都是用 synchronized 修饰,也就是说,整个表实例是一个全局锁,任一线程在执行 get/put/remove/size/clear/... 等方法时,会独占该 Hashtable 对象的锁。换句话说:任何一次对表的读或写都会与任何其它对表的读/写互斥。
实现简单、安全,但并发性差,高并发下会成为全表锁瓶颈(多线程频繁访问会串行化)。
此外,迭代器/枚举在外部使用时并不会一直持锁(返回枚举/迭代器后,用户可以在没有锁的情况下遍历,其他线程修改会影响枚举结果),行为与 Collections.synchronizedMap 类似,需要外部再次使用同步手段,以获得强一致性。
ConcurrentHashMap
1.7 Segment + Lock
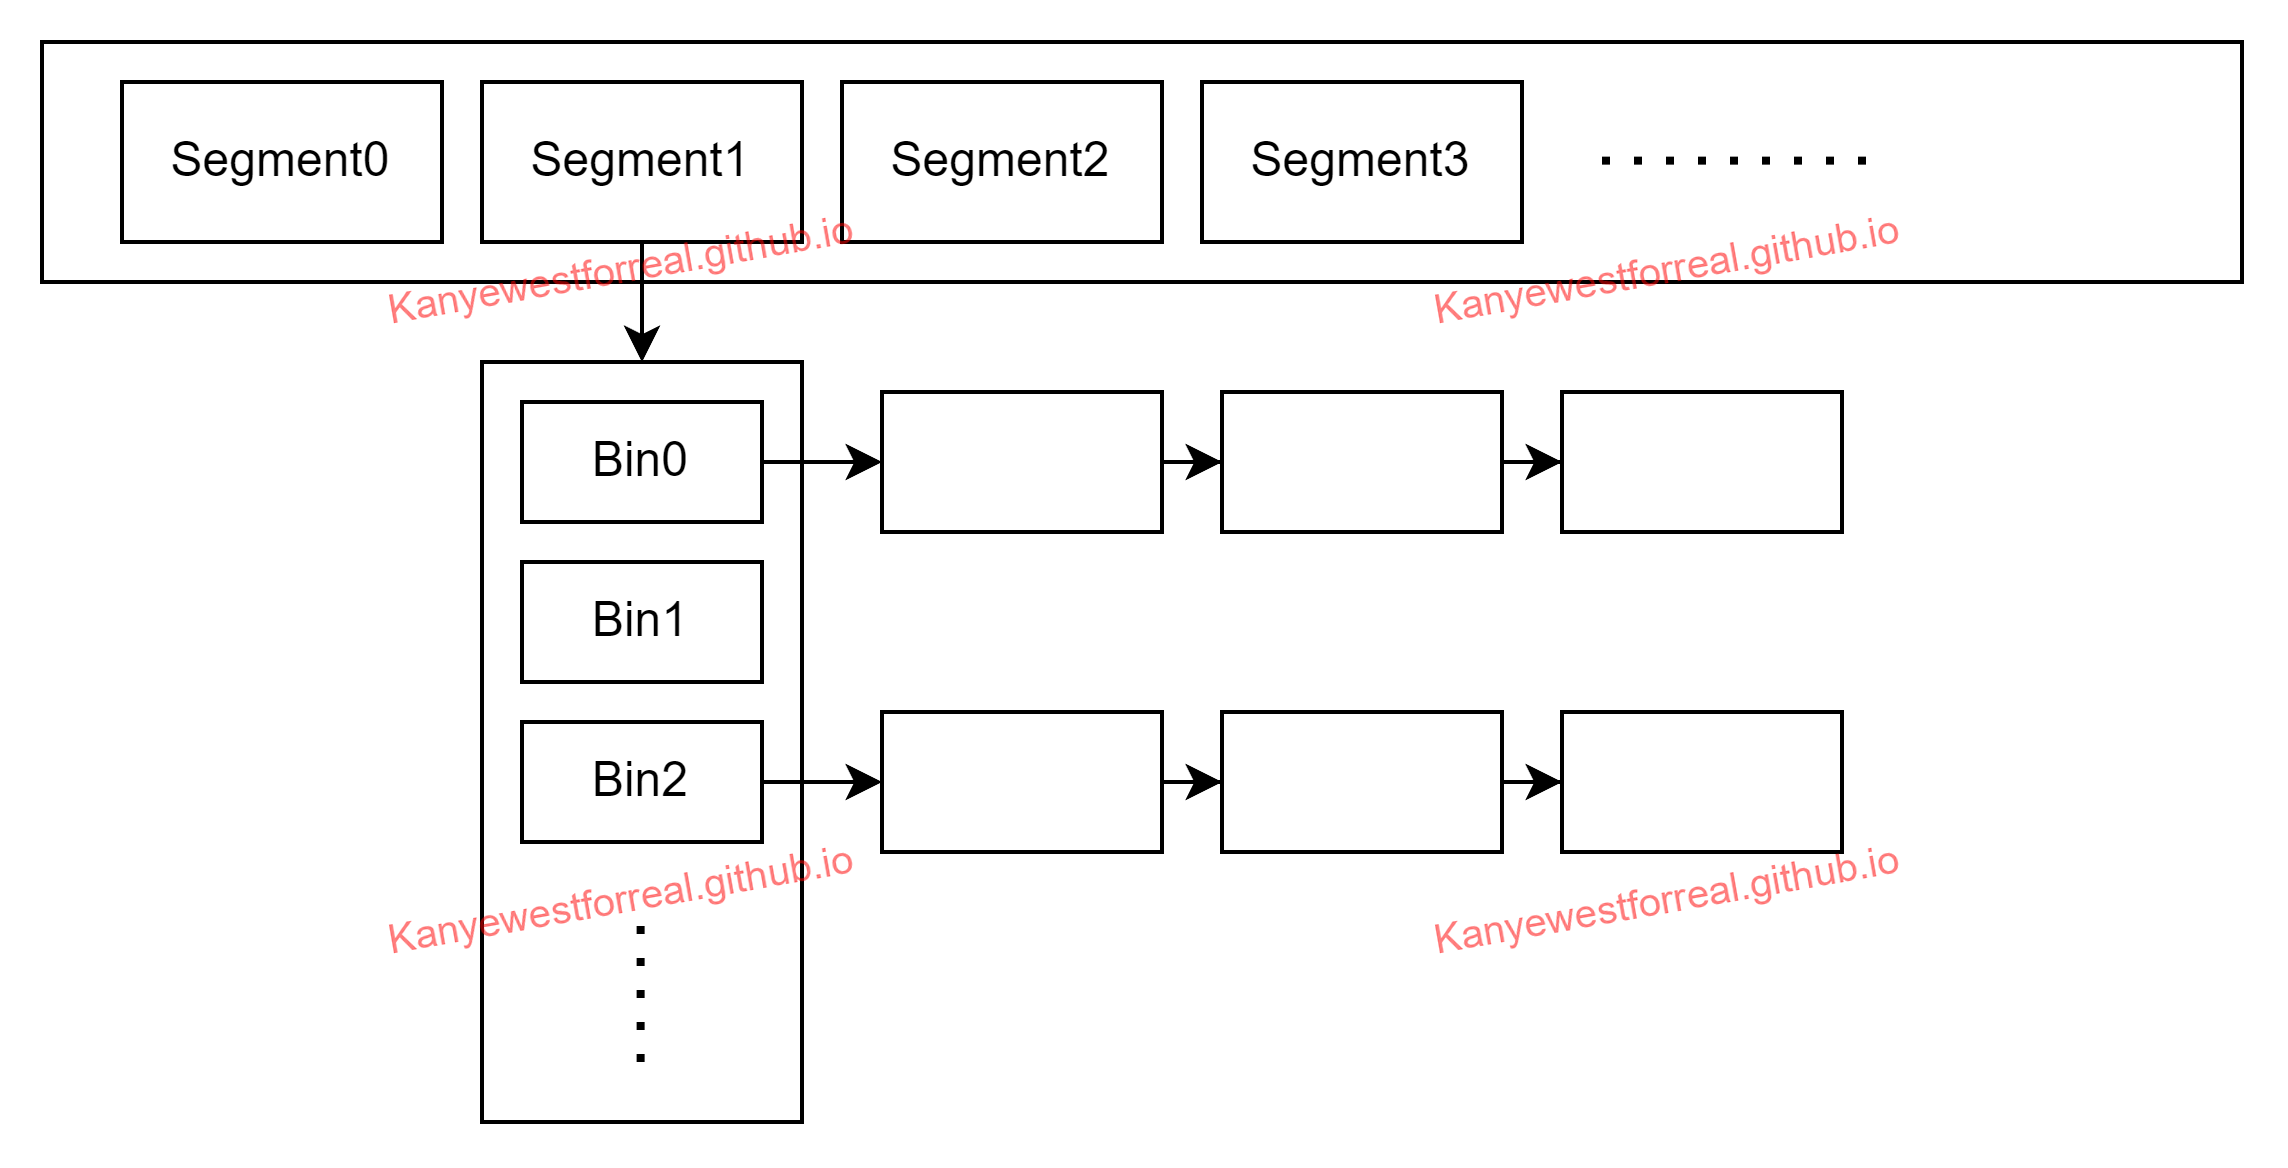
16 个独立的小 HashMap,每个小 HashMap 自己扩容,每个有自己的锁。
Segment 继承了 ReentrantLock,所以 Segment 内部可以很方便的获取锁。
ConcurrnetHashMap 由多个 Segment 组合成,而每一个 Segment 是类似于一个 HashMap 的结构,所以Segment内部像 HashMap一样,可以有多个Bin桶,可以进行扩容添加Bin,Bin也可以作为链表头。
数据就存放在Segment指向的HashEntry数组内,如果产生hash冲突,就会形成链表。
但是 Segment 的个数一旦初始化后就不能改变,默认 Segment 的个数是 16 个,可以认为 ConcurrentHashMap 默认支持 16 个线程并发操作。
JDK1.7 的 ConcurrentHashMap#put 使用头插法不会造成死循环,因为所有 put 和 rehash 操作都在 Segment 锁内进行,一个Segment同时间只能被同一个线程获取。
Segment 数组 + HashEntry 数组 + 链表。(没有使用红黑树)
1.8 Bin + Synchronized
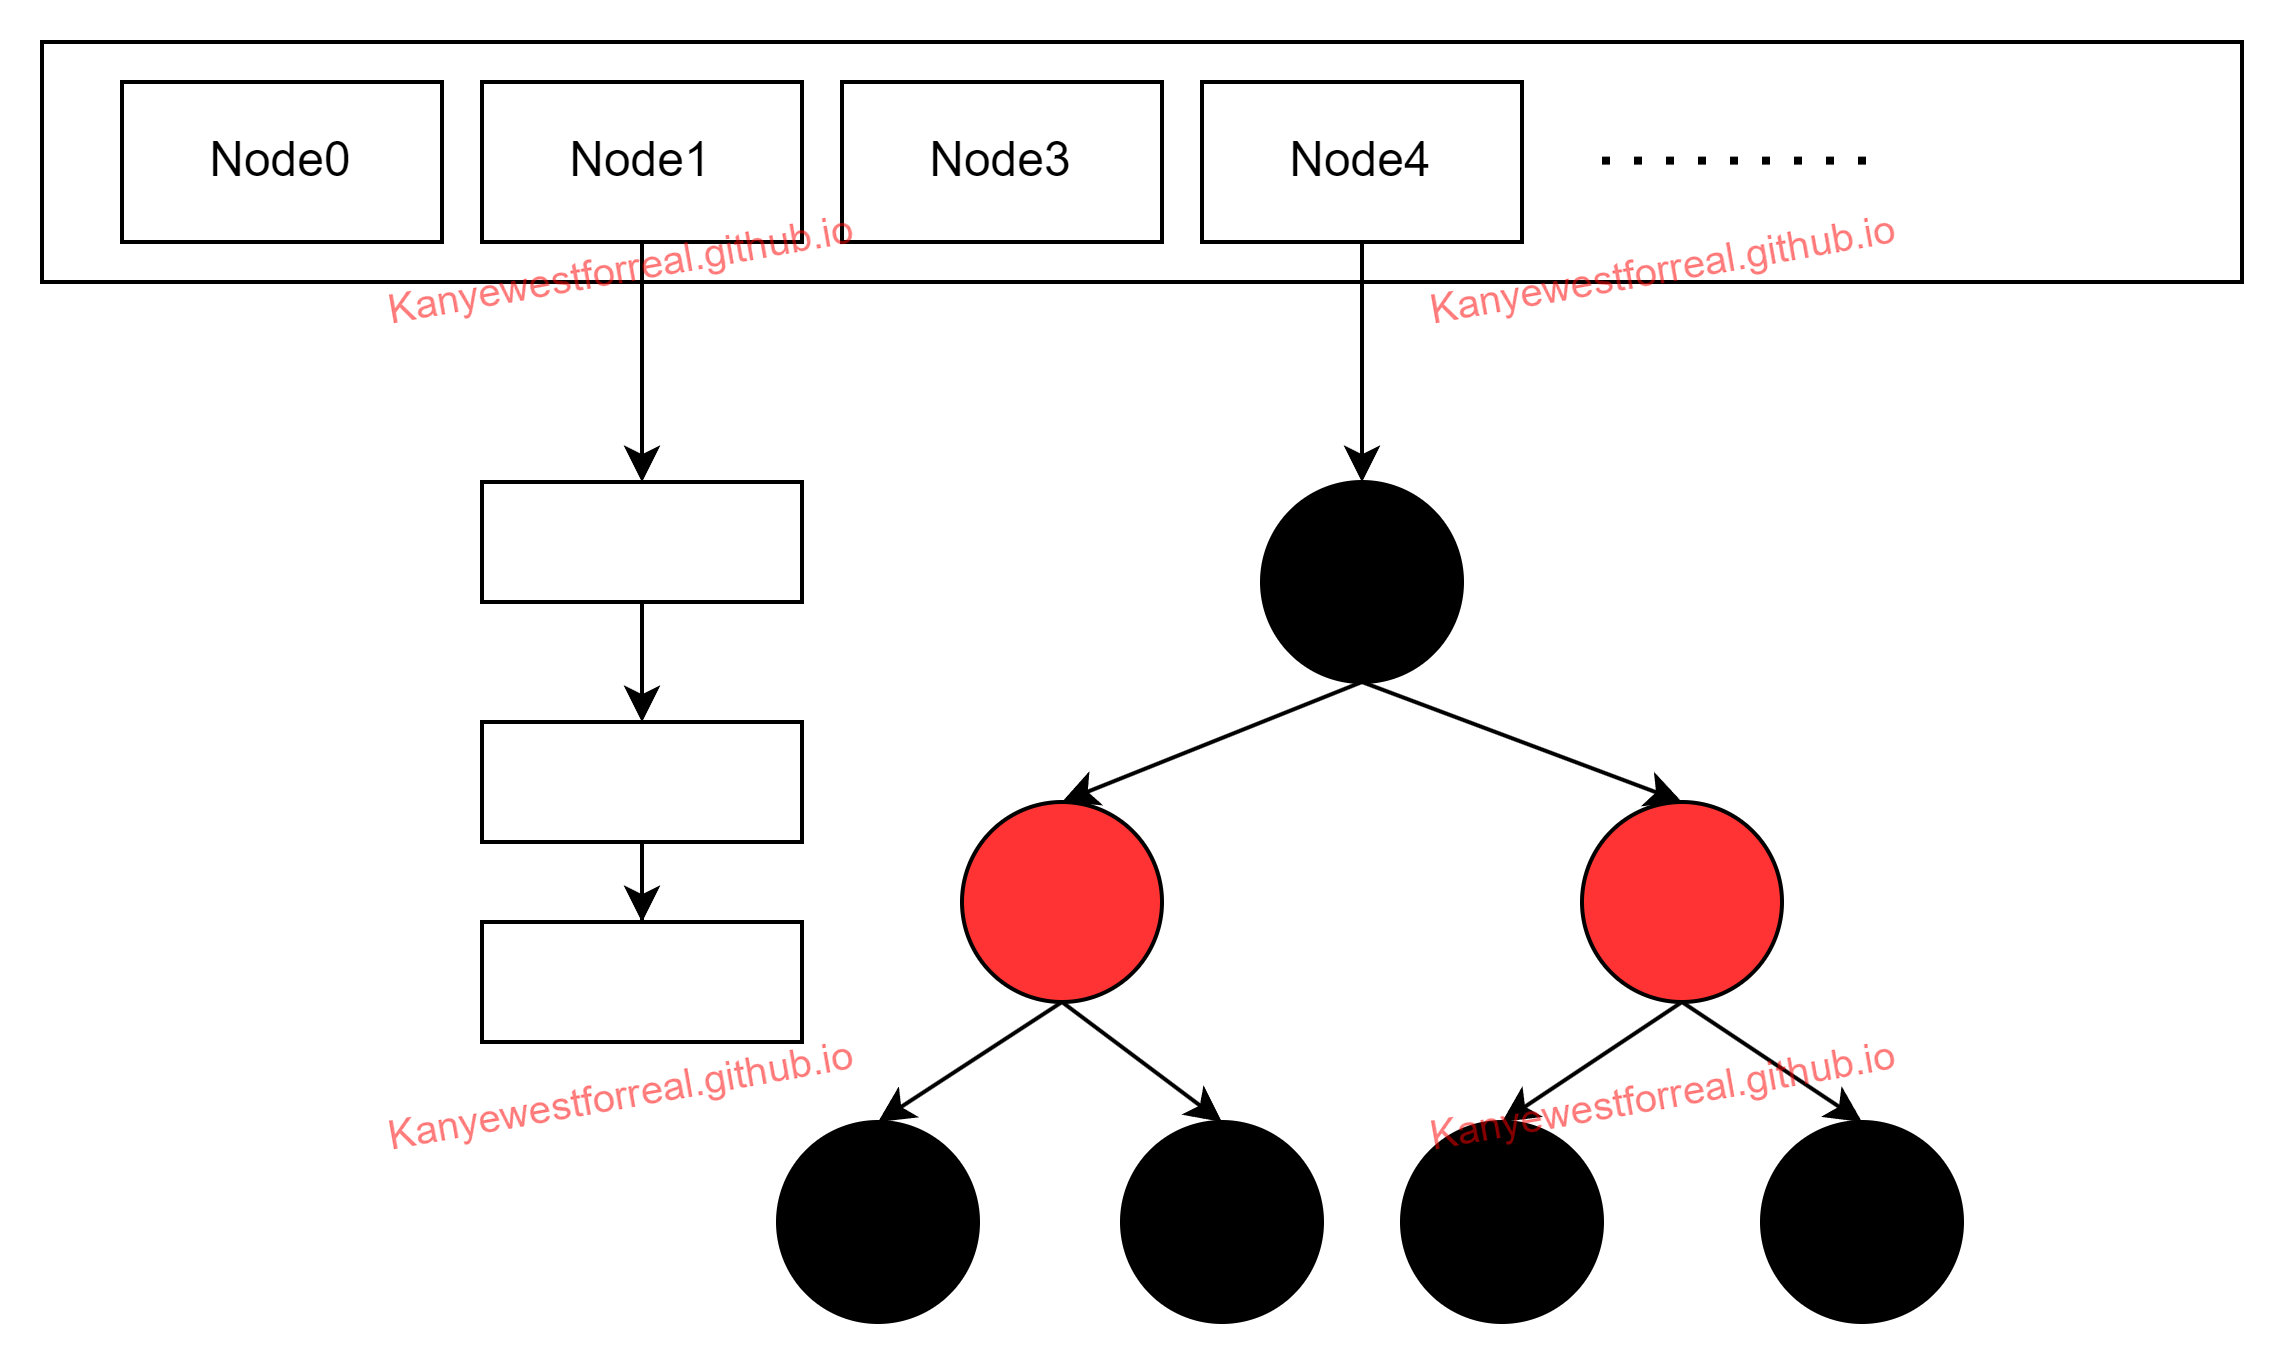
Node 数组 + 链表 / 红黑树。和1.8版本的HashMap的数据结构一致。
1.8版本的锁的颗粒度,比1.7的更细。1.8的锁仅影响一个Bin(Node),1.7的锁可能会同时影响多个Bin(一个Segment可以有多个Bin)。因此高并发性能更好。
以下源码出自Java17
Node类型
都是桶头的特殊类型
| 节点类型 | hash | 作用 | 解决的问题 |
|---|---|---|---|
TreeBin |
TREEBIN = -2 |
红黑树根节点的并发代理 | 树结构调整期间的读一致性 & 读不阻塞 |
ForwardingNode |
MOVED = -1 |
扩容时的跳转新表指针 | 并发扩容时的正确读写 & 多线程协作 |
ReservationNode |
RESERVED = -3 |
computeIfAbsent的占位符 |
原子性计算插入 & 防止重复计算/递归 |
TreeBin
TreeBin是红黑树的“包装器”,非真正的数据节点。
当某个桶中的链表长度 ≥ 8(TREEIFY_THRESHOLD)且总表容量 ≥ 64(MIN_TREEIFY_CAPACITY)时,为避免 O(n) 查找性能退化,将链表转为红黑树。
但红黑树的根节点本身不能直接放在 table[i] 中作为“头节点”,因为:
- 红黑树节点结构复杂(有 parent/left/right 等字段),遍历方式与链表不同;
- 在并发读取时,如果此时正在进行树的旋转(如插入/删除导致 rebalance),读线程可能看到不一致的中间状态(根节点的指向不稳定)。
作用
- 它不是数据节点,而是红黑树的并发安全“代理”。它持有真正的红黑树根节点
root,同时保留一个first字段指向原始链表的第一个节点(用于迭代器兼容)。 - 实现了读写锁机制(非
ReentrantReadWriteLock,而是自实现的基于lockState的轻量级自旋锁):- 读操作(如
get):若未在写,可直接走红黑树查找; - 写操作(如
putTreeVal):需获取写锁,阻塞写,但不阻塞读(读可以退化为链表遍历)。
- 读操作(如
//构造函数,会把传入的链表头节点,展开真正的红黑树化
TreeBin(TreeNode<K,V> b) {
    super(TREEBIN, null, null);
    this.first = b;
    TreeNode<K,V> r = null;
    for (TreeNode<K,V> x = b, next; x != null; x = next) {
        next = (TreeNode<K,V>)x.next;
        x.left = x.right = null;
        if (r == null) {
            x.parent = null;
            x.red = false;
            r = x;
        }
        else {
            K k = x.key;
            int h = x.hash;
            Class<?> kc = null;
            for (TreeNode<K,V> p = r;;) {
                int dir, ph;
                K pk = p.key;
                if ((ph = p.hash) > h)
                    dir = -1;
                else if (ph < h)
                    dir = 1;
                else if ((kc == null &&
                          (kc = comparableClassFor(k)) == null) ||
                         (dir = compareComparables(kc, k, pk)) == 0)
                    dir = tieBreakOrder(k, pk);
                TreeNode<K,V> xp = p;
                if ((p = (dir <= 0) ? p.left : p.right) == null) {
                    x.parent = xp;
                    if (dir <= 0)
                        xp.left = x;
                    else
                        xp.right = x;
                    r = balanceInsertion(r, x);
                    break;
                }
            }
        }
    }
    this.root = r;
    assert checkInvariants(root);
}
//TreeBin#find
final Node<K,V> find(int h, Object k) {
    if (k != null) {
        for (Node<K,V> e = first; e != null; ) {
            int s; K ek;
            //判断是否获取到写锁
            if (((s = lockState) & (WAITER|WRITER)) != 0) {
                // 有写锁 → 走链表查找
                // 有写锁,可能红黑树在结构变更,而链表是“只增不改链接”的(改链接也是尾部插入)
                // 所以在任意时刻,链表遍历都是安全的。
                // 时间复杂度On
                if (e.hash == h && ((ek = e.key) == k || (ek != null && k.equals(ek))))
                    return e;
                e = e.next;
            }
            else if (U.compareAndSetInt(...)) {
                // 无写锁 → 走红黑树查找 时间复杂度Ologn
                TreeNode<K,V> r, p;
                p = ((r = root) == null ? null : r.findTreeNode(h, k, null));
                ...
            }
        }
    }
}
ForwardingNode
ConcurrentHashMap 在扩容(transfer)时,不是一次性完成,而是分段迁移,允许其他线程同时读写。
当某个桶(如 table[i])的数据已经迁移到 nextTable 后,原位置不能留空(否则并发读会丢失数据)。
作用
- 标记该桶已完成迁移:其
hash = MOVED = -1,是一个特殊标识。 - 引导后续操作跳转到新表,任何线程访问该桶时,发现是
ForwardingNode,就会:- 读操作:自动去
nextTable中查找; - 写操作:要么协助扩容(
helpTransfer),要么在新表中插入。
- 读操作:自动去
public V get(Object key) {
    ...
    if ((eh = e.hash) == MOVED)
        return (p = e.find(h, key)) != null ? p.val : null;
}

// ForwardingNode.find() 会递归跳转到 nextTable
Node<K,V> find(int h, Object k) {
    outer: for (Node<K,V>[] tab = nextTable;;) {
        ...
        if (e instanceof ForwardingNode) {
            tab = ((ForwardingNode<K,V>)e).nextTable;
            continue outer;
        }
    }
}
ReservationNode/computeIfAbsent
考虑 computeIfAbsent(key, mappingFunction) 的语义:
如果 key 不存在,则原子性地调用
mappingFunction计算出 value 并插入。
但问题在于:从判断“不存在”到插入新值这个步骤之间,如果有其他线程也插入了同一个 key,就会冲突。
作用
- 在 CAS 成功将桶头从
null变为ReservationNode后,用临时节点占据该桶,表示“此 key 正在被计算”。 - 同一线程相同key,看到
ReservationNode,抛异常(避免递归调用) - 其他线程调用
computeIfAbsent:- 如果是相同 key → 等待f锁的释放;
- 如果是不同 key → 正常流程(除非不同key,但是hash相同,回到上述情况)。
ConcurrentHashMap<String, String> map = new ConcurrentHashMap<>();
map.computeIfAbsent("A", k -> {
    // 此时 table[xx] = ReservationNode (hash = RESERVED = -3)
    // 当前线程持有 synchronized(r)

    // 如果这里递归调用:
    return map.computeIfAbsent("A", k2 -> "C"); // ← 同key,第二次调用
    //计算 hash,定位到同一个桶,抛出异常,阻止递归
});

public V computeIfAbsent(K key, Function<? super K, ? extends V> mappingFunction) {
    //...
    Node<K,V> r = new ReservationNode<K,V>();
    synchronized (r) {
        //synchronized (r) 看上去是一个局部变量,但也起到了临时锁的作用,阻塞其他线程,获取f锁
        //这里CAS null被替换为r,r作为临时桶头
        //其他线程发现桶不为空,走到下面else分支被阻塞,直到r被替换为其他节点,释放r锁
        if (casTabAt(tab, i, null, r)) {
            binCount = 1;
            Node<K,V> node = null;
            try {
                if ((val = mappingFunction.apply(key)) != null)
                    node = new Node<K,V>(h, key, val);
            } finally {
                setTabAt(tab, i, node);// 替换为真实节点或 null
            }
        }
    }
    //...
	//如果mappingFunction函数内部(同一线程)再次调用computeIfAbsent(key),
    //会发现桶中是 ReservationNode,立即抛出异常,从而打断递归。
    else {
        //同一线程递归调用时:由于f锁重入,得以判断桶中是 ReservationNode,从而抛出异常
        //不同线程调用时,即使是同一个key,由于没有f锁(r锁),需要等待,不会抛出异常(取到f锁时,桶不再是ReservationNode)
        synchronized (f) {
            //...
            else if (f instanceof ReservationNode)
                throw new IllegalStateException("Recursive update");
            //...
        }
    }
    //...
}
这里 synchronized (r) 是对一个临时对象加锁,目的是防止同一个线程递归调用 computeIfAbsent(导致死锁或重复计算)和保证替换节点的原子性。
sizectl/resizeStamp
sizectl 是 ConcurrentHashMap 中最关键的状态控制字段之一。它是一个 volatile int 类型变量,在不同阶段承载着完全不同的语义。
sizeCtl 的作用与语义
1. 初始化阶段(table == null)
sizeCtl = 0:表示未初始化。如果初始化,那么使用默认容量(16)。
2. 初始化进行中
sizeCtl = -1:表示正在初始化 table。
- 只有一个线程能 CAS 成功将
sizeCtl从正数设为 -1,获得初始化权 - 其他线程看到 -1 就
Thread.yield()等待
3. 正常运行阶段
sizeCtl > 0:表示下次触发扩容的阈值(threshold)。
- 初始值 =
0.75 * n(n 为刚扩容完的 table 长度/默认容量) - 例如 table 长度为 16 →
sizeCtl = 12。那么当元素数量 ≥ 12 时,触发 resize
4. 扩容进行中
sizeCtl < -1:表示正在扩容
-
其中:
-
resizeStamp(n):对当前容量n生成一个唯一的扩容纳代戳(generation stamp) -
sc<0正确语义:高 16 位:generation stamp(确保不同扩容周期互不干扰)低 16 位:表示当前参与扩容的线程数 + 1 -
static final int resizeStamp(int n) {
    return Integer.numberOfLeadingZeros(n)
        | (1 << (RESIZE_STAMP_BITS - 1));
//n 是原表容量(2 的幂),numberOfLeadingZeros(n) 是n在二进制前导零个数。
//1 << (RESIZE_STAMP_BITS - 1) //保证最高位(符号位)为1,返回结果为负
//返回结果需要stamp << RESIZE_STAMP_BITS,然后+扩容线程数,才是sc<0正确语义
-
initTable
使用了Lock-free的思想,CAS+自旋保证初始化的正确性。
private final Node<K,V>[] initTable() {
    Node<K,V>[] tab; int sc;
    while ((tab = table) == null || tab.length == 0) {
        //sc<0说明正在初始化/正在扩容
        if ((sc = sizeCtl) < 0)
            Thread.yield(); // lost initialization race; just spin
        //sc默认为0,检查发现sizectl为0,说明还没初始化
        else if (U.compareAndSetInt(this, SIZECTL, sc, -1)) {
            try {
                if ((tab = table) == null || tab.length == 0) {
                    int n = (sc > 0) ? sc : DEFAULT_CAPACITY;
                    @SuppressWarnings("unchecked")
                    Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                    table = tab = nt;
                    //计数触发扩容的阈值
                    //n >>> 2 = n/4
                    sc = n - (n >>> 2);
                }
            } finally {
                sizeCtl = sc;
            }
            break;
        }
    }
    return tab;
}
setTabAt
使用Unsafe实现的volatile写。
static final <K,V> void setTabAt(Node<K,V>[] tab, int i, Node<K,V> v) {
    U.putReferenceRelease(tab, ((long)i << ASHIFT) + ABASE, v);
}
putVal
static final int spread(int h) {
    //高位参与低位运算,让 hash 值分布更均匀
    return (h ^ (h >>> 16)) & HASH_BITS;
}
//为什么要 & HASH_BITS(即 0x7fffffff):强制最高位为 0。
//因为 ConcurrentHashMap 用最高位(符号位)作为特殊节点的标记(如 MOVED = -1, TREEBIN = -2),实际数据节点必须保证 hash >= 0。

//onlyIfAbsent:若为 true,则只在 key 不存在时才插入(用于 putIfAbsent);
//否则覆盖已有值。
final V putVal(K key, V value, boolean onlyIfAbsent) {
    //key / value:不允许为 null,这是与 HashMap 的重要区别
    //(避免语义歧义:未来调用get(key)返回null,在并发情况下无法区分“未存在”还是“值为 null”)。
    // 单线程可以使用containKey判断,但是多线程使用containKey判断依然会出现歧义(一查一放)。
    if (key == null || value == null) throw new NullPointerException();
    //扰动/散列:高位参与低位运算,让 hash 值分布更均匀
    int hash = spread(key.hashCode());
    int binCount = 0;
    //使用 无限 for 循环 + CAS 重试 模式,经典lock-free
    //tab 是局部变量缓存 table,减少 volatile 读开销
    for (Node<K,V>[] tab = table;;) {
        Node<K,V> f; int n, i, fh; K fk; V fv;
        if (tab == null || (n = tab.length) == 0)
            //懒初始化
            tab = initTable();
        //hash不冲突,空桶
        else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
            //空桶直接 CAS 插入:这是最常见、最高效的路径
            if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value)))
                break;
        }
        //桶头处hash冲突
        //而且桶头是 ForwardingNode(其hash = MOVED = -1),说明正在扩容
        else if ((fh = f.hash) == MOVED)
            //当前线程协助扩容
            tab = helpTransfer(tab, f);
        //如果是 非覆盖(不存在key才存值)模式 && key匹配上了桶头 && 值不为空 那么返回值
        //这里依然是without lock
        else if (onlyIfAbsent
                 && fh == hash
                 && ((fk = f.key) == key || (fk != null && key.equals(fk)))
                 && (fv = f.val) != null)
            return fv;
        //否则 hash冲突 && 没有在扩容 && 覆盖模式
        else {
            V oldVal = null;
            //这里才上锁,锁对象为桶头
            //对比 HashTable / Collections.synchronizedMap 的全局锁,提高并发上限
            //为什么能锁 Node?因为桶头在生命周期内不会被替换(除非扩容),具有稳定性。
            synchronized (f) {
                //双重检查:防止ABA问题,再次确保桶头没有被替换
                if (tabAt(tab, i) == f) { //double-checking
                    if (fh >= 0) { //普通链表,hash >= 0
                        binCount = 1;
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            //尾插法
                            //保存e
                            Node<K,V> pred = e;
                            //e = e后继,如果e后继是空,说明e是链表尾
                            if ((e = e.next) == null) {
                                //e接上新节点
                                pred.next = new Node<K,V>(hash, key, value);
                                break;
                            }
                        }
                    }
                    else if (f instanceof TreeBin) {
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f)
                             .putTreeVal(hash, key,value)) != null) {
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                    else if (f instanceof ReservationNode)
                        throw new IllegalStateException("Recursive update");
                }
            }
            if (binCount != 0) {
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i);
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount);
    return null;
}
get
- ❓
get为什么不需要加锁?
→ 因为所有写操作对table、Node.val、Node.next的修改都是 volatile 写或 CAS + volatile 写,而get使用 volatile 读,天然满足内存可见性。 - ❓ 扩容期间
get如何工作?
→ 遇到ForwardingNode(hash = -1),自动跳转到nextTable继续查找。 - ❓ 红黑树读操作会阻塞吗?
→ 不会长期阻塞。TreeBin使用一种“伪读写锁”(基于lockState的 CAS);若获取读锁失败,则降级为遍历链表(因TreeNode有next指针)。 - ❓ 为什么不允许
null键/值?
→ 避免get(key)==null无法区分“key 不存在”还是“值为 null”,在并发环境下会导致语义混乱和竞态条件。
//没有使用锁
//使用volatile读实现
public V get(Object key) {
    Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek;
    //扰动:与 putVal 保持一致的关键步骤,确保获得正确的hash
    int h = spread(key.hashCode());
    //table 已初始化(非 null)
	//表长度 > 0(避免除零或数组越界)
	//目标桶((n-1) & h)非空
    if ((tab = table) != null && (n = tab.length) > 0 &&
        //tabAt使用 Unsafe.getReferenceAcquire 实现 volatile 读语义,防止脏读
        (e = tabAt(tab, (n - 1) & h)) != null) {
        //桶就是要找的,直接返回(如果是特殊节点,hash不会等于h)
        if ((eh = e.hash) == h) {
            if ((ek = e.key) == key || (ek != null && key.equals(ek)))
                return e.val;
        }
        //如果 e.hash < 0,说明是特殊节点
        else if (eh < 0)
            //调用 e.find(h, key),由具体子类实现
            return (p = e.find(h, key)) != null ? p.val : null;
        //普通链表遍历(eh >= 0 且不匹配头节点)。
        while ((e = e.next) != null) {
            //无需加锁:因为 val 是 volatile 字段,保证有序、可见性
            //只读不需要原子性
            //e = e.nxt 节点快照,即使准备返回e.val那一刻,原桶头被替换为特殊节点,也不影响读局部快照e
            if (e.hash == h &&
                ((ek = e.key) == key || (ek != null && key.equals(ek))))
                return e.val;
        }
    }
    //未找到 key,返回 null。null明确的语义:不存在
    return null;
}
remove
- ❓
remove如何保证线程安全?
→ 锁住桶头节点,临界区内完成查找、校验、删除、退化检查。 - ❓ 为什么红黑树删除不能 swap 内容?
→ 因为TreeNode的next指针用于并发遍历,swap 会破坏链表视图。 - ❓ 删除后会退化为链表吗?
→ 会。若树节点数 ≤ 6(UNTREEIFY_THRESHOLD),自动转回链表。 - ❓
remove(key, value)的作用?
→ 条件删除,常用于实现 CAS 式安全更新(如并发队列的出队)。 - ❓ 删除会触发扩容吗?
→ 不会。addCount(-1, -1)中check = -1跳过扩容逻辑。
//仅锁定目标桶(bin)的头节点,不影响其他桶的操作;
//支持多种删除形式:如 remove(key)、remove(key, value)(仅当值匹配时才删)
public V remove(Object key) {
    //调用内部通用方法 replaceNode(key, null, null);
	//value = null 表示“删除”;
	//cv = null 表示“不校验旧值”。
    return replaceNode(key, null, null);
}
public boolean remove(Object key, Object value) {
    if (key == null)
        throw new NullPointerException();
    //value = null 表示“删除”;
	//cv = value 表示需要“校验旧值”,匹配才删除。
    return value != null && replaceNode(key, null, value) != null;
}

final V replaceNode(Object key, V value, Object cv) {
    //不允许 key == null (由 spread 间接抛 NPE) 且 保证不是特殊节点;
    int hash = spread(key.hashCode());
    for (Node<K,V>[] tab = table;;) {
        Node<K,V> f; int n, i, fh;
        //表未初始化或桶为空 → 直接退出循环,返回 null
        if (tab == null || (n = tab.length) == 0 ||
            (f = tabAt(tab, i = (n - 1) & hash)) == null)
            break;
        //正在扩容 → 协助迁移
        else if ((fh = f.hash) == MOVED)
            //完成后得到新表,继续操作,下一次for循环
            tab = helpTransfer(tab, f);
        //正常情况,桶不为空,不在扩容
        //加锁操作桶
        else {
            V oldVal = null;
            boolean validated = false;
            synchronized (f) {
                //double-check
                if (tabAt(tab, i) == f) {
                    //如果是链表
                    if (fh >= 0) {
                        //成功进入临界区(validated = true)
                        validated = true;
                        for (Node<K,V> e = f, pred = null;;) {
                            K ek;
                            //找到对应节点
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                V ev = e.val;
                                if (cv == null
                                    //值校验(用于 remove(key, value))
                                    || cv == ev
                                    || (ev != null && cv.equals(ev))) {
                                    oldVal = ev;
                                    //用于 replace 方法,不删除而是更新值。
                                    if (value != null)
                                        e.val = value;
                                    // 非头节点,断连
                                    else if (pred != null)
                                        pred.next = e.next;
                                    else
                                        //头节点,换nxt为新桶头
                                        setTabAt(tab, i, e.next);
                                }
                                break;
                            }
                            pred = e;
                            if ((e = e.next) == null)
                                break;
                        }
                    }
                    //如果是红黑树
                    else if (f instanceof TreeBin) {
                        //成功进入临界区(validated = true)
                        validated = true;
                        TreeBin<K,V> t = (TreeBin<K,V>)f;
                        TreeNode<K,V> r, p;
                        if ((r = t.root) != null &&
                        //findTreeNode:hash + comparable + tie-break三级比较;
                            (p = r.findTreeNode(hash, key, null)) != null) {
                            V pv = p.val;
                            if (cv == null || cv == pv ||
                                (pv != null && cv.equals(pv))) {
                                oldVal = pv;
                                //replace更新值
                                if (value != null)
                                    p.val = value;
                                //调用 TreeBin.removeTreeNode(p);
								//内部实现红黑树标准删除(含旋转、颜色调整)
//标准红黑树删除常通过“交换待删节点与后继节点的内容”简化删除逻辑。
//但 ConcurrentHashMap 中,TreeNode 的 next 指针被迭代器和并发读使用,
//若交换内容会导致链表视图错乱。因此必须真实删除节点并调整树结构。
                                else if (t.removeTreeNode(p))
                                 //返回 true 表示:删除后树中节点数 ≤ 6
                                 //调用 untreeify() 转回链表
                                 //遍历 TreeBin.first
								 //逐个创建普通的Node(非TreeNode,不复用,保持轻量级)
								 //返回新链表的头节点 hd
                                 //setTabAt设置新桶头
                                    setTabAt(tab, i, untreeify(t.first));
                            }
                        }
                    }
                    //如果是递归调用
                    //computeIfAbsent 中 删除相同key
                    else if (f instanceof ReservationNode)
                        throw new IllegalStateException("Recursive update");
                }
            }
            //仅当成功进入临界区(validated == true)且删除成功(oldVal != null)
            //才调用 addCount(-1L, -1);
            if (validated) {
                if (oldVal != null) {
                    if (value == null)
                        //addCount(delta, check):
                        //delta = -1:减少计数;
						//check = -1:跳过扩容检查(删除不触发扩容);
                        addCount(-1L, -1);
                    //返回被删除的值(或 null 表示未删除)。
                    return oldVal;
                }
                break;
            }
        }
    }
    return null;
}
tryPresize
- ❓
tryPresize和putAll的关系?
→putAll调用tryPresize预分配足够空间,避免插入时频繁扩容。 - ❓ 为什么容量用
1.5 * size?
→ 因为负载因子 0.75,1 / 0.75 ≈ 1.33,取 1.5 是向上取整 + 容错。 - ❓ 如何保证线程安全?
→ 通过sizeCtl状态(≥0 表示空闲)和 CAS 控制初始化/扩容入口。 - ❓ 和
HashMap的putAll扩容有何不同?
→HashMap是插入过程中逐步扩容;ConcurrentHashMap可预扩容,更适合高并发批量写入。
内部用于预扩容表容量的方法。其主要用途是在批量插入操作前(如 putAll)、红黑树树化前,根据预计的元素数量,预先调整哈希表的容量,以避免在插入过程中频繁触发扩容,从而提升批量写入性能。
//参数 size:预计要插入的元素数量(不要求精确,只需合理估计)。
private final void tryPresize(int size) {
    //计算扩容后目标容量 c,使其能够容纳 size参数 个元素,同时保持负载因子 ≈ 0.75。
    //若 size ≥ MAXIMUM_CAPACITY/2
    //size + (size >>> 1) + 1 = size * 1.5 + 1 使用1.5*size是为了留出余量,避免刚插入完就触发扩容。
    int c = (size >= (MAXIMUM_CAPACITY >>> 1)) ? MAXIMUM_CAPACITY :
tableSizeFor(size + (size >>> 1) + 1);
    int sc;
    //(sc = sizeCtl) >= 0 表示当前没有线程在初始化或扩容。
    while ((sc = sizeCtl) >= 0) {
        Node<K,V>[] tab = table; int n;
        //若表未初始化,则以 max(sc, c) 作为初始容量
        //此时还未初始化,sc 是构造时指定的 initialCapacity
        if (tab == null || (n = tab.length) == 0) {
            n = (sc > c) ? sc : c;
            //CAS获取初始化权
            if (U.compareAndSetInt(this, SIZECTL, sc, -1)) {
                try {
                    if (table == tab) {
                        @SuppressWarnings("unchecked")
                        //创建新表
                        Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                        //发布新表
                        table = nt;
                        //设置 sizeCtl = 0.75n 作为下次扩容阈值。
                        sc = n - (n >>> 2);
                    }
                } finally {
                    sizeCtl = sc;
                }
            }
        }
        //无需扩容(已经初始化)
        //提前退出条件:
		//c <= sc:目标容量 ≤ 当前扩容阈值 ⇒ 当前容量已足够;
		//n >= MAXIMUM_CAPACITY:已达最大容量,无法再扩。
        else if (c <= sc || n >= MAXIMUM_CAPACITY)
            break;
        //需要扩容
        //tab == table 确保表在执行本方法时,未被其他线程扩容
        else if (tab == table) {
            //生成扩容标识
            int rs = resizeStamp(n);
            //CAS 设置sc标识,如果失败说明有其他线程开启扩容流程
            //如果成功,本线程开始扩容
            if (U.compareAndSetInt(this, SIZECTL, sc,
                                   (rs << RESIZE_STAMP_SHIFT) + 2))
                //启动扩容:调用 transfer(tab, null)
                //nextTab = null 表示由当前线程初始化新表。
                transfer(tab, null);
        }
    }
}
transfer
- ❓ 扩容时 get/put 能否正常工作?
→ 可以。遇到ForwardingNode会自动跳转到nextTab。 - ❓ 多线程如何协作扩容?
→ 通过transferIndexCAS 分配迁移区间,每个线程负责一段。 - ❓ 为什么链表迁移要找 lastRun?
→ 避免无谓的节点复制,复用尾部连续同组节点。 - ❓ 扩容完成后如何切换 table?
→ 最后一个线程将table = nextTable,并重置sizeCtl。
//创建一个新的容量为原表 2 倍 的 nextTable(若尚未创建);
//将原表(tab)中的所有桶(bin)逐步、并发地迁移到新表中;
//保证在迁移过程中,读写操作仍能正确执行(读操作通过 ForwardingNode 跳转,写操作可协助迁移);
//支持多线程协作迁移,避免单线程扩容成为性能瓶颈。

//nextTab目标新表,若为 null,表示当前线程是扩容发起者,需先初始化新表。
private final void transfer(Node<K,V>[] tab, Node<K,V>[] nextTab) {
    // n 被赋值为 tab.length
    // stride 只是声明
    int n = tab.length, stride;
    //计算每个线程负责迁移的桶数量(stride):
	//多核(NCPU > 1)时,stride = (n / 8) / NCPU,确保每个线程处理合理的数据量;
	//最小步长为 MIN_TRANSFER_STRIDE = 16,防止任务过小导致线程调度开销过大。
    if ((stride = (NCPU > 1) ? (n >>> 3) / NCPU : n) < MIN_TRANSFER_STRIDE)
        stride = MIN_TRANSFER_STRIDE; // subdivide range
    //扩容发起者,初始化
    if (nextTab == null) {
        try {
            @SuppressWarnings("unchecked")
            //新表容量为 n << 1(即原表 2 倍)
            Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1];
            nextTab = nt;
        } catch (Throwable ex) {      // try to cope with OOME
            sizeCtl = Integer.MAX_VALUE;
            return;
        }
        //将新表赋值给 nextTable(volatile 字段),供其他线程可见;
        nextTable = nextTab;
        //transferIndex是全局变量 + volatile
        //transferIndex = n 表示原tab下一个待分配的迁移起始位置是n(从后往前分配)
        //通过 CAS 递减分配区间,从高索引向低索引分配更自然,避免边界判断复杂化。
        transferIndex = n;
    }
    int nextn = nextTab.length;
    //创建一个 ForwardingNode,用于标记已迁移的桶,使其持有 nextTable 引用
    ForwardingNode<K,V> fwd = new ForwardingNode<K,V>(nextTab);
    //advance:是否推进到下一个任务块/桶,false表示不用推进,正在处理任务块/桶
    boolean advance = true;
    //finishing:是否完成全部迁移(仅由最后一个线程设置)。
    boolean finishing = false;
    //无限循环 + CAS
    //i 表示当前处理的桶索引。
    //bound 表示当前任务块的下界,闭区间 [bound, i]
    for (int i = 0, bound = 0;;) {
        Node<K,V> f; int fh;
        //advance为true表示需要推进到下一个 任务块/桶
        while (advance) {
            int nextIndex, nextBound;
            //若 i 仍在当前区间内(i >= bound),继续处理
            if (--i >= bound || finishing)
                advance = false;
            //transferIndex <= 0,说明所有桶已被分配
            //设置 i = -1 表示无任务,当前线程退出;
            else if ((nextIndex = transferIndex) <= 0) {
                i = -1;
                advance = false;
            }
            //每个线程通过 CAS 窃取一段任务,互不干扰,实现无锁任务分配。
            //获取一个新任务块:[nxtBound = nextIndex - stride, nextIndex - 1]
            else if (U.compareAndSetInt
                     (this, TRANSFERINDEX, nextIndex,
                      nextBound = (nextIndex > stride ?
                                   nextIndex - stride : 0))) {
                bound = nextBound;
                i = nextIndex - 1;
                advance = false;
            }
        }
        //还在for循环内
        //如果要处理的桶i 已经越界了,说明可能完成迁移
        if (i < 0 || i >= n || i + n >= nextn) {
            int sc;
            //真正完成扩容,更新 table 指向新表,重置 sizeCtl
            if (finishing) {
                nextTable = null;
                //切换到新表
                table = nextTab;
                sizeCtl = (n << 1) - (n >>> 1);
                return;
            }
            //sc - 1 分支:当前线程准备退出,将 sizeCtl 减 1(表示一个扩容线程结束)
            if (U.compareAndSetInt(this, SIZECTL, sc = sizeCtl, sc - 1)) {
                if ((sc - 2) != resizeStamp(n) << RESIZE_STAMP_SHIFT)
                    return;
                //(sc - 2)把线程计数部分减掉2,如果为最后一个线程,此时高16位就是stamp,低16位全为0
                //(resizeStamp(n) << RESIZE_STAMP_SHIFT),把stamp从低16移到高16
                //两者比较大小,值相等,说明:
                //只剩最后一个线程 且 扩容代际相同,可以设置 finishing = true 进行最终提交。
                finishing = advance = true;
                //说明处理完桶了 i = n
                i = n;
            }
        }
        //否则,没完成迁移,检查三种情况
        else if ((f = tabAt(tab, i)) == null)
            //1若桶为空,没有要处理的,直接 CAS 放入 ForwardingNode,标记这个桶为“已处理”。
            advance = casTabAt(tab, i, null, fwd);
        else if ((fh = f.hash) == MOVED)
            //2遇到 ForwardingNode(hash == MOVED),说明这个桶已被其他线程处理,跳过。
            advance = true; //需要推进
        else {
            //3真正迁移
            //普通链表或红黑树(需加锁迁移)
            synchronized (f) {
                //加锁:锁住桶头节点 f,防止并发修改;
                //双重检查:确认桶头未变(防 ABA 问题)。
                if (tabAt(tab, i) == f) {
                    //ln 放在原桶节点的桶头
                    //hn 放在原桶节点的桶头
                    Node<K,V> ln, hn;
                    //如果是链表
                    if (fh >= 0) {
                        int runBit = fh & n;
                        Node<K,V> lastRun = f;
                     //遍历链表
                     //在迁移链表时,如果每个节点都新建一个 Node,会带来大量 GC 压力和性能损耗。
					 //但观察发现:链表尾连续的一段节点,很可能具有相同的 runBit(即扩容后都去同一个新桶)
                        //从桶头往后遍历(往后遍历,最后的切换点记录的就是链表尾)
                        for (Node<K,V> p = f.next; p != null; p = p.next) {
                            int b = p.hash & n;
                            //切换点,不是一个簇了
                            if (b != runBit) {
                                runBit = b;
                                lastRun = p;
                            }
                        }
                        //runBit为0,最后一簇应该放在原桶
                        //ln设置为lastRun,直接复用lastRun后面的所有节点,保持原顺序,但是仍要检查run前的节点
                        //hn设置为null,需要构建放到新桶节点的链表
                        if (runBit == 0) {
                            ln = lastRun;
                            hn = null;
                        }
                        //不为0,最后一簇应该放在新桶
                        else {
                            hn = lastRun;
                            ln = null;
                        }
                        //再次遍历,处理切换点(最后一簇)前的所有节点
                        //因为最后一簇runBit极大概率是相等的,保留复用,减少GC
                        for (Node<K,V> p = f; p != lastRun; p = p.next) {
                            int ph = p.hash; K pk = p.key; V pv = p.val;
                            //ph & n == 0 说明这个节点应该留在原地,那么头插入ln
                            if ((ph & n) == 0)
                                //头插法
                                //newNode.nxt = ln then ln = newNode
//为什么不使用尾插法处理非复用部分?实际上是出于优化的考虑,减少局部变量tail之类的引入
//否则,不考虑优化的情况下
//是可以使用尾插法的,在取得f锁 + 迁移完成才发布的特性下,不存在并发造成头插成环、尾插覆盖的情况
                                ln = new Node<K,V>(ph, pk, pv, ln);
                            else
                            //ph & n != 0 说明这个节点应该留在原地,那么头插入hn
                                hn = new Node<K,V>(ph, pk, pv, hn);
                        }
                        //新表 i处的桶头设置为ln
                        setTabAt(nextTab, i, ln);
                        //新表 i+n处的桶头设置为hn
                        setTabAt(nextTab, i + n, hn);
                        //旧表 i处的桶头设置为ForwardingNode
                        setTabAt(tab, i, fwd);
                        //需要推进到下一个桶/任务块
                        advance = true;
                    }
                    //如果是红黑树结构
                    else if (f instanceof TreeBin) {
                        // 遍历树节点,按 hash & n 分成两组(lo/hi)
                        // 若某组 ≤ UNTREEIFY_THRESHOLD (6),则转回链表
                        // 否则保持红黑树
                        TreeBin<K,V> t = (TreeBin<K,V>)f;
                        //lo链表头,loTail尾节点
                        TreeNode<K,V> lo = null, loTail = null;
                        TreeNode<K,V> hi = null, hiTail = null;
                        int lc = 0, hc = 0;
                        for (Node<K,V> e = t.first; e != null; e = e.next) {
                            int h = e.hash;
                            //TreeNode 红黑树 + 双向链表 节点
                            TreeNode<K,V> p = new TreeNode<K,V>
                                (h, e.key, e.val, null, null);
                            //注意这里用了尾插法,额外维持了tail节点
                            //普通链表使用头插是为了配合 lastRun 的极致性能优化
                            //而红黑树因为无法利用 lastRun,而且需要构建双向链表,所以选择了逻辑最清晰且能保持顺序的尾插法,
                            if ((h & n) == 0) {
                                if ((p.prev = loTail) == null)
                                    //设置p为 链表头
                                    lo = p;
                                else
                                    //链接节点
                                    loTail.next = p;
                                //更新尾节点
                                loTail = p;
                                ++lc;
                            }
                            else {
                                if ((p.prev = hiTail) == null)
                                    hi = p;
                                else
                                    hiTail.next = p;
                                hiTail = p;
                                ++hc;
                            }
                        }
                        //链表节点数量小于等于 6 去树化 否则 创建代理桶头TreeBin
                        ln = (lc <= UNTREEIFY_THRESHOLD) ? untreeify(lo) :
                            (hc != 0) ? new TreeBin<K,V>(lo) : t;
                        hn = (hc <= UNTREEIFY_THRESHOLD) ? untreeify(hi) :
                            (lc != 0) ? new TreeBin<K,V>(hi) : t;
                        setTabAt(nextTab, i, ln);
                        setTabAt(nextTab, i + n, hn);
                        setTabAt(tab, i, fwd);
                        advance = true;
                    }
                    //computeIfAbsent中 mappingFunction put 相同的key
                    //如果导致扩容,会触发该异常
                    else if (f instanceof ReservationNode)
                        throw new IllegalStateException("Recursive update");
                }
            }
        }
    }
}
分组/runBit
ConcurrentHashMap 的扩容是 2 倍扩容(比如从 16 扩到 32)。
对于一个 key 的 hash 值,其在旧表中的索引是:
index = (n - 1) & hash // n 是旧表长度
扩容后,新表长度为 2n,新索引有两种可能:
- 仍为
index - 变为
index + n
这取决于 hash 的 第 log2(n) 位(即“新增的那一位”)是 0 还是 1。
| Hash | index = hash & 1111(扩容前) | index = hash & 11111 (扩容后) |
|---|---|---|
0 1011 |
1011= 11 |
0 1011= 11 (新增位为0) |
1 1011 |
1011= 11 |
1 1011= 27(新增位为1) |
这里直接计算新增位runBit。
int runBit = hash & n; // 要么是 0,要么是 n(即 扩容后容量)
- 若
runBit == 0→ 还在原位置i - 若
runBit != 0→ 迁移到i + n
为什么不像HashMap那样遍历链表后直接分组?
添加额外的lastRun策略,在于可以复用尾部连续同组节点的 next 指针,减少GC,在高并发的情况下很有用。
helpTransfer
- ❓ 为什么扩容时写线程要协助迁移?
→ 避免扩容成为单点瓶颈,利用写线程的空闲计算资源,加速扩容完成。 - ❓ 如何防止多个线程重复参与扩容?
→ 通过sizeCtl的 CAS 递增,精确控制参与线程数。 - ❓
helpTransfer返回新表的作用是什么?
→ 让上层逻辑(如putVal)能在新表上重试操作,实现“无感切换”。 - ❓ 扩容期间读操作如何工作?
→ 遇到ForwardingNode自动跳转到nextTable继续查找(get方法中已处理)。(迁移桶期间,读旧桶,不会转发到新表)
当一个线程在执行 put、remove 或其他写操作时,发现当前桶的头节点是一个 ForwardingNode(即 f.hash == MOVED == -1),说明哈希表正在进行扩容,此时该线程不会阻塞等待,而是主动参与扩容工作,帮助迁移其他未处理的桶。
final Node<K,V>[] helpTransfer(Node<K,V>[] tab, Node<K,V> f) {
    Node<K,V>[] nextTab; int sc;
    //因为 helpTransfer 被调用时,可能恰好处于扩容的中间状态,多种检验
    //tab != null确保旧表存在
    //f instanceof ForwardingNode:确认当前桶已被标记为“已处理”
    //nextTab != null:确保新表已创建(防止并发初始化过程中的空指针)
    if (tab != null && (f instanceof ForwardingNode) &&
        //快照nextTable
        (nextTab = ((ForwardingNode<K,V>)f).nextTable) != null) {
        int rs = resizeStamp(tab.length) << RESIZE_STAMP_SHIFT;
        //nextTab == nextTable:全局 nextTable 仍是当前新表(未被后续扩容覆盖);
		//table == tab:全局 table 仍是当前旧表(扩容未完成);
		//sizeCtl < 0:表示扩容正在进行中(sizeCtl 为负数)。
        //为何用 while?因为可能有多个线程同时协助扩容,需持续检查状态是否依然有效。
        while (nextTab == nextTable
               && table == tab
               && (sc = sizeCtl) < 0) {
            //sc == rs + MAX_RESIZERS:协助扩容的线程数已达上限;
			//sc == rs + 1:扩容已完成(只剩最后一个线程在做收尾);
			//transferIndex <= 0:所有迁移任务已被分配完毕(无事可做)。
            if (sc == rs + MAX_RESIZERS
                || sc == rs + 1
                //transferIndex 全局volatile变量
                || transferIndex <= 0)
                //退出协助
                break;
            //sizeCtl = rs + 2表示扩容刚开始(第一个线程),每新增一个协助线程,sc+1。
            if (U.compareAndSetInt(this, SIZECTL, sc, sc + 1)) {
                //nxtTab不为null,跳过初始化,直接协助
                transfer(tab, nextTab);
                break;
            }
        }
        //若成功协助扩容,返回新表 nextTab,调用者(如 putVal)可直接在新表上重试操作;
        return nextTab;
    }
    //若条件不满足(如扩容已完成),返回当前 table(table可能是扩容迁移完成了的)。
    return table;
}
computeIfAbsent
- ❓
computeIfAbsent如何保证线程安全?
→ 通过ReservationNode(空桶)或synchronized(桶头)(非空桶)实现互斥,确保对同一 key 的操作串行化。 - ❓ 为什么需要
ReservationNode?
→ 因为空桶没有节点可锁,需临时创建一个占位节点作为锁对象,同时通过 CAS 防止多个线程同时插入。 - ❓ 如果
mappingFunction抛异常会怎样?
→finally块会将桶恢复为null,后续线程可重试,不会导致死锁。 - ❓ 与
putIfAbsent的区别?
→computeIfAbsent是惰性计算,仅在 key 不存在时才调用函数;putIfAbsent无论是否存在都会创建 value 对象。
public V computeIfAbsent(K key, Function<? super K, ? extends V> mappingFunction) {
    if (key == null || mappingFunction == null)
        throw new NullPointerException();
    int h = spread(key.hashCode());
    V val = null;
    //binCount 用于后续判断是否需要树化;
    int binCount = 0;
    for (Node<K,V>[] tab = table;;) {
        Node<K,V> f; int n, i, fh; K fk; V fv;
        //懒初始化
        if (tab == null || (n = tab.length) == 0)
            tab = initTable();
        //桶为空
        else if ((f = tabAt(tab, i = (n - 1) & h)) == null) {
            Node<K,V> r = new ReservationNode<K,V>();
            //r临时锁作用见 Node的特殊类型#ReservationNode
            synchronized (r) {
                if (casTabAt(tab, i, null, r)) {
                    binCount = 1;
                    Node<K,V> node = null;
                    try {
                        if ((val = mappingFunction.apply(key)) != null)
                            node = new Node<K,V>(h, key, val);
                    } finally {
                        setTabAt(tab, i, node);
                    }
                }
            }
            if (binCount != 0)
                break;
        }
        //桶不为空
        //帮助迁移
        else if ((fh = f.hash) == MOVED)
            tab = helpTransfer(tab, f);
        //非覆盖模式:发现同hash 同key 返回val
        //https://bugs.openjdk.org/browse/JDK-8161372
        //注意这里是JDK9以后添加的
        //提供了check without lock的机制
        //如果check失败才会加锁 从而提高并发量
        //否则取锁再check bin,并发量会显著减少
        else if (fh == h
                 && ((fk = f.key) == key || (fk != null && key.equals(fk)))
                 && (fv = f.val) != null)
            return fv;
        else {
            //hash 冲突 非同key
            boolean added = false;
            //获取桶头锁
            synchronized (f) {
                if (tabAt(tab, i) == f) {
                    //处理链表
                    if (fh >= 0) {
                        binCount = 1;
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            //找到 key:返回已有值(val = e.val);
                            if (e.hash == h &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                val = e.val;
                                break;
                            }
                            //遍历到尾部:执行 mappingFunction,追加新节点;
                            Node<K,V> pred = e;
                            if ((e = e.next) == null) {
                                if ((val = mappingFunction.apply(key)) != null) {
                                    //安全性检查
                                    if (pred.next != null)
                                        throw new IllegalStateException("Recursive update");
                                    added = true;
                                    pred.next = new Node<K,V>(h, key, val);
                                }
                                break;
                            }
                        }
                    }
                    //处理红黑树
                    else if (f instanceof TreeBin) {
                        binCount = 2;
                        TreeBin<K,V> t = (TreeBin<K,V>)f;
                        TreeNode<K,V> r, p;
                        //通过 TreeBin 的 findTreeNode 查找;

                        if ((r = t.root) != null &&
                            (p = r.findTreeNode(h, key, null)) != null)
                            val = p.val;
                        //不存在则调用 putTreeVal 插入。
                        else if ((val = mappingFunction.apply(key)) != null) {
                            added = true;
                            t.putTreeVal(h, key, val);
                        }
                    }
                    else if (f instanceof ReservationNode)
                        throw new IllegalStateException("Recursive update");
                }
            }
            if (binCount != 0) {
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i);
                if (!added)
                    return val;
                break;
            }
        }
    }
    if (val != null)
        //若插入成功(added == true),更新计数;
        addCount(1L, binCount);
    return val;
}
treeifyBin
- ❓ 为什么链表长度 ≥8 才树化?
→ 泊松分布下,该情况概率极低(约千万分之一),可认为是哈希冲突异常。 - ❓ 为什么表长度 <64 时不树化?
→ 优先扩容,解决根本问题(分布不均),比树化更高效。 - ❓ TreeBin 和 TreeNode 的区别?
→TreeNode是树节点;TreeBin是桶头容器,管理整棵树,并提供并发控制。 - ❓ 读操作如何在树化后保持无锁?
→TreeBin.find()先尝试获取读锁,失败则降级为遍历链表(因TreeNode保留next指针)。 - ❓ key 不实现 Comparable 能树化吗?
→ 可以,通过tieBreakOrder(类名 +identityHashCode)保证插入顺序。
private final void treeifyBin(Node<K,V>[] tab, int index) {
    Node<K,V> b; int n;
    if (tab != null) {
        //如果表长度 < MIN_TREEIFY_CAPACITY(默认为 64),不进行树化,而是尝试扩容。
        if ((n = tab.length) < MIN_TREEIFY_CAPACITY)
            tryPresize(n << 1);
        //b != null:桶非空;b.hash >= 0:排除特殊节点
        else if ((b = tabAt(tab, index)) != null && b.hash >= 0) {
            //锁住桶头节点 b
            synchronized (b) {
                //双重检查
                if (tabAt(tab, index) == b) {
                    TreeNode<K,V> hd = null, tl = null;
                    //遍历链表,逐个转换为 TreeNode:
                    //TreeNode 继承自 Node,但是额外维持双向链表nxt,prev指针
                    //此时仅构建双向链表结构
                    for (Node<K,V> e = b; e != null; e = e.next) {
                        TreeNode<K,V> p =
                            new TreeNode<K,V>(e.hash, e.key, e.val,
                                              null, null);
                        if ((p.prev = tl) == null)
                            hd = p;
                        else
                            tl.next = p;
                        tl = p;
                    }
                    //链表转为红黑树的逻辑 在 TreeBin的构造函数中
                    setTabAt(tab, index, new TreeBin<K,V>(hd));
                }
            }
        }
    }
}
size
- ❓
size()为什么不是精确的?
→ 因为计数采用分段(baseCount + CounterCell[]),sumCount()非原子读取,无法保证遍历时无并发修改。 - ❓ 为什么这样设计?
→ 为了保证高并发写入性能,避免size()成为全局锁瓶颈。 - ❓ 如何获取精确大小?
→ 无法通过ConcurrentHashMap本身实现;需外部同步,或接受“近似性”。 - ❓
mappingCount()和size()的区别?
→mappingCount()返回long,避免int溢出;但同样是近似值。
public int size() {
    long n = sumCount();
    return ((n < 0L) ? 0 :
            (n > (long)Integer.MAX_VALUE) ? Integer.MAX_VALUE :
            (int)n);
}
//核心逻辑委托给 sumCount():
//在 sumCount() 执行期间,其他线程可能:
//执行 put → 调用 addCount(+1, ...);
//执行 remove → 调用 addCount(-1, ...);
//触发扩容 → 计数器结构变化。
final long sumCount() {
    //全局变量快照 高并发时启用的分段计数数组
    //每个线程通过哈希选择一个 CounterCell 进行 CAS 更新,避免竞争。
    CounterCell[] cs = counterCells;
    //全局变量快照 baseCount:基础计数器,用于低并发场景;
    long sum = baseCount;
    //遍历 baseCount + 所有 CounterCell.value 并累加;
	//但该过程不加锁,也没有内存屏障保证;
    //CounterCell 数组可能被扩容(fullAddCount 中的 Arrays.copyOf);
	//某个 CounterCell.value 可能被其他线程并发修改;
	//baseCount 也可能被更新。

    // 为何不加锁保证精确?
	//如果对 size() 加全局锁(如 synchronized),会导致:
	//所有写操作被阻塞;
	//违背 ConcurrentHashMap “高并发写”的设计目标;
	//在高并发系统中,size() 调用会成为性能瓶颈。
    if (cs != null) {
        for (CounterCell c : cs)
            if (c != null)
                sum += c.value;
    }
    return sum;
}
正确替代方案:
若需精确计数,应使用外部同步,自己实现全局锁的效果,例如:
synchronized (lock) {
    int size = map.size();
    // 业务逻辑
}
或者用其他类代替。
迭代器
ConcurrentHashMap 的迭代器(包括 Iterator、Enumeration、Spliterator)设计遵循以下核心原则:
-
弱一致性(Weakly Consistent):
-
迭代器不会回滚,也不会停止,也不会失败,只是尽力从当前正在变化的结构中返回“尽可能线性”的遍历顺序。
-
可能遍历到刚加入的节点:因为 put 时,next 指针会指向新节点,而遍历可能刚好读到。
-
可能遍历到已删除但仍可见的节点:因为链表删除是多个步骤通过锁f保证原子性,但是读时不竞争删除时的锁f(被删除节点还在next链中)。
-
可能漏掉某些节点:因为遍历到那个 bucket 时,因为put是多个步骤通过锁f保证原子性,但是读时不竞争put时的锁f(被插入节点还没接上next链)。
-
-
无锁遍历(Lock-Free Traversal):
- 迭代器的
next()、hasNext()等方法不加锁; - 利用
volatile读保证内存可见性; - 即使在扩容、树化、删除等并发修改下,也能安全遍历。
- 迭代器的
-
支持并发修改:
- 没有
modCount字段,不抛出ConcurrentModificationException; - 遍历线程和修改线程可同时工作;
- 修改操作(如
put/remove)不会被迭代器阻塞; - 迭代器也不会阻塞任何写操作。
- 没有
Traverser数据结构
所有迭代器(KeyIterator、ValueIterator、EntryIterator)都继承自 Traverser<K,V>,它是遍历逻辑的统一抽象。
//表栈的数据结构
static final class TableStack<K,V> {
    int length;
    int index;
    Node<K,V>[] tab;
    TableStack<K,V> next; //是个链表
}

//为什么需要栈?
//因为新表可能也正在扩容(多层扩容),遍历完新表后需回退到旧表继续处理其他桶。

static class Traverser<K,V> {
    // 当前正在遍历的 table(可能被替换为 nextTable)
    Node<K,V>[] tab;
    // 下一个要返回的节点,缓存以支持hasNext()
    Node<K,V> next;
    // 用于保存遍历状态,在扩容时恢复
    TableStack<K,V> stack, spare;
    // 当前正在处理的桶索引
    int index;
    // 初始表的当前索引
    int baseIndex;
    // 初始表的索引上界
    int baseLimit;

    //因为扩容是 2 倍扩容,旧表索引 i 的元素只会迁移到新表的 i 或 i + n(n = 旧表长)。
    //baseSize 记录了初始 n,用于计算镜像位置。
    // 初始表的大小(table.length)
    final int baseSize;
}
tab:允许在遍历中动态切换到 nextTable(扩容时);
stack 和 spare:用于保存和恢复遍历上下文,当遇到 ForwardingNode 时,记录当前状态,跳转到新表继续遍历;
baseIndex/baseLimit/baseSize:确保即使表被多次扩容,也能完整遍历初始表的所有桶(通过 (index + baseSize) 方式定位新表中的对应桶)。
标准迭代器接口:hasNext() 预取 next(这里是通过调用 advance()预取);next() 直接返回 next 并推进。
Traverser基础方法
栈相关
//表栈的数据结构
static final class TableStack<K,V> {
    int length;
    int index;
    Node<K,V>[] tab;
    TableStack<K,V> next; //是个链表
}

//为什么需要栈?
//因为新表可能也正在扩容(多层扩容),遍历完新表后需回退到旧表继续处理其他桶。


private void pushState(Node<K,V>[] t, int i, int n) {
    //spare 之前弹出的节点
    TableStack<K,V> s = spare;
    if (s != null)
        spare = s.next;
    else
        s = new TableStack<K,V>();
    s.tab = t;
    s.length = n;
    s.index = i;
    s.next = stack;
    stack = s;
}

//n:当前表长度(用于判断是否遍历完)。
private void recoverState(int n) {
    TableStack<K,V> s; int len;
    //stack != null 栈非空,说明还有旧表状态可恢复;
    while ((s = stack) != null
           //将当前 index 加上栈顶状态所保存的旧表长度 len
           //如果>= n(当前表长度):说明当前表中已无更多桶需要遍历,应当回退到上一层表
           //如果<n 就等于帮助推进 index 到新表的镜像桶位置,同时结束循环!
           && (index += (len = s.length)) >= n) {
		//全局变量恢复:恢复旧表长度记录
        n = len;
        //全局变量恢复:回到转跳前的索引
        index = s.index;
        //全局变量恢复:恢复旧表
        tab = s.tab;
        //释放,帮助GC
        s.tab = null;
        //准备弹出栈
        TableStack<K,V> next = s.next;
        s.next = spare; // 复用,stack 链接上 spare现在的链表头
        stack = next; //弹出stack
        spare = s;//这个stack变成sprae的链表头
    }

    //如果栈为空:
    //说明回退到了初始表,
    //1.index被while循环重置回转跳前的索引,
    //2.n被while循环重置回转跳前的初始表长度
    //3.tab被设置为初始表
    //basSize为初始表长度
    //计算index + baseSize >= n 必然为true。为什么要有这个判断?
    /**To
     * paranoically cope with potential sharing by users of iterators
     * across threads, iteration terminates if a bounds checks fails
     * for a table read.
     **/
    //为了谨慎地应对迭代器用户可能在跨线程共享迭代器的情况,
    //如果表读取的边界检查失败,迭代将终止。

    //baseIndex++ 进入下一个初始表桶。

    //栈不为空,结束
    if (s == null && (index += baseSize) >= n)
        index = ++baseIndex;


}
核心方法advance
static class Traverser<K,V> {
    // 当前正在遍历的 table(可能被替换为 nextTable)
    Node<K,V>[] tab;
    // 下一个要返回的节点,缓存以支持hasNext()
    Node<K,V> next;
    // 用于保存遍历状态,在扩容时恢复
    TableStack<K,V> stack, spare;
    // 当前正在处理的桶索引
    int index;
    // 初始表的当前索引
    int baseIndex;
    // 初始表的索引上界
    int baseLimit;

    //因为扩容是 2 倍扩容,旧表索引 i 的元素只会迁移到新表的 i 或 i + n(n = 旧表长)。
    //baseSize 记录了初始 n,用于计算镜像位置。
    // 初始表的大小(table.length)
    final int baseSize;
}


//返回表中下一个有效的、尚未被访问的 Node 节点;
//若遍历完成,则返回 null。
final Node<K,V> advance() {
    Node<K,V> e;
    //如果上次返回的节点还有后继,则优先返回其后继(先缓存到e,for循环中返回)
    if ((e = next) != null)
        e = e.next;
    //否则,无限循环直到找到有效节点或确认遍历结束;
    for (;;) {
        //使用局部变量,而非直接访问字段tab,因为在多线程情况下tab可能会被替换
        Node<K,V>[] t; int i, n;
        //找到了有效节点,缓存到 next 结束循环返回。
        if (e != null)
            return next = e;
        //初始表已遍历完(baseIndex >= baseLimit);
		//表为空;
		//索引越界。
        //为什么检查 baseIndex 而不是 index?
		//因为 index 会动态变化(如跳转到 nextTable)
        //而 baseIndex 始终代表“初始表进度”,是遍历完成的唯一可靠标志。
        if (baseIndex >= baseLimit
            || (t = tab) == null
            || (n = t.length) <= (i = index)
            || i < 0)
            //遍历完成,返回 null
            return next = null;
        //桶不为空 且 遇到特殊节点(hash < 0)
        if ((e = tabAt(t, i)) != null && e.hash < 0) {
            //扩容中
            if (e instanceof ForwardingNode) {
                //tab = nextTable切换到新表,准备继续遍历;
                tab = ((ForwardingNode<K,V>)e).nextTable;
                //放弃当前节点,将在新表的相同索引 i 处重新读取
                e = null;
                //pushState(t, i, n)将
                //当前表 t、当前桶索引 i、当前表长度 n 打包成一个 TableStack 节点,并压入栈 stack 中
                pushState(t, i, n);
                //重新开始循环,在新表中找节点。
                continue;
            }
            //如果是 TreeBin,先取其链表头 first,准备下一次循环遍历;
            else if (e instanceof TreeBin)
                e = ((TreeBin<K,V>)e).first;
            //其他特殊节点(如 ReservationNode)忽略。
            else
                e = null;
        }
        //一定会执行的if判断
        //如果栈非空(说明之前跳转过),调用recoverState(n) 更新index遍历新表 如果遍历完新表则回退到旧表,否则继续在新表
        if (stack != null)
            //n:当前表长度(用于判断是否遍历完)。
            recoverState(n);
        //stack为空:没有转跳 或 已经处理完所有跳转状态,回到初始表遍历逻辑
        //baseIndex++ 进入下一个初始表桶。
        //(index = i + baseSize) >= n 一定为true,栈空时,n = baseSize
        else if ((index = i + baseSize) >= n)
            index = ++baseIndex;
    }
}
CopyOnWriteArrayList
CopyOnWriteArrayList中的Copy-On-Write即写时复制,简称 COW。
当进行写入修改( add,set、remove) 等操作时,不会直接修改ArrayList的底层数组,而是会先创建底层数组的副本,对副本数组进行修改,修改完之后,再将替换原数组,这样就可以保证写操作不会阻塞读操作了。
因此读多写少的并发场景是可以使用COW机制的。多线程并发读时无需加锁,保证读操作的高性能。但是不适用于高写频率场景,频繁写会导致大量复制副本,出现内存分配和 GC 压力。
注意:由于快照的语义,读操作读取的是原数组,而写操作是修改副本,读操作不会立即可见副本的修改,只能保证立即可见替换原数组的操作。
以下源码出自Java17
get
@SuppressWarnings("unchecked")
static <E> E elementAt(Object[] a, int index) {
    return (E) a[index];
}

public E get(int index) {
    //无锁读
    return elementAt(getArray(), index);
}
get() 方法为什么不需要加锁?
因为底层数组是 volatile 引用,读操作能看到最新 发布 的数组;写操作总是替换整个数组,不会修改已有数组的内容;
因此读操作访问的是不可变快照,天然线程安全。
indexRangeOf
在区间内搜索是否存在元素,使用equals判断。
若返回值 < 0,表示中不存在该元素。否则,返回对应的index。
//时间复杂度On n=to - from
private static int indexOfRange(Object o, Object[] es, int from, int to) {
    if (o == null) {
        for (int i = from; i < to; i++)
            if (es[i] == null)
                return i;
    } else {
        for (int i = from; i < to; i++)
            //使用equals判断
            if (o.equals(es[i]))
                return i;
    }
    return -1;
}
add
//尾部添加一个元素
public boolean add(E e) {
    //为什么用 synchronized 而不用 ReentrantLock?
	//源码注释中说明:“We have a mild preference for builtin monitors over ReentrantLock when either will do.”
    //(当两种都能用时,更倾向于使用内置监视器)
    synchronized (lock) {
        //volatile读 获取当前底层数组的引用。
        Object[] es = getArray();
        //获取当前数组长度,用于确定新元素插入位置
        int len = es.length;
        //复制原数组,并扩展长度为 len+1
        //时间 O(n),空间 O(n)
        es = Arrays.copyOf(es, len + 1);
        //添加数据
        es[len] = e;
        //替换原数组
        setArray(es);
        //总是返回 true,这是为了满足 Collection.add(E) 接口规范
        //只要成功添加就返回 true
        return true;
    }
}
addIfAbsent
public boolean addIfAbsent(E e) {
    Object[] snapshot = getArray();
    //在快照数组中线性查找元素 e。
	//若返回值 < 0,表示当前快照中不存在该元素,可以尝试添加。
	//注意:这是一个“乐观检查”——因为其他线程可能在检查后、加锁前已经添加了该元素。
    return indexOfRange(e, snapshot, 0, snapshot.length) < 0
        && addIfAbsent(e, snapshot);
}
private boolean addIfAbsent(E e, Object[] snapshot) {
    //与 add() 方法共用同一把锁,确保所有修改互斥。
    synchronized (lock) {
        //再次获取当前数组(可能已因其他线程修改而不同于 snapshot)
        Object[] current = getArray();
        //当前数组长度
        int len = current.length;
        //判断从“乐观检查”到“加锁”这段时间内,是否有其他线程修改了列表。
		//如果 snapshot == current,说明期间无人修改,可直接添加。
        if (snapshot != current) {
            // 说明被修改过
            // 高效地在 current 数组中检查 e 是否已被其他线程添加。
            // 计算公共前缀长度
            int common = Math.min(snapshot.length, len);
            for (int i = 0; i < common; i++)
                //fast-fail 先做引用比较,再做equals,比直接用indexOfRange快
                //同index元素不相等,才说明被修改过,那么可以检查一下,是否是要添加的e
                if (current[i] != snapshot[i]
                    && Objects.equals(e, current[i]))
                    //返回false 说明e被添加了
                    return false;
            //如果前缀没找到,继续在 current 数组的剩余部分([common, len))中查找。
            if (indexOfRange(e, current, common, len) >= 0)
                //返回false 说明e被添加了
                return false;
        }
        //复制当前数组并扩展。
        Object[] newElements = Arrays.copyOf(current, len + 1);
        newElements[len] = e;
        setArray(newElements);
        //true表示添加成功
        return true;
    }
}
set
//替换指定索引处的元素。
//返回值:返回被替换的旧元素(符合 List.set 接口规范)
public E set(int index, E element) {
    synchronized (lock) {
        Object[] es = getArray();
        //从数组中取出指定位置的旧值。
		//elementAt 是一个静态类型安全转换方法
        E oldValue = elementAt(es, index);
        //优化:只有当新旧元素引用不同时,才执行复制和修改。
        if (oldValue != element) {
            //长度不变,那么使用clone方法,JVM可以优化速度
            es = es.clone();
            //更新值
            es[index] = element;
        }
        //即使数组内容没变,也要通过 volatile 写确保内存屏障效果;
        setArray(es);
        return oldValue;
    }
}
remove
//作用:删除索引 index 处的元素;
//返回值:被删除的旧元素(符合 List.remove(int) 接口规范);
public E remove(int index) {
    synchronized (lock) {
        Object[] es = getArray();
        int len = es.length;
        //取出要删除的元素;
        E oldValue = elementAt(es, index);
        //计算被删除元素之后需要前移的元素个数/被删除元素的后缀长度
		//例如:len=5, index=2
        //numMoved = 5 - 2 - 1 = 2(即索引 3 和 4 这两个需要前移)。
        int numMoved = len - index - 1;
        Object[] newElements;
        //要删除的是最后一个元素(index == len - 1)
        if (numMoved == 0)
            //无需移动任何元素,直接截断数组即可;
            newElements = Arrays.copyOf(es, len - 1);
        else {
            //删除非末尾元素
			//当需要移动元素时,分三步完成:
            //1.创建新的空数组,长度比原数组少 1;
            newElements = new Object[len - 1];
            //2.复制前半部分(索引 [0, index))
            // es[0] es[index - 1] to newElements[0] newElements[index - 1]
            System.arraycopy(es, 0, newElements, 0, index);
            //复制后半部分(索引 [index + 1, len))
            //es[index + 1] es[index + 1 + numMoved - 1] to
            //newElements[index] newElements[index + numMoved - 1]
            System.arraycopy(es, index + 1, newElements, index, numMoved);
            //用跳过,实现删除
        }
        setArray(newElements);
        return oldValue;
    }
}
Iterator
迭代器创建方法
public Iterator<E> iterator() {
    return new COWIterator<E>(getArray(), 0);
}
public ListIterator<E> listIterator() {
    return new COWIterator<E>(getArray(), 0);
}
public ListIterator<E> listIterator(int index) {
    Object[] es = getArray();
    int len = es.length;
    if (index < 0 || index > len)
        throw new IndexOutOfBoundsException(outOfBounds(index, len));
    return new COWIterator<E>(es, index);
}
COWIterator 内部类详解
static final class COWIterator<E> implements ListIterator<E> {
    /** Snapshot of the array */
    private final Object[] snapshot;
    //当前游标位置,下一次 next() 将返回 snapshot[cursor];
	//非 volatile:因为迭代器本身不要求线程安全
    private int cursor;

    COWIterator(Object[] es, int initialCursor) {
        cursor = initialCursor;
        //注意这里有一个trick:
        //es虽然作为引用被传入(注意:不是深拷贝,而是直接引用原数组对象)
        //但是COW 的写操作不会修改旧数组
		//迭代器只持有旧数组引用,旧数组不会变
		//因此自然形成快照
        //如果 es 后续被修改,snapshot 也是不能看到的
        //这与ConcurrentHashMap不同,其迭代器仍然具有弱一致性。
        snapshot = es;
    }

    public boolean hasNext() {
        return cursor < snapshot.length;
    }

    @SuppressWarnings("unchecked")
    public E next() {
        if (!hasNext())
            throw new NoSuchElementException();
        return (E) snapshot[cursor++];  // 从快照读取,无锁!
    }

    public boolean hasPrevious() {
        return cursor > 0;
    }

    @SuppressWarnings("unchecked")
    public E previous() {
        if (!hasPrevious())
            throw new NoSuchElementException();
        return (E) snapshot[--cursor];
    }

    public int nextIndex() { return cursor; }
    public int previousIndex() { return cursor - 1; }

    // 所有修改方法均不支持!
    //快照是只读的,无法反映修改;
	//若要修改,应直接调用 CopyOnWriteArrayList 的方法;
	//符合“快照迭代器”语义:只读、不可变视图。

    //remove替代方案:先收集要删除的元素,再批量调用 removeAll()。
    public void remove() { throw new UnsupportedOperationException(); }
    public void set(E e) { throw new UnsupportedOperationException(); }
    public void add(E e) { throw new UnsupportedOperationException(); }

    //Java 8 新增方法,高效批量消费剩余元素;
	//无锁:全程操作 snapshot;
    public void forEachRemaining(Consumer<? super E> action) {
        Objects.requireNonNull(action);
        final int size = snapshot.length;
        int i = cursor;
        cursor = size;
        //cursor = size:标记为“全部已遍历完”,避免重复消费;
		//直接 for 循环,避免多次方法调用开销;
        for (; i < size; i++)
            action.accept(elementAt(snapshot, i));  // 无锁批量遍历
    }
}
bulkRemove
允许一次性删除满足特定条件的多个元素,避免多次加锁和数组复制,极大提升批量操作效率。
public boolean removeIf(Predicate<? super E> filter) {
    Objects.requireNonNull(filter);
    return bulkRemove(filter);
}
public boolean removeAll(Collection<?> c) {
    Objects.requireNonNull(c);
    return bulkRemove(e -> c.contains(e));
}
public boolean retainAll(Collection<?> c) {
    Objects.requireNonNull(c);
    return bulkRemove(e -> !c.contains(e));
}

private boolean bulkRemove(Predicate<? super E> filter) {
    synchronized (lock) {
        return bulkRemove(filter, 0, getArray().length);
    }
}

private static long[] nBits(int n) {
    // n >> 6 = n / 64
    // 因为每个 long 占8个字节,在二进制有64位,可以表示64个元素是否要删除
    // 比如如果n < 64, n >> 6 = 0 + 1,说明要检查数组元素不足64,long数组只需要开拓一个long
    return new long[((n - 1) >> 6) + 1];
}

//设置对应long的对应位 为1
private static void setBit(long[] bits, int i) {
    bits[i >> 6] |= 1L << i; // i/64 找到对应的 long,1L << i 把第i位设置为1
}

//检查对应long的对应位 是否为0 //返回false表示不用删除
private static boolean isClear(long[] bits, int i) {
        return (bits[i >> 6] & (1L << i)) == 0;
}

boolean bulkRemove(Predicate<? super E> filter, int i, int end) {
    // assert Thread.holdsLock(lock);
    final Object[] es = getArray();

    //filter.test返回true,表示该元素需要删除

    // 1. 跳过前缀中不满足条件的元素(优化)
    //如果开头很多元素不需要删除,直接跳过,避免后续位图分配;
    //减少无谓的位图操作和内存分配。
    for (; i < end && !filter.test(elementAt(es, i)); i++)
        ;

    // 2. 如果没有要删除的元素(上面for循环 i++,如果全部都不满足filter i就会>= end)
    if (i >= end) {
        //底层数组被修改,抛出CME
        //防重入,test方法中调用了修改数组的方法
        if (es != getArray())
            throw new ConcurrentModificationException();
        //返回false表示没有删除
        return false;
    }

    // 3. 标记所有待删除元素
    final int beg = i; //要删除的元素初始索引
    // 位图
    // end - beg计算的是除前缀外剩下数组长度 也就是要使用位图的数量
    final long[] deathRow = nBits(end - beg);
    int deleted = 1; //计数,一共删除了多少元素
    deathRow[0] = 1L;  // 标记第一个待删元素
    //检查原数组es,知道前beg - 1个不用删除,第beg个要删除,那么i从beg+1开始
    for (i = beg + 1; i < end; i++) {
        //test返回true,说明要删除
        if (filter.test(elementAt(es, i))) {
            //设置第i位1
            //i - beg 是因为 for循环开始时i = beg + 1
            setBit(deathRow, i - beg);
            //说明要有一个元素被删除,++
            deleted++;
        }
    }

    // 4. 继续检查是否发生并发修改(防重入)
    if (es != getArray())
        throw new ConcurrentModificationException();

    // 5. 构建新数组(大小为原数组长度 - 要删除数量)
    final Object[] newElts = Arrays.copyOf(es, es.length - deleted);
    int w = beg;
    //迁移
    for (i = beg; i < end; i++) {
        if (isClear(deathRow, i - beg)) // 未被标记则保留
            newElts[w++] = es[i];
    }
    //注意bulkRemove 并没有实际删除元素,而是跳过这些要被删除的元素,然后发布新的数组
    // 6. 如果 end 不等于 原始数组长度,那么需要复制尾部未扫描元素([end, len))
    // 此时i = end,len = es.length - end
    System.arraycopy(es, i, newElts, w, es.length - i);

    // 7. 发布新数组
    setArray(newElts);
    return true;
}
subList
在 CopyOnWriteArrayList 中,subList(int fromIndex, int toIndex) 返回的是一个 COWSubList 对象,它是 CopyOnWriteArrayList 的内部类,不是独立的集合,而是一个视图(view),其底层仍然指向原列表的数组。
//返回一个基于原数组的视图/窗口,只关注fromIndex 到 toIndex的元素
public List<E> subList(int fromIndex, int toIndex) {
    synchronized (lock) {
        Object[] es = getArray();
        int len = es.length;
        int size = toIndex - fromIndex;
        //边界检查
        if (fromIndex < 0 || toIndex > len || size < 0)
            throw new IndexOutOfBoundsException();
        return new COWSubList(es, fromIndex, size);
    }
}

//这是一个内部类,意味着COWSubList可以调用COWArrayList的方法
private class COWSubList implements List<E>, RandomAccess {
    // 子列表在原数组中的起始偏移
    private final int offset;
    // 子列表长度(可变)
    private int size;
    // 创建时原列表的数组快照引用
    private Object[] expectedArray;

    COWSubList(Object[] es, int offset, int size) {
        expectedArray = es;   //注意这里是引用赋值
        this.offset = offset;
        this.size = size;
    }
}
COWSubList 的几乎所有方法(如 get, add,set, size, iterator 等)都会调用:
private void checkForComodification() {
    //如果原列表的 array 引用不再是当初创建子列表时的那个数组,
    //就说明原列表被修改过(因为 CopyOnWrite 的写操作会生成新数组并更新 array 引用)。
    if (getArray() != expectedArray)
        throw new ConcurrentModificationException();
}
这样设计的主要目的是:防止视图错乱,COWSubList 依赖 offset 和 size 定位元素,如果原列表结构被外部改变,offset 指向的就不是原来的元素了。
什么操作会触发CME异常?
合法操作:通过 subList 自身修改
只有通过COWSubList自身的方法修改,才会更新COWSubList#expectedArray,本质上也是先调用CopyOnWriteArrayList对应的方法,再获取新数组来更新COWSubList#expectedArray。
非法操作:通过原列表修改
通过原列表修改,COWSubList无法更新expectedArray,从而导致再次调用COWSubList的方法时,会抛出ConcurrentModificationException。
迭代器不会抛 CME,为什么子列表会抛?
迭代器是只读快照,不关心原列表后续修改;子列表是可写视图,必须保证其操作语义的一致性(如 get(0) 始终返回同一元素);
因此子列表需要检测“外部修改”,而迭代器不需要。
如何安全使用 subList?
创建子列表后,只通过该子列表操作,不要同时操作原列表;
或者,将子列表转为独立列表:
List<E> safeSub = new ArrayList<>(list.subList(a, b));
ConcurrentLinkedQueue
Java 提供的线程安全的 Queue 可以分为阻塞队列和非阻塞队列,其中阻塞队列的典型例子是 BlockingQueue,非阻塞队列的典型例子是 ConcurrentLinkedQueue,在实际应用中要根据实际需要选用阻塞队列或者非阻塞队列。
阻塞队列通过加锁来实现,非阻塞队列通过 CAS 操作实现。
ConcurrentLinkedQueue这个队列使用链表作为其数据结构。
ConcurrentLinkedQueue应该算是在高并发环境中性能最好的队列了。它之所有能有很好的性能,是因为其内部复杂的实现,主要使用 CAS 非阻塞算法来实现线程安全。
ConcurrentLinkedQueue 适合在对性能要求相对较高,同时对队列的读写存在多个线程同时进行的场景。即如果对队列加锁的成本较高则适合使用无锁的 ConcurrentLinkedQueue 来替代。
关键数据结构
Node 节点类
static final class Node<E> {
    volatile E item;
    volatile Node<E> next;

    Node(E item) {
        ITEM.set(this, item);  // 宽松写,因为item只有通过CAS发布后才能被看到
    }

    Node() {}  // 构造死节点(哑节点)

    void appendRelaxed(Node<E> next) {
        NEXT.set(this, next);  // 宽松设置next指针
    }

    boolean casItem(E cmp, E val) {
        return ITEM.compareAndSet(this, cmp, val);
    }
}
核心字段
//可以在 O(1) 时间内到达第一个 未删除 节点(如果有)的节点。
//不变量:
    //- 所有没被删除的节点都可以通过 head的succ() 到达
    //- head != null
	//- (tmp = head).next != tmp || tmp != head (防止自链接异常)
//head.item 可能为空,也可能不为空。
//允许尾部滞后于头部,即尾部无法从头部到达!
transient volatile Node<E> head;  // 头指针

//可以在 O(1) 时间内到达列表中最后一个节点(即 node.next == null 的唯一节点)的节点。
//不变式:
	//- 最后一个节点始终可以通过 succ() 从 tail 到达
    //- tail != null
//tail.item 可能为空,也可能不为空。
//允许尾部滞后于头部,即尾部无法从头部到达!
//tail.next 可能是也可能不是自链接的。
private transient volatile Node<E> tail;  // 尾指针
更新策略
head和tail允许滞后更新。只有当前指针距离首或尾节点两步或更多时才更新。
即head、tail当前指向的节点,不一定是真实链表上的head、tail。只有在遍历链表时,距离head、tail两个节点或更多的,才会更新head、tail指向真实的head、tail。
tail为private、head不是private
// head 被多处直接访问
final Node<E> succ(Node<E> p) {
    if (p == (p = p.next))
        p = head;  // 直接访问head
    return p;
}

// tail 主要在offer()和addAll()中通过TAIL VarHandle访问
private static final VarHandle TAIL;
// 通过VarHandle进行原子操作,而不是直接字段访问
Iterator实现的需要:内部类Itr需要访问head来开始遍历。tail只是一个优化指针,不是算法正确性必需的(可以从head遍历到尾)。
自链接节点 (self-link) 是什么?
自链接节点是指一个节点的 next 指针指向自身的特殊状态。在 ConcurrentLinkedQueue 中,这是标识**节点已经"出队"或"失效"**的重要机制。
updateHead() 方法中的自链接
//原子推进 head 并隔离旧节点
final void updateHead(Node<E> h, Node<E> p) {
    // assert h != null && p != null && (h == p || h.item == null);
    // 旧head不能为null
    // 新head不能为null
    // 如果新旧head 相等,说明已经update过
    // 旧head item为空 说明队列为空
    if (h != p && HEAD.compareAndSet(this, h, p))
        NEXT.setRelease(h, h);  // 关键行:将旧head指向自己
    	// 使用release语义确保自链接对其他线程可见
    	// 虽然volatile Node<E> next 本身就是nxt,但是直接写是full—fence
    	// 使用setRelease 就只有store-fence
}
当成功更新 head 指针后,旧的头节点会被设置为自链接。
自链接的作用/succ如何工作
final Node<E> succ(Node<E> p) {
    if (p == (p = p.next))  // 检测自链接
        p = head;           // 遇到自链接就跳回真正的head
    return p;
    //正常情况:p的下一个有效节点
	//异常情况:当p自链接时,返回当前head
}
自链接作为一个明确的"已失效"标记,任何遍历遇到自链接节点都知道这个节点已经不在活动队列中了。
遍历前队列:Head → A → B → C → null
遍历时队列被并发修改:
Head → B → C → null
A → A (自链接)
线程原本在A,调用 succ(A) 发现自链接,立即跳转到当前Head(B)。
head/tail 滞后更新的优化策略
滞后更新
// 在offer()和poll()中的体现:
if (p != t) // p == t 则不更新tail,允许tail滞后一步(刚刚插入新节点了)而不立即更新
    TAIL.weakCompareAndSet(this, t, newNode);  // 不保证成功,失败也可接受

if (p != h) // p == h 则不更新head,允许head滞后一步(刚刚插入新节点了)而不立即更新
    updateHead(h, ((q = p.next) != null) ? q : p);
滞后目的:性能提升
// 朴素方案 每次入队都更新tail:
if (NEXT.compareAndSet(p, null, newNode)) {
    // 每次成功入队都必须更新tail
    TAIL.compareAndSet(this, t, newNode);  // 每次都需要CAS
    return true;
}

// 滞后更新方案 每次入队先检查再更新tail:
if (NEXT.compareAndSet(p, null, newNode)) {
    if (p != t)
        TAIL.weakCompareAndSet(this, t, newNode);  // 且使用更轻量的weak CAS
    return true;
}
朴素方案:每个成功入队需要2次CAS,next指针CAS成功 + tail指针CAS成功。
滞后更新:平均每个成功入队只需1.5次CAS(next指针必须成功,tail指针有时失败也可)。
offer() 无锁入队
public boolean offer(E e) {
    //创建新节点,包装插入的e
    final Node<E> newNode = new Node<E>(Objects.requireNonNull(e));

    //无限循环+CAS
    //捕获当前tail的快照到局部变量t
	//使用局部变量避免多次读取volatile的tail
	//tail可能在循环中变化,但t保持快照值
    for (Node<E> t = tail, p = t;;) {
        //p用于遍历寻找真正的尾节点
        //q是探测灯,临时变量,存储p.next
        Node<E> q = p.next;
        //q == null 说明 p是最后一个节点
        if (q == null) {
            if (NEXT.compareAndSet(p, null, newNode)) {
                // 这里就是线性化点
    			// 所有后续操作都是优化,不影响正确性

                // p 和 t 比较是为了检查是否经历了遍历 (初始化时p = t)
                // p = t 说明tail准确 允许tail滞后一步(刚刚插入新节点了)而不立即更新
                // p != t 说明遍历了多个节点才找到尾节点,tail滞后
                //(原来允许滞后一步,刚刚又插入新节点,算是至少滞后两步了),应该更新
                if (p != t)
                    //weak 允许虚假失败
                    TAIL.weakCompareAndSet(this, t, newNode);
                return true;
            }
            // 输给另一个线程的CAS竞争;下次for循环 重新读取next
        }
        else if (p == q)
            // 如果q = p.next指向p自己,说明p已经被移除(设置自链接)
            // 说明从链表上掉下来了。

            // t = tail重新读取tail到局部变量t
            // t != (t = tail):比较旧的t和新读取的tail
            //如果tail变化了,说明其他线程更新了tail,使用新的tail
			//如果tail未变,说明tail也掉出链表了,跳转到head,其总是能到达所有存活节点
            p = (t != (t = tail)) ? t : head;
        else
            //p != t:p是否已经从初始位置移动过 (初始化p = t)
            //t != (t = tail):重新读取tail并检查是否变化
            //如果p != t(p移动过)且t变化了(tail被其他线程更新)
			//则p = 新的tail(因为新的tail可能更接近真正的尾节点)
			//否则 p = q(p的下一个节点)进入下一次循环
            p = (p != t && t != (t = tail)) ? t : q;
    }
}
场景1:无竞争快速入队
初始:tail → A → null

线程1:offer(B)
1. 此时t = tail (指向A), p = t
2. q = p.next = null
3. CAS成功:A.next = B
4. p == t,没经过遍历不更新tail

结果:A → B → null,tail仍指向A(滞后)
场景2:高并发竞争
初始:tail → A → null
线程1:offer(B),线程2:offer(C)

时间线:
1. 线程1:t1 = tail(A), p1 = A, q1 = null
2. 线程2:t2 = tail(A), p2 = A, q2 = null

3. 线程1:CAS成功,A.next = B,返回true
4. 线程2:CAS失败(A.next不再是null)

此时队列:A → B → null

5. 线程2:重新循环,现在t2 = A,p2 = B, q2 = null
6. 线程2:CAS成功,B.next = C

7. 线程2:p2 != t2,更新tail(A) → C(可能成功或失败)
poll() 无锁出队
public E poll() {
    //标签,允许从内层循环直接跳回此处重新开始
    //当检测到自链接时,需要完全重新开始遍历
    restartFromHead:
    //无限循环,典型的无锁算法模式,直到成功或队列为空
    for (;;) {
        //h = head:捕获head的快照到局部变量h
        //p = h:工作指针p从head开始
		//p用于遍历寻找第一个非空item的节点
		//q:临时变量,存储p.next
		//p = q:循环推进,p移动到下一个节点
        for (Node<E> h = head, p = h, q;; p = q) {
            final E item;
            //null:表示节点已被逻辑删除或已经出队
            if ((item = p.item) != null && p.casItem(item, null)) {
                // CAS成功,p出队前的处理

                //如果p == h:p就是head,head已经指向出队的节点,head是准确的
				//如果p != h:p经过了多次遍历才指向实际上的head,说明head滞后需要更新
                if (p != h)
                    // h 是旧head
                    // ((q = p.next) != null) ? q : p 用于挑选新head
                    // q 等于 p.next
                    //如果q != null:使用q作为新head (跳过刚出队p)
					//如果q == null:使用p作为新head(说明p是唯一节点,虽被删但需保持链表结构,以及帮助GC)
                    updateHead(h, ((q = p.next) != null) ? q : p);
                //返回出队的元素
                return item;
            }
            //处理 item 为 null 的情况 或者 CAS失败
            //q = p.next:读取p的下一个节点
            //如果p.next为null
			//情况1:队列为空,p是哑节点 (创建CLQ时 head = tail = dummy)
			//情况2:p是最后一个节点且刚刚被另外线程CAS
            else if ((q = p.next) == null) {
                // 情况1 h == p updateHead 无效
                // 情况2 帮助GC,仍要推进head
                // 举例:
                // head → B(item=null) → C(item=null) → D(item=null) → null
				// D 是最后一个节点,且刚刚已经出队(item=null)
				// head 滞后,仍指向 B,需要更新到D,帮助GC,B、C两个节点
                updateHead(h, p);
                //队列为空,返回null(与阻塞队列不同)
                return null;
            }
            //上面分支q = p.next,
            //如果q == p,说明p曾是head,但已被其他线程通过updateHead设置为自链接
            else if (p == q)
                //跳回外层循环,重新读取head,因为当前遍历状态已无效
                continue restartFromHead;
        }
    }
}
skipDeadNodes()
跳过逻辑删除的死节点
//TODO
size() 方法为何昂贵?弱一致性下的计数逻辑
//first()需要遍历:
//跳过head可能的哑节点
//找到第一个item不为null的节点
Node<E> first() {
    restartFromHead: for (;;) {
        for (Node<E> h = head, p = h, q;; p = q) {
            boolean hasItem = (p.item != null);
            if (hasItem || (q = p.next) == null) {
                updateHead(h, p);
                return hasItem ? p : null;
            }
            else if (p == q)
                continue restartFromHead;
        }
    }
}

//size()线程开始遍历,如果其他线程同时修改队列,无锁无法保证一致性
//加锁违背高并发设计原则
public int size() {
    restartFromHead: for (;;) {
        int count = 0;
        //first 通过遍历 找到第一个有效节点
        for (Node<E> p = first(); p != null;) {
            if (p.item != null)
                if (++count == Integer.MAX_VALUE)
                    break;  // @see Collection.size()
            if (p == (p = p.next))
                continue restartFromHead;
        }
        return count;
    }
}

//A - B - C - D
//时间线:
//1. size(): 计数A (count=1)
//2. 线程2: poll() 移除B (B.item = null)
//3. size(): 到达B,发现B.item == null,不计入 (count=1)
//4. 线程3: offer(E) 在D后添加E
//5. size(): 继续遍历C (count=2)、D (count=3)
//6. 但错过了E,因为E在size()开始后添加
//7. 结果:size()返回3,实际可能有4个元素
"弱一致性"的具体含义:
- 不反映瞬时状态:返回的是某个时间点附近的状态
- 可能错过并发修改:遍历期间的变化可能不被反映
- 但不会"破坏"一致性:不会返回不可能的状态(如负数)
如果需要判断是否为空,请使用isEmpty(比size快)。
如果需要判断是否为空,且后续需要获取元素,直接使用poll。
// 反模式:基于size()做决策
while (queue.size() > 0) {  // 每次都是O(n)遍历!
    process(queue.poll());
}

// 正确模式:基于poll()结果
E element;
while ((element = queue.poll()) != null) {
    process(element);
}
线性化点(Linearization Point)
线性化点(Linearization Point) 是无锁(Lock-Free)和无等待(Wait-Free)算法中用于证明操作原子性的关键概念。
定义:
一个并发操作的线性化点,是该操作执行过程中的某个瞬间,
在这个瞬间,操作看起来是原子地完成的,
且所有线程观察到的效果,等价于某个顺序执行(串行)的历史。
简单说:线性化点就是操作“真正生效”的那个原子时刻。
CLQ中,线性化点 ,在poll/offer中成功CAS的那个时刻。
//offer NEXT.compareAndSet(p, null, newNode)

//为什么?
//在此之前,newNode 对其他线程不可见(因为未链接到主链)
//在此之后,newNode 立即对所有后续操作可见
//所有线程读取 p.next 都会看到 newNode
//效果:e 被原子地添加到队列尾部


//poll if ((item = p.item) != null && p.casItem(item, null)) {  // 线性化点

//为什么?
//在此之前,item 仍可被其他 peek() 或 poll() 看到
//在此之后,p.item == null,所有后续操作都认为该元素已被移除
//即使 head 未更新,其他线程遍历到 p 时也会跳过它
//效果:item 被原子地从队列中移除

//由于offer中一次CAS,只能由一个线程成功,也就保证了串行化。
//而offer/poll 一个是对队头CAS、一个是对队尾CAS,两者在局部上是没有串行的。
//但是因为必须先有x,才能移除x。在全局上是串行的。
BlockingQueue
BlockingQueue 通常用于一个线程生产对象,而另外一个线程消费这些对象的场景。
如果队列是满的,负责生产的线程插入对象时发生阻塞。它会一直处于阻塞之中(或者设定超时结束阻塞、或者返回异常结束阻塞、或者返回布尔值结束阻塞),直到负责消费的线程从队列中拿走一个对象。
如果队列是空的,负责消费的线程拿出对象时发生阻塞。它会一直处于阻塞之中(或者设定超时结束阻塞、或者返回异常结束阻塞、或者返回布尔值结束阻塞),直到负责生产线程把一个对象插入队列。
无法向一个 BlockingQueue 中插入 null。如果你试图插入 null,BlockingQueue 将会抛出一个 NullPointerException。
//TODO
补:生产者-消费者模型
生产者-消费者(Producer-Consumer)是经典并发模型:生产者线程产生数据(任务、消息、对象)并放入一个共享缓冲区(队列、环形数组等),消费者线程从缓冲区取数据并处理。
常用实现方式:wait/notify(手写)、java.util.concurrent 中的 BlockingQueue、Lock + Condition、更高性能的 Disruptor 等
wait/notify + synchronized
Buffer
// 有界缓冲(环形缓冲)—— 使用 Object 的 monitor + wait/notify 实现
public class BoundedBuffer<T> {
    // 缓冲区,存放元素的数组(固定容量)
    // 使用环形数组(下标可以伪无限递增):减少O(n) 拷贝,提高效率
    private final Object[] items;
	// 下一个放入位置索引
    private int putPtr = 0;
    // 下一个取出位置索引
    private int takePtr = 0;
    // 当前缓冲中元素个数
    private int count = 0;


    // 构造器:capacity 为缓冲区大小
    public BoundedBuffer(int capacity) {
        if (capacity <= 0) throw new IllegalArgumentException("capacity <= 0");
        this.items = new Object[capacity]; // 分配底层数组
    }

    // 生产者调用:将元素放入缓冲,必要时阻塞直到有空间
    // synchronized修饰的是方法,那么put方法执行时,take方法无法执行,两者互斥
    // 步骤1、2应该是原子的,1、2之间需要 条件 不能被修改
    // 如果非原子性的,可能会导致信号丢失:
    // 1、2之间线程A释放锁,线程B获取锁修改条件,B释放锁,然后notify
    // A获取锁,A执行wait(),持续阻塞在这一行
    // 现在没线程notify A,出现死锁
    public synchronized void put(T x) throws InterruptedException {
        // while 循环用于防止虚假唤醒,重新检查条件
        // 当线程因为条件不满足而等待时,被唤醒后条件不一定仍然满足!(缓冲区依然是满的)
        // 因此醒来后必须重新检查条件是否仍然成立
        // 必须使用while,而使用if只会检查一次,被唤醒后就不检查了,出现虚假唤醒
        while (count == items.length) { //步骤1. 检查条件
            // 如果缓冲区已满,则等待
            // 即释放 monitor lock 并等待被 notify/notifyAll
            wait(); // 步骤2. 条件不满足,等待
            //(调用 wait/notify 必须持有相应 monitor,否则会抛 IllegalMonitorStateException。)
        }
        // 以下为临界区:我们持有 monitor lock,可以修改共享状态
        // 放入元素进入缓冲区
        items[putPtr] = x;
        // 环形索引推进。可以用位运算提高效率
        putPtr = (putPtr + 1) % items.length;
        // 更新计数
        count++;
        // 通知可能等待的消费者、其他生产者
        // notifyAll是为了防止死锁
        // 但是在高并发场景它会唤醒大量线程,增加竞争
        notifyAll();
        // 离开 synchronized 块时隐式释放 monitor lock(允许唤醒线程竞争该锁)
    }

    // 消费者调用:从缓冲中取出一个元素,必要时阻塞直到有元素
    @SuppressWarnings("unchecked")
    public synchronized T take() throws InterruptedException {
        // while 循环用于防御虚假唤醒以及保证条件成立
        while (count == 0) {
            // 缓冲为空,则等待
            wait();
            // 释放 monitor-lock 并等待通知
        }
        // 临界区:取元素并更新状态
        // 取出元素引用
        Object x = items[takePtr];
        // 防止内存泄露(帮助 GC)
        items[takePtr] = null;
        // 环形索引推进
        takePtr = (takePtr + 1) % items.length;
        // 更新计数
        count--;
        // 通知可能等待的生产者(或其他消费者)
        notifyAll();
        // 返回取出的元素/调用方法消费
        return (T) x;
        // 离开 synchronized 块时释放 monitor
    }
}
Usage
public class Demo {
    public static void main(String[] args) {
        final BoundedBuffer<Integer> buffer = new BoundedBuffer<>(5); // 容量 5

        // 创建并启动多个生产者线程
        for (int p = 0; p < 3; p++) {
            final int id = p;
            new Thread(() -> {
                try {
                    for (int i = 0; i < 10; i++) {
                        int item = id * 100 + i; // 造点数据
                        buffer.put(item);        // 放入缓冲(可能阻塞)
                        System.out.println("Producer " + id + " put " + item);
                        Thread.sleep(50);        // 模拟生产耗时
                    }
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            }, "P-" + p).start();
        }

        // 创建并启动多个消费者线程
        for (int c = 0; c < 2; c++) {
            final int id = c;
            new Thread(() -> {
                try {
                    while (true) {
                        Integer v = buffer.take(); // 取出元素(可能阻塞)
                        System.out.println("Consumer " + id + " took " + v);
                        Thread.sleep(200);         // 模拟消费耗时
                    }
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            }, "C-" + c).start();
        }
    }
}
BlockingQueue
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class BlockingQueueDemo {
    public static void main(String[] args) {
        // 创建一个有界阻塞队列,容量为 10
        final BlockingQueue<Integer> queue = new ArrayBlockingQueue<>(10);

        // 使用线程池管理生产者线程(方便示例)
        // 三个生产者线程
        // 在实际生产环境中,应该使用ThreadPoolExecutor手动配置参数
        ExecutorService prodPool = Executors.newFixedThreadPool(3);
        // 提交 3 个生产者任务
        // 每个任务使用for循环生产50个数据后自动执行关闭
        for (int p = 0; p < 3; p++) {
            final int id = p;
            prodPool.submit(() -> {
                try {
                    for (int i = 0; i < 50; i++) {
                        // 生成数据
                        int item = id * 1000 + i;
                        // 阻塞直到队列有空间(线程安全)
                        queue.put(item);
                        System.out.println("Producer " + id + " put " + item);
                        Thread.sleep(20);
                    }
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            });
        }

        // 使用线程池管理消费者线程
        // 4个生产者线程
        ExecutorService consPool = Executors.newFixedThreadPool(4);
        // 提交 4 个消费者任务
        // 每个任务使用while循环处理,除非手动关闭,否则一直运行
        for (int c = 0; c < 4; c++) {
            final int id = c;
            consPool.submit(() -> {
                try {
                    while (true) {
                        // 阻塞直到有元素可取(线程安全)
                        Integer item = queue.take();
                        System.out.println("Consumer " + id + " took " + item);
                        Thread.sleep(100);
                    }
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            });
        }

        // 生产环境应在合适时机 shutdown()
    }
}
补:ConcurrentModificationException
ConcurrentModificationException(简称 CME)是 Java 集合框架中用于 fail-fast(快速失败) 机制的核心异常。它的设计初衷是为了在并发修改检测到不一致状态时,尽早暴露问题,而不是让程序在后续产生不可预测的、难以调试的错误。
在非线程安全集合(如 ArrayList、HashMap)中,如果一个线程在使用迭代器遍历,另一个线程在修改(add/remove),迭代器可能:跳过某些元素;重复访问某些元素;读到 null 或损坏的数据;甚至导致 JVM 崩溃(极罕见,但在 native 代码中可能)。
这些错误难以复现、难以调试,因为它们依赖于线程调度的时序。
因此需要提供明确的错误信号,而非静默失败。
非并发集合如何检测到需要抛出CME?
以 ArrayList 为例,它的内部机制可以概括为 “快速失败” 机制。
核心原理:modCount 字段
-
modCount(修改计数器):在
ArrayList(以及大多数非线程安全集合)的内部,都有一个名为modCount的整型字段。任何会结构化修改集合的操作(例如:
add,remove,clear)都会使这个modCount的值加一。结构性修改是指改变集合大小的操作。 -
迭代器的预期值:
expectedModCount:当你通过
iterator()方法获取一个迭代器时,这个迭代器对象会在内部记录下当前集合的modCount值,我们称之为expectedModCount。迭代器认为,在它的生命周期内,
modCount应该始终等于它记录的这个expectedModCount。 -
检查与抛出异常:
在迭代器执行
next(),remove(),forEachRemaining()等方法时,它会首先调用一个内部检查方法checkForComodification()。这个方法的逻辑非常简单:
final void checkForComodification() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); }如果在迭代过程中,其他线程(或者甚至当前线程通过非迭代器自己的
remove方法)对集合进行了结构性修改,就会导致集合的modCount增加,而迭代器内部的expectedModCount还是旧值。当下一次迭代器方法被调用时,检查发现
modCount != expectedModCount,便立即抛出ConcurrentModificationException。
单线程会抛吗?
会!比如在 for-each 中直接调用list.remove()。
正确做法是使用迭代器自己的 remove 方法,因为它会在删除元素后,同步更新 expectedModCount 以匹配新的 modCount:
能防止多线程错误吗?
不能!它只是提示,真正安全需要同步或并发集合。
CopyOnWriteArrayList 为何不抛 CME?
它采用 “快照迭代器”机制:
- 迭代器持有创建时的数组引用;
- 写操作复制新数组,不影响旧快照;
- 因此天然无并发冲突,无需
modCount,也永不抛CME。 - 不提供通过迭代器修改集合的方法:若要修改,应直接调用
CopyOnWriteArrayList的方法。
代价:迭代器看不到实时修改(但是保证最终一致性)。
ConcurrentHashMap 为何不抛 CME?
ConcurrentHashMap 的设计理念是高并发,它的迭代器实现了 弱一致性。
-
没有共享的
modCount:ConcurrentHashMap内部没有一个全局的、用于检测并发修改的modCount字段。迭代器根本不关心创建之后集合被修改了多少次。
-
实时遍历:
- 当你调用
keySet().iterator(),values().iterator()或entrySet().iterator()时,迭代器是直接去遍历当前动态变化的哈希表的。但是ConcurrentHashMap修改集合的方法是安全的,结构的变化(put/remove)不会终止迭代器,因此迭代器遍历时会尽可能遍历到所有出现在集合中的元素。
- 当你调用
-
不提供通过迭代器修改集合的方法:
- 若要修改,应直接调用
ConcurrentHashMap的方法;
- 若要修改,应直接调用
-
弱一致性的含义:迭代器不会回滚,也不会停止,也不会失败,只是尽力从当前正在变化的结构中返回“尽可能线性”的遍历顺序。
-
可能遍历到刚加入的节点:因为 put 时,next 指针会指向新节点,而遍历可能刚好读到。
-
可能遍历到已删除但仍可见的节点:因为链表删除是多个步骤通过锁f保证原子性,但是读时不竞争删除时的锁f(被删除节点还在next链中)。
-
可能漏掉某些节点:因为遍历到那个 bucket 时,因为put是多个步骤通过锁f保证原子性,但是读时不竞争put时的锁f(被插入节点还没接上next链)。
-
参考
https://javaguide.cn/java/collection/concurrent-hash-map-source-code.html
https://javaguide.cn/java/concurrent/java-concurrent-collections.html
- Semaphore
- CountDownLatch
- Exchanger
- CyclicBarrier
- Phaser
- HashTable
- ConcurrentHashMap
- CopyOnWriteArrayList
- ConcurrentLinkedQueue
- BlockingQueue
- 补:生产者-消费者模型
- 补:ConcurrentModificationException
- 参考