
Java多线程笔记(3)
锁
线程之间的协作底层类:LockSupport
CAS、原子类底层类:Unsafe
CAS、原子类
保障共享数据一致性工具类:
同步器AQS、ReentrantLock、ReentrantReadWriteLock
线程之间的通信/协作类:
Condition
什么是锁
锁的本质是:一种用于协调多个线程访问共享资源的机制。
简单理解:当一个线程获得锁后,其他线程必须等待它释放锁,才能访问受保护的代码或数据。
锁的分类
悲观锁、乐观锁
悲观锁
悲观锁总是假设最坏的情况,认为共享资源每次被访问时都会发生冲突,因此每次访问时都会加锁。
这样其他线程想访问这个共享资源时就会阻塞直到锁被释放。因此,悲观锁的并发性能较差。
应用场景:多写场景,即并发更新操作比较频繁的场景。
实现方式:synchronized关键字、ReentrantLock、数据库中的行锁、表锁等。
乐观锁
乐观锁总是假设最好的情况,假设共享资源不会发生冲突,只在提交操作时检查是否有冲突。所以线程在访问共享资源时不会上锁,乐观锁通常使用版本号机制或CAS(Compare And Swap)算法实现。
应用场景:多读场景,即读多写少的场景。
实现方式:版本号机制、CAS算法。在Java中,java.util.concurrent.atomic包下的原子类就是使用CAS实现的乐观锁。
公平锁、非公平锁
公平锁
公平锁是指多个线程按照申请锁的顺序来获取锁,即先到先得FIFO。公平锁会维护一个等待队列,当锁被释放时,会优先分配给等待时间最长的线程。
优点:等待锁的线程不会饿死。
缺点:整体吞吐效率相对非公平锁要低,因为公平锁需要维护一个队列,等待队列中除第一个线程以外的所有线程都会阻塞,并且唤醒队列中的线程需要上下文切换。
非公平锁
非公平锁是多个线程加锁时直接尝试获取锁,获取不到才会进入等待队列。如果此时锁正好可用,那么这个线程可以无需阻塞直接获取到锁。
优点:可以减少唤起线程的开销(此时刚好有线程来获取锁,那么给这个线程锁,无需唤醒等待队列中的线程,减少切换线程上下文),整体的吞吐效率高。
缺点:等待队列中的线程可能会饿死,或者等很久才会获得锁。
例子:ReentrantLock默认是非公平锁,可以通过构造方法传入true来设置为公平锁。synchronized一定是非公平锁。
可重入锁、非可重入锁
可重入锁
可重入锁也叫递归锁,指的是同一个线程在获取锁之后,再次获取该锁时不会被阻塞。可重入锁可以防止死锁。
例子:synchronized和ReentrantLock都是可重入锁。
非可重入锁
非可重入锁与可重入锁相反,同一个线程在持有锁的情况下再次申请锁时会被阻塞,直到释放锁。非可重入锁容易导致死锁。
例子:非可重入锁NonReentrantLock
独享锁(排他锁)、共享锁
独享锁(排他锁)
独享锁也叫排他锁,是指该锁一次只能被一个线程所持有。
如果线程T对数据A加上排他锁后,则其他线程不能再对A加任何类型的锁。获得排他锁的线程既能读数据又能修改数据。
例子:synchronized、ReentrantLock都是独享锁。
共享锁
共享锁是指该锁可以被多个线程所持有。 一般用于读操作。
如果线程T对数据A加上共享锁后,则其他线程只能对A再加共享锁,不能加排他锁。获得共享锁的线程只能读数据,不能修改数据。
例子:ReadWriteLock的读锁是共享锁。
无锁、偏向锁、轻量级锁、重量级锁
synchronized锁的四种状态,这里不讨论。
什么是死锁?
为了防止多线程竞争共享资源而导致数据错乱,都会在操作共享资源之前加上互斥锁,只有成功获得到锁的线程,才能操作共享资源,获取不到锁的线程就只能等待,直到锁被释放。
死锁条件
这四个条件必须同时满足才会导致死锁。
-
互斥条件
- 描述:一个资源每次只能被一个进程(或线程)使用。
- 解释:这是资源本身的特性,比如数据库连接、打印设备等。如果资源可以被多个线程共享,就不会有死锁。
-
请求与保持条件
- 描述:一个进程已经持有了至少一个资源,同时还在等待获取其他被占用的资源,对已获得的资源保持不放。
- 解释:线程 A 已经持有了资源 R1,它还在请求资源 R2。如果在请求 R2 时不会释放 R1,那么这个条件就满足了。
-
不剥夺条件
- 描述:进程已获得的资源,在未使用完之前,不能被强行剥夺,只能由该进程自己释放。
- 解释:其他线程或系统不能强行把线程 A 持有的锁 R1 抢过来给线程 B 用。
-
循环等待条件
- 描述:若干进程之间形成一种头尾相接的循环等待资源关系。
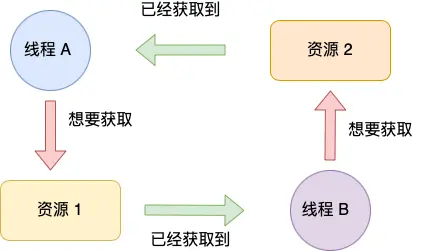
- 解释:线程 A 持有 R1,等待 R2;线程 B 持有 R2,等待 R1。这就形成了一个循环等待环。这是死锁最直接的表现形式。
public class DeadLockDemo {
    private static Object resource1 = new Object();//资源 1
    private static Object resource2 = new Object();//资源 2

    public static void main(String[] args) {
        new Thread(() -> {
            synchronized (resource1) {
                System.out.println(Thread.currentThread() + "get resource1");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println(Thread.currentThread() + "waiting get resource2");
                synchronized (resource2) {
                    System.out.println(Thread.currentThread() + "get resource2");
                }
            }
        }, "线程 1").start();

        new Thread(() -> {
            synchronized (resource2) {
                System.out.println(Thread.currentThread() + "get resource2");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println(Thread.currentThread() + "waiting get resource1");
                synchronized (resource1) {
                    System.out.println(Thread.currentThread() + "get resource1");
                }
            }
        }, "线程 2").start();
    }
}
输出
Thread[线程 1,5,main]get resource1
Thread[线程 2,5,main]get resource2
Thread[线程 1,5,main]waiting get resource2
Thread[线程 2,5,main]waiting get resource1
线程 A 通过 synchronized (resource1) 获得 resource1 的监视器锁,然后通过 Thread.sleep(1000);
让线程 A 休眠 1s,为的是让线程 B 得到执行,先获取到 resource2 的监视器锁。
线程 A 和线程 B 休眠结束了都开始企图请求获取对方的资源,然后这两个线程就会陷入互相等待的状态,这也就产生了死锁。
我们对线程 2 的代码修改成下面这样就不会产生死锁了。
new Thread(() -> {
            synchronized (resource1) {
                System.out.println(Thread.currentThread() + "get resource1");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println(Thread.currentThread() + "waiting get resource2");
                synchronized (resource2) {
                    System.out.println(Thread.currentThread() + "get resource2");
                }
            }
        }, "线程 2").start();
输出:
Thread[线程 1,5,main]get resource1
Thread[线程 1,5,main]waiting get resource2
Thread[线程 1,5,main]get resource2
Thread[线程 2,5,main]get resource1
Thread[线程 2,5,main]waiting get resource2
Thread[线程 2,5,main]get resource2

Process finished with exit code 0
我们分析一下上面的代码为什么避免了死锁的发生?
线程 1 首先获得到 resource1 的监视器锁,这时候线程 2 就获取不到了。然后线程 1 再去获取 resource2 的监视器锁,可以获取到。
然后线程 1 释放了对 resource1、resource2 的监视器锁的占用,线程 2 获取到resource1就可以执行了。这样就破坏了循环等待条件,因此避免了死锁。
预防死锁
要预防或避免死锁,核心思想就是破坏上述四个条件中的至少一个。
- 破坏互斥条件
- 方法:让资源不被一个线程独占。例如,使用无锁数据结构(
ReadWriteLock的读锁)、使用资源池等。 - 缺点:在很多情况下(如写操作)无法破坏,因为互斥是业务逻辑的要求。所以这个方法实用性有限。
- 方法:让资源不被一个线程独占。例如,使用无锁数据结构(
- 破坏请求与保持条件(一次性申请所有资源)
- 方法:采用“原子申请”策略。一个线程在开始执行前,必须一次性申请它所需要的所有资源。如果其中任何一个资源不可用,那么它就不能获得任何资源,必须等待。
- 优点:简单直接。
- 缺点:资源利用率低,可能导致饥饿(某个线程需要的热门资源一直被占用,导致它永远无法一次性申请到所有资源)。
- 破坏不剥夺条件
- 方法:如果一个线程已经持有了一些资源,但又无法立即申请到新的资源,那么它必须释放所有已持有的资源,过一段时间后再重新申请。
- 优点:适用于资源状态易于保存和恢复的场景。
- 缺点:实现复杂,反复申请释放资源会造成性能开销。
- 破坏循环等待条件(资源有序分配法)
- 方法:给所有资源类型定义一个严格的线性顺序。每个线程都必须按照这个递增的顺序来申请资源。
- 举例:假设有资源 A、B、C,我们规定申请顺序必须是 A -> B -> C。
- 线程1:申请 A -> 申请 B (允许)
- 线程2:申请 A -> 申请 C (允许)
- 线程3:申请 B -> 申请 A (禁止!因为 B 的顺序在 A 之后,必须先申请 A)
- 优点:这是最常用且有效的实践方法。它强制线程按顺序申请,不可能出现循环等待。
- 缺点:需要对系统内所有资源有清晰的认知;申请顺序可能不符合业务逻辑的自然顺序,导致资源利用率降低。
工具排查死锁
jstack
如果你想排查你的 Java 程序是否死锁,则可以使用 jstack 工具,它是 JDK 自带的线程堆栈分析工具。jstack 用于打印出 JVM 中某个进程或远程调试服务的线程堆栈信息(一般称为 threaddump 或者 javacore 文件)。它常用于诊断应用程序中的线程问题,比如线程死锁、死循环或长时间等待。
jstack option:
| 选项 | 描述 |
|---|---|
| -F | 当正常输出的请求不被响应时,强制输出线程堆栈 |
| -l | 除了堆栈外,显示关于锁的附加信息 |
| -m | 如果调用的是本地方法的话,可以显示 c/c++的堆栈 |
jstack 命令格式:
jstack [ option ] pid
使用 jstack
- 步骤:
- 使用
jps或ps命令找到 Java 进程的 PID。 - 执行命令:
jstack -l <PID>
- 使用
- 输出分析:
jstack会输出线程的堆栈信息。如果它检测到死锁,它会在输出的最后明确地指出 “Found one Java-level deadlock:“,并详细列出哪些线程在互相等待哪些锁。
使用 JConsole 或 VisualVM
- 步骤:
- 运行
jconsole或jvisualvm命令。 - 连接到目标 Java 进程。
- 在 JConsole 中,切换到“线程”标签页,点击“检测死锁”按钮。
- 在 VisualVM 中,切换到“线程”标签页,死锁信息会直接显示出来。
- 运行
在实际开发中,预防胜于治疗。通过良好的设计(如固定的锁顺序)、使用 Lock.tryLock() 带有超时的方法,可以有效地避免和缓解死锁问题。
Unsafe
介绍
sun.misc.Unsafe(或较新的 jdk.internal.misc.Unsafe)是 JDK 提供的“低层”工具类,暴露了直接操作内存、原子操作、内存屏障、类加载、实例分配等能力。它绕开了 Java 语言层的安全/封装,能做很多 JVM/本地级别的操作,因此被称为“不安全”。
自 Java 9 起,JDK 推荐使用 VarHandle、MethodHandles 等替代方案,但很多内部/高性能实现仍依赖 Unsafe(或由 HotSpot 通过 intrinsic 实现)。
普通应用不能直接引用 Unsafe(受模块/安全管理限制),也不建议在业务代码中使用;用 jdk.internal.misc.Unsafe 会有兼容性风险。
Unsafe与JUC
Unsafe 是 Java 并发包(java.util.concurrent, JUC)的基石,其核心作用体现在 CAS (Compare-And-Swap) 操作上。
在 AtomicInteger、AtomicReference 等原子类的实现中,它们内部都持有一个 Unsafe 的实例。当执行 compareAndSet 或 getAndIncrement 等原子操作时,最终都是通过调用 Unsafe 的 compareAndSwapInt、compareAndSwapObject 等 native 方法来实现的。
这些 CAS 操作利用了 CPU 的原子指令,能够在不使用重量级锁(如 synchronized)的情况下,保证对共享变量操作的原子性,从而极大地提升了并发性能。
如何获得Unsafe实例
getUnsafe()方法:Unsafe类提供了一个静态的public static Unsafe getUnsafe()方法。但是,这个方法内部会检查调用者的类加载器。只有由Bootstrap ClassLoader(启动类加载器)加载的类(通常是 JDK 核心库的类)才能成功调用此方法。如果我们在自己的应用程序代码中直接调用,会抛出SecurityException异常。- 反射获取:由于
Unsafe类内部持有一个私有的静态实例theUnsafe,我们可以通过 Java 的反射机制来绕过访问限制,获取这个私有字段的值。这是在应用代码中获取Unsafe实例的常用(但非官方推荐)方式。
功能
内存操作
在 Java 中是不允许直接对内存进行操作的,对象内存的分配和回收都是由 JVM 自己实现的。但是在 Unsafe 中,提供的下列接口可以直接进行内存操作:
//分配新的本地空间
public native long allocateMemory(long bytes);
//重新调整内存空间的大小
public native long reallocateMemory(long address, long bytes);
//将内存设置为指定值
public native void setMemory(Object o, long offset, long bytes, byte value);
//内存拷贝
public native void copyMemory(Object srcBase, long srcOffset,Object destBase, long destOffset,long bytes);
//清除内存
public native void freeMemory(long address);
注意:分配的是 堆外内存,不受 JVM 垃圾回收管理,需要去手动调用freeMemory方法进行释放,否则会产生内存泄漏。通用的操作内存方式是在try中执行对内存的操作,最终在finally块中进行内存的释放。
为什么要使用堆外内存?
- JVM 的垃圾回收器会移动(compact)堆对象以减少碎片、压缩内存。若你得到某个对象的“裸地址”并直接读写,GC 一旦移动对象,地址就失效,会崩溃或读写错误。堆外内存由本地分配(类似
malloc),不受 GC 移动,地址恒定。- 对垃圾回收停顿的改善。大量或大的堆内对象会被垃圾回收器扫描、标记、移动或回收,导致 GC 次数/停顿增加,当我们使用堆外内存时,在 GC 时减少回收停顿对于应用的影响。(堆外并不是完全“免 GC”。包装这个 native 内存的 Java 对象(例如
DirectByteBuffer的小包装对象)仍在堆上,会被 GC 管理,但这只是一个很小的对象,远比大容量数据便宜得多。)- 提升程序 I/O 操作的性能。在 I/O 通信,常见成本来自数据从用户空间到内核空间的拷贝(或反向拷贝),对于需要频繁进行内存间数据拷贝且生命周期较短的暂存数据,这些短寿命对象会加大年轻代回收压力。堆外内存,JVM 可以直接把 native 地址传给底层 C 函数/内核调用,省掉一次从 Java 堆到 native 的拷贝。
DirectByteBuffer是 Java 用于实现堆外内存的一个重要类,通常用在通信过程中做缓冲池,如在 Netty、MINA 等 NIO 框架中应用广泛。DirectByteBuffer对于堆外内存的创建、使用、销毁等逻辑均由 Unsafe 提供的堆外内存 API 来实现。
内存屏障
控制 CPU 和编译器的指令重排序,保证内存可见性和有序性。
//内存屏障,禁止load操作重排序。屏障前的load操作不能被重排序到屏障后,屏障后的load操作不能被重排序到屏障前
public native void loadFence();
//内存屏障,禁止store操作重排序。屏障前的store操作不能被重排序到屏障后,屏障后的store操作不能被重排序到屏障前
public native void storeFence();
//内存屏障,禁止load、store操作重排序
public native void fullFence();
对象操作
//仅通过 Class 对象就可以创建此类的实例对象,而且不需要调用其构造函数、初始化代码、JVM 安全检查等
//在 java.lang.invoke、Objenesis、Gson中都有相应的应用。
allocateInstance(Class<?> cls)
//获取对象字段在内存中的偏移量。
objectFieldOffset(Field f)

//在指定对象的内存地址中,通过偏移量获取一个对象引用
public native Object getObject(Object o, long offset);
//在指定对象的内存地址中,通过偏移量写入一个对象引用
public native void putObject(Object o, long offset, Object x);

//在指定对象的内存地址中,按偏移量读写字段。
putInt(Object o, long offset, int value)
getInt(...)

//相当于对volatile 变量的读写。
public native int getIntVolatile(Object o, long offset);
public native void putIntVolatile(Object o, long offset, int x);

//有序写(StoreStore 屏障),性能优于 volatile 写。
public native void putOrderedObject(Object o, long offset, Object x);
public native void putOrderedInt(Object o, long offset, int x);
public native void putOrderedLong(Object o, long offset, long x);
数据操作
//返回数组中第一个元素的偏移地址
public native int arrayBaseOffset(Class<?> arrayClass);
//返回数组中一个元素占用的大小
public native int arrayIndexScale(Class<?> arrayClass);
AtomicIntegerArray 通过 Unsafe 的 arrayBaseOffset、arrayIndexScale 分别获取数组首元素的偏移地址 base 及单个元素大小因子 scale。
CAS 操作
/**
  *  CAS
  * @param o         要被修改字段的对象
  * @param offset    对象被修改字段的偏移量
  * @param expected  期望值
  * @param update    更新值
  * @return          true CAS成功 false失败
  */
public final native boolean compareAndSwapObject(Object o, long offset,  Object expected, Object update);

public final native boolean compareAndSwapInt(Object o, long offset, int expected,int update);

public final native boolean compareAndSwapLong(Object o, long offset, long expected, long update);
线程调度
//唤醒线程
//thread表示要唤醒的线程
public native void unpark(Object thread);
//阻塞线程
//isAbsolute:
//false 表示 相对时间(相对于现在)
//true 表示 绝对时间(实现里是以毫秒自 epoch 的绝对时刻作为参数)
//time:
//0L 不设超时,永久阻塞
//其他非负数 表示超时后自动唤醒
public native void park(boolean isAbsolute, long time);

//获得对象锁(可重入锁)
@Deprecated
public native void monitorEnter(Object o);
//释放对象锁
@Deprecated
public native void monitorExit(Object o);
//尝试获取对象锁
@Deprecated
public native boolean tryMonitorEnter(Object o);
AbstractQueuedSynchronizer (AQS),就是通过调用LockSupport.park()和LockSupport.unpark()实现线程的阻塞和唤醒的,而 LockSupport 的 park、unpark 方法实际是调用 Unsafe 的 park、unpark 方式实现的。
Class 操作
//获取静态属性的偏移量
public native long staticFieldOffset(Field f);
//获取静态属性的对象引用
public native Object staticFieldBase(Field f);

//判断类是否需要初始化(用于获取类的静态属性前进行检测)
//如果一个类没有被初始化,那么它的静态属性也不会被初始化,最后获取的字段属性将是null。
public native boolean shouldBeInitialized(Class<?> c);
//初始化类
ensureClassInitialized(Class<?> c);

//运行时动态地创建一个类
public native Class<?> defineClass(String name, byte[] b, int off, int len, ClassLoader loader,ProtectionDomain protectionDomain);
//运行时动态地创建一个匿名类
//Lambda 表达式实现使用(未来会弃用)
public native Class<?> defineAnonymousClass(Class<?> hostClass, byte[] data, Object[] cpPatches);
系统信息
//返回系统引用的大小。返回值为4(32位系统)或 8(64位系统)。
public native int addressSize();
//内存页的大小,此值为2的幂次方。
public native int pageSize();
CAS
介绍
CAS 的全称是 Compare And Swap(比较与交换) ,用于实现乐观锁,被广泛应用于各大框架中。CAS 的思想很简单,就是用一个预期值和要更新的变量值进行比较,两值相等才会进行更新。
CAS 是一个原子操作,底层依赖于一条 CPU 的原子指令。
原子操作 即最小不可拆分的操作,也就是说操作一旦开始,就不能被打断,直到操作完成。
CAS 涉及到三个操作数:
- Exchange:拟写入的新值
- Destination:需要读写的内存位置/变量
- Compare:要对比的预期值
当D上的值等于C时,更新D上的值为E。否则不做更新。
那有没有可能在判断D上的值等于E之后,正准备更新D为新值E的时候,其它线程突然更改了D的值呢?
不会的。因为 CAS 是一种原子操作,可以简单理解为在判断时就已经尝试更新值了。
当多个线程同时使用 CAS 操作一个变量时,只有一个会胜出,并成功更新,其余均会失败,但失败的线程并不会被挂起,仅是被告知失败,并且允许再次尝试,当然也允许失败的线程放弃操作。
不同系统的CAS指令
X86
Linux 的 X86 下主要是通过cmpxchg这个指令完成CAS 操作的,但在多处理器情况下,通常会使用lock指令作为前缀来独占缓存行,实现原子性并防止别核同时写:lock cmpxchg [mem],reg 。
CMPXCHG是“Compare and Exchange”的缩写,它是一种原子指令,用于在多核/多线程环境中安全地修改共享数据。CMPXCHG在很多现代微处理器体系结构中都有,例如Intel x86/x64体系。对于32位操作数,这个指令通常写作CMPXCHG,而在64位操作数中,它被称为CMPXCHG8B或CMPXCHG16B。
ARM
ARM 平台有两种常见实现途径:LL/SC(Load-Linked / Store-Conditional)对 和 直接的 CAS 原语(自 ARMv8 LSE 起)。
LL/SC(旧方式,ARMv6 起可用)
它不提供一个直接的、万能的 CAS 指令,而是提供了一对更为基础的原子操作原语:加载独占 和 存储独占。
LDREX:加载独占寄存器。STREX:存储独占寄存器。
ARM 的 CPU 内部有一个叫做 独占监视器 的硬件单元。当执行 LDREX 时,它会记录被访问的地址。当其他处理器访问了同一块内存地址时,监视器会清除这个“独占”标记。随后的 STXR 会检查这个标记是否存在,如果不存在就说明发生了数据竞争,存储失败,需要回退重试。
CAS指令
ARMv8 LSE(Large System Extensions)引入的 CAS 指令。
// 假设使用 64-bit CAS:比较寄存器 x1 与 [x0],相等则把 x2 写入 [x0]
// 注:具体寄存器/操作数顺序以汇编器为准
cas x1, x2, [x0]
Java实现的CAS
在 Java 中,有一个Unsafe类。它里面都是一些native方法,其中就有几个是关于 CAS 的:
/**
  *  CAS
  * @param o         要被修改字段的对象
  * @param offset    对象被修改字段的偏移量
  * @param expected  期望值
  * @param update    更新值
  * @return          true CAS成功 false失败
  */
public final native boolean compareAndSwapObject(Object o, long offset,  Object expected, Object update);

public final native boolean compareAndSwapInt(Object o, long offset, int expected,int update);

public final native boolean compareAndSwapLong(Object o, long offset, long expected, long update);
补充
为什么CAS使用lock cmpxhg独占缓存行时,不算上锁?
从实现上来说
锁实际上是偏向于软件层面的,只不过其是由编程语言使用硬件提供的原子操作原语、操作系统底层API构建出来的。
锁的硬件基础主要包括:
- 原子操作指令(如x86的
LOCK CMPXCHG,ARM的LDXR/STXR) - 内存屏障指令(如x86的
MFENCE,ARM的DMB) - 缓存一致协议等
操作系统:线程调度与等待机制(如操作系统提供的Futex)等
CAS相关指令 是构造锁的原子操作指令,但指令本身不是一个完整的“锁实现”。
锁更高级的阻塞、公平等等语义,仍然需要软件层面实现。单一的独占缓存行指令,无法实现这样的语义。
从时间尺度上来说
CAS指令是瞬时,锁是持续的。
CAS使用lock cmpxchg 保证一次读-检查-写原子操作就结束,它只把缓存行短暂地变为独占态以完成操作,并不保留这种独占态作为“占有权”供后续指令无限期使用。而互斥锁的“持有”是一个持续的语义(持有者在解锁前持续占有临界资源)。
TAS、TTAS
- TAS(Test-And-Set):使用原子写操作竞争锁。若失败表示被占用,继续自旋并反复执行原子写。
- TTAS(Test-Test-And-Set):先做非原子的读(测试)看锁是否空闲,只有当锁空闲时才尝试一次TAS。目的是减少不必要的原子写/总线流量。
原子类
java.util.concurrent.atomic 包提供了一些用于原子操作的类。这些类利用底层的原子指令,确保在多线程环境下的操作是线程安全的。
1、基本类型
使用原子的方式更新基本类型
AtomicInteger:整型原子类AtomicLong:长整型原子类AtomicBoolean:布尔型原子类
2、数组类型
使用原子的方式更新数组里的某个元素
AtomicIntegerArray:整型数组原子类AtomicLongArray:长整型数组原子类AtomicReferenceArray:引用类型数组原子类
3、引用类型
AtomicReference:引用类型原子类AtomicMarkableReference:原子更新带有标记的引用类型。该类将 boolean 标记与引用关联起来。AtomicStampedReference:原子更新带有版本号的引用类型。该类将整数值与引用关联起来,可用于解决原子的更新数据和数据的版本号,可以解决使用 CAS 进行原子更新时可能出现的 ABA 问题。
4、对象的属性修改类型
AtomicIntegerFieldUpdater:原子更新整型字段的更新器AtomicLongFieldUpdater:原子更新长整型字段的更新器AtomicReferenceFieldUpdater:原子更新引用类型里的字段的更新器
Java原子类是通过UnSafe类实现的。
AtomicInteger
以AtomicInteger为例子。AtomicInteger是 Java 的原子类之一,主要用于对 int 类型的变量进行原子操作,它利用Unsafe类提供的低级别原子操作方法实现无锁的线程安全性。
//获取当前的值
public final int get()
//获取当前的值,并设置新的值
public final int getAndSet(int newValue)
//获取当前的值,并自增
public final int getAndIncrement()
//获取当前的值,并自减
public final int getAndDecrement()
//获取当前的值,并加上预期的值
public final int getAndAdd(int delta)
//lazySet 由 Unsafe.putOrderedXxx 实现
//在某些架构/JVM 上这等价于一个带store-store 屏障的写,从而避免了全屏障或明显的缓存刷新,性能更好。
//对可见性要求低使用
void lazySet(int newValue)
核心源码
Atomic类关键是使用了volatile对象保证其关键字段的可见性,以及使用Unsafe类实现CAS。
// 获取 Unsafe 实例
private static final Unsafe unsafe = Unsafe.getUnsafe();
private static final long valueOffset;

static {
    try {
        // 通过Unsafe获取“value”字段在AtomicInteger类中的内存偏移量
        valueOffset = unsafe.objectFieldOffset
            (AtomicInteger.class.getDeclaredField("value"));
    } catch (Exception ex) { throw new Error(ex); }
}
// 确保“value”字段的可见性
private volatile int value;

// 如果当前值等于预期值,则原子地将值设置为newValue
// 使用 Unsafe#compareAndSwapInt 方法进行CAS操作
public final boolean compareAndSet(int expect, int update) {
    return unsafe.compareAndSwapInt(this, valueOffset, expect, update);
}

// 原子地将当前值加 delta 并返回旧值
public final int getAndAdd(int delta) {
    return unsafe.getAndAddInt(this, valueOffset, delta);
}

// 原子地将当前值加 1 并返回加之前的值(旧值)
// 使用 Unsafe#getAndAddInt 方法进行CAS操作。
public final int getAndIncrement() {
    return unsafe.getAndAddInt(this, valueOffset, 1);
}

// 原子地将当前值减 1 并返回减之前的值(旧值)
public final int getAndDecrement() {
    return unsafe.getAndAddInt(this, valueOffset, -1);
}
Unsafe#getAndAddInt源码:
// 原子地获取并增加整数值
public final int getAndAddInt(Object o, long offset, int delta) {
    int v;
    //通过 自旋+CAS 实现失败后重试,直到CAS成功
    do {
        // 以 volatile 方式获取对象 o 在内存地址中偏移 offset 处的整数值
        v = getIntVolatile(o, offset);
    } while (!compareAndSwapInt(o, offset, v, v + delta));
    // 返回旧值
    return v;
}
ABA 问题
所谓的 ABA 问题,就是一个值原来是 A,变成了 B,又变回了 A。那 CAS 操作就会误认为它从来没有被修改过,但实际上却被更新了两次。
ABA 问题的解决思路是为变量添加额外信息,比如版本号或者时间戳。
JDK 的 atomic 包里提供了一个类AtomicStampedReference类来解决 ABA 问题。
这个类的compareAndSet方法的作用是首先检查当前引用是否等于预期引用,并且检查当前标志是否等于预期标志,如果二者都相等,才使用 CAS 设置为新的值和标志。
public class AtomicStampedReference<V> {
    //用 Pair 对象把两个数据当成一个原子单元进行 CAS
    private static class Pair<T> {
        final T reference;  //维护对象引用
        final int stamp;  //用于标志版本
        private Pair(T reference, int stamp) {
            this.reference = reference;
            this.stamp = stamp;
        }
        static <T> Pair<T> of(T reference, int stamp) {
            return new Pair<T>(reference, stamp);
        }
        //没有重新equals方法,每次都创建新的对象,保证对比时能够确保识别出ABA
    }
    private volatile Pair<V> pair;

    /**
      * expectedReference :更新之前的原始值
      * newReference : 将要更新的新值
      * expectedStamp : 期待更新的标志版本
      * newStamp : 将要更新的标志版本
      */
    public boolean compareAndSet(V   expectedReference,
                             V   newReference,
                             int expectedStamp,
                             int newStamp) {
        // 获取当前的(元素值,版本号)对
        Pair<V> current = pair;
        return
            // 引用没变
            expectedReference == current.reference &&
            // 版本号没变
            expectedStamp == current.stamp &&
            // 新引用等于旧引用
            ((newReference == current.reference &&
            // 新版本号等于旧版本号
            newStamp == current.stamp) ||
            // 构造新的Pair对象并CAS更新,不就地修改Pair是因为没有重写equals
            casPair(current, Pair.of(newReference, newStamp)));
    }

    private boolean casPair(Pair<V> cmp, Pair<V> val) {
        // 调用Unsafe的compareAndSwapObject()方法CAS更新pair的引用为新引用
        return UNSAFE.compareAndSwapObject(this, pairOffset, cmp, val);
    }
}
如果新的引用或者标记与当前的不同,那么就会调用 casPair 方法来尝试更新 pair 对象。
casPair 方法会尝试用 newReference 和 newStamp 创建的新的 Pair 对象替换当前的 Pair 对象。如果替换成功,casPair 方法会返回 true;如果替换失败(也就是说在尝试替换的过程中,Pair 对象已经被其他线程改变了),casPair 方法会返回 false。
补1
AtomicMarkableReference不能解决ABA问题。
假设初始:
reference = A, mark = false
- 线程 T1 读到:
expectedReference = A,expectedMark = false。 - T1 暂停。
- 线程 T2:
compareAndSet(A -> B, false -> true)成功。现在是(B,true)。 - 线程 T3:
compareAndSet(B -> A, true -> false)成功。现在又回到(A,false)。 - T1 恢复并执行它的
compareAndSet(A -> X, false -> true):它看到当前是(A,false),和它读到的一模一样,于是 CAS 通过 —— T1 完全没察觉中间 A→B→A 那段变化(ABA)。
因为 mark 只有 true/false 两个值,状态可以在有限集合中回到先前值,从而使中间变化被掩盖。
或者说 AtomicMarkableReference只能用来判断是否修改过变量。
补2
一个线程 T1 读取内存位置 X,得到值 A;
在 T1 执行 CAS(X, A, B) 之前,
线程 T2 将 X 改为 B,然后又改回 A;
T1 执行 CAS 时发现 X 仍是 A,操作成功——
但中间状态 B 被忽略,可能导致逻辑错误。
注意在C/C++这种没有GC的语言中,CAS也可能会导致ABA问题。
也就是说GC是可以帮助解决ABA问题的。
在无GC语言中,使用某CAS 队列/链表:
T2 的 poll() 会将 Node A ("x")出队,把A放到重用池。
T3 的 offer("y") 会 new Node("y")入队 ,重用了A,且令head = A。
T1 持有 A 的引用,CAS(head, A, ...) ,head上确实是A(因为相同的地址)!CAS成功。
但实际上A不再是之前Node "x"了,而是Node "y"。如果T3再poll,会得到不是自己想要的值,发生错误!
而在GC语言中,A 和 B 是不同对象,即使偶然的内存地址相同,但是引用不同,CAS比较引用,那么ABA 不可能发生
多个共享变量的CAS
当对一个共享变量执行操作时,CAS 能够保证该变量的原子性。但是对于多个共享变量,CAS 就无法保证操作的原子性,这时通常有两种做法:
- 使用锁
- 使用
AtomicReference(类似AtomicStampedReference的做法,用Pair包装)
LockSupport
为什么推荐使用 LockSupport 来做线程的阻塞与唤醒(线程间协同工作),因为它具备如下优点:
- 以线程为操作对象更符合阻塞线程的直观语义
- 操作更精准,可以准确地唤醒某一个线程(notify 随机唤醒一个线程,
notifyAll唤醒所有等待的线程) - 无需锁对象(以线程作为操作对象),不会因竞争锁对象产生死锁问题
- unpark 与 park 没有严格的执行顺序,不会因执行顺序引起死锁问题,比如
Thread.suspend和Thread.resume没按照严格顺序执行,就会产生死锁
常见API。
//阻塞当前线程,如果调用 unpark 方法、线程被中断(Thread.interrupt)唤醒,则该线程将被唤醒。
//请注意,park 不会抛出 InterruptedException,因此线程必须单独检查其中断状态。
//调用park阻塞时,不会释放任何持有的 monitor/锁
void park()
//Object 对象用来记录导致线程阻塞的对象,方便问题排查。
void park(Object blocker)

//阻塞当前线程一定的纳秒时间,或直到被 unpark 调用,或线程被中断。
void parkNanos(long nanos)

// Object 对象用来记录导致线程阻塞的对象,方便问题排查。
void parkNanos(Object blocker, long nanos)

//阻塞当前线程直到某个指定的截止时间(以毫秒为单位),或直到被 unpark 调用,或线程被中断。
void parkUntil(long deadline)

//Object 对象,用来记录导致线程阻塞的对象,方便问题排查。
void parkUntil(Object blocker, long deadline)

//唤醒一个由 park 方法阻塞的线程thread。
//如果该线程未被阻塞,那么下一次调用 park 时将立即返回。
void unpark(Thread thread)
DEMO
//有 3 个独立的线程,一个只会输出 A,一个只会输出 B,一个只会输出 C,在三个线程启动的情况下,请用合理的方式让他们按顺序打印 ABCABC。
public class ABCPrinter {
    private static Thread t1, t2, t3;

    public static void main(String[] args) {
        t1 = new Thread(() -> {
            for (int i = 0; i < 2; i++) {
                LockSupport.park();
                System.out.print("A");
                LockSupport.unpark(t2);
            }
        });

        t2 = new Thread(() -> {
            for (int i = 0; i < 2; i++) {
                LockSupport.park();
                System.out.print("B");
                LockSupport.unpark(t3);
            }
        });

        t3 = new Thread(() -> {
            for (int i = 0; i < 2; i++) {
                LockSupport.park();
                System.out.print("C");
                LockSupport.unpark(t1);
            }
        });

        t1.start();
        t2.start();
        t3.start();

        // 主线程稍微等待一下,确保其他线程已经启动并且进入park状态。
        try {
            Thread.sleep(100);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        // 启动整个流程
        LockSupport.unpark(t1);


        //线程启动后,第一次循环park阻塞自己
        //主线程唤醒t1,打印A,唤醒t2,第二次循环开始park阻塞自己
        //t2打印B,唤醒t3,第二次循环开始park阻塞自己
        //t3打印C,唤醒t1,第二次循环开始park阻塞自己
        //t1打印A,唤醒t2,t1结束。
        //t2打印B,唤醒t3,t2结束。
        //t3打印C,唤醒t1,t3结束。
    }
}
Thread.sleep()和LockSupport.park()的区别
LockSupport.park()还有几个兄弟方法——parkNanos()、parkUtil()等,我们这里说的park()方法统称这一类方法。
- 从功能上来说,
Thread.sleep()和LockSupport.park()方法类似,都是阻塞当前线程的执行,且都不会释放当前线程占有的锁资源; Thread.sleep()没法从外部唤醒,只能自己醒过来;LockSupport.park()方法可以被另一个线程调用LockSupport.unpark()方法唤醒;Thread.sleep()方法声明上抛出了InterruptedException中断异常,所以调用者需要捕获这个异常或者再抛出;LockSupport.park()方法不会抛出中断异常;Thread.sleep()本身就是一个native方法;LockSupport.park()底层是调用的Unsafe的native方法;
Object.wait()和LockSupport.park()的区别
二者都会阻塞当前线程的运行,他们有什么区别呢?
Object.wait()方法需要在synchronized块中执行(隐含着:必须获取锁);LockSupport.park()可以在任意地方执行;Object.wait()方法声明抛出了中断异常,调用者需要捕获或者再抛出;LockSupport.park()方法不会抛出中断异常;Object.wait()不带时间参数的,需要另一个线程执行notify()来唤醒,但不一定能继续执行后续内容(不一定抢到锁);LockSupport.park()不带时间参数的,需要另一个线程执行unpark()来唤醒,一定能继续执行后续内容;
park()/unpark()底层的原理是“二元信号量”,也就是只有一个许可证permit的Semaphore,只不过这个信号量在重复执行unpark()的时候也不会再增加许可证,最多只有一个许可证。
如果在wait()之前执行了notify()会怎样?
如果当前的线程不是此对象锁的所有者,却调用该锁对象的notify()或wait()方法时会抛出IllegalMonitorStateException异常;
如果当前线程是此锁对象的所有者,调用wait()后会一直阻塞,因为后续将没有其它notify()唤醒它。
如果在park()之前执行了unpark()会怎样?
线程不会被阻塞,直接跳过park(),继续执行后续内容
LockSupport.park()会释放锁资源吗?
不会,它只负责阻塞当前线程,释放锁资源实际上是在Condition的await()方法中实现的。
AQS
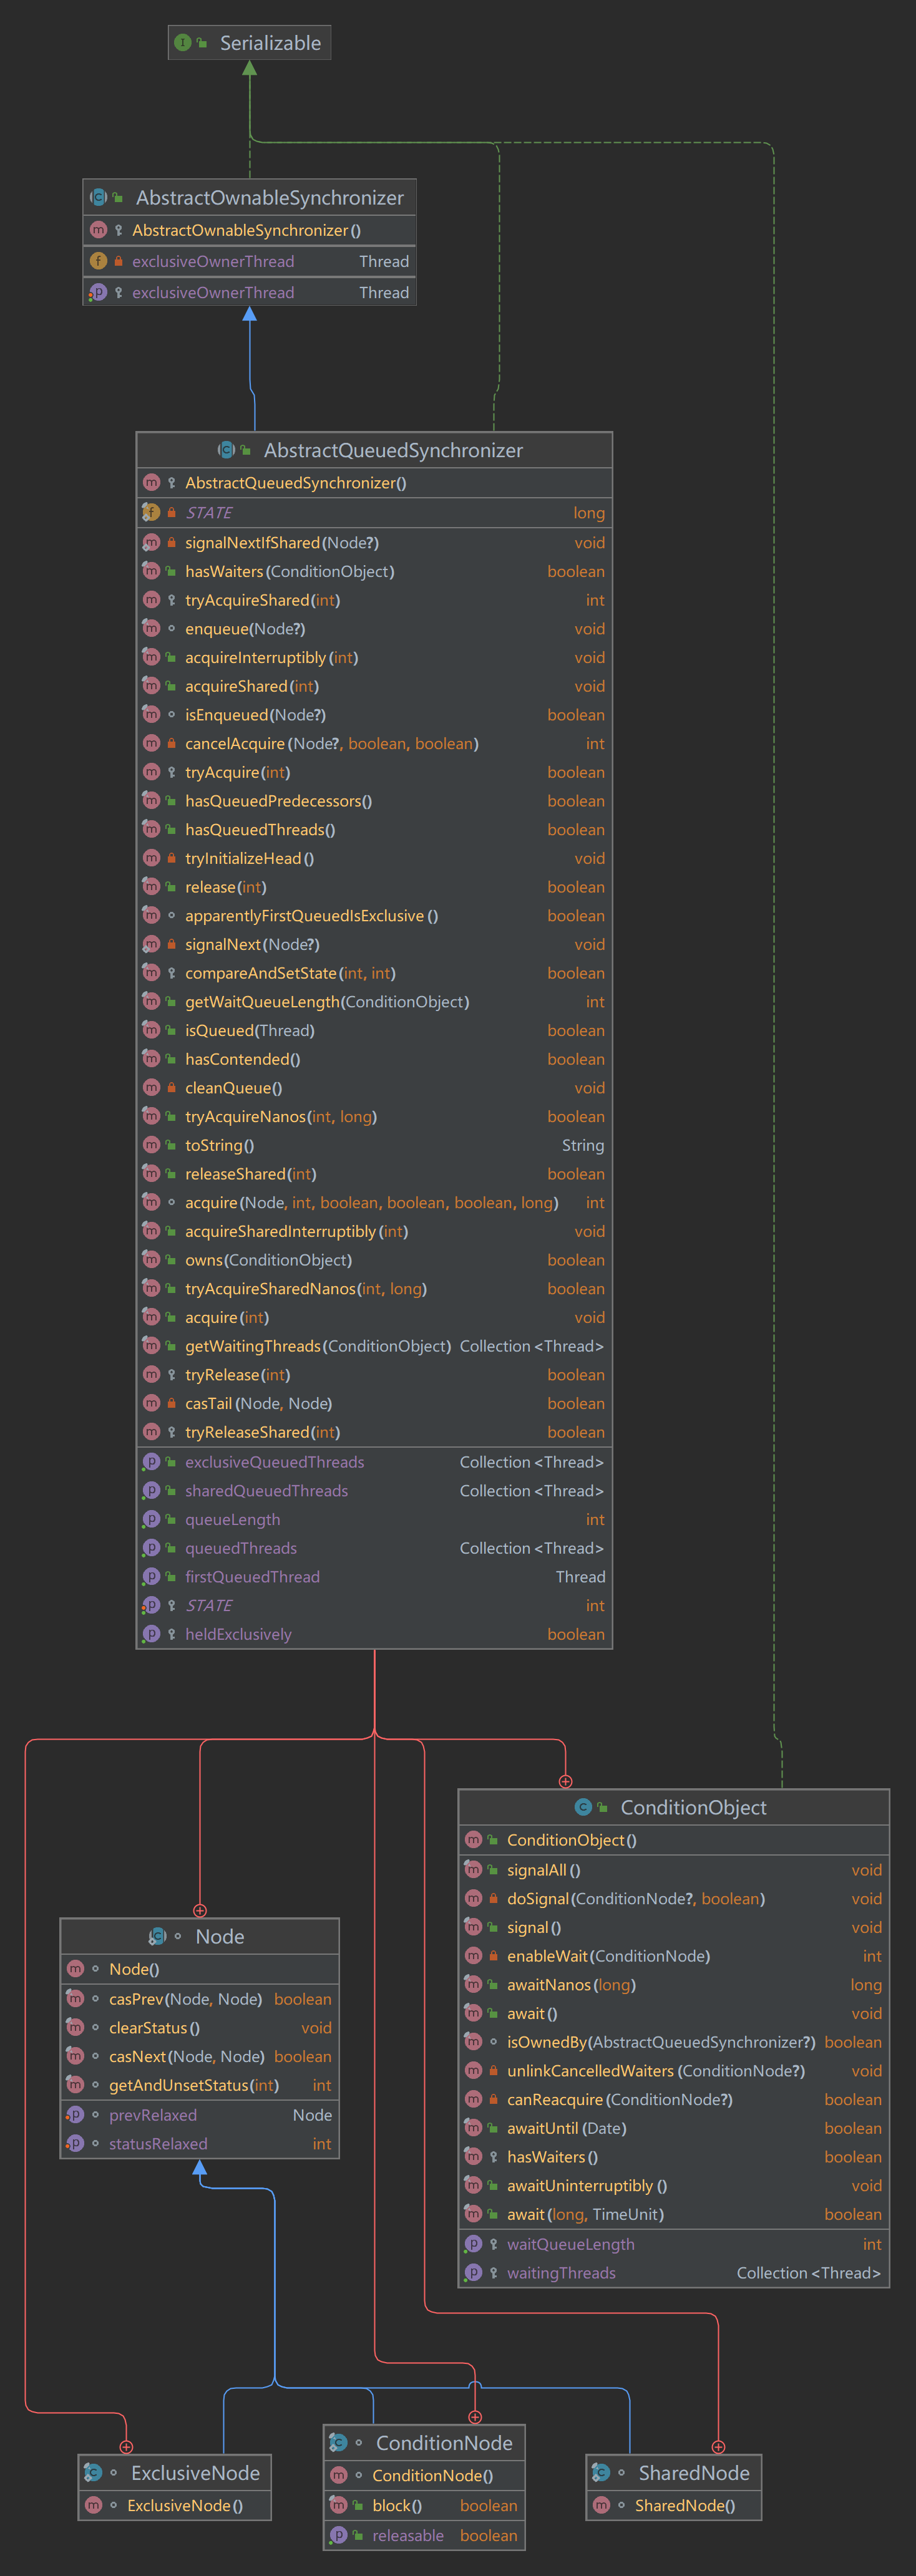
AQS是AbstractQueuedSynchronizer的简称,即抽象队列同步器。
AQS是一个用来构建锁和同步器的框架,使用AQS能简单且高效地构造出应用广泛的大量的同步器,比如ReentrantLock、Semaphore、ReentrantReadWriteLock,SynchronousQueue,FutureTask等等皆是基于AQS的。
核心
AQS核心思想是:
如果被请求的共享资源空闲,则将当前请求资源的线程设置为有效的工作线程,并且将共享资源设置为锁定状态。
如果被请求的共享资源被占用,那么就需要一套线程阻塞等待以及被唤醒时锁分配的机制。这个机制AQS是用CLH锁队列变体实现的,即将暂时获取不到锁的线程加入到队列中。
CLH锁、MCS锁
UMA(一致性内存访问,Uniform Memory Access)
- 多个处理器共享单一的物理内存与总线/互连,所有 CPU 对内存的访问性能(延迟、带宽)大致相同。
- 实现简单,适合中小规模多核/多处理器系统。瓶颈通常是共享缓存/总线的争用:CPU数量的增加,内存访问冲突将迅速增加,最终会造成CPU资源的浪费,使 CPU利用率大大降低。
NUMA(非一致性内存访问,Non-Uniform Memory Access)
- 处理器被分成若干模块,一个模块有多个CPU,每个模块都有对应的本地内存。访问本地内存比访问远端模块内存的延迟更低、带宽更好。
- “非一致性”:不同 CPU 访问不同内存区域的性能(延迟、带宽)不一致。需要考虑内存亲和性(哪核访问哪块内存)来保证性能;不恰当的访问会导致额外的跨节点流量和性能下降。
CLH
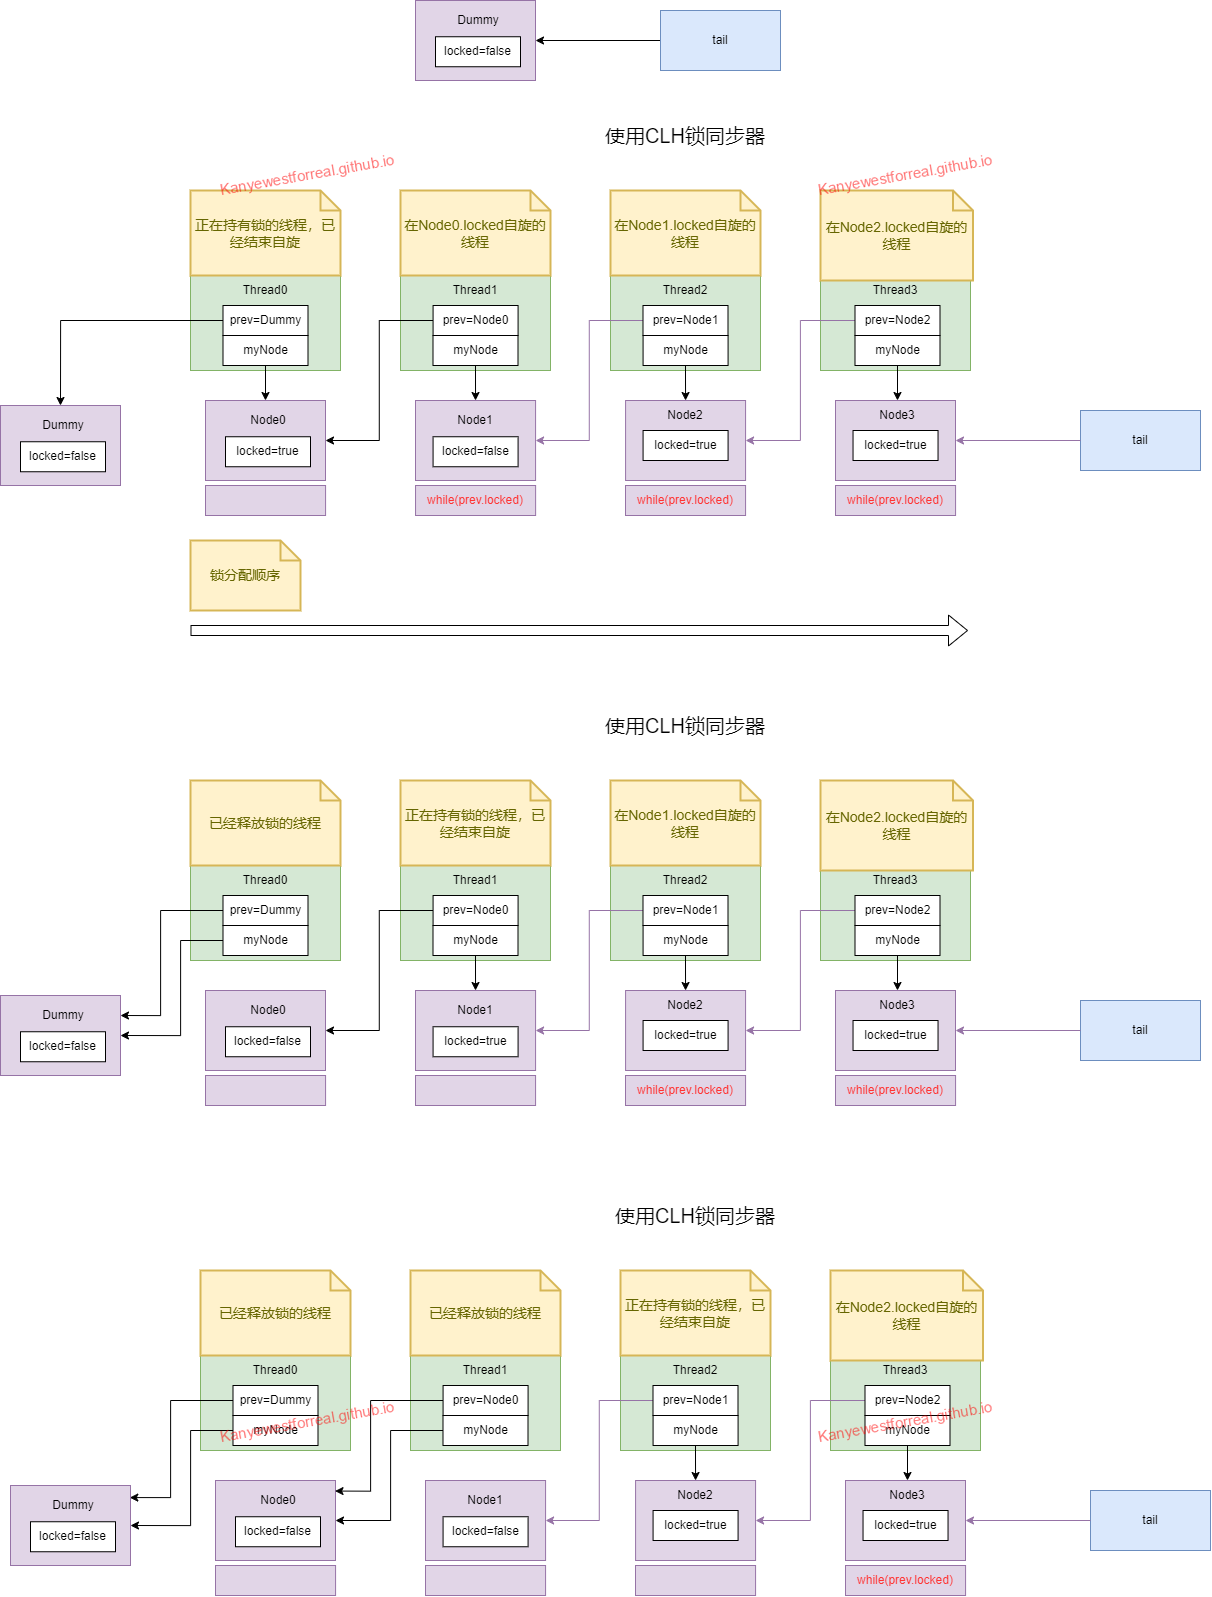
CLH关键点:
QNode只含volatile boolean locked:写很少(释放者写false),读由后继自旋读取(读取前驱的 locked)。tail是唯一的全局共享写点(getAndSet),入队不需要写前驱的next。因此称为“虚拟队列”:逻辑上 FIFO,但没有长期显式 next 引用链。- 每个线程通过
ThreadLocal保存自己的 Node(myNode),线程持有自己的节点引用(这是常见/推荐做法),Node 本身不需要持有Thread引用(因为忙等不需要阻塞/唤醒)。 unlock()中把myNode替换为它的前驱是一种节点重用策略,避免每次都分配对象。
import java.util.concurrent.atomic.AtomicReference;

public class CLHLock {
    // CLH 节点:一个简单的标志,volatile 保证可见性
    static final class QNode {
        // true表示 当前节点的线程仍在等待锁/正在占有锁,后继节点需要自旋
        // false表示 当前节点的线程不需要锁/已经释放锁,后继节点可以获取锁
        volatile boolean locked = false;
    }

    // 队尾引用,指向最后入队的 QNode(逻辑队列)
    // 一开始指向Dummy节点
    private final AtomicReference<QNode> tail = new AtomicReference<>(new QNode());

    // 每个线程维护自己的 node 和 对应的前驱引用
    private final ThreadLocal<QNode> myNode = ThreadLocal.withInitial(QNode::new);
    private final ThreadLocal<QNode> myPred = new ThreadLocal<>();

    public void lock() {
        // 从ThreadLocal取得 自己节点
        QNode node = myNode.get();
        // 表示自己在等待锁/持有锁
        node.locked = true;
        // 获得当前tail节点,并更新tail为 自己节点
        // 那么当前tail节点 相对于 自己节点 就是 前驱节点
        QNode pred = tail.getAndSet(node);
        // 保存前驱以便释放时/重用
        myPred.set(pred);
        // 自旋观察前驱的 locked 字段(remote spinning)
        while (pred.locked) {
            // 给 CPU hint(JDK 9+),短自旋更友好
            Thread.onSpinWait();
        }
        // 通过读取 pred.locked 为 false 表示自己获得锁
    }

    public void unlock() {
        QNode node = myNode.get();
        // 修改自己节点locked为false:通知后继,前驱已释放
        node.locked = false;
        // 复用——将自己的 node 指向前驱,这样下次入队可以复用对象,减少分配
        // 此时前驱 locked = false 等于刚初始化完的node

        // 为什么不复用 自己的node,而是复用前驱?
        // 如果T1 释放后 重用 Node1,T2 依赖 Node1.locked
        // T1 再次重入队列,那么 Node1.locked 从 false 变回 ture
        // 由于是多线程并行,T2可能读取 Node1.locked 不及时
        //(即使是volatile变量,也只能保证读取时是最新的,而不是类似观察者模式)
        // 那么T2继续自旋等待,破坏了公平性
        // 而T1复用前驱Node0,重入时,Node0的变化 不会影响 Node2 对 Node1的依赖
        myNode.set(myPred.get());
    }
}
CLH 不维护 successor 链,后继自旋依赖读取前驱字段。若某个中间节点被取消(线程中断或超时),要把它“从队列中移除”就比较麻烦,因为没有显式后继引用来让前驱直接通知后继跳过取消节点。实现者需要额外机制(帮助机制或扫描)来维护队列能够正确工作。
CLH锁队列结构变化:
MCS
MCS关键点:
QNode有显式的next和locked字段,并非虚拟队列。入队时前驱需要写pred.next = node,等待线程自旋在自己的 node.locked —— 缓存局部性好。tail.getAndSet(node)将 node 插到队尾并返回前驱(如果为 null,直接获得锁)。- 释放者(前驱)通过直接访问
node.next来唤醒后继successor(通过把succ.locked = false,通知后继可以获取锁)。若node.next == null,尝试 CAS 把tail置空或等待后继链接上来。 - 同样用
ThreadLocal缓存节点以避免频繁分配。
import java.util.concurrent.atomic.AtomicReference;

public class MCSLock {
    static final class QNode {
        volatile QNode next;
        // 注意这里初始化locked 为 true,true/false语义不同于CLH
        // true表示 前驱节点的线程仍在等待锁/正在占有锁,自己节点需要自旋
        // false表示 前驱节点的线程不需要锁/已经释放锁,自己节点可以获取锁
        volatile boolean locked = true;
    }

    //注意这里tail 没有初始化指向Dummy节点
    private final AtomicReference<QNode> tail = new AtomicReference<>(null);

    // 每个线程保存自己的节点以便重用
    private final ThreadLocal<QNode> myNode = ThreadLocal.withInitial(QNode::new);

    public void lock() {
        QNode node = myNode.get();
        // 重置
        node.next = null;
        // 表示等待锁
        node.locked = true;
        // 入队,返回前驱
        QNode pred = tail.getAndSet(node);
        // 前驱不为空
        if (pred != null) {
            // 把当前节点连接到前驱
            // 写 pred.next 是 remote write 只有单次
            // 而CLH 是多次的remote read/spinning
            // 在 NUMA 架构中
            pred.next = node;
            // 注意:自旋在自己的 node.locked 上
            while (node.locked) {
                Thread.onSpinWait();
            }
        }
        // 如果 pred == null,则直接获得锁(队列为空)
    }

    public void unlock() {
        QNode node = myNode.get();
        QNode succ = node.next;
        //如果没有后继节点,分两种情况:1.真没有后继;2.后继节点还没连接上来
        if (succ == null) {
            // 先需要恢复tail为null
            // CAS尝试把 tail 从 node 置为 null
            if (tail.compareAndSet(node, null)) {
                // 成功,链表空,直接返回
                // 失败,说明存在竞争,那么就是情况2
                return;
            }
            // 短自旋等待:等待其他线程节点,作为后继链接上来
            // (succ = node.next) == null
            // 先读取node.next,再赋值给succ,然后和null比较
            // 为什么不分开写为:while(node.next == null){...} succ = node.next;
            // 因为可以少一次volatile读
            while ((succ = node.next) == null) {
                Thread.onSpinWait();
            }
        }
        // 通知后继:设置后继的 locked = false,告诉后继可以获取锁了
        succ.locked = false;
        // 注意:这里 ThreadLocal的 myNode 对象可以直接复用,不需要修改/改为其他的
        // 因为lock方法中会重置 next引用 以及 locked
        // 为什么不在unlock中重置?入队加锁时,需要写前驱节点next引用
        // 我们假定一种情况,
        // T1 unlock最后重置Node1.next引用 前,此时T2 lock通过tail获得前驱Node1
        // T2 接下来把Node1.next 指向自己节点,T1 再unlock重置next引用
        // 那么Node1.next 无法指向 Node2了,队列断开。
    }
}
MCS 有 next,操作节点相对直接:可以用 next/pred 协同更新(当然也有并发竞态需要解决,但思路清晰)。这也是为什么 AQS(需要大量取消/park/unpark/condition)选择显式链表:更容易处理取消与唤醒。
MCS锁队列结构变化:
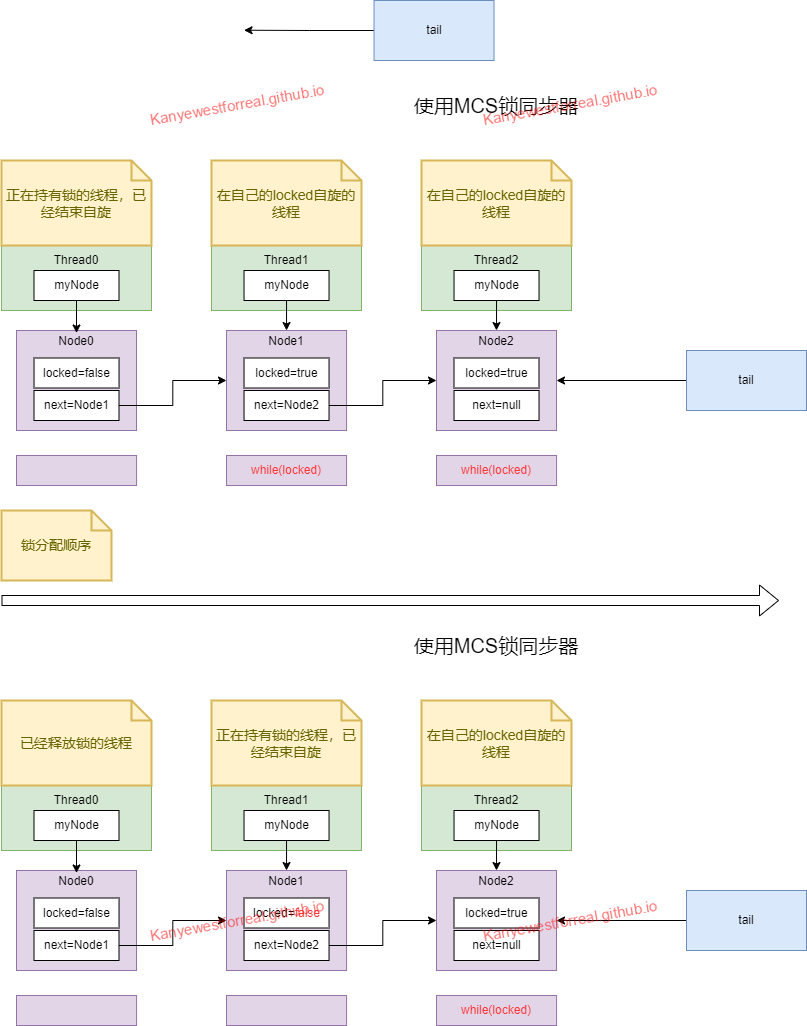
变体(AQS实现)
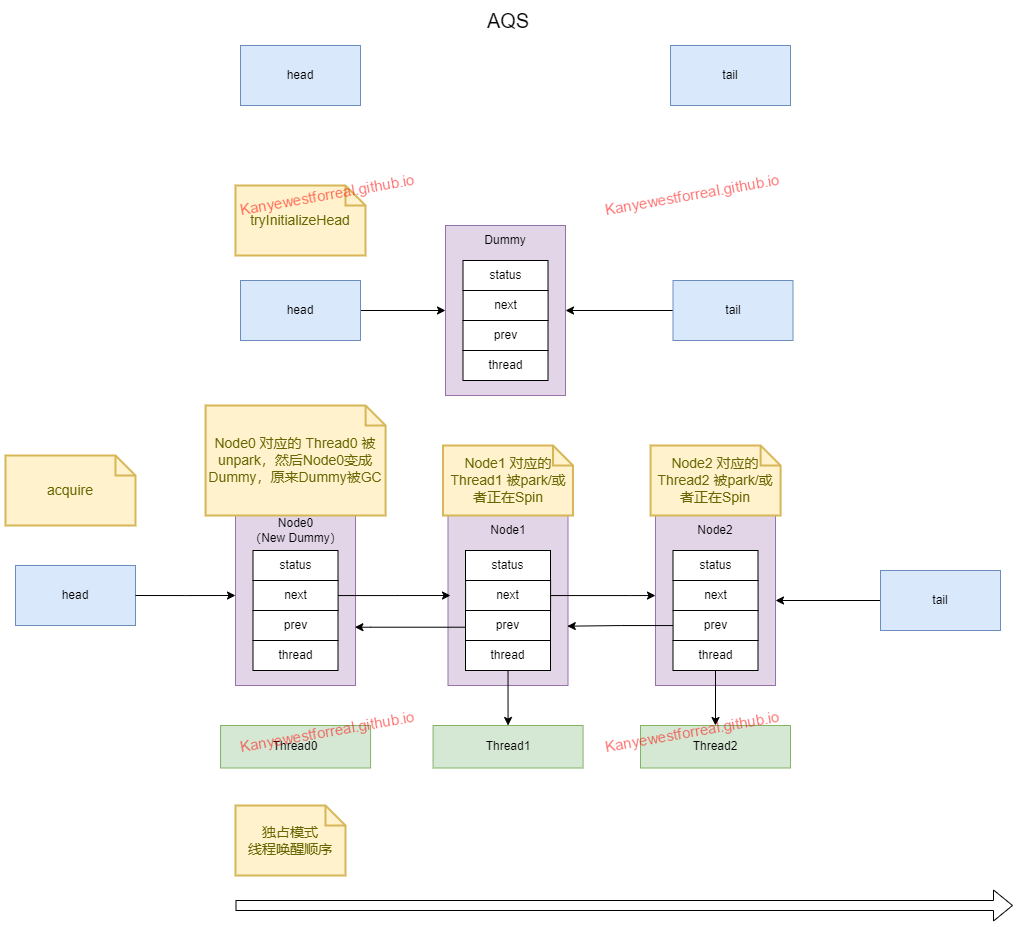
AQS 的等待并非在 CPU 上自旋,而是使用 LockSupport.park/unpark 阻塞/唤醒线程。
以下代码来自JDK-17,AQS的实现出现了很大的改变,
Node#waitStatus并没有PROPAGATE、SIGNAL这些状态了。
数据结构
public abstract class AbstractQueuedSynchronizer
    extends AbstractOwnableSynchronizer
    implements java.io.Serializable {


    //用于标识节点Node状态
    //表示该节点正在等待被唤醒(即调用了 LockSupport.park())。
    //设计为 1 是为了与 0(初始状态)区分,并便于使用 CAS 原子操作设置。
    static final int WAITING   = 1;

    //0x80000000 等于 -2147483648
    //表示节点已被取消(如因超时或中断)。
    //使用负数是为了在状态检查时快速判断:status < 0 即为已取消。
    //这在 cleanQueue() 中用于跳过无效节点。
    static final int CANCELLED = 0x80000000;

    //表示节点处于条件队列中(即调用了 Condition.await())。
    //当线程在条件上等待时,会打上此标记,以便 signal() 时能正确转移回同步队列。
    static final int COND      = 2;          // in a condition wait

	/** CLH Nodes */
    abstract static class Node {
        //入队操作通常通过 CAS 把新节点设为 tail,
        //并将新节点的 prev 指向旧尾节点
        volatile Node prev;

        //当节点处于可被唤醒(signallable)状态时,next 将起到作用
        //—— 这有助于在释放时确定要唤醒的后继节点。
        volatile Node next;

        //这是实现 park/unpark 精准唤醒的核心:直接拿到线程对象来唤醒,效率高。
        //而不像传统CLH、MCS锁会自旋;
        Thread waiter;

        //又可称为waitStatus
        //用来表示节点的状态(例如:取消、需要唤醒、在 condition 队列等)
        //写入由当前线程完成,其他线程通过原子位操作(如 getAndUnsetStatus)修改。

        volatile int status;


        // methods for atomic operations
        final boolean casPrev(Node c, Node v) {
            // for cleanQueue
            return U.weakCompareAndSetReference(this, PREV, c, v);
        }
        final boolean casNext(Node c, Node v) {
            // for cleanQueue
            return U.weakCompareAndSetReference(this, NEXT, c, v);
        }
        final int getAndUnsetStatus(int v) {
            // for signalling
            return U.getAndBitwiseAndInt(this, STATUS, ~v);
        }
        final void setPrevRelaxed(Node p) {
            // for off-queue assignment
            U.putReference(this, PREV, p);
        }
        final void setStatusRelaxed(int s) {
            // for off-queue assignment
            U.putInt(this, STATUS, s);
        }
        final void clearStatus() {
            // for reducing unneeded signals
            U.putIntOpaque(this, STATUS, 0);
        }
    }

    //队列的虚拟头节点 只是作为 引用
    private transient volatile Node head;

    //队列的虚拟尾节点 只是作为 引用
    private transient volatile Node tail;

    //state 是同步器的核心状态值
    //例如:对于 ReentrantLock,state 表示持有次数;
    //对于 Semaphore,state 表示可用许可数;
    //对于读写锁,state 的某些位表示读计数、写标志等)
    private volatile int state;

    //在处理队列时可以通过 instanceof 或类型判定
    //来区别独占/共享语义,而不必在 Node 中额外增加字段。

    //当节点是 ExclusiveNode 时,表明该节点在独占模式
    static final class ExclusiveNode extends Node { }

    //当节点是 SharedNode 时,表明该节点在共享模式
    static final class SharedNode extends Node { }

    //ConditionNode 用于条件队列(Condition)中的节点。
    //它是从主队列分离出的另一条等待链
    //(当线程 await 时,它先进入 condition 队列,而不是主同步队列)
    // await() 时进 condition 链,signal() 时把条件节点转到主队列
    static final class ConditionNode extends Node
        implements ForkJoinPool.ManagedBlocker {
        //nextWaiter 在条件队列中形成单向链(链上所有节点都是等待 condition 的线程)
        ConditionNode nextWaiter;

        //允许在 ForkJoinPools 中使用条件等待,
        //而不会冒固定池耗尽的风险。这仅适用于无时条件等待,不适用于定时版本。
        //用于判断当前条件节点是否可以结束等待(可释放)
        public final boolean isReleasable() {
            return status <= 1 || Thread.currentThread().isInterrupted();
        }

        //block() 是阻塞方法,返回true说明可以 结束等待
        public final boolean block() {
            while (!isReleasable()) LockSupport.park();
            return true;
        }
    }

}
基础关键方法
初始化队列相关的方法,使用懒加载,可用于同步队列、条件队列。
private boolean casTail(Node c, Node v) {
    //如果TAIL == c,那么更新TAIL = v
    return U.compareAndSetReference(this, TAIL, c, v);
}

private void tryInitializeHead() {
    //类型无关紧要,因为哑节点不对应任何真实线程。
    Node h = new ExclusiveNode();
    //通过 CAS 尝试将 head 从 null 初始化为该哑节点。
    //成功后,同步设置 tail = h,使队列初始状态为:head == tail == dummy
    //注意后续 h.next 不等于 dummy,而是等于dummy.next,因为head == dummy
    //dummy节点是会变的,获取资源的节点会成为新的dummy
    if (U.compareAndSetReference(this, HEAD, null, h))
        tail = h;
}

//同步队列的唤醒使用该signalNext方法;条件队列的signal方法只负责转移到同步队列,不唤醒!

//释放资源后唤醒后继线程的核心逻辑。
//执行 unlock 解锁时,就会通过 AQS 的release -> tryRelease方法,
//修改 state 变量以释放资源,
//然后通过signalNext唤醒下一个等待队列中的线程,完成共享资源的竞争和释放
private static void signalNext(Node h) {
    Node s;
    //检查头节点 h 的下一个节点 s 是否存在且状态非 0(即已设置 WAITING)
    if (h != null && (s = h.next) != null && s.status != 0) {
        //先移除WAITTING标志,再唤醒
        //配合acquire方法,确保并发时,节点s能够感知到节点h正在释放资源,而不先park
        s.getAndUnsetStatus(WAITING);
        LockSupport.unpark(s.waiter);
    }
}
//共享模式使用,仅唤醒共享节点(避免独占节点被错误唤醒)
private static void signalNextIfShared(Node h) {
    Node s;
    if (h != null && (s = h.next) != null &&
        (s instanceof SharedNode) && s.status != 0) {
        s.getAndUnsetStatus(WAITING);
        LockSupport.unpark(s.waiter);
    }
}
辅助acquire的方法
//返回值:
//CANCELLED:表示因中断而取消(且 interruptible = true)。
//0:表示超时取消,或中断但 interruptible = false
//(如 lock() 模式下被中断,需在获取后补中断)。
private int cancelAcquire(Node node, boolean interrupted,
                          boolean interruptible) {
    if (node != null) {
        node.waiter = null;
        node.status = CANCELLED;
        //若 prev == null,说明节点尚未成功入队(可能在入队 CAS 失败后就被取消),无需清理。
        //否则,节点已经入队,需要清理。
        if (node.prev != null)
            cleanQueue();
    }
    //被标记中断了
    if (interrupted) {
        //可中断的,立即响应中断,返回CANCELLED
        //上层方法(如 acquireInterruptibly)会抛出 InterruptedException
        if (interruptible)
            return CANCELLED;
        else
            //不可中断的,延迟响应不抛异常,先恢复中断状态标识,结束后由子类处理
            Thread.currentThread().interrupt();
    }
    return 0;
}

//遍历队列,移除所有 CANCELLED 状态的节点,并修复链表链接。
//lock-free base:make a snapshot of some vars
//这是无锁算法的基石——任何修改都必须基于一个稳定、一致的快照。如果快照已失效,则放弃本次操作,由外层循环重启。
private void cleanQueue() {
    for (;;) {
        //q:当前检查的节点(从 tail 开始向 head 遍历)。反向遍历原因见enqueue方法
		//s:q 的后继节点(在遍历中,s 是之前检查的节点q)。
		//p:q 的前驱节点(p = q.prev,未来要检查的节点)。
        for (Node q = tail, s = null, p, n;;) {
            //队列未初始化/只有Dummy节点
            //注意:p 被赋值了
            if (q == null || (p = q.prev) == null)
                //结束循环
                return;
            //首次循环,s == null,检查:q还是tail节点吗?
            //非首次,检查:之前检查的节点s是否等于现在的检查的节点q
            //||
            //之前检查的节点s是否取消(没取消才会成为s节点,取消的被清除掉了)
            //(注意是反向遍历,from tail to head)
            if (s == null ? tail != q : (s.prev != q || s.status < 0))
                //重新循环
                break;
            //如果当前节点取消
            //将已取消的节点 q 从队列中逻辑摘除,使 p 直接链接到 s
            if (q.status < 0) {
                //首次循环:把tail节点从q更新为p
                // 非首次:把上次检查的节点s的前驱,从当前节点q更新为未来要检查的节点p
                // (更新q后继节点的prev)
                // &&
                // 当前节点q的前驱 是否等于 未来要检查的节点p (snapshot)
                if ((s == null ? casTail(q, p)
                    : s.casPrev(q, p))
                    &&
                    q.prev == p) {
                    //这一步不是必须的。
                    //因为 AQS 的主逻辑主要依赖 prev 指针,而不是next
                    //即使更新失败,q 也已被 s.prev 的更新所“绕过”(重复),不影响正确性
                    p.casNext(q, s);
                    //如果未来检查节点p 成为了新的队首(p.prev == null)
                    //则调用 signalNext(p)。
                    if (p.prev == null)
                        signalNext(p);
                    //当一个取消操作导致某个节点成为新的队首时,必须立即尝试唤醒它,
                    //否则该节点可能永远无法被唤醒,导致死锁。
                }
                break;
            }
            //帮助完成可能没有完成的入队操作
            //一个线程在执行自己的任务时,如果发现其他线程留下的“半成品”,会主动帮忙完成,从而保证整个系统的 progress(进展性)
            //在另一个线程的入队操作中,可能已经通过 casTail 将 q 设为新尾,
            //但尚未执行 p.next = q。
            //此时,p.next 可能指向更早的尾巴节点 n。(可能发生在acquire/enqueue方法)
            //“帮助”那个线程完成入队操作,将 p.next 修正为 q
            if ((n = p.next) != q) {
                if (n != null && q.prev == p) {
                    p.casNext(n, q);
                    //如果未来检查节点p 成为了新的队首(p.prev == null)
                    //则调用 signalNext(p)。
                    if (p.prev == null)
                        signalNext(p);
                }
                break;
            }
            //开启下一次循环
            //更新之前检查的节点s = 现在检查的节点q
            //现在(准备)检查的节点q = q的前驱
            s = q;
            q = q.prev;
        }
    }
}
核心-acquire 获取资源
//node:当前线程对应的队列节点。首次调用时为 null
//arg:同步操作的参数(如重入次数、许可数量),由子类解释。
//shared:是否为共享模式(true = 共享,false = 独占)。
//interruptible:是否响应中断(中断时返回负值)。
//timed:是否带超时。
//time:超时截止时间(纳秒)。

//返回值:
//> 0:成功获取资源。
//= 0:超时失败。
//< 0:被中断。

//获取操作的通用流程:自旋 → 入队 → 阻塞 → 唤醒 → 取消
final int acquire(Node node,
                  int arg,
                  boolean shared,
                  boolean interruptible,
                  boolean timed,
                  long time) {

    Thread current = Thread.currentThread();
    byte spins = 0, postSpins = 0;
    //记录线程是否被中断(用于最终决定是否抛出 InterruptedException)
    boolean interrupted = false,
    //标记当前节点是否为队首(即是否有资格尝试获取资源)。
    boolean first = false;
    Node pred = null;

    for (;;) {
        // head是dummy节点,如果一个节点对应的线程获取了资源,那么这个节点就要成为新的dummy节点
        // 因为head == dummy,head.next 是队首节点的意思

        // !first 说明不是head.next队首/没有判断过
        // node != null 说明不是首次调用,node.prev != null 说明节点已经入队
        // (head == pred),前驱等于head,说明当前节点是head.next
        // 不是队首(fast-path)&& 不是首次调用且节点已经入队 && 再判断不是队首(slow-path)
        if (!first
            && (pred = (node == null) ? null : node.prev) != null
            //如果当前节点是 head.next 队首,则first = true
            && !(first = (head == pred))) {
            //前驱已取消,调用 cleanQueue() 清理无效节点,然后重试
            if (pred.status < 0) {
                cleanQueue();
                continue;
            } else if (pred.prev == null) {
                //pred.prev == null 说明队列结构处于不稳定状态:
                //1.正在初始化:pred 应该是头节点,但全局 head 指针还未更新到 pred
                //(之前在最外层的判断时,还不是头节点,说明发生变化)
				//2.正在释放资源:队列正处于并发中间态,有代码操作node.prev = null;
                //(见下)
                Thread.onSpinWait();
                continue;
            }
        }
        //尝试获取资源(仅限队首或首次调用)
        if (first || pred == null) {
            boolean acquired;
            try {
                //调用子类实现的 tryAcquire(独占)或 tryAcquireShared(共享)
                if (shared)
                    acquired = (tryAcquireShared(arg) >= 0);
                else
                    acquired = tryAcquire(arg);
            } catch (Throwable ex) {
                //异常,调用cancelAcquire
                cancelAcquire(node, interrupted, false);
                throw ex;
            }
            //获取成功
            if (acquired) {
                //如果是队首
                if (first) {
                    //队首节点要成为新的dummy
                    //断开旧链接:node.prev = null; pred.next = null(帮助 GC)。
                    //更新头节点:head = node。
                    node.prev = null;
                    head = node;
                    pred.next = null;
                    //清空 waiter:避免内存泄漏
                    node.waiter = null;

                    //唤醒后继:若是共享模式,调用 signalNextIfShared 唤醒所有共享节点。
					//处理中断:若被中断过,调用 current.interrupt()恢复标识
                    if (shared)
                        signalNextIfShared(node);
                    if (interrupted)
                        current.interrupt();
                }
                //返回1,标识成功
                return 1;
            }
        }
        //获取失败了,如果成功那么应该在上面return
        //如果是首次调用而且失败了,那么当前线程需要关联一个节点入队
        if (node == null) {
            //给node赋值,下次循环就不会是首次调用了
            if (shared)
                node = new SharedNode();
            else
                node = new ExclusiveNode();
        } else if (pred == null) {
            //不是首次调用了,pred = null,当前节点还没入队
            //也就是说入队前会自旋一次(上面的node赋完值后,会重走一次循环)
            //尝试入队
            node.waiter = current;
            Node t = tail;
            node.setPrevRelaxed(t);
            if (t == null)
                //懒加载
                tryInitializeHead();
            //CAS 更新尾节点失败(说明有其他线程并发入队),
            //回退(back out),将 prev 置为 null,下一轮循环重试。
            else if (!casTail(t, node))
                node.setPrevRelaxed(null);
            else
                //成功入队,继续设置
                t.next = node;
        } else if (first && spins != 0) {
            //是队首,被unpark了,但是获取资源失败,进行自旋
            --spins;
            Thread.onSpinWait();
        } else if (node.status == 0) {
            //自旋结束了,仍然获取失败,准备最后一次自旋
            //节点状态为初始值 0,将其设置为 WAITING(1),表示阻塞等待
            //因为只有非0状态,signal才会unpark

            //为什么不和下一个else合并?
            //因为有可能另外一个线程准备释放资源,可以再尝试,不急着park

            //如果合并后:
            //1.先设置waiting标识
            //2.然后当前线程park
            //3.此时另外一个线程unpark
            //4.就会额外切换上下文,不如重新再尝试一次

            //选择分开:
            //1.先设置waiting标识,告诉当前线程可以被unpark
            //2.如果另外一个线程signalNext:
            //先清除当前线程的节点状态为0
            //Ⅰ.那么当前线程下次尝试可以直接获取资源;
            //Ⅱ.当前线程还是先走到了else,但是一park,由于另外一个线程先unpark,那么当前线程的park会被立刻取消。
            //Ⅲ.当前线程还是先走到了else,但是一park,另外一个线程随后unpark,那么当前线程的park会被取消。(覆盖合并的情况)
            node.status = WAITING;
        } else {
            //最后一次自旋没拿到,那么准备park
            long nanos;
            //自旋次数spins = 2^n + 1
            //随着被 park 次数n增加而增加,使得长期未拿到资源的线程有更多自旋机会
            //spins会被--,用postSpins记录自旋次数
            spins = postSpins = (byte)((postSpins << 1) | 1);
            if (!timed)
                //park,就阻塞在这一行
                LockSupport.park(this);
            else if ((nanos = time - System.nanoTime()) > 0L)
                //park定时,就阻塞在这一行
                LockSupport.parkNanos(this, nanos);
            else
                break;

            //被唤醒了,清除节点状态,开始竞争资源
            node.clearStatus();
            // 如果有中断标识,而且是可中断的,则退出循环
            // interrupted在这里被赋值,Thread#interrupted()会清理标识
            if ((interrupted |= Thread.interrupted()) && interruptible)
                break;
        }
    }
    //走到这,说明取消了 或者 被中断。
    return cancelAcquire(node, interrupted, interruptible);
}
核心-release/releaseShared 释放资源
release-独占模式释放
这是 ReentrantLock.unlock() 等操作的底层实现。
在 ReentrantLock 中,其实现的tryRelease 会递减重入计数,只有当计数减到 0 时才返回 true。
public final boolean release(int arg) {
    //调用子类实现的 tryRelease,尝试释放资源。
	//tryRelease 的返回值:
    //如果为true 表示同步状态已完全释放(即 state == 0),现在可以安全地唤醒等待线程。
    if (tryRelease(arg)) {
        //基础关键方法中已经介绍
        signalNext(head);
        //return 向上层/子类(如 unlock())报告释放是否成功。
        //失败通常意味着当前线程并非锁的持有者(IllegalMonitorStateException)。
        return true;
    }
    return false;
}
releaseShared-分享模式释放
这是 Semaphore.release()、CountDownLatch.countDown() 等操作的底层实现。
在 Semaphore 中,只要许可数增加(state++),就返回 true。
在CountDownLatch 中,只有当计数器减到 0 时才返回 true。
public final boolean releaseShared(int arg) {
    //调用子类实现的 tryReleaseShared
    if (tryReleaseShared(arg)) {
        //看起来一样,但效果完全不同!
        signalNext(head);
        return true;
    }
    return false;
}
虽然 releaseShared 只调用了 signalNext(head),但是signalNext(head)会唤起队首,使其调用acquire方法获取资源,如果获取资源成功,那么就会调用到signalNextIfShared。
if (acquired) {
    if (first) {
        // ... 更新 head
        if (shared)
            signalNextIfShared(node); // <-- 关键在这里!
    }
    return 1;
}
完整的共享唤醒链:
releaseShared成功 →signalNext(head)→ 唤醒head.next(假设head.next是共享节点 S1)。- S1 被唤醒,在
acquire中成功获取资源。 - S1 在成功后,自己是共享节点,那么会调用
signalNextIfShared,尝试唤醒它的后继 S2。 - 如果S2是共享节点,那么尝试唤醒S2。
- S2 唤醒成功后,又会按照步骤3、4,唤醒 S3…… 如此往复,直到遇到一个独占节点或获取失败的共享节点。
这就是“传播性”。
在共享模式下(如 Semaphore 有多个许可),无需释放者去遍历整个队列。唤醒第一个共享节点后,由被唤醒者自己负责唤醒下一个,形成“链式反应”。
signalNextIfShared通过 instanceof SharedNode 检查,确保独占节点不会被错误地卷入共享唤醒链中,保证了两种模式的语义隔离。
private static void signalNextIfShared(Node h) {
    Node s;
    if (h != null && (s = h.next) != null &&
        (s instanceof SharedNode) && s.status != 0) {
        s.getAndUnsetStatus(WAITING);
        LockSupport.unpark(s.waiter);
    }
}
AQS 通过统一的释放入口(release/releaseShared)和统一的唤醒原语(signalNext),配合子类的状态管理(tryRelease/tryReleaseShared)和获取时的传播逻辑,以极简的代码实现了两种截然不同的同步语义。这正是“模板方法模式”和“好莱坞原则”在并发领域的巅峰应用。
Condition 条件队列
在传统的 synchronized 关键字和 wait(), notify() 机制中,一个对象锁只关联一个内置等待集(wait set)。这导致多个不同的等待条件(例如,队列“非空”和“未满”)会混杂在同一个等待集中,当调用 notifyAll() 时,会唤醒所有等待的线程,即使其中一些线程等待的条件并未满足,这会导致“虚假唤醒”和性能问题。
这时候就需要一个类,内部有着自己的条件队列,同时这个条件队列可以转移到锁的同步队列中。那么只要这个锁能够支持这个类,就可以实现一个锁关联多个条件变量,每个条件变量只需要合理使用对应的条件队列即可。
Condition 是抽象的条件变量接口,描述 Lock 需要的等待与通知机制;
而其子类ConditionObject 实现了这种机制:让一个独占资源的线程,能够安全地、原子地“释放资源”并“进入一个与特定条件变量关联的等待队列”,直到另一个线程“修改了条件”并通过 signal() 将其唤醒,然后重新加入同步器队列中去竞争资源。
public class ConditionObject implements Condition, java.io.Serializable {
    private transient ConditionNode firstWaiter;
    private transient ConditionNode lastWaiter;
}
firstWaiter 和 lastWaiter 作为条件队列的head、tail节点,其类型为ConditionNode,有字段nextWaiter连接调用 await() 的线程对应的后继节点,这就是条件队列,是单向的,管理所有因条件不满足而主动释放锁并等待的线程。
-
同步队列:管理因获取资源失败而等待的线程(FIFO)。
-
条件队列:管理因业务条件不满足而主动释放锁并等待的线程(FIFO)。
辅助await的方法
//将当前线程安全地加入条件队列,并原子地释放与其关联的独占锁。
//返回值:成功时返回一个整数 savedState,这个值将在 await() 结束后被用于精确地重新获取锁。
private int enableWait(ConditionNode node) {
    // 检查是否持有独占锁
    // 必须是独占锁,为什么不能是共享锁?
    // 如果是共享锁,
    if (isHeldExclusively()) {
        //waiter保存当前线程引用,当该节点被 signal() 唤醒并转移到同步队列后,
        //LockSupport.unpark(node.waiter) 能准确唤醒此线程。
        node.waiter = Thread.currentThread();
        // 更新node status标记为条件等待
        //使用 relaxed 写(无内存屏障)
        //接下来会将节点加入条件队列(一个单线程操作,由持有锁的线程完成),
        //不需要立即对其他线程可见,可以省去内存屏障开销。
        //COND 标志表示它在条件队列中,WAITING 标志使它能被 signal 唤醒。
        node.setStatusRelaxed(COND | WAITING);
        //取得tail节点指向的Node
        ConditionNode last = lastWaiter;
        if (last == null)
            // 队列为空,设为头尾
            firstWaiter = node;
        else
            // 不为空
            // node加入条件队列尾部
            last.nextWaiter = node;
        //tail节点指向node
        lastWaiter = node;
        //getState() 返回 AQS 的核心同步状态
        //等下要释放(恢复为0),所以提前保存
        int savedState = getState();
        // await() 的语义要求是:必须完全释放锁
        // release() 会调用用户实现的 tryRelease
        // 传入savedState,才能完全释放锁
        //(对于可重入锁,会释放所有重入次数)。
        //release()内部会调用signalNext,确保锁释放后能正确唤醒同步队列中的下一个竞争者
        if (release(savedState))
            //true,说明完全释放成功
            //返回savedState给await方法,后续需要savedState来复原现场
            return savedState;
    }
    //执行到这说明 没有独占锁就调用 await() 或者 释放锁失败
    //说明程序逻辑有错误,必须抛出 IllegalMonitorStateException。
    node.status = CANCELLED;
    throw new IllegalMonitorStateException();
}

//将节点安全加入同步队列尾部。
//主要用于 Condition.await() 后被 signal() 唤醒的场景
//(此时节点需从条件队列转移到同步队列)。
//普通 acquire 的入队逻辑是内联在 acquire() 方法中的,而非调用此方法
final void enqueue(Node node) {
    if (node != null) {
        for (;;) {
            Node t = tail;
            node.setPrevRelaxed(t);
            if (t == null)
                tryInitializeHead();
            //把尾节点tail更新为node如果成功
            else if (casTail(t, node)) {
                //此时t代表旧的尾节点
                //link old tail to new tail
                t.next = node;
                if (t.status < 0)
                    //若前驱节点 t 已被取消(status < 0),
                    //则立即 unpark 当前节点线程
                    //促使其在下次循环中调用 cleanQueue() 清理无效链接。
                    LockSupport.unpark(node.waiter);
                break;
            }
        }
    }
}

//判断一个节点是否已成功加入同步队列。
//主要用于 Condition.await() 的恢复阶段(canReacquire() 方法),
//确认被 signal() 唤醒的节点是否已转移到同步队列。
final boolean isEnqueued(Node node) {
    //反向遍历队列
    //正向遍历(从 head 开始)可能因 next 指针尚未设置而失败
    //(入队是“先设 prev,再 CAS tail,最后设 next”)。
	//prev 指针在 CAS 前已设置(setPrevRelaxed),因此反向遍历更可靠。
    for (Node t = tail; t != null; t = t.prev)
        if (t == node)
            return true;
    return false;
}

//检查节点是否已从条件队列成功转移到同步队列。
private boolean canReacquire(ConditionNode node) {
    //node.prev != null:表示节点已被设置为同步队列中的某个节点的后继。只有在同步队列中的才会被设置prev
    //isEnqueued(node):从 tail 反向遍历同步队列,确认节点确实在其中。
    return node != null && node.prev != null && isEnqueued(node);
    //为什么不用检查 status?
    //因为在 enqueue 过程中,status 可能尚未设置,但 prev 指针是可靠的。
}
核心-await 释放锁等待条件满足
public final void await() throws InterruptedException {
    if (Thread.interrupted())
        throw new InterruptedException();
    //创建一个 ConditionNode,它是Node的子类,包含nextWaiter字段,用于构建条件队列。
    //这个节点将同时属于两个队列:
    //条件队列(通过 nextWaiter)和
    //未来加入的同步队列(通过 prev/next)。
    ConditionNode node = new ConditionNode();
    // 保存释放锁前的AQS状态,以期望后续获取锁时,能够复原现场
    // 也就是恢复到调用await前的状态
    // 否则可能产生死锁之类的。
    int savedState = enableWait(node);
    //调试信息
    LockSupport.setCurrentBlocker(this);
    boolean interrupted = false, cancelled = false, rejected = false;
    //等待循环 —— 等待被 signal
    //canReacquire检查该节点是否已被 signal() 成功转移到同步队列
    while (!canReacquire(node)) {
        if (interrupted |= Thread.interrupted()) {
            //如果线程被中断,且节点仍在条件队列中(COND 标志存在),则取消等待(break)。
            if (cancelled = (node.getAndUnsetStatus(COND) & COND) != 0)
                break;
        } else if ((node.status & COND) != 0) {
            //节点仍在条件队列中
            //调用 ForkJoinPool.managedBlock(node),
            //这会最终调用 LockSupport.park(),这是对 ForkJoinPool 的支持
            //防止在公共线程池中因大量 await() 而耗尽线程。
            //其中有对其他类型线程的处理
            try {
                if (rejected)
                    //managedBlock补偿失败,直接park,直到节点不在条件队列 或者 被中断
                    node.block();
                else
                    //先尝试补偿处理,不是ForkJoinPool线程会被另外处理
                    //内部也是调用block方法,直接park,直到节点不在条件队列 或者 被中断
                    ForkJoinPool.managedBlock(node);
            } catch (RejectedExecutionException ex) {
                //补偿失败 报错
                rejected = true;
            } catch (InterruptedException ie) {
                interrupted = true;
            }
        } else{
            //走到这说明是 node.status & COND == 0
            //(status之前被设置为,COND(0010)| WAITING(0001)= 0011)
            // signal会getAndUnsetStatus(COND),status 变为 0001 再进行|运算 = 0
            //说明 signal 正在转移此节点。
            //此时自旋等待转移完成,避免不必要的 park/unpark。
            Thread.onSpinWait();
        }
    }
    //调试信息
    LockSupport.setCurrentBlocker(null);
    //走到这,说明park结束了,即被signal唤醒,或者 被中断了
    //先恢复status,在这一般是清除WAITING标识,使得节点可以重新被park,因为要尝试获取锁
    node.clearStatus();
    //acquire传入了之前保存的 savedState 和已有的 node。
	//会识别这是一个“重新获取”场景(node != null),并跳过节点创建和初次入队的步骤。
	//它会使用 savedState 作为参数调用 tryAcquire(savedState),
    //确保恢复到线程调用 await() 之前的锁状态

    //这里有三个false,不共享、不可中断、不超时
    //要求acquire必须取得锁,来保证await的语义:await返回时一定是取得锁的
    acquire(node, savedState, false, false, false, 0L);
	//取得锁之后再处理中断
    //由于有多种await方法,处理中断方式不同
    if (interrupted) {
        if (cancelled) {
            //如果是 还在条件队列且没有被signal唤醒的竞争锁而被中断的
            //那么从条件队列移除这个node(需要持有锁,才能安全移除?)
            unlinkCancelledWaiters(node);
            //因为等待操作根本没有完成,这是一个失败的操作,必须通过异常告知调用者。
            throw new InterruptedException();
        }
        //await已经成功(被 signal 唤醒,而中断也是一种唤醒方法)
        //交给调用者处理中断标识
        Thread.currentThread().interrupt();
    }
}
核心-signal 转移队列
signal() 只负责转移队列,不直接 unpark 线程。线程的唤醒由同步队列的 acquire/release 逻辑处理!
public final void signal() {
    ConditionNode first = firstWaiter;
    //signal() 也必须在持有锁时调用。
    if (!isHeldExclusively())
        throw new IllegalMonitorStateException();
    if (first != null)
        doSignal(first, false);
}
public final void signalAll() {
    ConditionNode first = firstWaiter;
    if (!isHeldExclusively())
        throw new IllegalMonitorStateException();
    if (first != null)
        doSignal(first, true);
}
private void doSignal(ConditionNode first, boolean all) {
    while (first != null) {
        //当前节点的后继节点
        ConditionNode next = first.nextWaiter;
        //firstWaiter = next,使得head节点指向后继,准备断开与当前节点的连接
        if ((firstWaiter = next) == null)
            //如果后继节点为空,说明条件队列当前只有一个节点
            //那么tail节点不能指向这个节点了,以此断开链接
            lastWaiter = null;
        //清除 COND 标志,也是 await() 中检查节点是否被signal的关键。
        if ((first.getAndUnsetStatus(COND) & COND) != 0) {
            //把first节点,准备从条件队列,转到同步队列
            //调用这个方法后,node加入同步队列,其 prev 被设置,isEnqueued将返回 true。
			//在下一次循环中,await() 中的 canReacquire 检查就会通过,
            //线程将退出检查,进入重新获取锁的阶段。
            enqueue(first);
            //是否把条件变量对应的队列上所有节点全部转移?
            if (!all)
                break;
        }
        first = next;
    }
}
ReentrantLock
ReentrantLock 是 Java 并发包 (java.util.concurrent.locks) 中一个非常重要的显式锁实现。它的核心设计哲学就是委托。
ReentrantLock 自身并不直接处理复杂的线程排队、阻塞和唤醒逻辑,而是将这些繁重且容易出错的任务完全委托给一个其内部的同步器对象——sync。
这个 sync 字段的类型是 Sync,而 Sync 正是 AbstractQueuedSynchronizer (AQS) 的一个抽象子类。
public class ReentrantLock implements Lock, java.io.Serializable {
    private final Sync sync;
}
AQS 用于构建锁和同步器的框架。它定义了同步状态的管理(通过一个 int 类型的 state)、线程的排队(通过一个 CLH 变体的 FIFO 队列)以及线程的阻塞和唤醒机制。
ReentrantLock 的巧妙之处在于,它只需要告诉 AQS “怎么样算是获取了锁” 和 “怎么样算是释放了锁”,剩下的所有复杂调度工作都由 AQS 自动完成。
ReentrantLock 对 AQS 中 state 字段的具体语义:state 的值代表当前锁被同一线程重入的次数(即持有计数)。
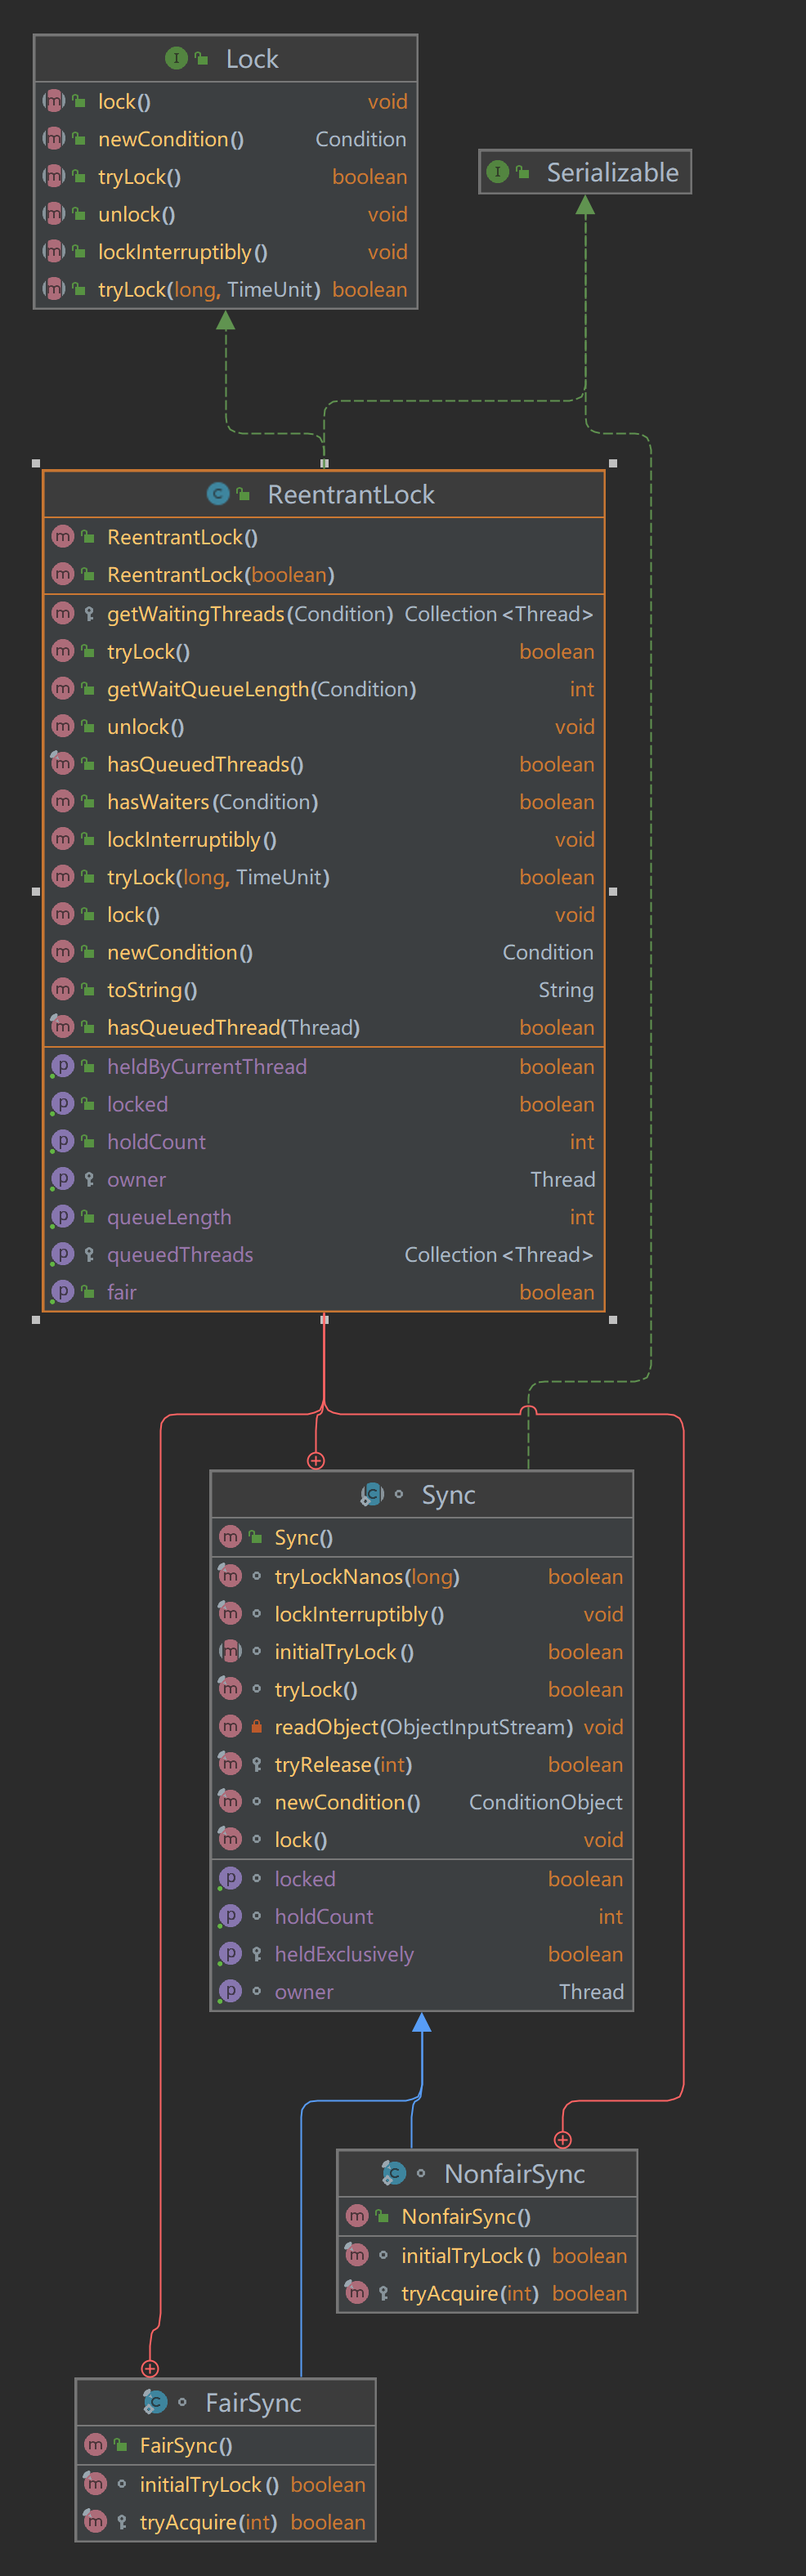
Sync 抽象父类
abstract static class Sync extends AbstractQueuedSynchronizer
static 用于 嵌套类(即声明在另一个类里的类),把嵌套类声明为 static 的主要动机是:让它不再隐式持有外部类的实例引用(只能访问外部的static变量,无法访问非static变量),从而更清晰、内存更省、可独立使用(不需要外部类的实例化,就可以实例化)。
非公平的快速尝试获取锁 tryLock
无论是否是公平Sync,还是非公平Sync,都会非公平尝试,这是Sync父类方法。
//提供了最快的获取路径,避免了进入AQS复杂的排队逻辑,对性能非常友好。
//但可能导致等待线程“饥饿”。
final boolean tryLock() {
    Thread current = Thread.currentThread();
    // 1. 读取当前同步状态
    int c = getState();
    if (c == 0) {
        // 2. 如果状态为0(锁空闲),尝试CAS原子地将状态设为1
        if (compareAndSetState(0, 1)) {
            // 3. 设置当前线程为独占锁的持有者
            setExclusiveOwnerThread(current);
            //获取到锁,返回true
            return true;
        }
    } else if (getExclusiveOwnerThread() == current) {
        // 4. 如果当前线程已经是锁的持有者(重入)
        // 5. 检查重入次数是否溢出
        if (++c < 0)
            throw new Error("Maximum lock count exceeded");
        // 6. 原子地(此处无需CAS,因为是同一线程在操作)增加持有计数
        setState(c);
        // 获取到锁,返回true
        return true;
    }
    // 7. 锁被其他线程持有,获取失败
    return false;
}
抽象方法 initialTryLock
abstract boolean initialTryLock();
这是一个抽象方法,定义了公平、非公平策略下,初次尝试获取锁都会调用该方法。
lock() 等公共方法只需要调用 initialTryLock(),而无需关心是哪种策略。
核心加锁流程 lock
除了tryLock以外的,唯一加锁入口。
final void lock() {
    // 1. 首先执行策略相关的初次尝试 fast-path
    if (!initialTryLock()){
        // 2. 如果初次尝试失败,调用AQS的acquire模板方法
        acquire(1);
    }
}

//AQS#acquire
public final void acquire(int arg) {
    //先调用子类的tryAcquire,失败再调用AQS的核心aqcuire
    if (!tryAcquire(arg))
        acquire(null, arg, false, false, false, 0L);
}
释放锁 tryRelease
protected final boolean tryRelease(int releases) {
    // 1. 计算释放后的状态
    int c = getState() - releases;
    // 2. 安全检查:只有锁的持有者才能释放锁
    if (getExclusiveOwnerThread() != Thread.currentThread())
        throw new IllegalMonitorStateException();
    // 3. 判断是否完全释放(持有计数归零)
    boolean free = (c == 0);
    if (free){
        // 4. 清空持有者
        setExclusiveOwnerThread(null);
    }
    // 5. 更新状态
    setState(c);
    // 6. 返回是否完全释放,AQS会据此决定是否唤醒后继节点
    return free;
}
ReentrantLock常用方法
lock
public void lock() {
    sync.lock();
}
获取锁:
- 如果锁未被其他线程持有,则立即获取并返回;
- 如果当前线程已持有该锁,则持有计数加一并立即返回;
- 如果锁被其他线程持有,则当前线程将被阻塞,直到获取到锁。
提供了最基础、最常用的阻塞式加锁操作,内部的快速路径优化保证了在无竞争场景下的高性能。
lockInterruptibly
public void lockInterruptibly() throws InterruptedException {
	sync.lockInterruptibly();
}
获取锁,但可以响应线程中断。其获取逻辑与 lock() 相同,但如果在等待获取锁的过程中,当前线程被其他线程调用了 interrupt(),则会立即抛出 InterruptedException 并退出,不会继续等待。
- 首先检查线程是否已被中断,如果是,直接抛异常。
- 执行
initialTryLock()快速路径。 - 如果失败,调用
acquireInterruptibly(1)。这个 AQS 方法与acquire的关键区别在于,它在阻塞等待 (park) 的循环中会不断检查线程的中断状态。一旦检测到中断,就会清理节点并抛出异常。
为程序提供了响应中断的能力,避免了线程因等待锁而陷入永久阻塞,这对于需要优雅关闭或处理超时的场景非常重要。
tryLock
public boolean tryLock() {
    return sync.tryLock();
}
//在指定的时间内尝试获取锁,超过时间自动结束,并且可以响应中断
//如果在等待期间被中断,则抛出 `InterruptedException`。
public boolean tryLock(long timeout, TimeUnit unit)
	throws InterruptedException {
	return sync.tryLockNanos(unit.toNanos(timeout));
}
非阻塞地尝试获取锁。无论ReentrantLock是公平还是非公平模式,总是立即返回,不会进入等待队列。
- 如果锁可用(未被持有或由当前线程持有),则获取锁并返回
true。 - 如果锁被其他线程持有,则立刻返回
false,不会阻塞。
避免死锁:在需要按固定顺序获取多个锁时,可以使用 tryLock 配合超时,避免两个线程互相等待对方的锁而造成死锁。
高性能轮询:适用于可以快速重试或执行其他任务的场景。
即使在一个公平锁上,tryLock() 也会“插队”,这是其设计文档明确说明的。
unlock
public void unlock() {
	sync.release(1);
}
释放锁。如果当前线程是锁的持有者,则持有计数减1。如果持有计数减为0,则完全释放锁,并可能唤醒等待队列中的下一个线程。
流程:
- 调用 AQS 的
release(1)模板方法。 release(1)会调用tryRelease(1)。tryRelease会检查调用者是否为持有者,然后减少state。- 如果
tryRelease返回true(即state已归零),release方法会调用唤醒队列中的头节点的后继节点。
必须由锁的持有者来调用,否则会抛出 IllegalMonitorStateException。这保证了同步状态的正确性。
newCondition
public Condition newCondition() {
	return sync.newCondition();
}
为此锁实例创建一个 Condition 对象。
直接返回 AQS 内部实现的 ConditionObject 实例。将 Condition 的实现也委托给 AQS,ReentrantLock 无需关心 Condition 的等待队列(这是一个与同步队列分离的、单向的条件队列)和信号 (signal) 机制的具体实现,再次体现了委托和复用的设计哲学。
查询方法
getHoldCount(): 返回当前线程对此锁的持有计数。isHeldByCurrentThread(): 判断当前线程是否持有此锁。isLocked(): 判断此锁是否被任意线程持有(不关心是哪个线程)。
NonfairSync
非公平锁是 ReentrantLock 的默认实现,其核心思想是允许新来的线程“插队”,即使等待队列中已经有其他线程在排队。这牺牲了线程获取锁的顺序公平性,但换取了更高的吞吐量。
非公平策略 initialTryLock
final boolean initialTryLock() {
    Thread current = Thread.currentThread();
    // 关键点:当发现锁空闲(state==0)时,直接先尝试CAS,完全不关心等待队列!
    //检查队列 (hasQueuedThreads()) 本身是一个开销相对较大的操作。
    if (compareAndSetState(0, 1)) {
        setExclusiveOwnerThread(current);
        return true;
    } else if (getExclusiveOwnerThread() == current) {
        //可重入处理
        int c = getState() + 1;
        if (c < 0) // overflow
            throw new Error("Maximum lock count exceeded");
        setState(c);
        return true;
    } else{
        //快速尝试失败,返回false,走slow-path
        return false;
    }
}
acquire 模板方法在非公平模式下的实现——tryAcquire
调用Sync#lock/ReentrantLock#lock方法,会走到AQS#acquire模板方法,然后走一遍子类的tryAcquire,当作fast-path尝试,如果失败,才会走AQS的核心acquire方法。
实际上核心acquire方法获取资源,也是通过调用子类的tryAcquire方法,只不过添加了自旋尝试的逻辑。
//当线程在 AQS 的等待队列中被唤醒后,它会再次调用 tryAcquire 来尝试获取锁。
protected final boolean tryAcquire(int acquires) {
    //尝试获取一个空闲锁
    if (getState() == 0 && compareAndSetState(0, acquires)) {
        setExclusiveOwnerThread(Thread.currentThread());
        //获取成功
        return true;
    }
    //获取失败
    return false;
}
FairSync
公平锁的设计目标是严格按照线程请求锁的顺序来分配锁,即“先来后到”,避免线程饥饿。为此,它付出的代价是性能上的轻微损失。
公平策略 initialTryLock
final boolean initialTryLock() {
    Thread current = Thread.currentThread();
    int c = getState();
    if (c == 0) {
        // 发现锁空闲
        // 关键点:在CAS之前,先检查等待队列是否为空!
        // 为空就尝试CAS;
        // 不为空,返回false,表示快路径fail
        if (!hasQueuedThreads() && compareAndSetState(0, 1)) {
            setExclusiveOwnerThread(current);
            return true;
        }
    } else if (getExclusiveOwnerThread() == current) {
        //处理可重入
        if (++c < 0) // overflow
            throw new Error("Maximum lock count exceeded");
        setState(c);
        return true;
    }
    return false;
}
acquire 模板方法在公平模式下的实现——tryAcquire
protected final boolean tryAcquire(int acquires) {
    //!hasQueuedPredecessors():这个方法比 !hasQueuedThreads() 更精确。
    //它检查的是当前线程对应的节点是否有前驱。
    //按照公平的语义:只有节点是队首,才有资格在锁被释放后尝试获取锁。
    //如果不是队首,那么返回false,表示获取失败
    if (getState() == 0 && !hasQueuedPredecessors() &&
        compareAndSetState(0, acquires)) {
        setExclusiveOwnerThread(Thread.currentThread());
        return true;
    }
    return false;
}
补充
ReentrantLock 确实是可以实现 原子性、有序性、可见性的。其释放锁、获取锁的语义和synchronized的相同。
All Lock implementations must enforce the same memory synchronization semantics as provided by the built-in monitor lock, as described in section 17.4 of The Java™ Language Specification:
A successful lock operation has the same memory synchronization effects as a successful Lock action.
A successful unlock operation has the same memory synchronization effects as a successful Unlock action.
关键点在于,其Sync继承了AQS,并且在lock、unlock时,均需要对volatile int state变量操作。
有序性
happens-before + volatile int state 的内存屏障
可见性
volatile int state 的内存屏障
原子性
语义实现保证。
ReentrantReadWriteLock
ReentrantLock 是一个标准的互斥锁,任何时候都只允许一个线程访问受保护的资源。
而 ReentrantReadWriteLock 将锁分成了读锁和写锁,它允许多个读线程同时访问,在读多写少的情况下,提高了并发性。
Java 8 引入了 StampedLock,它提供了一种更高效的读写锁。它使用“戳记”(stamp)来管理锁状态,并提供了乐观读的模式。在非常高的读竞争下,StampedLock 的性能通常优于 ReentrantReadWriteLock。
StampedLock没有使用AQS,而是自己实现了同步队列管理,但是实现思路相似,都是使用了CLH锁变体。
StampedLock不支持"重入"特性, 这是设计上的取舍。通过放弃重入性等复杂功能,StampedLock可以实现更轻量级、更高性能的锁机制,而AQS框架为了支持重入等特性会带来额外的开销。
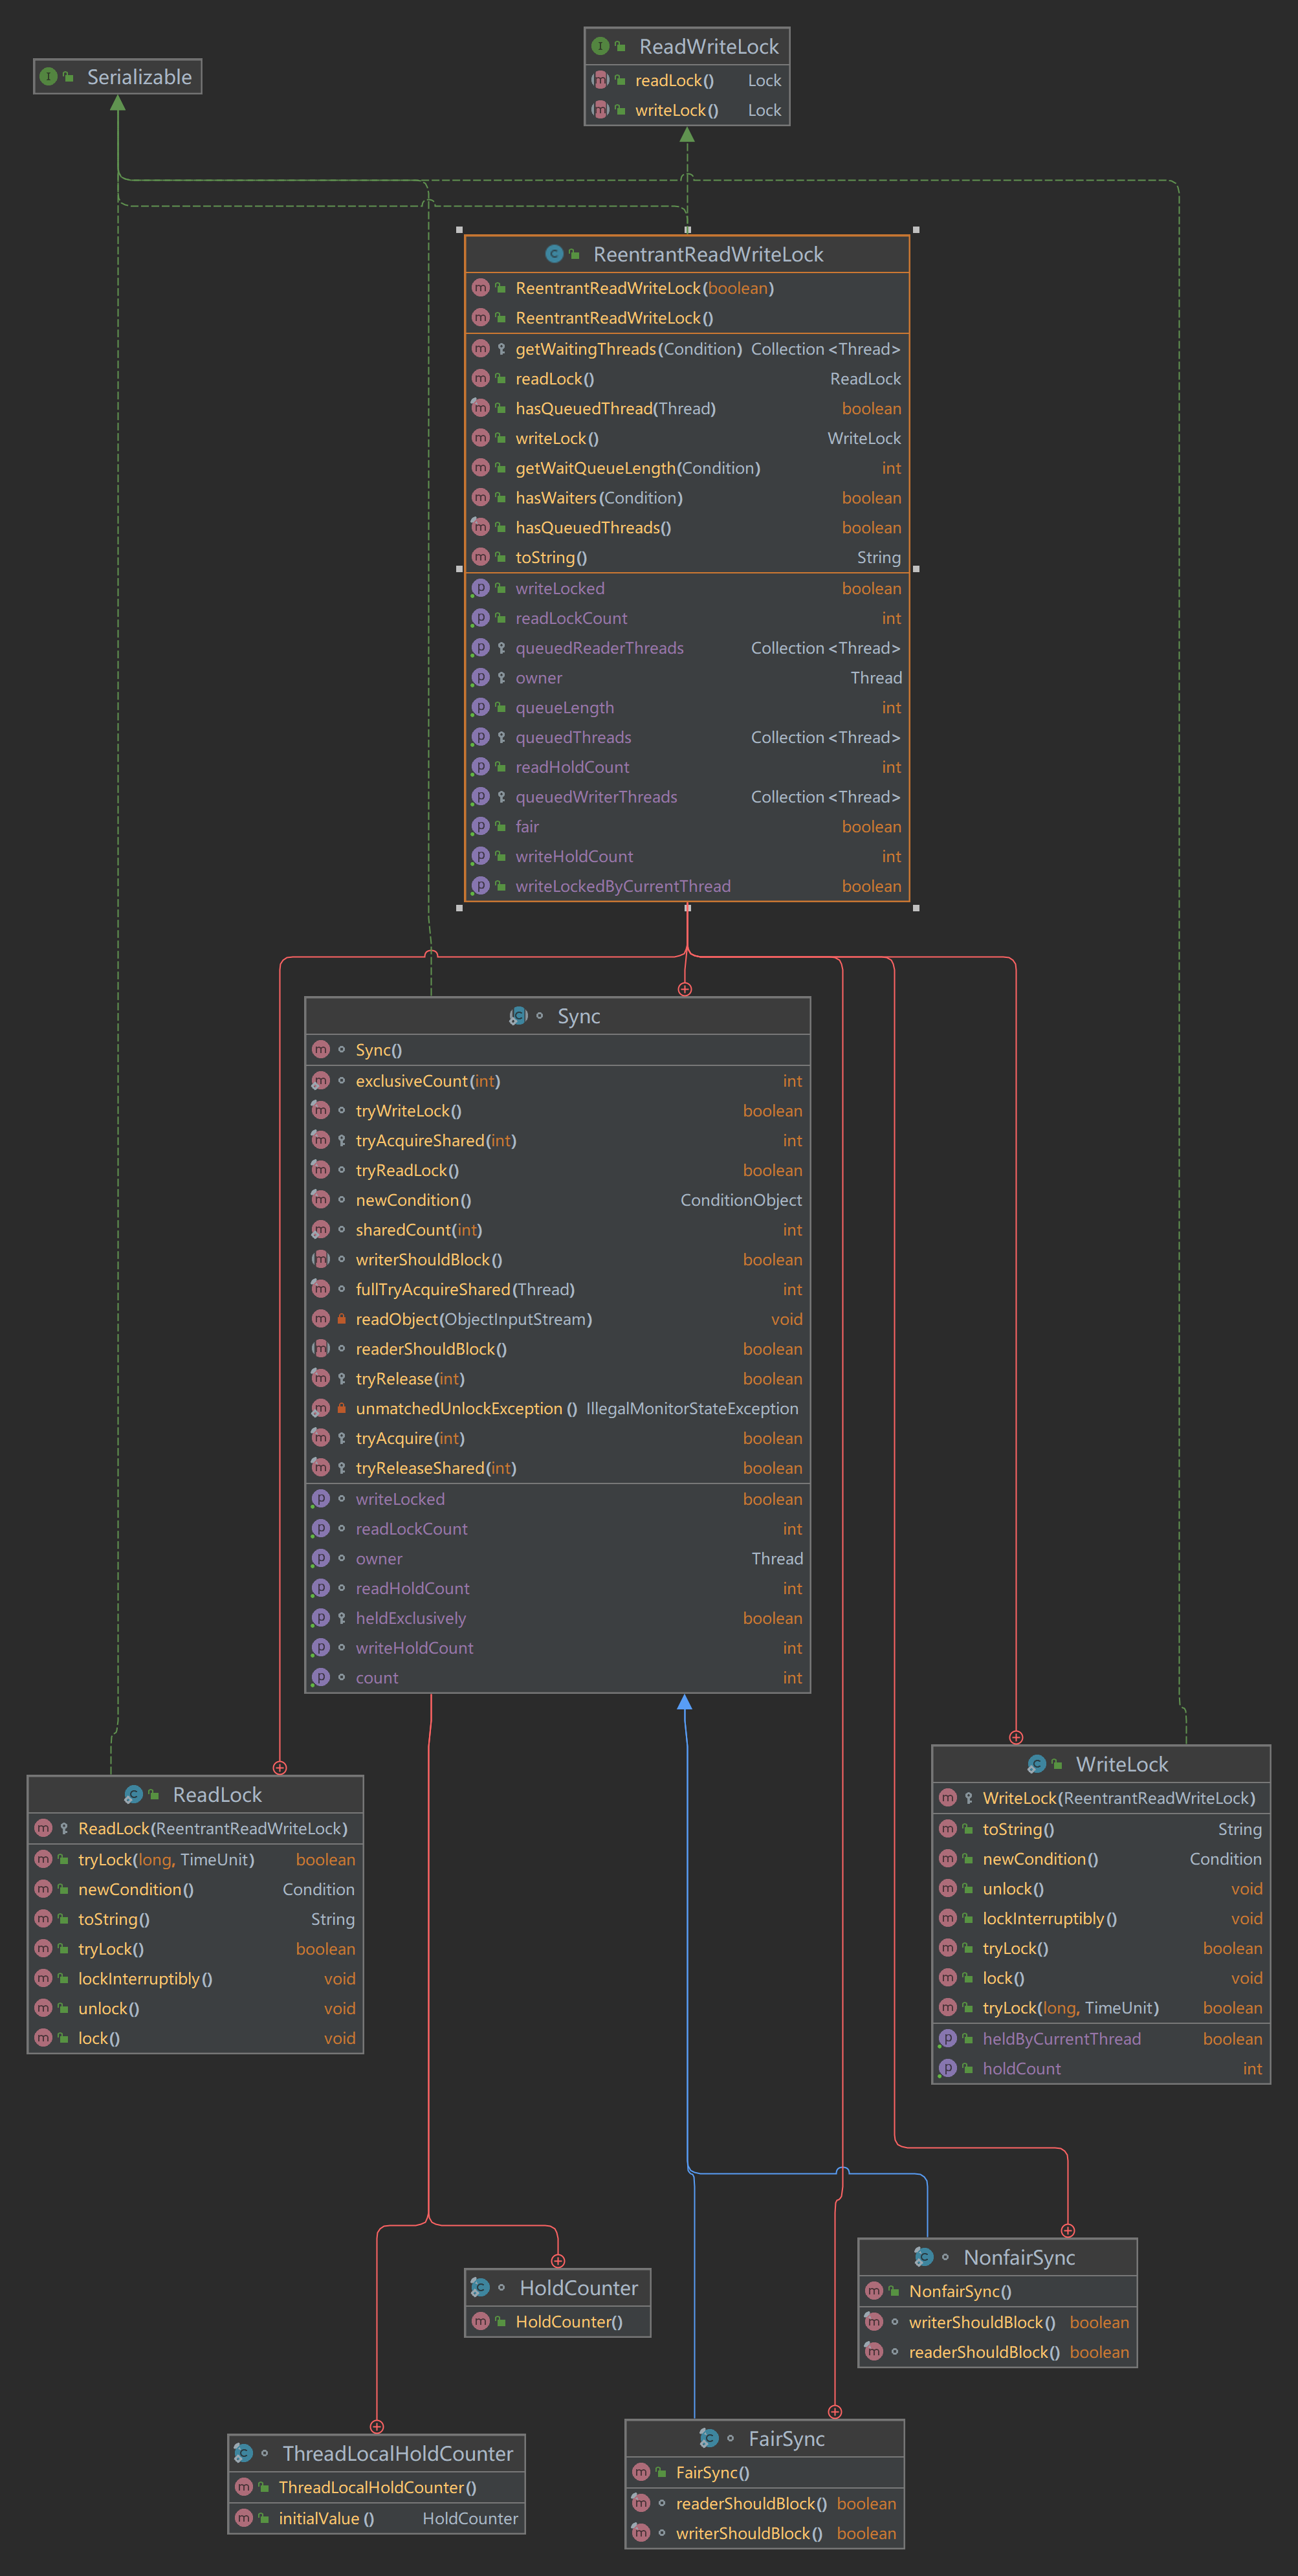
ReentrantReadWriteLock数据结构
//实现了 ReadWriteLock 接口,该接口定义了 readLock() 和 writeLock() 两个方法。
public class ReentrantReadWriteLock
        implements ReadWriteLock, java.io.Serializable {


	//这两个对象是对外暴露的锁操作入口。
    private final ReentrantReadWriteLock.ReadLock readerLock;
    private final ReentrantReadWriteLock.WriteLock writerLock;

    //同步逻辑的实际实现者(继承自 AQS)
    final Sync sync;

    //ReentrantReadWriteLock 可以选择公平策略、非公平策略
    //非公平策略:获取写锁可插队;在队列头要获取写锁时,获取读锁阻塞(防写饥饿)。
    //公平策略:无论读写,只要队列中有前驱,就阻塞(严格 FIFO)。
    public ReentrantReadWriteLock(boolean fair) {
        sync = fair ? new FairSync() : new NonfairSync();
        readerLock = new ReadLock(this);
        writerLock = new WriteLock(this);
	}
}
Sync 抽象类
Sync数据结构
abstract static class Sync extends AbstractQueuedSynchronizer{
    //右移16位可得读锁计数。
    static final int SHARED_SHIFT   = 16;
    //每次加一个读锁,状态加 65536。 高16位
    static final int SHARED_UNIT    = (1 << SHARED_SHIFT);
    //读/写锁最大重入次数 65535
    static final int MAX_COUNT      = (1 << SHARED_SHIFT) - 1;
    //用于掩码提取低16位(写锁计数)。
    static final int EXCLUSIVE_MASK = (1 << SHARED_SHIFT) - 1;

    //获取高16位(读锁数量)
    static int sharedCount(int c){ return c >>> SHARED_SHIFT; }
    //获取低16位(写锁重入次数)
	static int exclusiveCount(int c) { return c & EXCLUSIVE_MASK; }

    Sync() {
        readHolds = new ThreadLocalHoldCounter();
        //setState(getState()) 是一个 内存屏障,
        //确保 readHolds 对其他线程可见(利用 state 是 volatile语义)。
        setState(getState()); // ensures visibility of readHolds
    }
}
Sync 继承自 AbstractQueuedSynchronizer,并利用 AQS 的 state 字段同时表示 读锁数量 和 写锁数量。
在ReentrantReadWriteLock的设计中,AQS的volatile int state ,高16位和低16位分别有不同含义:
- 高16位(shared):表示 读锁的持有数量(所有线程的总和)
- 低16位(exclusive):表示 写锁的重入次数(因为写锁是独占的,只能有一个线程持有)
读锁重入计数——ThreadLocal
因为读锁是共享的,多个线程可以同时持有,但每个线程可以多次获取读锁(重入)。所以需要为每个线程单独记录它获取读锁的次数。
实现
abstract static class Sync extends AbstractQueuedSynchronizer{
	    static final class HoldCounter {
            //记录 当前线程 持有读锁的次数
            int count;
			//用 tid 而不是 Thread 引用?防止 Thread 对象无法被 GC
            final long tid = LockSupport.getThreadId(Thread.currentThread());
        }

		//ThreadLocal 容器,每个线程拥有自己的 HoldCounter。
    	//同一个线程可多次获取读锁,每个线程重入不同,那么需要记录,记录在自己线程map上
        static final class ThreadLocalHoldCounter
            extends ThreadLocal<HoldCounter> {
            public HoldCounter initialValue() {
                return new HoldCounter();
            }
        }

    	//存储当前线程的读锁持有数。
    	//transient 表示不参与序列化(因为线程状态无法跨 JVM 恢复)。
        private transient ThreadLocalHoldCounter readHolds;

    	// 缓存 最后一个成功获取读锁的线程 的 HoldCounter。
    	// 避免频繁 ThreadLocal.get()(有哈希查找开销)。
		// 在释放锁/获取锁时优先检查此缓存,提升性能。
        private transient HoldCounter cachedHoldCounter;

    	//优化:如果只有一个线程在读,直接用这两个字段记录。
		//避免创建 ThreadLocal 和 HoldCounter,极大提升单读线程场景性能。
		//仅当 第一个将读锁从0变为1的线程 才是 firstReader。
        private transient Thread firstReader;
    	//firstReader 获取读锁次数
        private transient int firstReaderHoldCount;

}
持有关系
Thread -> ThreadLocalMap
ThreadLocalMap -> Entry
ThreadLocal<HoldCounter> means Entry<ThreadLocal as Key, HoldCounter as Value>
HoldCounter -> {
    count
    tid
}
抽象方法(由 Fair/Nonfair 子类实现)
abstract boolean readerShouldBlock();
abstract boolean writerShouldBlock();
判断当前线程是否应阻塞(即是否允许“插队”)。
FairSync:只要队列中有等待者,就阻塞(hasQueuedPredecessors())。
NonfairSync:写线程永不阻塞(writerShouldBlock() 返回 false)。读线程仅在队列头是写线程时阻塞(防写饥饿)。
写锁的获取 tryAcquire
此方法由 WriteLock.lock() 调用,最终通过 AQS 的 acquire(1) 进入。
//返回 true 表示成功获取写锁。
//false 获取失败

//表示对栈空间敏感
@ReservedStackAccess
protected final boolean tryAcquire(int acquires) {

    Thread current = Thread.currentThread();
    int c = getState();
    //提取低16位,即当前写锁的重入次数。
	//如果 w > 0,说明已有线程持有写锁。
    int w = exclusiveCount(c);
    //c不等于0,说明持有锁
    if (c != 0) {
 		//如果 w == 0 且 c != 0,说明有线程持有读锁(sharedCount(c) > 0)。
        //写锁要求“任何线程没有读锁,也没有写锁”(独占),
        //否则其他线程读,某一线程写,两者并发,读先一步完成,会读到过期数据
        //由于是独占,所以写锁可以持有读锁,“锁降级”
        if (w == 0 || current != getExclusiveOwnerThread()){
            //不允许读锁获取写锁,防止“锁升级”:
            //如果线程 A 持有读锁并尝试升级为写锁,而此时线程 B 也持有读锁,
            //A 会等 B 释放读锁;
            //但如果 B 也同时想升级为写锁,就会互相等待——死锁。
            return false;
        }
        //检查写锁重入次数是否超过 MAX_COUNT
        if (w + exclusiveCount(acquires) > MAX_COUNT)
            throw new Error("Maximum lock count exceeded");
        //持有写锁,再次获取,算重入
        //此时不需要设置 exclusiveOwnerThread,因为它早已被设置。
        setState(c + acquires);
        return true;
    }
    //第一次获取写锁
    //模板方法writerShouldBlock()由子类实现
    //FairSync:若队列中有等待者(hasQueuedPredecessors()),则阻塞(返回 true)。
	//NonfairSync:永远返回 false,允许“插队”(barging)。
    if (writerShouldBlock() ||
        //CAS失败,返回false
        !compareAndSetState(c, c + acquires))
        return false;
    //后续可重入判断、isHeldExclusively 都依赖此字段。
    setExclusiveOwnerThread(current);
    return true;
}
写锁的释放 tryRelease
此方法由 WriteLock.unlock() 调用,通过 AQS 的 release(1) 触发。
@ReservedStackAccess
protected final boolean tryRelease(int releases) {
    //检查当前线程是否为写锁持有者。
    if (!isHeldExclusively())
        throw new IllegalMonitorStateException();
    //nextc:释放后的状态值。
	//free:判断写锁是否完全释放(重入次数归零)。
    int nextc = getState() - releases;
    boolean free = exclusiveCount(nextc) == 0;
    if (free){
        //如果写锁完全释放(free == true),清除独占线程引用。
        setExclusiveOwnerThread(null);
    }
    setState(nextc);
    //返回 free:如果为true,AQS可以唤醒后续等待写锁线程
    return free;
}
fast-path 读锁的获取 tryAcquireShared
读锁是共享锁(shared),允许多个线程同时持有,但前提是没有写锁被其他线程持有。
该方法由 ReadLock.lock() 调用,最终通过 AQS 的 acquireShared(1) 进入。
//≥ 0:获取成功,且允许后续共享线程继续获取(即无需唤醒,可“传播”)。
//< 0:获取失败,需入队等待。
@ReservedStackAccess
protected final int tryAcquireShared(int unused) {
    Thread current = Thread.currentThread();
    int c = getState();
    //exclusiveCount(c) != 0:表示有写锁存在。(注意:这里说明锁降级不是走这个方法)
	//getExclusiveOwnerThread() != current:且不是当前线程持有。
    if (exclusiveCount(c) != 0 &&
        getExclusiveOwnerThread() != current)
        //返回false表示失败,需要入队
        return -1;

    //快速路径(Fast Path)尝试获取

    int r = sharedCount(c);
    //三个条件必须同时满足:
	//!readerShouldBlock():根据公平策略,当前线程无需阻塞(可“插队”)。
	//r < MAX_COUNT:当前读锁数量未达上限。
	//CAS成功:增加一个读锁。
    if (!readerShouldBlock() &&
        r < MAX_COUNT &&
        compareAndSetState(c, c + SHARED_UNIT)) {
        //CAS成功了,说明取到读锁
        //是全局第一个取得读锁的,先避免创建ThreadLocal,优化单读线程场景。
        //注意“全局第一个获取读锁的线程”的概念是:其他线程现在都没有取得读锁,意味着可能有其他线程释放完过读锁
        if (r == 0) {
            firstReader = current;
            firstReaderHoldCount = 1;
        } else if (firstReader == current) {
            //是全局第一个取得读锁的,重入
            firstReaderHoldCount++;
        } else {
            //不是全局第一个取得读锁的线程

            HoldCounter rh = cachedHoldCounter;
            //先检查缓存 cachedHoldCounter:
            //1.缓存为null:
            // 说明有第二个线程要获取读锁,
            // 需要创建ThreadLocal,然后使用get方法创建、返回新的HoldCounter
            // 新的HoldCounter缓存到cachedHoldCounter

            //2.缓存不为null,但缓存不是当前线程的HoldCounter:
            // get方法获取对应线程的ThreadLocal,返回ThreadLocal as Key,
            // 对应的 HoldCounter as Value
            // 并缓存HoldCounter到cachedHoldCounter
            if (rh == null ||
                rh.tid != LockSupport.getThreadId(current))
            {
                cachedHoldCounter = rh = readHolds.get();
            }
            //缓存不为null,且缓存是当前线程的HoldCounter

            //如果rh.count == 0,
            //说明 那么之前 HoldCounter 对应的 ThreadLocal 被remove了
            //(count为0时,Sync会remove ThreadLocal及对应的Entry,
            // 但是HoldCounter由于还被cachedHoldCounter引用,不会回收)
            // 避免下次 get()时,调用initalValue创建新的HoldCounter,直接set复用
            else if (rh.count == 0)
                readHolds.set(rh);
            //如果缓存的 HoldCounter 属于当前线程,且ThreadLocal没有被GC,则直接使用
            //记录当前线程持有读锁次数
            rh.count++;
        }
        //返回 1(>0),表示成功获取,可继续传播(其他读线程也可获取)。
        return 1;
    }
    //快速路径失败,交由 fullTryAcquireShared 处理。
    return fullTryAcquireShared(current);
}
slow-path 读锁获取 fullTryAcquireShared
通过自旋尝试,直到成功获取或确定失败。
final int fullTryAcquireShared(Thread current) {
    HoldCounter rh = null;
    for (;;) {
        int c = getState();

        if (exclusiveCount(c) != 0) {
            if (getExclusiveOwnerThread() != current)
                //其他线程有写锁了,返回-1表示失败,只能入队
                return -1;
        } else if (readerShouldBlock()) {
            // 没有线程持有写锁
            // 获取读锁,readerShouldBlock()返回true需要入队等待

            // 核心思想:
            // 但实际上一个已经持有读锁的线程,即使在公平策略下也应该被允许再次获取读锁
            // 否则会造成死锁。
            // A、B持有读锁,A重入,如果要等B释放,此时B重入,要等A重入获取->死锁

            if (firstReader == current) {
                //如果是全局第一个获取读锁的线程重入,那么什么都不做
            } else {
                //不是全局第一个获取读锁的线程,来获取读锁(不一定是重入)

                //第一次判断 == null,是为了确定要不要读缓存
                //在方法开始时,rh 被初始化为 null;
                //由于这个方法包含一个无限循环,
                //在循环的第一次迭代中,rh 为 null,需要初始化
                //但在后续的循环迭代中,如果之前已经获取了 rh,就不需要重新获取
                if (rh == null) {
                    //尝试获取缓存
                    rh = cachedHoldCounter;

                    //判断缓存是否有效
                    if (rh == null ||
                        rh.tid != LockSupport.getThreadId(current)) {
                        //如果缓存为空 ||
                   		//缓存不是当前线程的HoldCounter
                        //那么需要获取当前线程的HoldCounter
                        rh = readHolds.get();

                        if (rh.count == 0)
                            //count为0,说明线程是 首次 或者 释放完全后 来获取读锁
                            //remove进行内存清理,清理ThreadLocal
                            //如果是首次获取读锁的,其ThreadLocal也会被清理
                            //但是HoldCounter被临时保存到rh
                            readHolds.remove();
                    }
                }
                //读过缓存了,rh不为null,走到这
                //count为0,说明线程是 首次 或者 释放完全后 来获取读锁
                //说明不是重入,返回-1,必须阻塞,入队等待
                if (rh.count == 0)
                    return -1;
            }
        }
        //不需要入队等待

        if (sharedCount(c) == MAX_COUNT)
            throw new Error("Maximum lock count exceeded");
        if (compareAndSetState(c, c + SHARED_UNIT)) {
            //CAS成功
            if (sharedCount(c) == 0) {
                //全局第一个获取读锁的线程
                firstReader = current;
                firstReaderHoldCount = 1;
            } else if (firstReader == current) {
                firstReaderHoldCount++;
            } else {

                if (rh == null)
                    rh = cachedHoldCounter;

                if (rh == null ||
                    rh.tid != LockSupport.getThreadId(current))
                    rh = readHolds.get();
                else if (rh.count == 0)
                    readHolds.set(rh);
                rh.count++;
                //这里缓存rh,是为了realse时使用。
                cachedHoldCounter = rh;
            }
            //获取读锁成功,不用入队等待
            return 1;
        }
    }
}
读锁的释放 tryReleaseShared
此方法由 ReadLock.unlock() 调用,通过 AQS 的 releaseShared(1) 触发。
//返回值含义:
//true:表示读锁、写锁完全释放(读锁、写锁计数归零),可以唤醒等待的写线程/其他读线程。
//false:仍有线程持有锁(读锁 或者 写锁),无需唤醒写线程。
@ReservedStackAccess
protected final boolean tryReleaseShared(int unused) {
    Thread current = Thread.currentThread();
    if (firstReader == current) {
        //如果当前线程是 firstReader(第一个获取读锁的线程),直接操作优化字段。
        if (firstReaderHoldCount == 1)
            //这是最后一次释放,清空 firstReader 引用。
            firstReader = null;
        else
            firstReaderHoldCount--;
    } else {
        //非firstReader
        //读取缓存
        HoldCounter rh = cachedHoldCounter;
        if (rh == null ||
            rh.tid != LockSupport.getThreadId(current))
            //缓存失效,用ThreadLocal获取当前线程的HoldCounter
            rh = readHolds.get();
        int count = rh.count;
        //count <= 1:准备完全释放该线程的读锁
        if (count <= 1) {
            //主动清理 ThreadLocal,防止内存泄漏。
            readHolds.remove();
            if (count <= 0)
                throw unmatchedUnlockException();
        }
        --rh.count;
    }
    //无限循环:直到对AQS state 的 CAS 操作成功
    for (;;) {
        int c = getState();
        int nextc = c - SHARED_UNIT;
        //CAS 释放一个读锁
        if (compareAndSetState(c, nextc))
            //注意这里c 是 getState,包含读锁、写锁的计数
            //nextc == 0 检查读锁、写锁,是否都已释放
			//此时返回 true,AQS 会唤醒队列中的线程(可能是写线程或读线程)。
            return nextc == 0;
    }
}
非公平策略 NonfairSync
static final class NonfairSync extends Sync {
    //返回false表示不应该阻塞(入队等待)
    //返回true表示允许插队,可以立刻尝试获取锁
    final boolean writerShouldBlock() {
        // 写线程永远可以插队,不用入队等待
        return false;
    }
    final boolean readerShouldBlock() {
        //检查队列头是否为等待的写线程。
        return apparentlyFirstQueuedIsExclusive();
        //避免写线程无限期饥饿。
		//如果队列头是写线程,即使非公平,读线程也应阻塞,让写线程先执行。
    }
}

//AQS#apparentlyFirstQueuedIsExclusive
final boolean apparentlyFirstQueuedIsExclusive() {
    Node h, s;
    //四个条件都要满足,才返回true:
    //head节点不为空(队列至少有一个节点,可以是Dummy) && 队首不为空
    //&&
    //队首不是SharedNode(队首是写锁)&& 队首对应线程不为空
    return (h = head) != null && (s = h.next)  != null &&
        !(s instanceof SharedNode) && s.waiter != null;
}
公平策略 FairSync
static final class FairSync extends Sync {
    final boolean writerShouldBlock() {
        //无论读写,只要队列中有等待者/前驱(hasQueuedPredecessors()),新线程必须阻塞。
        return hasQueuedPredecessors();
    }
    final boolean readerShouldBlock() {
        return hasQueuedPredecessors();
    }
}

//目的是在无锁(lock-free)的前提下,高效、安全地读取队列状态。
//由于 AQS 的队列操作是并发的(多个线程可能同时入队或出队),
//直接读取 head.next 可能会因为内存可见性或指令重排序而得到一个“陈旧”或“不一致”的视图。
//因此,它们采用了双重检查和从尾部遍历回退的策略来保证结果的可靠性。

//AQS#hasQueuedPredecessors
public final boolean hasQueuedPredecessors() {
    Thread first = null; Node h, s;
    //首先确认队列头不为空(队列至少有一个节点,可以是Dummy) &&
	//如果队首(非Dummy)为空 ||
	//如果队首的线程引用为空(这可能发生在节点刚创建但还未设置 waiter 字段时) ||
	// 队首的 prev 指针为空 ||
    //(表示该节点的链接过程尚未完成,在acquire中node.setPrevRelaxed(t))

    //这组检查是一个快速路径(fast path)
    //如果 h.next 是一个完全初始化且有效链接的节点,那么可以直接使用它,无需retry
    if ((h = head) != null && ((s = h.next) == null ||
                               (first = s.waiter) == null ||
                               s.prev == null))
        //不是完全初始化且有效链接的节点,需要retry(slow-path)
        first = getFirstQueuedThread();
    //队列有(非Dummy)节点,返回true,说明需要排队(公平策略)
    return first != null && first != Thread.currentThread();
}
//AQS#getFirstQueuedThread
public final Thread getFirstQueuedThread() {
    Thread first = null, w; Node h, s;

    //再次尝试快速路径
    if ((h = head) != null && ((s = h.next) == null ||
                               (first = s.waiter) == null ||
                               s.prev == null)) {
        //快速路径依然失败,线性遍历

        //从队列尾部(tail)向前遍历,因为从尾部遍历在并发CAS下更安全、更可靠。
        //(因为入队是“先设 prev,再 CAS tail,最后设 next”)。
        //正向遍历(从 head 开始)可能因 next 指针尚未设置而失败
        //和判断入队的思路一致(isEnqueued)

        //这个循环的目的是找到任意一个在队列中的线程,以证明队列非空。
        //在 AQS 的队列结构保证下,从尾部向前遍历时,
        //最后一个赋值给 first 的线程恰好就是 head.next 所代表的线程
        for (Node p = tail, q; p != null && (q = p.prev) != null; p = q)
            if ((w = p.waiter) != null)
                first = w;
    }
    //返回first引用的节点
    //只要不为null,那么公平策略应该生效,需要阻塞/入队等待
    return first;
}
WriteLock特殊方法
提供无条件的 barging(插队),忽略公平策略。
与 tryAcquire 的关键区别
- 完全移除了
writerShouldBlock()检查。 - 无论公平与否,只要锁可用(无竞争或可重入),就尝试获取。
//WriteLock#tryLock
public boolean tryLock() {
	return sync.tryWriteLock();
}

////Sync#tryWriteLock
final boolean tryWriteLock() {
    Thread current = Thread.currentThread();
    int c = getState();
    if (c != 0) {
        int w = exclusiveCount(c);
        if (w == 0 || current != getExclusiveOwnerThread())
            return false;
        if (w == MAX_COUNT)
            throw new Error("Maximum lock count exceeded");
    }
    if (!compareAndSetState(c, c + 1))
        return false;
    setExclusiveOwnerThread(current);
    return true;
}
ReadLock特殊方法-tryReadLock
提供无条件的 barging(插队),忽略公平策略。
与 tryAcquireShared 的关键区别
- 完全移除了 readerShouldBlock()` 检查。
- 无论公平与否,只要锁可用(无竞争或可重入),就尝试获取。
//ReadLock#tryLock
public boolean tryLock() {
    return sync.tryReadLock();
}

//Sync#tryReadLock
@ReservedStackAccess
final boolean tryReadLock() {
    Thread current = Thread.currentThread();
    for (;;) {
        int c = getState();
        if (exclusiveCount(c) != 0 &&
            getExclusiveOwnerThread() != current)
            return false;
        int r = sharedCount(c);
        if (r == MAX_COUNT)
            throw new Error("Maximum lock count exceeded");
        if (compareAndSetState(c, c + SHARED_UNIT)) {
            if (r == 0) {
                firstReader = current;
                firstReaderHoldCount = 1;
            } else if (firstReader == current) {
                firstReaderHoldCount++;
            } else {
                HoldCounter rh = cachedHoldCounter;
                if (rh == null ||
                    rh.tid != LockSupport.getThreadId(current))
                    cachedHoldCounter = rh = readHolds.get();
                else if (rh.count == 0)
                    readHolds.set(rh);
                rh.count++;
            }
            return true;
        }
    }
}
参考
https://javaguide.cn/java/concurrent/java-concurrent-questions-01.html
https://pdai.tech/md/java/thread/java-thread-x-juc-AtomicInteger.html