
Java多线程笔记(2)
并发编程概念
操作系统基础:线程、进程
Java并发编程基础
线程池
ThreadLocal
并发和并行的区别
- 并发:指系统具有处理多个任务的能力。这些任务在宏观上看起来是同时执行的,但在微观上,CPU可能在多个任务之间快速交替执行。
- 并行:指系统具有同时执行多个任务的能力。这要求必须有多个计算单元(如多核CPU),使得多个任务可以在同一时刻同时执行。
同步和异步、阻塞和非阻塞的区别
四个是不一样的概念。
在中文文档内,异步常常被等于非阻塞。
- 同步 vs 异步:结果怎么拿?关注的是消息通信机制或任务执行流程。
- 阻塞 vs 非阻塞:你等不等?关注的是调用者在等待结果时的状态。
| 维度 | 概念 | 核心区别 |
|---|---|---|
| 调用者状态 | 阻塞 | 等待时能不能干别的事? 阻塞:不能,线程被挂起。 |
| 非阻塞 | 非阻塞:能,线程可执行其他任务。 | |
| 消息机制 | 同步 | 谁来主动拿结果? 同步:调用者主动等待或查询。 |
| 异步 | 异步:调用者等待被调用方主动通知。 |
从定义上来说,OkHttp 是阻塞(使用BIO实现——底层用阻塞的 socket / Okio),但是对外提供了异步API。
RxJava / CompletableFuture 提供了异步、同步API,可以任务可以使用阻塞IO、非阻塞IO。两者在使用OkHttp时,实际上库把请求交给内部的线程池(Dispatcher/worker threads),在这些线程上执行阻塞 I/O,这些线程被阻塞,然后通过回调把结果回传给用户主线程,换句话说是“线程池 + 阻塞 I/O”的异步封装。
线程、进程、协程的区别
进程是操作系统资源分配的基本单位。进程拥有独立的内存堆、栈、系统资源(如文件句柄、网络连接)和至少一个线程。
线程是CPU分发、调度的基本单位,共享进程的内存资源,是进程中的一个执行流。同时线程拥有独自的栈和寄存器。
协程是用户态/runtime层面的,轻量级可挂起任务,它的比较对象应该是Runnable、Callable之类的任务,而不是线程。协程运行时会占用线程的CPU时间片,同一线程下协程之间共享对应的线程、进程资源。
在 Java 中,当我们启动 main 函数时其实就是启动了一个 JVM 的进程,而 main 函数所在的线程,就是这个进程中的一个线程,也称主线程。
对于线程和进程,我们可以这么理解:
- 当进程只有一个线程时,可以认为进程就等于线程;
- 当进程拥有多个线程时,这些线程会共享相同的虚拟内存和全局变量等资源,这些资源在上下文切换时是不需要修改的;
- 进程是资源(包括内存、打开的文件等)分配的单位,线程是 CPU 调度的单位;
- 进程拥有一个完整的资源平台,而线程只独享必不可少的资源,如寄存器和栈;
- 线程同样具有就绪、阻塞、执行三种基本状态,同样具有状态之间的转换关系;
- 线程能减少并发执行的空间开销;
一个线程可以同时运行多个协程吗?
如果“同时”指“在同一时刻真正并行执行”——不能。单个 CPU 核心 / 单个线程在任一瞬间只有一个指令流在执行,所以同一线程上只有一个协程在运行。
如果“同时”指“并发地管理/进行”(也就是切换执行,看起来像同时)——可以。一个线程可以承载并调度大量协程,按需在它们之间切换(通常由协程主动让出控制权),因此看起来多个协程“同时在进展”。
Java里面的线程和操作系统的线程一样吗?
按照管理、使用对象对线程分类,可分为:
- 用户线程:用户空间程序或运行时环境(如 JVM、Go runtime)创建和管理的线程抽象,其生命周期和调度逻辑由应用程序或语言运行时控制。内核无法感知用户线程,因此不具备利用多核并行的能力。只要不是内核线程,那么可以说是用户线程。
- 内核线程:由操作系统内核创建、调度和管理的执行实体,拥有独立的内核栈和调度上下文,能够直接参与 CPU 时间片分配并利用多核并行能力。
用户线程创建、切换成本低,但不可以利用多核;内核线程创建、切换成本高,可以利用多核。
映射模型是用户线程和内核线程之间的关联方式,常见的映射模型有这三种:
- 一对一(一个用户线程对应一个内核线程)
- 多对一(多个用户线程映射到一个内核线程)
- 多对多(多个用户线程映射到多个内核线程)
在现代 Java 中,java.lang.Thread 虽属于用户线程(因其由 Java 程序创建并封装),但每个用户线程在启动时都会直接使用系统API,创建一个对应的内核线程,两者一一绑定,实际调度完全交由内核完成,是 1 对 1 的映射模型。
因此可以简单的说,Java的线程是内核线程。
推荐阅读
https://go.cyub.vip/gmp/gmp-model/
补
狭义上,轻量级进程 LWP(Light-Weight Process)就是内核级线程(kernel thread / schedulable kernel entity);(Solaris 明确把 LWP 当作内核可调度单位;在 Linux 语境下,把 LWP 当作 TID/内核线程来看待。)
广义上,有时也用LWP来指代“作为用户线程与内核线程之间的可调度载体”的那个实体(即在 M:N 模型里把用户线程复用到的内核调度单元)。
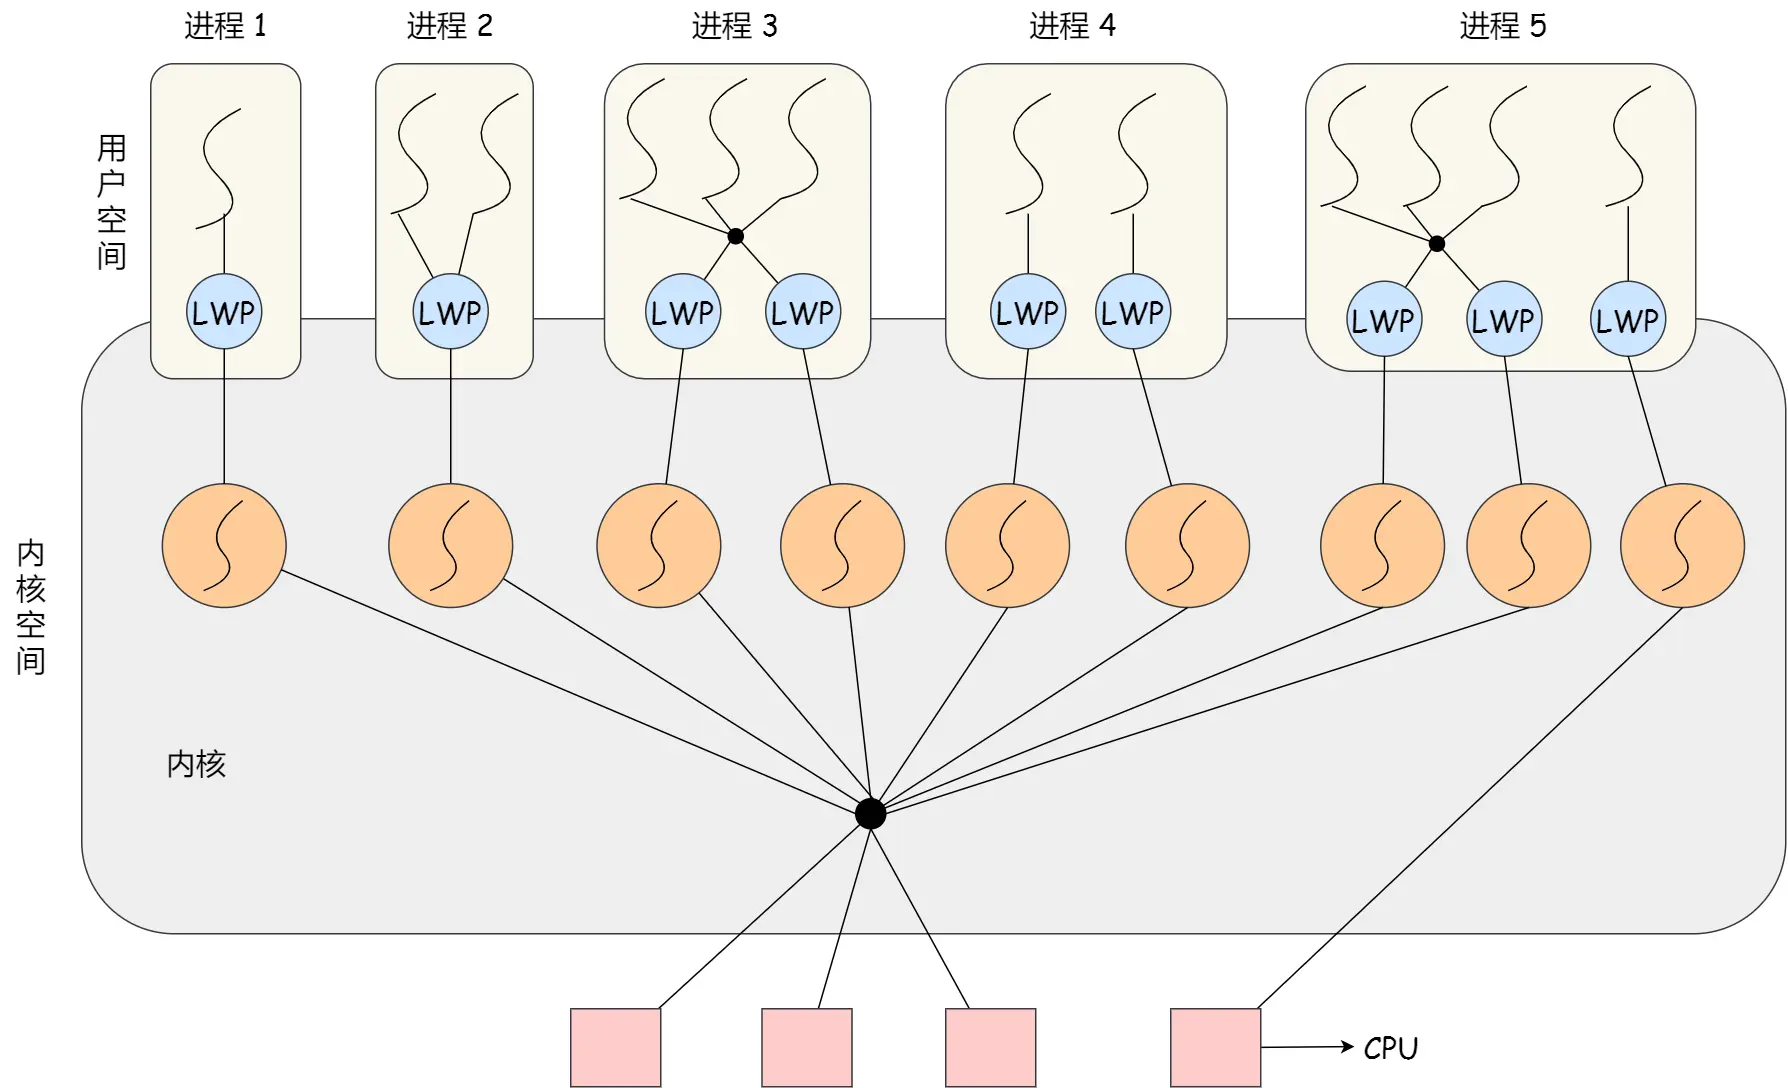
推荐阅读。
https://cloud.tencent.com/developer/article/2187991
Linux下,进程和线程十分相似,无论进程还是线程,都是抽象成了 task 任务,在源码里都是用同一个task_struct 数据结构来实现的。
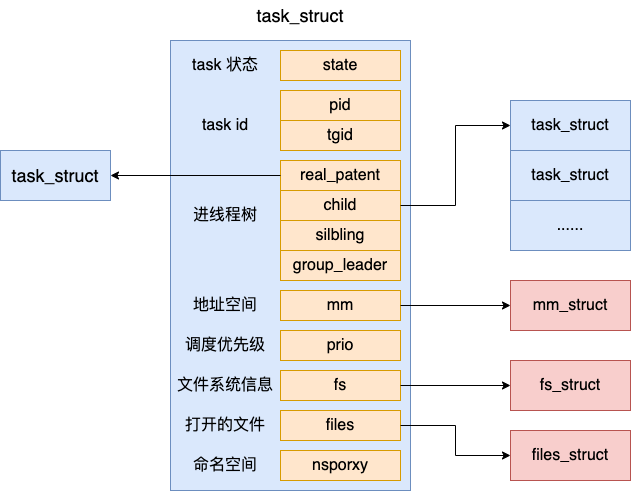
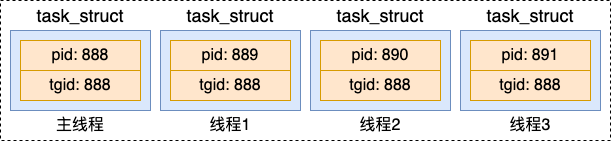
对于进程来说,这个 pid 就是我们平时常说的进程 pid。
对于线程来说,我们假如一个进程下创建了多个线程出来。那么每个线程的 pid 都是不同的。但是我们一般又需要记录线程是属于哪个进程的。这时候,tgid 就派上用场了,通过 tgid 字段来表示自己所归属的进程 ID。
CPU、线程、进程切换上下文是什么
“CPU 切换上下文”是总称;线程切换与进程切换是两种具体情形。
线程上下文切换是指操作系统为了执行多个线程,需要保存当前运行线程的状态,并恢复另一个线程的状态,以便下一次能继续执行当前线程的过程。
“上下文”是什么:指的是CPU运行时其寄存器和程序计数器的内容。寄存器存储了CPU的当前工作变量,程序计数器则指示了CPU下一条要执行的指令地址。CPU 寄存器和程序计数是 CPU 在运行任何任务前,所必须依赖的环境,这些环境就叫做 CPU 上下文。
进程切换上下文
“切换”的过程
- 操作系统内核会中断当前正在执行的线程。
- 内核将当前进程的运行时状态(寄存器、程序计数器、页表指针等)保存到其 进程控制块PCB 中。
- 将当前进程的状态从“运行”改为“就绪”、“阻塞”或其他相应状态,并将其移入对应的调度队列。
- 调度算法从就绪队列中选择一个优先级最高、最合适的进程来运行。
- 恢复要运行的下一个进程的上下文,从新进程的PCB中加载其之前保存的寄存器、程序计数器、栈指针等状态信息到CPU中。切换内存管理单元(MMU)的页表,以映射新进程的地址空间。
- 跳转并开始执行:将程序计数器(PC)设置为新进程上次被中断时下一条要执行的指令地址,CPU开始执行新进程的代码。
切换发生场景
- 主动放弃CPU:
- 进程阻塞:当进程执行了需要等待外部事件的操作时,如进行I/O操作(读文件、网络请求)、等待信号量或锁、调用
sleep()等。 - 显式让出:进程主动调用
yield()等函数,自愿放弃CPU。
- 进程阻塞:当进程执行了需要等待外部事件的操作时,如进行I/O操作(读文件、网络请求)、等待信号量或锁、调用
- 被动剥夺CPU:
- 时间片用完:在分时系统中,当前进程的CPU时间片耗尽,系统强制收回CPU。
- 更高优先级进程就绪:一个有更高优先级的进程进入就绪状态(如中断处理完成后唤醒了一个高优先级任务),内核会进行抢占式调度,立即剥夺当前进程的CPU。
- 被中断打断:
- 虽然中断处理本身不是完整的上下文切换,但它为切换创造了条件。当中断处理程序(如时钟中断、I/O中断)完成后,内核可能会发现有一个更高优先级的进程需要运行,从而触发调度。
线程切换上下文
“切换”的过程
- 操作系统内核会中断当前正在执行的线程。
- 将该线程的当前状态(所有寄存器值、程序计数器等)保存到内存中一个称为“线程控制块TCB”的数据结构里。
- 将当前线程的状态从“运行”改为“就绪”或“阻塞”,并将其移入对应的调度队列。
- 调度算法从就绪队列中选择一个优先级最高、最合适的线程来运行。
- 然后从内存中加载下一个要运行的线程的已保存状态到CPU中。
- 最后,将程序计数器指向新线程要执行的指令,CPU开始运行新线程。
切换发生场景
- 主动放弃CPU:
- 线程阻塞:线程执行了需要等待的操作,如I/O操作、等待互斥锁/信号量、调用
sleep()、wait()等。 - 显式让出:线程主动调用
yield(),建议调度器让出CPU。
- 线程阻塞:线程执行了需要等待的操作,如I/O操作、等待互斥锁/信号量、调用
- 被动剥夺CPU:
- 时间片用完:当前线程的CPU时间片耗尽。
- 更高优先级线程就绪:一个更高优先级的线程变为就绪状态,触发抢占式调度。
- 被中断打断:中断处理完成后,调度器可能决定运行另一个就绪的线程。
线程上下文切换是有代价的。它需要直接的CPU时间来保存和加载状态,并且会导致CPU缓存(如L1, L2缓存)失效,因为新线程需要加载自己的数据到缓存中,这会对性能产生显著影响。在Android开发中,不必要或过于频繁的线程切换是导致应用卡顿的重要原因之一。
总结
线程相比进程能减少开销,体现在:
- 线程的创建时间比进程快,因为进程在创建的过程中,还需要资源管理信息,比如内存管理信息、文件管理信息,而线程在创建的过程中,不会涉及这些资源管理信息,而是共享它们;
- 线程的终止时间比进程快,因为线程释放的资源相比进程少很多;
- 同一个进程内的线程切换比进程切换快,因为线程具有相同的地址空间(虚拟内存共享),这意味着同一个进程的线程都具有同一个页表,那么在切换的时候不需要切换页表。而对于进程之间的切换,切换的时候要把页表给切换掉,而页表的切换过程开销是比较大的;
- 由于同一进程的各线程间共享内存和文件资源,那么在线程之间数据传递的时候,就不需要经过内核了,这就使得线程之间的数据交互效率更高了;
线程的创建方式
继承Thread类
继承Thread类,重写run方法。run()方法中定义了线程执行的具体任务。创建该类的实例后,通过调用start()方法启动线程。
class MyThread extends Thread {
    @Override
    public void run() {
        // 线程执行的代码
    }
}

public static void main(String[] args) {
    MyThread t = new MyThread();
    t.start();
}
采用继承Thread类方式
- 优点:直接、清晰,能覆写线程方法并加自定义状态/方法。
- 缺点:不能复用线程类用于不同任务(耦合 task 与 thread);Java 单继承限制(无法再继承别的类)。
实现Runnable接口
public class WorkerRunnable implements Runnable {
    private final String name;

    public WorkerRunnable(String name) {
        this.name = name;
    }

    @Override
    public void run() {
        //
    }

    public static void main(String[] args) throws InterruptedException {
        Thread t = new Thread(new WorkerRunnable("task-A"), "thread-A");
        t.start();
    }
}
把任务与线程分离,可复用任务类,传给 Thread 或线程池。
- 优点:任务与线程分离,易复用、易测试;可与线程池配合。
- 缺点:无返回值、无法直接抛出受检查异常传回调用者(可用
Callable/Future代替)。
实现Callable接口/使用FutureTask类
public class CallableExample {
    static class SumTask implements Callable<Integer> {
        private final int n;
        SumTask(int n) { this.n = n; }
        @Override
        public Integer call() throws Exception {
            int sum = 0;
            for (int i=1;i<=n;i++) sum += i;
            Thread.sleep(200); // 模拟耗时
            return sum;
        }
    }

    public static void main(String[] args) throws Exception {
        // 使用 FutureTask 在单独线程中运行并可复用
        FutureTask<Integer> futureTask = new FutureTask<>(new SumTask(100));
        Thread t = new Thread(futureTask, "sum-thread");
        t.start();

        // 主线程可以做别的事
        System.out.println("Waiting for result...");
        Integer result = futureTask.get(1, TimeUnit.SECONDS);
        System.out.println("Sum result = " + result);
    }
}
当任务需要返回值或抛异常时使用 Callable。
要因为Thread类的构造器只接受Runnable参数,而FutureTask实现了Runnable接口。
FutureTask 可将 Callable 转为可运行的 Runnable,或直接用于监控/取消任务。
- 优点:可返回结果、可抛异常、支持取消和超时。
- 缺点:相比单纯
Runnable稍复杂;如果频繁创建裸线程开销大(推荐结合线程池)。
使用ExecutorService线程池
import java.util.concurrent.*;

public class ExecutorServiceDemo {
    public static void main(String[] args) throws InterruptedException {
        ThreadFactory namedFactory = new ThreadFactory() {
            private final ThreadFactory defaultFactory = Executors.defaultThreadFactory();
            private final AtomicInteger idx = new AtomicInteger(1);
            public Thread newThread(Runnable r) {
                Thread t = defaultFactory.newThread(r);
                t.setName("pool-worker-" + idx.getAndIncrement());
                return t;
            }
        };

        ExecutorService pool = Executors.newFixedThreadPool(3, namedFactory);

        for (int i = 0; i < 6; i++) {
            final int id = i;
            pool.submit(() -> {
                //do something
            });
        }

        // 优雅关停
        pool.shutdown();
        if (!pool.awaitTermination(2, TimeUnit.SECONDS)) {
            pool.shutdownNow();
        }
        System.out.println("pool terminated");
    }
}
线程池是生产级并发的标准做法:复用线程、控制并发度、统一管理。可以自定义 ThreadFactory、提交任务、优雅关闭。
- 优点:高效复用线程、可控制最大并发、统一管理异常/生命周期。
- 缺点:需要合理配置池参数(线程数、队列、拒绝策略);滥用全局单例池可能导致资源争抢/任务延迟。
使用CompletableFuture类
import java.util.concurrent.*;

public class CompletableFutureDemo {
    public static void main(String[] args) {
        ExecutorService ioPool = Executors.newCachedThreadPool();

        CompletableFuture.supplyAsync(() -> {
            // 异步获取数据
            return "raw-data";
        }, ioPool)
        .thenApplyAsync(raw -> {
            // 转换
            return raw.toUpperCase();
        }, ioPool)
        .thenAccept(result -> {
            // 使用结果
            System.out.println("Got result: " + result);
        })
        .exceptionally(ex -> {
            //异常处理
            System.err.println("Error: " + ex.getMessage());
            return null;
        });

        ioPool.shutdown();
    }
}
现代异步编程风格,支持链式、组合、异常处理,适合 I/O 异步或事件驱动逻辑。
- 优点:易写链式/组合异步逻辑;良好的异常处理和时间控制;可与
Executor配合指定线程池。 - 缺点:链过长可读性下降;调试栈跟踪不如同步代码直观(但比回调好很多)。
总结
严格来说,Java 就只有一种方式可以创建线程,那就是通过new Thread().start()创建。像Runnable、Callable实际上创建的是任务。不管是哪种方式,最终还是依赖于new Thread().start()。
守护线程是什么
守护线程是一种支持性线程,它的存在是为了服务于其他线程(用户线程)。它的生命周期依赖于用户线程,当所有用户线程都结束时,无论守护线程是否正在执行,JVM都会立即退出,守护线程也会被直接终止。
在启动线程之前,通过 setDaemon(true) 方法将一个线程设置为守护线程。在线程启动后设置会抛出 IllegalThreadStateException。
进程、线程的状态变化
进程状态模型
操作系统中进程的状态模型主要有三态模型、五态模型、七态模型。
三态模型
- 运行态:进程正在CPU上执行。
- 就绪态:进程已获得了除CPU之外的所有必要资源,一旦得到CPU即可立即执行。
- 阻塞态:进程由于等待某个事件(如I/O操作完成、信号量等)而无法继续执行。
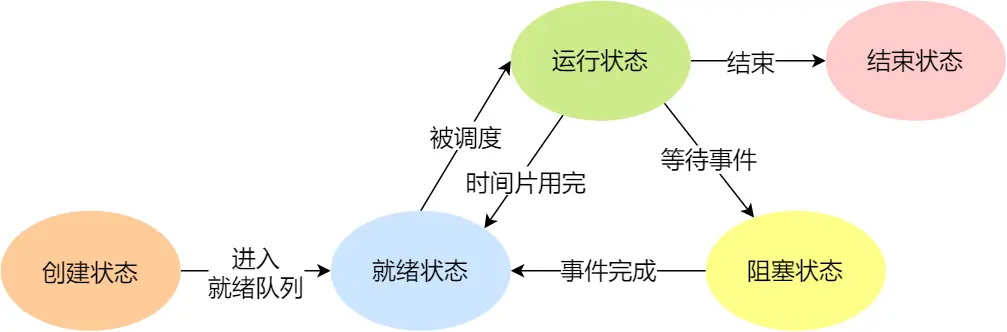
五态模型
在三态模型的基础上,增加了创建和终止状态。
- 创建态:进程正在被创建,尚未进入就绪状态。操作系统会为其分配PCB、资源等。
- 就绪态:进程已获得了除CPU之外的所有必要资源,一旦得到CPU即可立即执行。
- 运行态:进程正在CPU上执行。
- 阻塞态:进程由于等待某个事件(如I/O操作完成、信号量等)而无法继续执行。
- 终止态:进程已结束运行,操作系统正在回收其占用的资源和PCB。
状态转换
- NULL → 创建态:一个新进程被创建。
- 创建态 → 就绪态:系统完成创建过程,将进程加入就绪队列。
- 就绪态 → 运行态:进程调度器选择了这个进程(进程上下文切换)。
- 运行态 → 就绪态:时间片用完,或有更高优先级的进程进入就绪状态(被抢占)。
- 运行态 → 阻塞态:进程请求等待某个事件(如I/O请求)。
- 阻塞态 → 就绪态:进程等待的事件发生了(如I/O完成)。
- 运行态 → 终止态:进程执行完毕,或者出现不可恢复的错误。
七态模型
当系统资源紧张,特别是内存不足时,操作系统需要将一些暂时不能运行的进程从内存移到外存(磁盘交换区),以释放内存空间。这个操作就叫“挂起”。被挂起的进程处于“挂起状态”。
- 创建态:进程正在被创建,尚未进入就绪状态。操作系统会为其分配PCB、资源等。
- 就绪态:进程在内存中,并准备好运行,只等待CPU。
- 运行态:进程正在CPU上执行。
- 阻塞态:进程在内存中,但正在等待某个事件(如I/O完成)。
- 就绪/挂起态:进程在外存中,但已经具备了运行条件(只要被换入内存并得到调度,就能立即运行)。
- 阻塞/挂起态:进程在外存中,并且正在等待某个事件。
- 终止态:进程已结束运行,操作系统正在回收其占用的资源和PCB。、
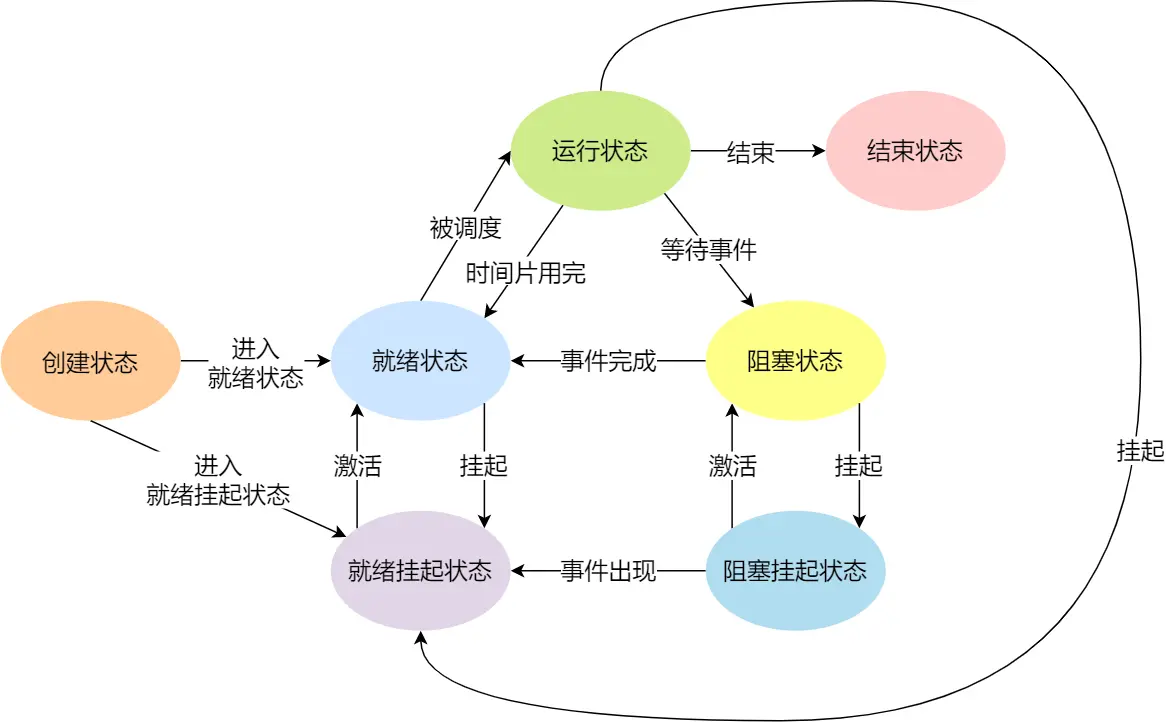
导致进程挂起的原因不只是因为进程所使用的内存空间不足,还包括如下情况:
- 通过 sleep 让进程挂起。
- 用户主动挂起一个程序的执行。
PCB
进程描述信息:
- 进程标识符:标识各个进程,每个进程都有一个并且唯一的标识符;
- 用户标识符:进程归属的用户,用户标识符主要为共享和保护服务;
进程控制和管理信息:
- 进程当前状态
- 进程优先级:进程抢占 CPU 时的优先级;
资源分配清单:
- 有关内存地址空间或虚拟地址空间的信息,所打开文件的列表和所使用的 I/O 设备信息。
CPU 相关信息:
- CPU 中各个寄存器的值,当进程被切换时,CPU 的状态信息都会被保存在相应的 PCB 中,以便进程重新执行时,能从断点处继续执行。
Linux中的PCB就是task_struct。
进程的创建、终止、阻塞、唤醒
01 创建进程
操作系统允许一个进程创建另一个进程,而且允许子进程继承父进程所拥有的资源。
创建进程的过程如下:
- 申请一个空白的 PCB,并向 PCB 中填写一些控制和管理进程的信息,比如进程的唯一标识等;
- 为该进程分配运行时所必需的资源,比如内存资源;
- 将 PCB 插入到就绪队列,等待被调度运行;
UNIX:fork/exec
WINDOWS:CreateProcess
02 终止进程
进程可以有 3 种终止方式:正常结束、异常结束以及外界干预(信号 kill 掉)。
当子进程被终止时,其在父进程处继承的资源应当还给父进程。而当父进程被终止时,该父进程的子进程就变为孤儿进程,会被 1 号进程收养,并由 1 号进程对它们完成状态收集工作。
终止进程的过程如下:
- 查找需要终止的进程的 PCB;
- 如果处于执行状态,则立即终止该进程的执行,然后将 CPU 资源分配给其他进程;
- 如果其还有子进程,则应将该进程的子进程交给 1 号进程接管;
- 将该进程所拥有的全部资源都归还给操作系统;
- 将其从 PCB 所在队列中删除;
UNIX:exit
WINDOWS:TerminateProcess
03 阻塞进程
当进程需要等待某一事件完成时,它可以调用阻塞语句把自己阻塞等待。而一旦被阻塞等待,它只能由另一个进程唤醒。
阻塞进程的过程如下:
- 找到将要被阻塞进程标识号对应的 PCB;
- 如果该进程为运行状态,则保护其现场,将其状态转为阻塞状态,停止运行;
- 将该 PCB 插入到阻塞队列中去;
UNIX:wait
WINDOWS:WaitForSingleObject
04 唤醒进程
进程由「运行」转变为「阻塞」状态是由于进程必须等待某一事件的完成,所以处于阻塞状态的进程是绝对不可能叫醒自己的。
如果某进程正在等待 I/O 事件,需由别的进程发消息给它,则只有当该进程所期待的事件出现时,才由发现者进程用唤醒语句叫醒它。
唤醒进程的过程如下:
- 在该事件的阻塞队列中找到相应进程的 PCB;
- 将其从阻塞队列中移出,并置其状态为就绪状态;
- 把该 PCB 插入到就绪队列中,等待调度程序调度;
进程的阻塞和唤醒是一对功能相反的语句,如果某个进程调用了阻塞语句,则必有一个与之对应的唤醒语句。
线程六态
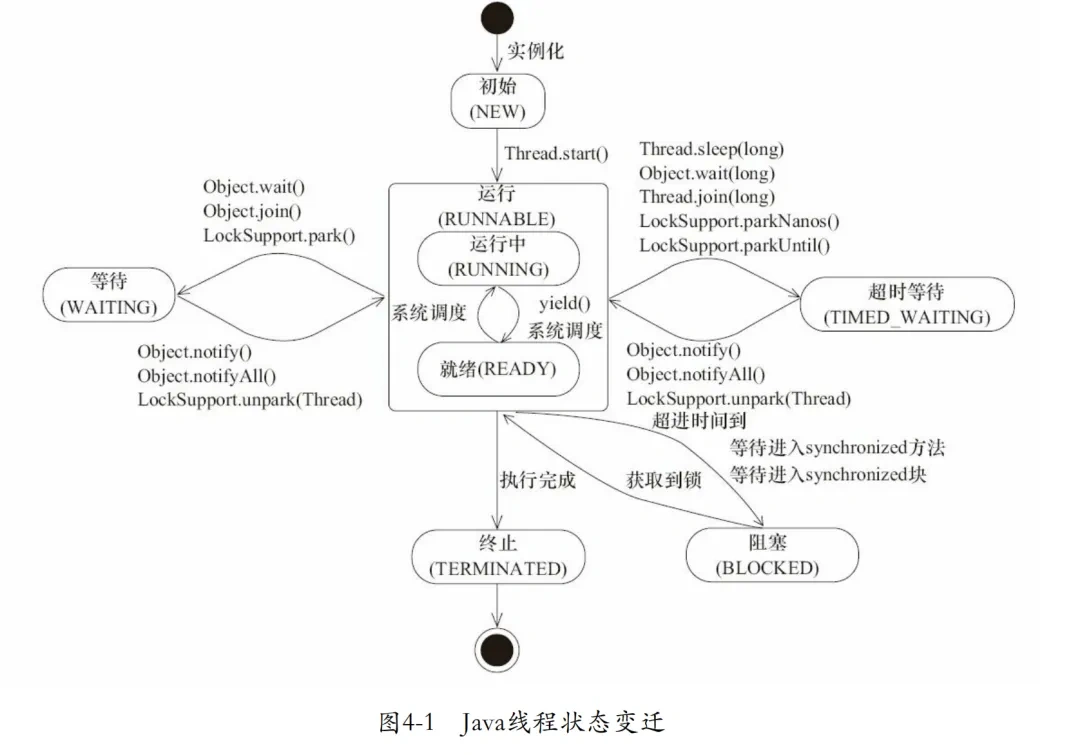
其中Java线程的RUNNABLE状态,对应操作系统级进程/线程的两个状态:RUNNING运行中、READY就绪。
| 线程状态 | 解释 |
|---|---|
| NEW | 尚未启动的线程状态,即线程创建,还未调用start方法 |
| RUNNABLE | 就绪状态(调用start,等待调度)+正在运行 |
| BLOCKED | 等待监视器锁时,陷入阻塞状态 |
| WAITING | 等待状态的线程正在等待另一线程执行特定的操作(如notify) |
| TIMED_WAITING | 具有指定等待时间的等待状态 |
| TERMINATED | 线程完成执行,终止状态 |
// Thread.State 源码
public enum State {
    NEW,
    RUNNABLE,
    BLOCKED,
    WAITING,
    TIMED_WAITING,
    TERMINATED;
}

// Thread.getState方法源码:
public State getState() {
    // get current thread state
    return sun.misc.VM.toThreadState(threadStatus);
}
NEW
没有调用 Thread 实例的start()方法。只是创建了线程而并没有调用 start 方法,此时线程处于 NEW 状态。
private void createThread() {
    Thread thread = new Thread(() -> {});
    System.out.println(thread.getState()); // 输出 NEW
}
RUNNABLE
调用start方法,线程从NEW状态转变为RUNNABLE状态。线程已经启动,正在Java虚拟机中执行,或者等待操作系统的资源(如CPU)。注意,在RUNNABLE状态中,线程可能正在运行,也可能准备运行,这取决于操作系统的调度。
线程可能因为操作系统的调度而处于就绪(ready)或运行(running)状态,但这在Java线程状态中统一为RUNNABLE。
注意
从操作系统层面来说,线程在等待IO时是阻塞的,不占用CPU,不是可运行Runnable状态。
但是,在HotSpot JVM的具体实现中,通过 Thread.getState() 方法查询,线程在等待IO时,它的状态通常被报告为 RUNNABLE,这需要我们结合其他工具(如jstack, async-profiler)来准确判断线程是在忙计算还是在等待I/O。
这就是JVM 与 操作系统的线程状态模型不完全一致的情况之一。
如果多次调用start方法会如何?
可以在终止状态TERMINATED调用吗?
// 使用synchronized关键字保证这个方法是线程安全的
public synchronized void start() {
    // threadStatus初始值为0
    // threadStatus != 0 表示这个线程已经被启动过或已经结束了
    // 如果试图再次启动这个线程,就会抛出IllegalThreadStateException异常
    if (threadStatus != 0)
        throw new IllegalThreadStateException();

    // 将这个线程添加到当前线程的线程组中
    group.add(this);

    // 声明一个变量,用于记录线程是否启动成功
    boolean started = false;
    try {
        // 使用native方法启动这个线程
        start0();
        // 如果没有抛出异常,那么started被设为true,表示线程启动成功
        started = true;
    } finally {
        // 在finally语句块中,无论try语句块中的代码是否抛出异常,都会执行
        try {
            // 如果线程没有启动成功,就从线程组中移除这个线程
            if (!started) {
                group.threadStartFailed(this);
            }
        } catch (Throwable ignore) {
            // 如果在移除线程的过程中发生了异常,我们选择忽略这个异常
        }
    }
}
从threadStatus这个变量来看,就能确定start方法不能多次调用。在TERMINATED状态调用start时,也会报错。因为其在native方法中被修改,不会被重复赋值为0。
//https://stackoverflow.com/questions/53406078/java-lang-thread-where-does-threadstatus-come-from
// Write the thread status value to threadStatus field in java.lang.Thread java class.
void java_lang_Thread::set_thread_status(oop java_thread,
                                         java_lang_Thread::ThreadStatus status) {
  // The threadStatus is only present starting in 1.5
  if (_thread_status_offset > 0) {
    java_thread->int_field_put(_thread_status_offset, status);
  }
}
在调用Thread#start方法前,这里认为,Java线程NEW状态没有对应操作系统线程的任一状态,因为内核线程还未被开始创建。
在调用Thread#start方法后,Java才通过系统API创建了对应的内核线程。
BLOCKED
线程被阻塞。
等待一个锁释放以进入临界区;
在调用Object.wait()方法后,被notify唤醒重新进入临界区时被又被阻塞,通常发生在竞争同步资源时。
WAITING
线程处于等待状态,直到其他线程执行特定的动作后被唤醒。
线程进入等待状态是通过调用以下方法之一:
Object#wait()without timeoutThread#join()without timeoutLockSupport#park()
在WAITING状态,线程等待另一个线程的通知(如Object.notify()或Object.notifyAll())或者等待另一个线程结束(如Thread.join())。
TIMED_WAITING
线程在指定的时间范围内等待。与WAITING类似,但有一个超时时间。通过以下方法可以进入TIMED_WAITING状态:
Thread.sleep(long millis)Object.wait(long timeout)Thread.join(long millis)LockSupport.parkNanos(long nanos)LockSupport.parkUntil(long deadline)
TERMINATED
线程执行完毕或者因为异常退出而终止时处于该状态。
终止状态分为两种情况:
- 调用run方法,正常执行完毕后,线程自然终止。
- 没有捕获的异常终止了run方法,使线程意外终止。
一旦进入终止状态,线程将不再拥有运行的资格,也不能再转换到其他状态,生命周期结束。
WAITING → RUNNABLE
根据转换图,知道有 3 个方法可以使线程从 RUNNABLE 状态转为 WAITING 状态。我们主要介绍下Object#wait()和Thread#join()。
Object#wait()
调用wait()方法前,线程必须持有对象的锁。
线程调用wait()方法时,会释放当前的锁,直到有其他线程对同一个锁对象调用notify()/notifyAll()方法,才可以唤醒等待锁的线程。
需要注意的是,其他线程调用notify()方法只会唤醒单个等待锁的线程,如有多个线程都在等待这个锁的话,不一定会唤醒到之前调用wait()方法的线程。
同样,调用notifyAll()方法唤醒所有等待锁的线程之后,刚才wait放弃锁的线程也不一定会获取到锁、获得时间片,具体要看系统的调度(可能存在其他线程竞争)。
Thread#join()
线程T1调用T2.join()方法,T1会一直等待T2线程执行任务完毕(转换为 TERMINATED 状态)。
public static void main(...) {
    ······
    a.start();
    a.join();
    b.start();
    System.out.println(a.getName() + ":" + a.getState()); // 输出 TERMINATED
    System.out.println(b.getName() + ":" + b.getState());
}
要是没有调用 join 方法,main 线程不管 a 线程是否执行完毕都会继续往下走。
a 线程启动之后,main线程马上调用了 a.join 方法,这里 main 线程就会等到 a 线程执行完毕,所以这里 a 线程打印的状态一定是TERMINATED。
由于 join() 的阻塞特性,main线程会阻塞在a.join(),a线程任务完成后,b.start() 才执行。
线程b的状态可能是 RUNNABLE 或 TERMINATED,取决于其执行速度
sleep 和 wait的区别是什么?
对比例表:
| 特性 | sleep() |
wait() |
|---|---|---|
| 所属类 | Thread 类(静态方法) |
Object 类(实例方法) |
| 锁释放 | ❌ | ✅ |
| 使用前提 | 任意位置调用 | 必须在同步块内(持有锁) |
| 唤醒机制 | 超时自动恢复 | 需 notify()/notifyAll() 或超时 |
| 设计用途 | 暂停线程执行,不涉及锁协作 | 线程间协调,释放锁让其他线程工作 |
- 所属分类的不同:sleep 是
Thread类的静态方法,可以在任何地方直接通过Thread.sleep()调用,无需依赖对象实例。wait 是Object类的实例方法,这意味着必须通过对象实例来调用。 - 锁释放的情况:
Thread.sleep()在调用时,线程会暂停执行指定的时间,但不会释放持有的对象锁。也就是说,在sleep期间,其他线程无法获得该线程持有的锁。object.wait():调用该方法时,线程会释放持有的对象锁,进入等待状态,直到其他线程调用相同对象的notify()或notifyAll()方法唤醒它。 - 使用条件:sleep 可在任意位置调用,无需事先获取锁。 wait 必须在同步块或同步方法内调用(即线程需持有该对象的锁),否则抛出
IllegalMonitorStateException。 - 唤醒机制:sleep 休眠时间结束后,线程 从 TIMED_WAITING 自动恢复 到 RUNNABLE,等待CPU调度。wait 需要其他线程调用相同锁对象的
lock.notify()或lock.notifyAll()方法才能被唤醒。lock.notify()会随机唤醒一个在该锁对象上等待的线程,而lock.notifyAll()会唤醒所有在该锁对象上等待的线程。
sleep、yield会释放CPU吗
sleep
调用 Thread.sleep() 时,线程会释放 CPU,但不会释放持有的锁。
当线程调用 sleep() 后,会主动让出 CPU 时间片,进入 TIMED_WAITING 状态。此时操作系统会触发调度,将 CPU 分配给其他处于RUNNABLE状态的线程。这样其他线程(无论是需要同一锁的线程还是不相关线程)便有机会执行。
sleep() 不会释放线程已持有的任何锁(如 synchronized 同步代码块或方法中获取的锁)。因此,如果有其他线程试图获取同一把锁,它们仍会被阻塞,直到原线程退出同步代码块。
yield
同样,Thread.yield() 只是给调度器的**“建议/提示”:当前线程让出 CPU 使用权的意图**,但不保证任何效果(调度器可以忽略它)。
yield() 不会释放持有的锁 / 监视器。只有 Object.wait() 会释放当前同步块/对象的监视器。
如果你在持有锁的情况下调用 yield(),其它等待同一锁的线程仍然无法进入临界区(因为锁还在你手上),所以这通常不能改善并发/公平性,反而可能降低效率或造成误解。
不要依赖 yield() 控制并发或实现正确性。用它只适合非常局部的优化(比如短时间的自旋退让),并且要非常谨慎。
停止线程常用方法
Thread.interrupt() 只设置中断标志(Thread.interrupted()/isInterrupted() 可读)。它不会强制停止线程,而是靠被阻塞的 API 或代码去“响应”这个标志。
常见库/方法对中断的响应分成三类:
- 抛出
InterruptedException并清除中断状态(典型的可中断阻塞方法,sleep、wait、join、Condition.await、BlockingQueue.take)。 - 返回/解除阻塞但不抛出异常,保留或设置中断状态(比如
LockSupport.park)。 - 完全不响应中断(不可中断),只有其它手段能把它唤醒(比如
synchronized的 monitor 获取阻塞、某些传统阻塞 IO)。
优先使用协作式取消(interrupt / 标志位 / Executor + Future),避免使用已废弃或强行杀死的手段(如 Thread.stop)。
协作式取消的核心原理是:
- 设置标志位:调用
interrupt()只是设置线程的中断状态标志 - 检查标志位:被中断的线程需要主动检查这个标志并决定如何响应
- 清除状态:某些方法会响应中断并清除中断状态
配合处理中断
使用t.interrupt(),设置线程t中断标志(interrupt)。
如果线程在可中断的阻塞调用,比如预先调用了sleep, wait, join, BlockingQueue.take() 等方法,这时候设置中断标识,则会抛出 InterruptedException,同时清理该中断标志,所以尽可能主动处理该异常,进行重新设置中断标识,或者清理资源。
否则,线程可通过 Thread.interrupted() / Thread.currentThread().isInterrupted() 主动检测中断标识并退出。
Thread#interrupted vs t#isInterrupted
Thread.interrupted()(静态):查询并清除当前线程的中断标志(返回后标志变为 false)
Thread.currentThread().isInterrupted():查询当前线程的中断标志(不清除)。
适用:线程会执行阻塞或周期性检查中断状态的场景(大多数情况)。
示例:
public class InterruptibleThread extends Thread {
    @Override
    public void run() {
        while (!Thread.currentThread().isInterrupted()) {
            try {
                // 执行任务
                System.out.println("Working...");
                Thread.sleep(1000);
            } catch (InterruptedException e) {
                // 当线程在阻塞状态被中断时抛出
                System.out.println("Thread was interrupted during sleep");
                // 重新设置中断状态,因为捕获异常后会清除中断状态
                Thread.currentThread().interrupt();
            } finally{
                //可能需要清理资源
                cleanUp();
            }
        }
        System.out.println("Thread stopped via interrupt.");
    }
}

// 使用示例
InterruptibleThread thread = new InterruptibleThread();
thread.start();

// 3秒后中断线程
Thread.sleep(3000);
thread.interrupt();
注意:
- 捕获
InterruptedException时通常应该做必要清理,以及恢复中断标志。 interrupt()只是“请求”中断,不会强制终止线程。
使用标志位(推荐方式)
这是最常用且安全的线程停止方式,通过设置一个 volatile 标志位或 AtomicBoolean,来控制线程执行。
public class ThreadWithFlag extends Thread {
    private volatile boolean stopped = false;

    @Override
    public void run() {
        while (!stopped) {
            // 执行任务
            System.out.println("Thread is running...");
            try {
                Thread.sleep(1000);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                break;
            }
        }
        System.out.println("Thread stopped gracefully.");
    }

    public void stopThread() {
        stopped = true;
    }
}

// 使用示例
ThreadWithFlag thread = new ThreadWithFlag();
thread.start();

// 3秒后停止线程
Thread.sleep(3000);
thread.stopThread();
使用 ExecutorService 关闭线程池
对于使用线程池的情况,可以使用 ExecutorService 的关闭方法。
public class ExecutorServiceExample {
    public static void main(String[] args) throws InterruptedException {
        ExecutorService executor = Executors.newFixedThreadPool(2);

        // 提交任务
        executor.submit(() -> {
            while (!Thread.currentThread().isInterrupted()) {
                System.out.println("Task running...");
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            }
        });

        Thread.sleep(2000);

        // 方式1: 平缓关闭 - 等待正在执行的任务完成
        executor.shutdown();

        // 方式2: 立即关闭 - 尝试停止所有正在执行的任务
        // List<Runnable> notExecutedTasks = executor.shutdownNow();

        // 等待线程池终止
        if (!executor.awaitTermination(5, TimeUnit.SECONDS)) {
            System.out.println("Forcing shutdown...");
            executor.shutdownNow();
        }
    }
}
使用 Future 取消任务
当使用 Callable 或 Runnable 配合 Future 时,可以通过 Future 来取消任务。
public class FutureCancelExample {
    public static void main(String[] args) throws Exception {
        ExecutorService executor = Executors.newSingleThreadExecutor();

        Future<?> future = executor.submit(() -> {
            int count = 0;
            while (!Thread.currentThread().isInterrupted() && count < 100) {
                System.out.println("Count: " + count++);
                try {
                    Thread.sleep(100);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            }
            return count;
        });

        Thread.sleep(1000);

        // 取消任务,true 表示如果任务正在运行则中断它
        boolean cancelled = future.cancel(true);
        System.out.println("Task cancelled: " + cancelled);

        executor.shutdown();
    }
}
关闭/中断阻塞 IO
有些阻塞(如传统的 InputStream.read()、某些 native IO)未必响应 interrupt()。
解决办法:
-
使用支持中断的 NIO 通道(
SocketChannel的close()会使阻塞操作抛异常)。 -
调用
close()关闭 socket/stream,从而让阻塞调用抛出IOException,在 catch 中退出线程。 -
使用
interruptibleAPI 或可超时版本(Socket.setSoTimeout())组合轮询。
示例:
try (Socket socket = ...) {
    InputStream in = socket.getInputStream();
    while (!Thread.currentThread().isInterrupted()) {
        int b = in.read(); // 可能阻塞
        if (b < 0) break;
    }
} catch (IOException e) {
    // 可能是 close() 导致,进行清理并退出
}
注意:有些 native 方法或第三方库的阻塞调用可能完全不响应中断,这种情形需要通过关闭底层资源或考虑把工作放到独立进程并 kill 进程。
synchronized可以中断吗?
synchronized在持有锁时可以中断。synchronized在阻塞等待锁时不可中断。
//在取得lock前,interrupt()无法中断synchronized
synchronized(lock) {
    // 只有当线程已经拿到锁才会执行这里
    // 调用 interrupt() 只会设置中断标志,不会使它立刻抛 InterruptedException 或返回
    lock.wait(); // wait是可中断的阻塞,中断会抛 InterruptedException
}
ReentrantLock 在持有锁时可以中断(interrupt方法,设置标志位),在阻塞等待锁时可以中断(使用lock.lockInterruptibly)。
因为调用 Thread#interrupt() 只是设置线程的中断状态标志,不会返回、抛出异常。
小结
| 场景 / API | 中断时行为 |
|---|---|
Thread.interrupt()(调用方) |
仅设置标志,不直接抛异常 |
Thread.sleep() / Object.wait() / Condition.await()/Thread.join() |
可中断,抛 InterruptedException,并清除中断标志 |
BlockingQueue.take() / Semaphore.acquire() / Condition.await() |
抛 InterruptedException |
ReentrantLock.lock() |
不抛,等待不可中断(但中断标志被设置,可以通过标志返回退出) |
ReentrantLock.lockInterruptibly() |
可中断地等待锁;如果等待期间收到中断,会抛 InterruptedException 并且不会获得锁。 |
synchronized尝试锁 |
获取锁时不可中断 |
LockSupport.park() |
返回但不抛异常;若因中断返回则中断标志保持为 true |
线程安全的分类
按照线程安全的“安全程度”由强到弱来排序,分为以下5类:
不可变、绝对线程安全、相对线程安全、线程兼容和线程对立。
不可变
不可变对象一定是线程安全的。因不可变对象创建出来后,对于外部来说,其可见性永远不会改变。
1)共享数据是基本数据类型。定义时使用final关键字修饰即可保证不可变。
2)共享数据是对象,保证对象的行为不会对其状态产生任何改变才行。
java.lang.String类的对象是不可变对象,substring()、replace()等方法不会改变原来的值,只会返回一个新构造的字符串对象。
保证对象行为不影响自己状态的最简单方法,把对象中带有状态的变量都声明为final。
Java中的不可变类,String、枚举类型、Long、Double、BigInteger、BigDecimal。
绝对线程安全
“不管运行时环境如何,调用者都不需要进行任何额外的同步措施”。
Java API中标注线程安全的类,大多都不是绝对线程安全。
Vector的set(),get(),remove(),size()都是同步的,但是不采取适当的同步措施的话,代码仍是不安全的。
相对线程安全
通常意义上的线程安全,需要保证对这个对象单独的操作是线程安全的,无需额外保证措施,但是对于特定顺序的连续调用,需要在调用时使用额外的同步手段保证调用的正确性。
Java中,大多数的线程安全类都属于这种类型,如Vector、HashTable、Collections.synchronizedCollection()方法包装过的集合。
Vector的set(),get(),remove(),size()都是同步的,但是不采取适当的同步措施的话,代码仍是不安全的。
对于下面的代码,如果删除元素的线程删除了 Vector 的一个元素,而获取元素的线程试图访问一个已经被删除的元素,那么就会抛出 ArrayIndexOutOfBoundsException。
public class VectorUnsafeExample {
    private static Vector<Integer> vector = new Vector<>();

    public static void main(String[] args) {
        while (true) {
            for (int i = 0; i < 100; i++) {
                vector.add(i);
            }
            ExecutorService executorService = Executors.newCachedThreadPool();
            executorService.execute(() -> {
                for (int i = 0; i < vector.size(); i++) {
                    vector.remove(i);
                }
            });
            executorService.execute(() -> {
                for (int i = 0; i < vector.size(); i++) {
                    vector.get(i);
                }
            });
            executorService.shutdown();
        }
    }
}
Exception in thread "Thread-159738" java.lang.ArrayIndexOutOfBoundsException: Array index out of range: 3
    at java.util.Vector.remove(Vector.java:831)
    at VectorUnsafeExample.lambda$main$0(VectorUnsafeExample.java:14)
    at VectorUnsafeExample$$Lambda$1/713338599.run(Unknown Source)
    at java.lang.Thread.run(Thread.java:745)
如果要保证上面的代码能正确执行下去,就需要对删除元素和获取元素的代码进行同步。
executorService.execute(() -> {
    synchronized (lock) {
        for (int i = 0; i < vector.size(); i++) {
            vector.remove(i);
        }
    }
});
executorService.execute(() -> {
    synchronized (lock) {
        for (int i = 0; i < vector.size(); i++) {
            vector.get(i);
        }
    }
});
线程兼容
指对象本身不是线程安全的,可以在调用时使用同步等手段保证对象在并发环境下可以安全被被使用。
我们平时说一个类不是线程安全的,指的就是这种情况。如ArrayList和HashMap。
线程对立
指无论调用端是否采用了同步措施,都无法保证对象在多线程环境中被安全使用。
例子:Thread类的suspend()方法和resume()方法。两个线程同时对同一个线程对象调用,一个调用suspend(),一个调用resume(),可能导致死锁。
正是这个原因,这两个方法被JDK声明为@Deprecated。
如何实现线程安全
互斥同步
互斥同步最主要的问题就是线程阻塞和唤醒所带来的性能问题,因此这种同步也称为阻塞同步。
互斥同步属于一种悲观的并发策略。
synchronized 关键字
使用场景
- 简单计数器:对共享变量的简单操作
- 资源互斥访问:如文件操作、数据库连接等
- 单例模式实现:双重检查锁定
Lock 接口及其实现
ReentrantLock、读写锁 (ReadWriteLock)
使用场景
- 需要尝试获取锁:
tryLock()方法 - 需要公平锁:避免线程饥饿
- 读写分离场景:读多写少的缓存系统
- 需要中断响应:
lockInterruptibly()
非阻塞同步
可以使用基于冲突检测的乐观并发策略: 先进行操作,如果没有其它线程争用共享数据,那操作就成功了,否则采取补偿措施(不断地重试,直到成功为止)。这种乐观的并发策略的许多实现都不需要将线程阻塞,因此这种同步操作称为非阻塞同步。
只需要可见性:volatile
原子类/CAS
硬件支持的原子性操作最典型的是: 比较并交换(Compare-and-Swap,CAS)。CAS 指令需要有 3 个操作数,分别是内存地址 V、旧的预期值 A 和新值 B。当执行操作时,只有当 V 的值等于 A,才将 V 的值更新为 B。
类:AtomicInteger, AtomicLong, AtomicReference, AtomicReferenceFieldUpdater 等,以及 LongAdder、LongAccumulator。
注意ABA问题:
如果一个变量初次读取的时候是 A 值,它的值被改成了 B,后来又被改回为 A,那 CAS 操作就会误认为它从来没有被改变过。
J.U.C 包提供了一个带有标记的原子引用类 AtomicStampedReference 来解决这个问题,它可以通过控制变量值的版本来保证 CAS 的正确性。大部分情况下 ABA 问题不会影响程序并发的正确性,如果需要解决 ABA 问题,改用传统的互斥同步可能会比原子类更高效。
无同步方案
要保证线程安全,并不是一定就要进行同步。如果一个方法本来就不涉及共享数据,那它自然就无须任何同步措施去保证正确性。
栈封闭
多个线程访问同一个方法的局部变量时,不会出现线程安全问题,因为局部变量存储在虚拟机栈中,属于线程私有的。
ThreadLocal
为每个线程提供独立的变量副本,避免共享。
public class UserContext {
    private static final ThreadLocal<User> currentUser = new ThreadLocal<>();

    public static void setCurrentUser(User user) {
        currentUser.set(user);
    }

    public static User getCurrentUser() {
        return currentUser.get();
    }

    public static void clear() {
        currentUser.remove();
    }
}

// 使用示例
public class UserService {
    public void processRequest() {
        User user = getUserFromRequest();
        UserContext.setCurrentUser(user);
        try {
            // 业务处理,任何地方都可以获取当前用户
            businessLogic();
        } finally {
            UserContext.clear(); // 防止内存泄漏
        }
    }
}
使用场景
- 用户会话管理:Web应用中的用户上下文
- 数据库连接:某些框架的连接管理
- 避免参数传递:在调用链中隐式传递参数
注意:防止内存泄漏,尤其在线程池中需手动 remove()。
不可变对象
final修饰共享数据,一旦构造完成,状态不变,天然线程安全(只要正确发布)。
并发集合与队列
类:ConcurrentHashMap, ConcurrentLinkedQueue, CopyOnWriteArrayList, BlockingQueue(ArrayBlockingQueue, LinkedBlockingQueue)等。
特点:
ConcurrentHashMap:高并发读写,分段/桶级别并发。CopyOnWriteArrayList:写少读多场景(写时复制,读无需锁)。BlockingQueue:用于生产者-消费者,自动阻塞/唤醒。
示例(生产者-消费者):
BlockingQueue<String> q = new LinkedBlockingQueue<>();
// producer: q.put(item);
// consumer: String item = q.take();
使用场景:共享集合需要线程安全访问时、任务队列、读多写少集合、并发 Map 操作(缓存、计数器映射)。
JUC工具类
使用java.util.concurrent包中提供的同步工具类,如CountDownLatch、CyclicBarrier、Semaphore等。
使用场景:
CountDownLatch:允许一个或多个线程等待其他线程完成操作。CyclicBarrier:让一组线程到达一个屏障(同步点)时被阻塞,直到最后一个线程到达屏障时,屏障才会打开,所有被屏障拦截的线程才会继续运行。Semaphore:控制同时访问特定资源的线程数量。
如何查看哪些线程持有哪些锁?
Java 在运行时通过对象头(mark word) + monitor(ObjectMonitor)机制跟踪 synchronized 的拥有者,通过AQS/同步器内部字段跟踪 ReentrantLock 等的拥有者;
要 查看 哪些线程持有哪些锁,最方便的方式是用 jstack -l/jcmd Thread.print(离线分析)或在程序里用 ThreadMXBean.getThreadInfo(..., true, true)(在线分析)。
线程池
线程池就是管理一系列线程的资源池,其提供了一种限制和管理线程资源的方式。每个线程池还维护一些基本统计信息,例如已完成任务的数量。
- 降低资源消耗:通过复用已创建的线程,降低线程重复创建、销毁造成的消耗。
- 提高响应速度:当任务到达时,任务可以不需要等到线程创建就能立即执行。
- 提高线程的可管理性:使用线程池可以进行统一的管理。
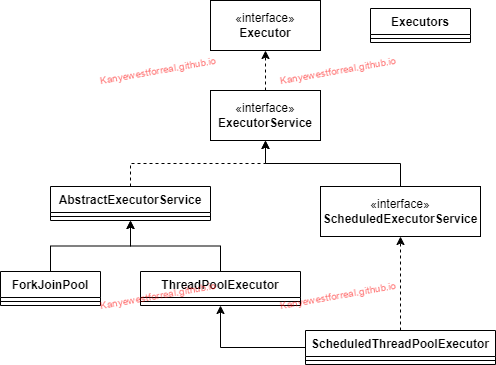
Executor 类图
Executor使用流程图
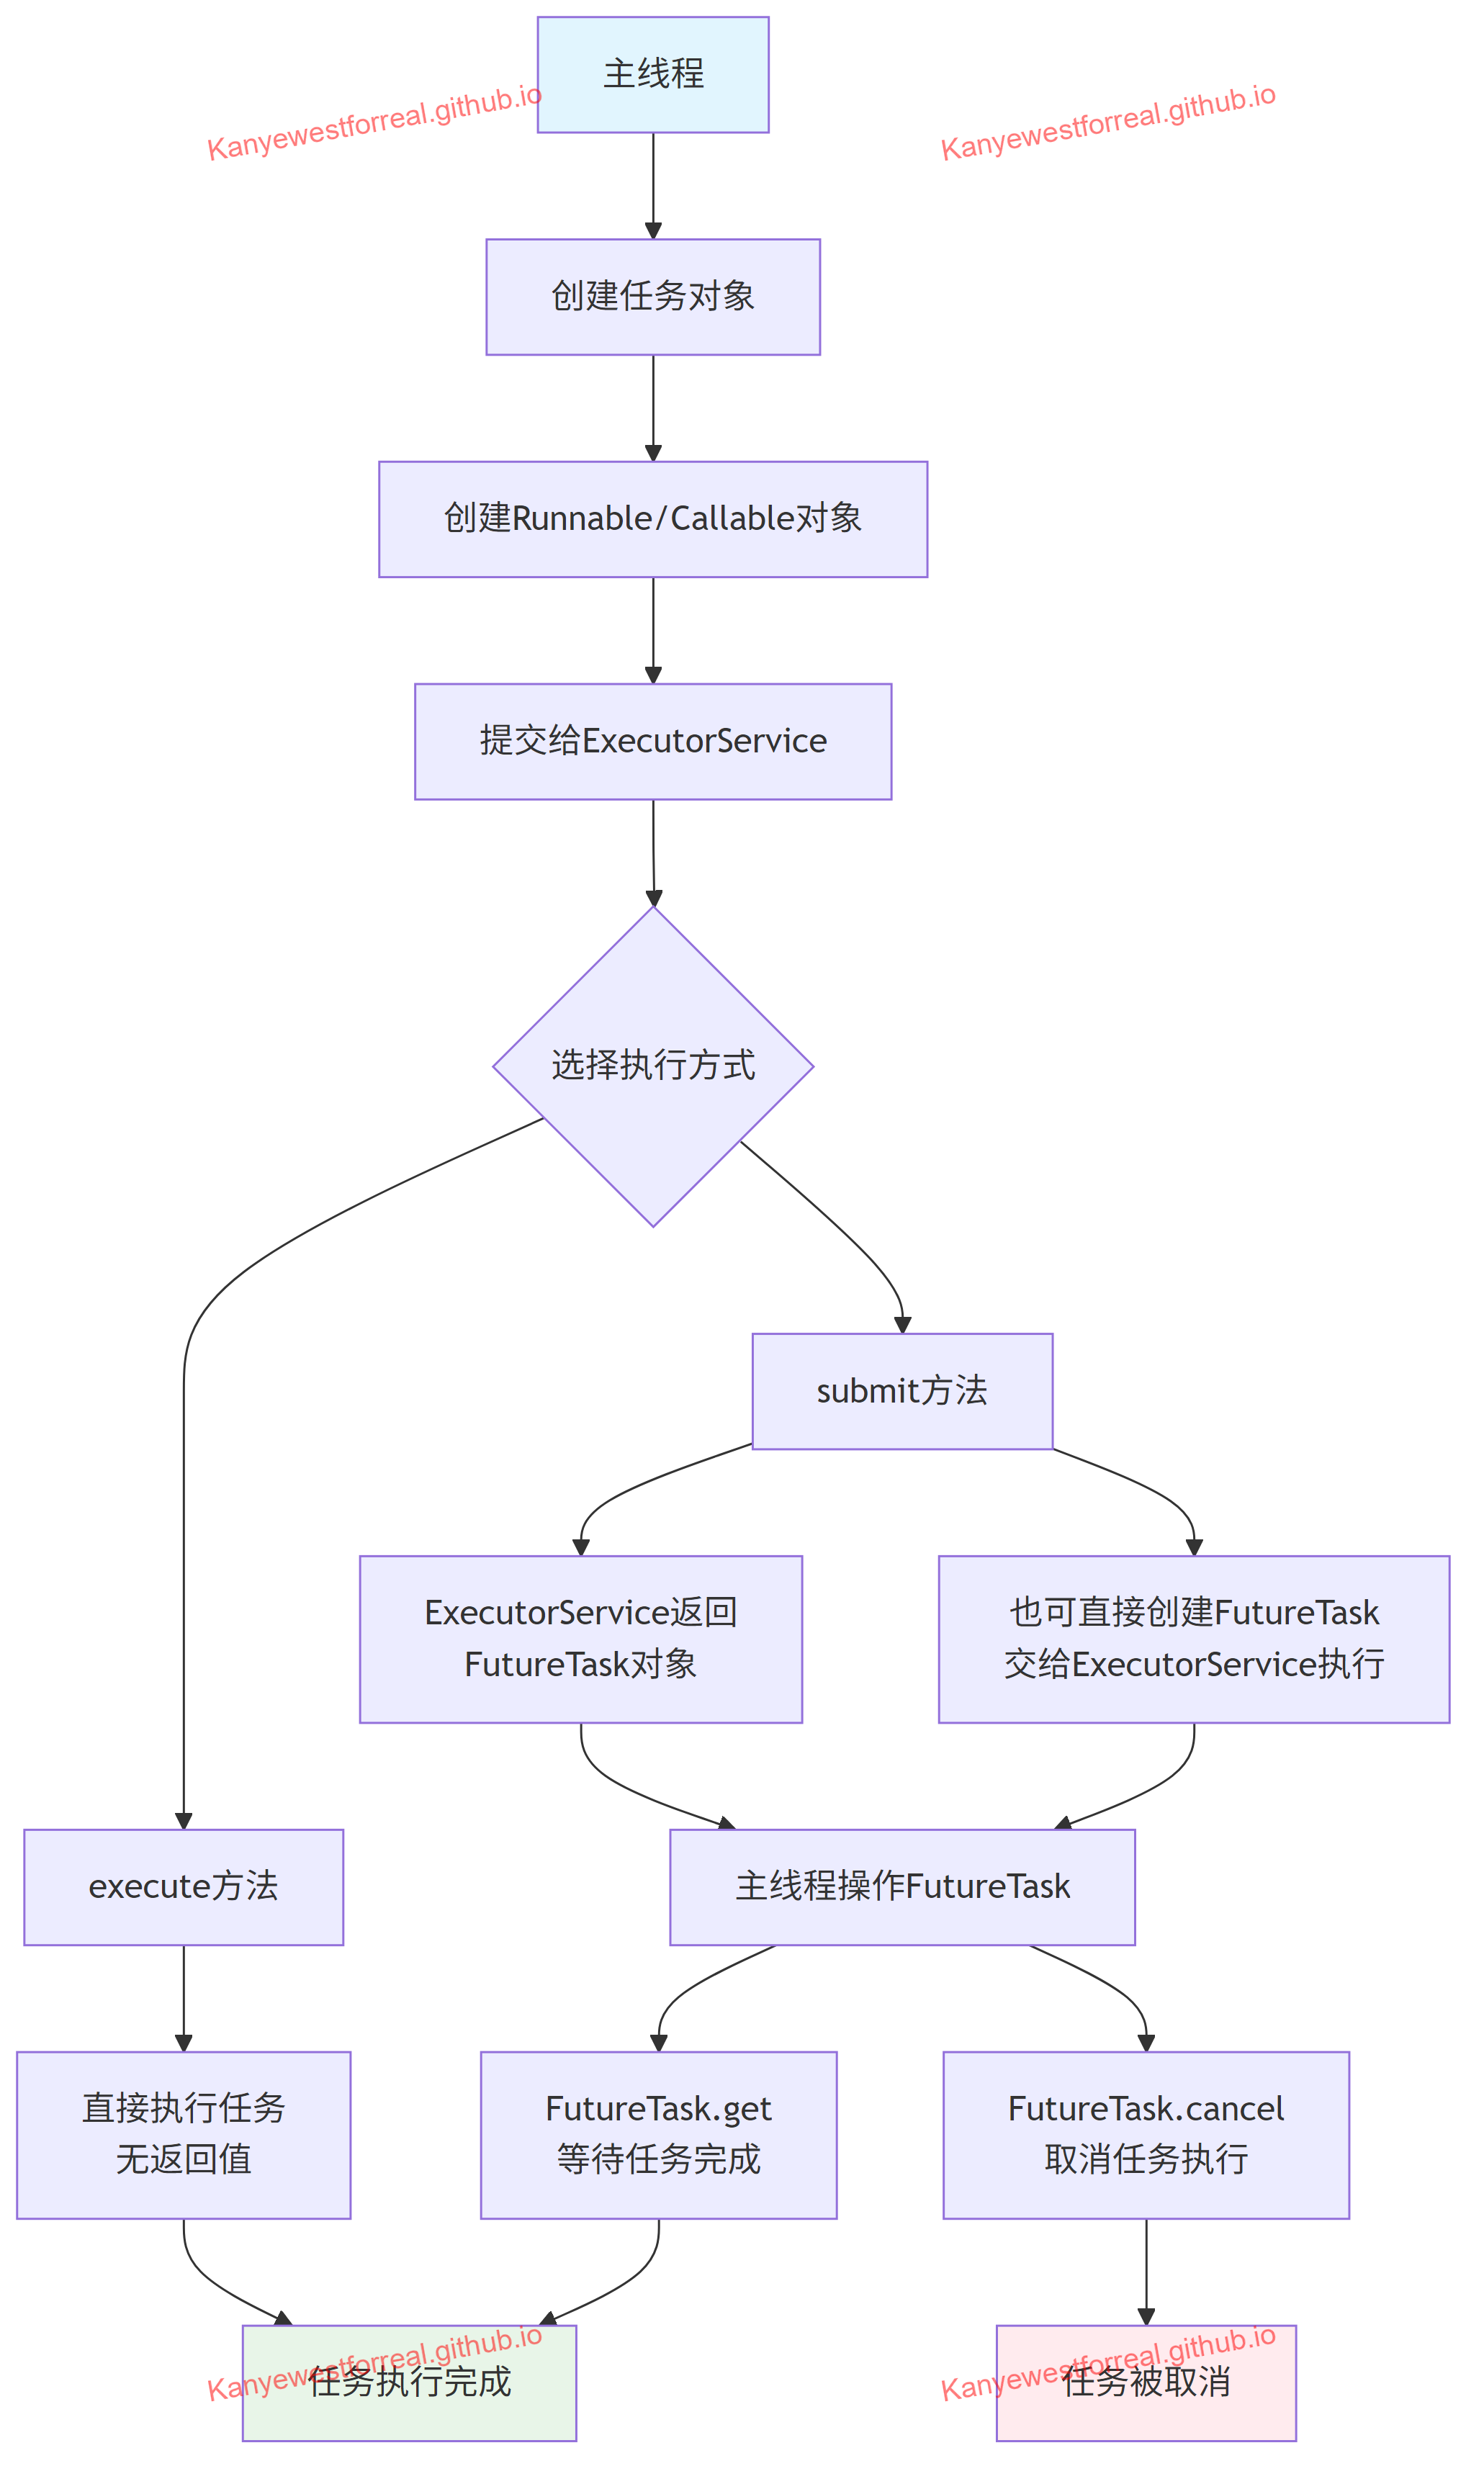
ThreadPoolExecutor
线程池实现类 ThreadPoolExecutor 是 Executor 框架最核心的类。
构造方法与参数分析
//使用给定的初始参数创建新的 ThreadPoolExecutor 。

public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory,
                          RejectedExecutionHandler handler) {
    if (corePoolSize < 0 ||
        maximumPoolSize <= 0 ||
        maximumPoolSize < corePoolSize ||
        keepAliveTime < 0)
        throw new IllegalArgumentException();
    if (workQueue == null || threadFactory == null || handler == null)
        throw new NullPointerException();
    this.corePoolSize = corePoolSize;
    this.maximumPoolSize = maximumPoolSize;
    this.workQueue = workQueue;
    this.keepAliveTime = unit.toNanos(keepAliveTime);
    this.threadFactory = threadFactory;
    this.handler = handler;
}
corePoolSize
线程池核心线程数量。
默认情况下,线程池中线程的数量如果 <= corePoolSize,那么即使这些线程处于空闲状态,那也不会被销毁。
maximumPoolSize
线程池能创建的最大线程总数(包括核心线程和非核心线程)。
当线程池的线程数量 > corePoolSize && 任务队列已满 && 当前线程数 < maximumPoolSize,就会创建新线程执行此任务。
但是当前线程数 > maximumPoolSize && 任务队列已满,就会执行拒绝策略。
workQueue
工作队列。新任务来的时候会先判断当前运行的线程数量是否达到核心线程数corePoolSize(是否有空闲的线程),如果达到的话,新任务就会被存放在队列中,等待执行。
keepAliveTime
当线程池中线程的数量大于corePoolSize,并且某个线程的空闲时间超过了keepAliveTime,那么这个线程就会被销毁。
有关线程池的核心线程回收机制:
ThreadPoolExecutor 默认不会回收核心线程,即使它们已经空闲了。这是为了减少创建线程的开销,因为核心线程通常是要长期保持活跃的。但是,如果线程池是被用于周期性使用的场景,且频率不高(周期之间有明显的空闲时间),可以考虑将 allowCoreThreadTimeOut(boolean value) 方法的参数设置为 true,这样就会回收空闲(时间间隔由 keepAliveTime 指定)的核心线程了。
unit
就是keepAliveTime时间的单位。
threadFactory
线程工厂。
handler
拒绝策略。当一个新任务交给线程池时,如果当前线程池中线程的数量 等于maximumPoolSize,就不会创建新线程,就会去执行拒绝策略。
ThreadPoolExecutor 定义的拒绝策略:
ThreadPoolExecutor.AbortPolicy:默认值。抛出RejectedExecutionException来拒绝新任务的处理。ThreadPoolExecutor.CallerRunsPolicy:将任务回退给调用者,使用调用者的线程来执行任务,如果调用者的线程已关闭,则会丢弃该任务。ThreadPoolExecutor.DiscardPolicy:不处理新任务,直接丢弃掉。ThreadPoolExecutor.DiscardOldestPolicy:此策略将丢弃最早的未处理的任务请求。
在提交任务前,可以提前创建线程吗?
ThreadPoolExecutor 提供了两个方法帮助我们在提交任务之前,完成核心线程的创建,从而实现线程池预热的效果:
prestartCoreThread():启动一个线程,等待任务,如果已达到核心线程数,这个方法返回 false,否则返回 true;prestartAllCoreThreads():启动所有的核心线程,并返回启动成功的核心线程数。
工作队列常见类
BlockingQueue (接口)
├── ArrayBlockingQueue
├── LinkedBlockingQueue
├── PriorityBlockingQueue
├── DelayQueue
├── SynchronousQueue
├── DelayedWorkQueue
└── LinkedTransferQueue
BlockingQueue
BlockingQueue<E> 是一个线程安全的队列,支持当队列为空时等待取元素、或当队列已满时等待放元素的操作,非常适合生产者-消费者场景。
放入元素
void put(E e)
队列已满时 阻塞 直到有空间或线程被中断;会抛InterruptedException。boolean offer(E e)
立即尝试放入,成功返回true,失败(满)返回false,不阻塞。boolean offer(E e, long timeout, TimeUnit unit)
在给定超时时间内等待空间,超时返回false,可抛InterruptedException。boolean add(E e)
继承自Queue,如果队列满会抛IllegalStateException(通常少用于有界队列)。
取出元素
E take()
队列为空时 阻塞 直到有元素可用或线程被中断;会抛InterruptedException。E poll()
立即取出并返回元素,若为空返回null(不阻塞)。E poll(long timeout, TimeUnit unit)
在给定超时时间内等待元素,超时返回null,可抛InterruptedException。E remove()/E element()
继承自Queue,空时会抛NoSuchElementException(少用)。
查看/辅助
E peek()
立即查看队首,空时返回null(不移除,也不阻塞)。int remainingCapacity()
返回还能插入多少元素(对有界队列有意义)。int drainTo(Collection<? super E> c)/int drainTo(Collection<? super E> c, int maxElements)
一次性把队列中尽可能多(或最多maxElements)元素移动到指定集合,常用于批量消费以减少开销。注意:在某些迭代器同步语义上可能有实现差异。
注意
阻塞方法 (put, take 等) 在等待期间可被中断,会抛 InterruptedException —— 调用方通常要处理中断。
带超时的方法 (offer/poll 带 timeout) 提供在阻塞等待时的时间限制。
立即返回的方法 (offer、poll、peek) 不会阻塞,适合非阻塞逻辑。
ArrayBlockingQueue
- 特点:基于数组的有界队列。按照FIFO原则对任务进行排序。由于队列有界,当线程池中的线程数达到corePoolSize后,新任务会放入队列,如果队列已满,则会创建新线程(直到达到maximumPoolSize),然后执行拒绝策略。
- 使用场景:适用于需要控制任务队列长度,防止内存溢出的场景。可以平衡吞吐量和资源消耗。
LinkedBlockingQueue
FixedThreadPool 和 SingleThreadExecutor使用。
- 特点:基于链表的无界队列(除非初始化时指定大小)。按照FIFO(先进先出)的原则对任务进行排序。由于它可以是无界的,所以当线程池中的线程数达到corePoolSize后,新任务都会放在队列中,而不会创建新线程直到队列被填满(无界队列永远不会填满,因此不会创建超过corePoolSize的线程)。
- 使用场景:适用于任务量波动较大,但不需要限制任务数量的场景。由于队列无界,可能会堆积大量任务,导致内存溢出。
- 注意:使用无界队列时,maximumPoolSize参数将无效,因为队列不会满,所以不会创建超过corePoolSize的线程。
PriorityBlockingQueue
- 特点:一个支持优先级排序的无界队列。任务按照优先级顺序被取出。优先级通过自然顺序或Comparator定义。
- 使用场景:适用于有任务优先级需求的场景。注意,它也是无界的,所以同样有内存溢出的风险。
- 注意:使用此队列时,任务类需要实现Comparable接口,或者在线程池构造时提供Comparator。
DelayQueue
- 特点:一个无界队列,用于存放实现了Delayed接口的任务。任务只有在指定的延迟时间到达后才能被取出。队列中的任务按照延迟时间排序,延迟时间到的任务先被取出。
- 使用场景:适用于定时任务和缓存过期的场景,如定时调度、缓存对象过期删除等。
- 注意:该队列也是无界的,因此可能存在内存溢出风险。
SynchronousQueue
newCachedThreadPool使用。
- 特点:这是一个不存储元素的阻塞队列。每个插入操作必须等待另一个线程的对应移除操作,反之亦然。因此,它实际上不维护任务队列,而是直接将任务交给线程执行。
- 使用场景:适用于线程数无限(newCachedThreadPool)或者可以创建很多线程的场景。当使用
SynchronousQueue时,如果现有线程无法接收任务(即线程池已达到最大线程数且没有空闲线程),则会尝试创建新的线程执行任务,如果超过最大线程数则执行拒绝策略。 - 注意:因为不存储任务,所以通常要求线程池的maximumPoolSize足够大,否则容易执行拒绝策略。
LinkedTransferQueue
- 特点:一个无界队列,基于链表结构。它实现了TransferQueue接口,提供了transfer和tryTransfer方法,可以将任务直接传递给消费者线程(如果有等待的消费者线程,则直接传递,否则放入队列)。
- 使用场景:适用于需要直接传递任务的场景,可以提高性能。
DelayedWorkQueue
专门为 ScheduledThreadPoolExecutor 设计。
- 特点:
DelayedWorkQueue的内部元素按照延迟的时间长短对任务进行排序,内部采用的是“堆”的数据结构,可以保证每次出队的任务都是当前队列中执行时间最靠前的。DelayedWorkQueue添加元素满了之后会自动扩容,即永远不会阻塞,最大扩容可达Integer.MAX_VALUE。 - 使用场景:在指定延迟后执行任务,例如启动后稍后执行某个操作;以及周期性地重复执行任务,例如每隔一段时间执行一次数据同步、日志清理或定时发送通知等。
LinkedBlockingDeque
- 特点:基于链表的双端队列。可以在队列的两端插入和移除任务。因此,它既可以作为FIFO队列使用,也可以作为LIFO队列(栈)使用。
- 使用场景:适用于工作窃取(work-stealing)算法,或者需要从队列两端操作任务的场景。
线程池创建的两种方式
通过 ThreadPoolExecutor 构造函数创建
允许开发者明确指定线程池的核心参数,对线程池的运行行为有更精细的控制,从而避免资源耗尽的风险。
通过 Executors 工具类创建(不推荐)
通过Executors工具类可以创建多种类型的线程池,包括:
FixedThreadPool:固定线程数量的线程池。该线程池中的线程数量始终不变。当有一个新的任务提交时,线程池中若有空闲线程,则立即执行。若没有,则新的任务会被暂存在一个任务队列中,待有线程空闲时,便处理在任务队列中的任务。SingleThreadExecutor: 只有一个线程的线程池。若多余一个任务被提交到该线程池,任务会被保存在一个任务队列中,待线程空闲,按先入先出的顺序执行队列中的任务。CachedThreadPool: 可根据实际情况调整线程数量的线程池。若所有线程均在工作,又有新的任务提交,则会创建新的线程处理任务。所有线程在当前任务执行完毕后,将返回线程池进行复用。ScheduledThreadPool:给定的延迟后运行任务或者定期执行任务的线程池。
生产中建议不要使用Executors工具类创建线程池:
FixedThreadPool 和 SingleThreadExecutor:使用的是阻塞队列 LinkedBlockingQueue,任务队列最大长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。
CachedThreadPool:使用的是同步队列 SynchronousQueue, 允许创建的线程数量为 Integer.MAX_VALUE ,如果任务数量过多且执行速度较慢,可能会创建大量的线程,从而导致 OOM。
ScheduledThreadPool 和 SingleThreadScheduledExecutor:使用的无界的延迟阻塞队列DelayedWorkQueue,任务队列最大长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。
Executor 关键源码
Doug Lea 教授编写Executor时,考虑的情况十分周全,比如各种可能失败的情况都考虑了,导致控制流十分复杂,需要一定的阅读能力。
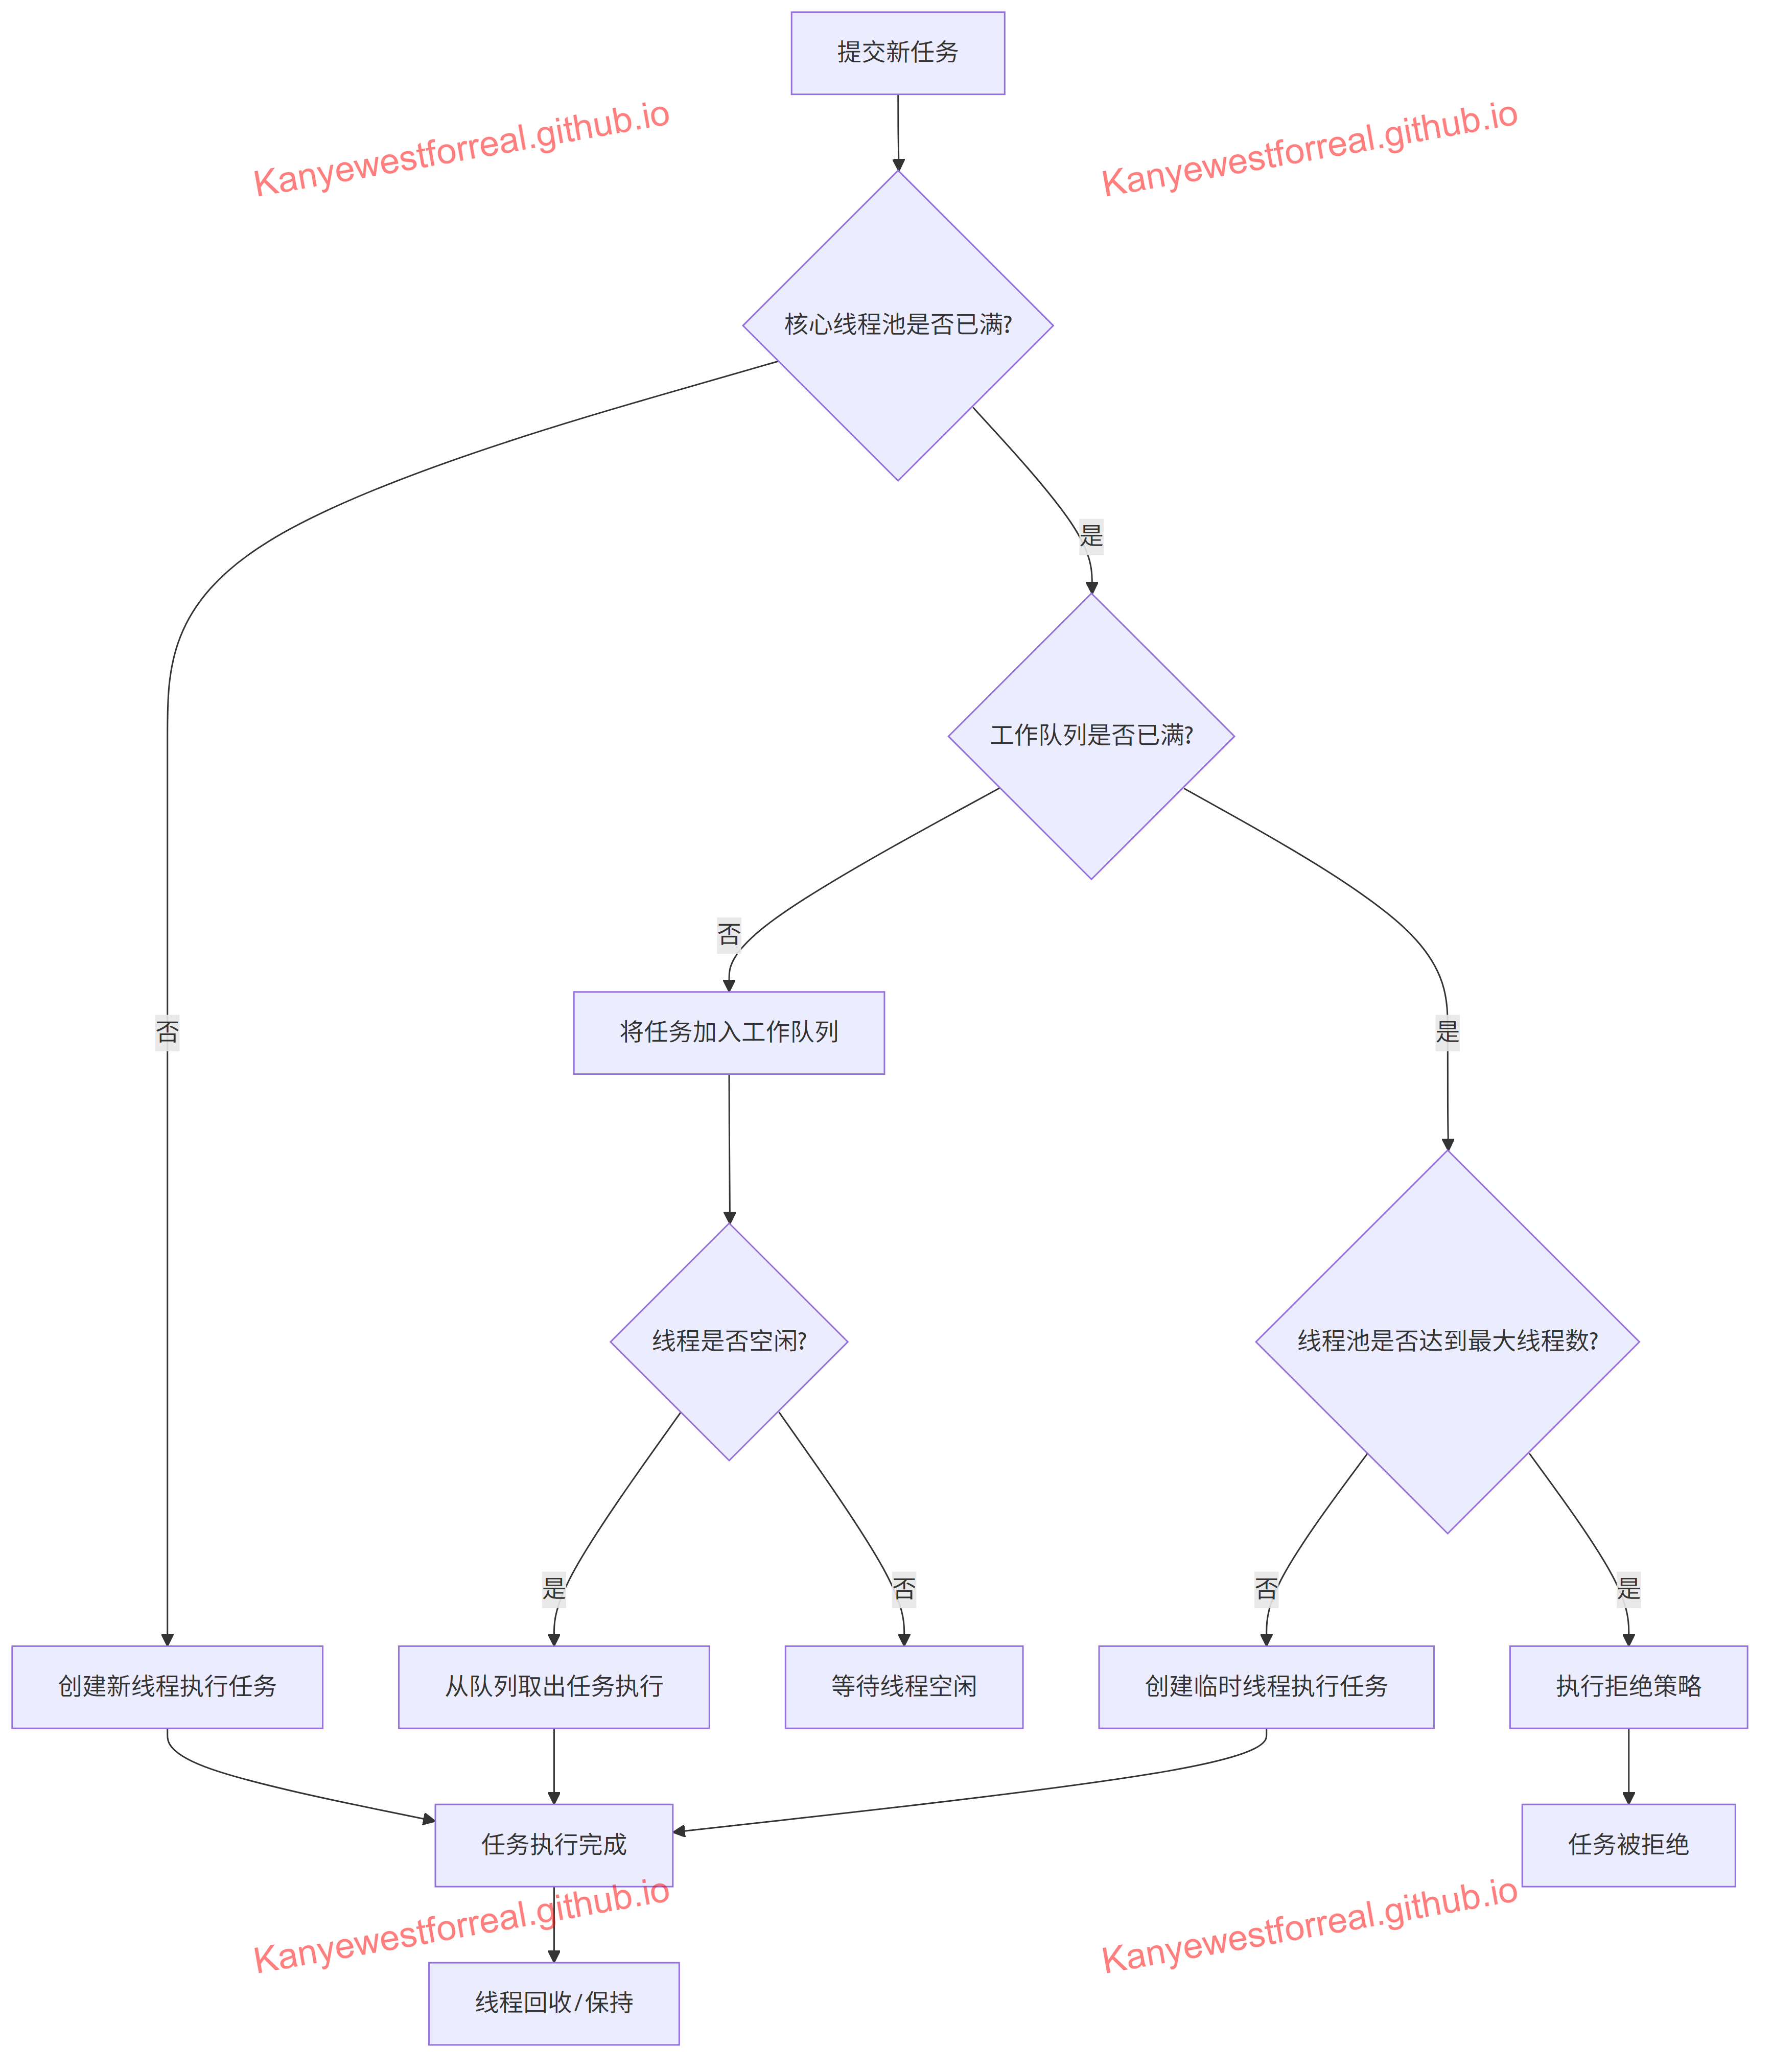
Executor#execute工作流程
略微简化的工作流程图,省略了失败情况。
ctl
ctl 是 AtomicInteger,高位存放线程池状态 runState(RUNNING, SHUTDOWN, STOP, TIDYING, TERMINATED),低位存放当前线程数 workerCount。
这种压缩可以仅用单次 CAS 实现同步“状态 + 计数”。这是实现轻量级的安全计数与状态检查的关键设计。
//ThreadPoolExecutor
private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));
private static final int COUNT_BITS = Integer.SIZE - 3;
private static final int COUNT_MASK = (1 << COUNT_BITS) - 1;

// runState is stored in the high-order bits
//运行中状态,可以接收新的任务和执行任务队列中的任务
private static final int RUNNING    = -1 << COUNT_BITS;
//shutdown 状态,不再接收新的任务,但是会执行任务队列中的任务
private static final int SHUTDOWN   =  0 << COUNT_BITS;
//停止状态,不再接收新的任务,也不会执行任务队列中的任务,中断所有执行中的任务
private static final int STOP       =  1 << COUNT_BITS;
//整理中状态,所有任务已经终结,工作线程数为 0,过渡到此状态的工作线程接下来会调用钩子方法terminated()
private static final int TIDYING    =  2 << COUNT_BITS;
//终结状态,钩子方法terminated()执行完毕
private static final int TERMINATED =  3 << COUNT_BITS;

// Packing and unpacking ctl
private static int runStateOf(int c)     { return c & ~COUNT_MASK; }
private static int workerCountOf(int c)  { return c & COUNT_MASK; }
private static int ctlOf(int rs, int wc) { return rs | wc; }
execute
//ThreadPoolExecutor#executor
public void execute(Runnable command) {
    //fast-fail
    if (command == null)
        throw new NullPointerException();

    //读取 ctl 的当前值(state + workerCount 的组合)。
    //不是加锁,只是快路径读,降低竞争。
    int c = ctl.get();
    if (workerCountOf(c) < corePoolSize) {
        //如果当前线程数少于 corePoolSize,
        //优先尝试立刻创建一个新线程,并把 command 作为该线程的 firstTask 去执行
        //addWorker(..., true) true表示按 corePoolSize 限制
        //addWorker如果返回 true 说明创建和启动工作线程成功,否则返回 false。
        if (addWorker(command, true))
            //线程创建成功,返回
            return;
        //没有返回,再读一次ctl
        //addWorker 失败(并发竞争、状态变更等),重新读取最新状态再走后续分支。
        c = ctl.get();
    }
    //以下if else-if 处理:
    //当线程数已达 corePoolSize || (当线程数未达 corePoolSize && 创建线程失败)。

    //如果池正在运行 && 尝试把任务放入队列成功。
    //注意 offer 而非 put,避免调用者线程被阻塞。
    if (isRunning(c) && workQueue.offer(command)) {
        //再读一次 ctl,用于防止竞态
        int recheck = ctl.get();

        if (! isRunning(recheck) && remove(command))
            //如果在 offer 之后线程池已不再 RUNNING(比如正在 shutdown),
        	//尝试把刚放进去的任务从队列移除它:remove(command) ,如果移除成功返回true
            //如果失败,说明可能其它线程已经把队列中的任务取走
            //若移除成功才调用 reject
            reject(command);

       	// 处理: 池还在运行 && 没有线程workerCount==0
        // 预防 最后一次检查之后所有存活的工作线程已经终结 的情况
        // 但任务放入了队列,那就尝试创建一个非 core(即按 maximumPoolSize)线程去消费任务队列
        // addWorker firstTask 为 null,线程会从任务队列阻塞地take()任务。
        // 确保不会饿死。
        else if (workerCountOf(recheck) == 0)
            addWorker(null, false);
    }
    //处理: 池不在运行 || 任务放入队列失败
    //false 尝试创建非core 线程,执行command
    else if (!addWorker(command, false))
        //创建非core失败,拒绝
        reject(command);
}
优先创建 core 线程 → 将多余任务入队 → 在队列满时扩到 max 线程 → 最终拒绝。这是 ThreadPoolExecutor 的经典三阶策略。
submit
包装返回FutureTask,本质上还是调用了Executor#execute。
//ExecutorService#submit
public <T> Future<T> submit(Callable<T> task) {
    if (task == null) throw new NullPointerException();
    RunnableFuture<T> ftask = newTaskFor(task);
    execute(ftask);
    return ftask;
}
addWorker
核心目标:原子地(在并发条件下)增加 workerCount、创建 Worker、把 Worker 加入集合并启动对应 Thread。要做很多检查以保证状态正确性与并发安全。
//ThreadPoolExecutor#addWorker
private boolean addWorker(Runnable firstTask, boolean core) {
    //for + retry 标签:允许在状态改变时重新从外层判断做起。
    retry:
    //这是个死循环
    //读 ctl
    for (int c = ctl.get();;) {
        // Check if queue empty only if necessary.
        //fast-fail
        //如果 runState 已到 SHUTDOWN 及以上(不再是 RUNNING)
        // && 满足下面任一:
		//1.runState 已到 STOP(要强制停止,不能创建新 worker)
        //2.firstTask != null(有要立即执行的任务,但池处于 SHUTDOWN,这种情况下不接受新任务以避免运行新提交的任务)
        //3.workQueue.isEmpty()(如果队列为空也不用创建新线程)
		// 那么返回false 不创建新线程,保证 shutdown 语义
        if (runStateAtLeast(c, SHUTDOWN)
            && (runStateAtLeast(c, STOP)
                || firstTask != null
                || workQueue.isEmpty()))
            return false;

        //这是个死循环
        //内循环做两件事:
		//1.检查是否已经达到允许的线程上限(如果 core==true 用 corePoolSize 限制,否则 maximumPoolSize)。
        //如果达上限返回 false。这防止超出配置。
        //( & COUNT_MASK 是为了取低位 workerCount 有效范围)
        //2.尝试通过 CAS 把 workerCount 增 1(并且保持 runState 不变)。
        //CAS成功就跳出重试并继续创建线程。
		//如果 CAS 失败,重新读 ctl 并检查 runState 是否在此期间变为 SHUTDOWN 等;
        //若是则 continue retry(回到外层重新检查fast-fail),否则继续内循环尝试。
        for (;;) {
            if (workerCountOf(c)
                >= ((core ? corePoolSize : maximumPoolSize) & COUNT_MASK))
                return false;
            if (compareAndIncrementWorkerCount(c))
                break retry;
            c = ctl.get();  // Re-read ctl
            if (runStateAtLeast(c, SHUTDOWN))
                continue retry;
        }
    }

    //线程/Worker 的构造与注册(非原子,需要锁保护 workers 集合)
    boolean workerStarted = false;
    boolean workerAdded = false;
    Worker w = null;
    try {
        //Worker 的构造会创建一个 Thread(通常使用 ThreadFactory.newThread(w)),
        //并把 firstTask 存进 Worker。
        //注意 w.thread 可能为 null(ThreadFactory 可能返回 null 或抛异常)。
        //把 Thread 启动放在锁外,避免死锁与降低锁持有时间。
        w = new Worker(firstTask);
        final Thread t = w.thread;
        if (t != null) {
            final ReentrantLock mainLock = this.mainLock;
            mainLock.lock();
            //在把 w 真正加入 workers 集合前需要持 mainLock,
            //保证对 workers 的更新与 largestPoolSize 更新等是受保护的(避免竞态)
            try {
                //在获取 mainLock 期间 ctl 可能变化,
                //必须确保当前池状态仍允许把这个 worker 加入(例如在拿锁前池可能被 shutdown)。
                //这是防止 race 的必要 recheck。
                int c = ctl.get();

                //允许把 worker 加入的条件:
                //池仍在 RUNNING || (池处于 SHUTDOWN 但尚未到 STOP && firstTask==null(允许用新线程去清空队列中已有的任务))
                //和 execute 中 addWorker 对应。
                if (isRunning(c) ||
                    (runStateLessThan(c, STOP) && firstTask == null)) {
                    //确保线程尚未启动
                    if (t.getState() != Thread.State.NEW)
                        throw new IllegalThreadStateException();
                    workers.add(w);
                    workerAdded = true;
                    int s = workers.size();
                    if (s > largestPoolSize)
                        largestPoolSize = s;
                }
            } finally {
                //释放锁
                mainLock.unlock();
            }
            //t.start() 放在锁外,避免在启动线程时持锁以降低锁持有时间与死锁风险
            if (workerAdded) {
                //!!! 在这里启动了线程
                //线程会执行 w.run() 即 runWorker
                t.start();
                workerStarted = true;
            }
        }
    } finally {
        //如果线程没能成功启动或发生异常,需要回滚:addWorkerFailed
        //会把 workerCount 减回去,移除 workers 集合中的 w。
        //保证 workerCount 与 workers 集合一致性。
        if (! workerStarted)
            addWorkerFailed(w);
    }
    //成功启动线程则返回 true
    return workerStarted;
}

//Worker构造函数
//Worker继承了AQS
Worker(Runnable firstTask) {
    //使用AQS
    setState(-1); // 上锁,禁止中断interrupt,直到 runWorker
    this.firstTask = firstTask;
    this.thread = getThreadFactory().newThread(this);
}
getTask
Worker 从队列获取下一个任务或决定退出。
private Runnable getTask() {
    //timedOut:记录上一次 poll 是否超时(用于判断是否需要回收线程)
    boolean timedOut = false;
	//这是个死循环
    for (;;) {
        int c = ctl.get();

        //如果池已经 SHUTDOWN 且( 已经STOP || 队列为空)
        //应该退出并减少 workerCount(decrementWorkerCount())
        //返回 null 表示线程要终止。
        //目的是遵守 shut down 语义:SHUTDOWN 时清空队列后终止;STOP 立即停止。
        if (runStateAtLeast(c, SHUTDOWN)
            && (runStateAtLeast(c, STOP) || workQueue.isEmpty())) {
            decrementWorkerCount();
            return null;
        }

        int wc = workerCountOf(c);

        //timed 表示当前 worker 是否受“超时回收”策略控制:
        //如果 allowCoreThreadTimeOut==true(允许 core 线程也超时回收)
        //或
        //当前线程数 wc 超过 corePoolSize(即额外线程可以被回收),则 timed=true。
        boolean timed = allowCoreThreadTimeOut || wc > corePoolSize;

        //如果 wc > maximumPoolSize(不常见,防御性;有可能因为配置变化导致)
        // ||
        ///timed && timedOut(线程超时过 && 允许回收)
        // &&
        //wc > 1 (线程数量大于1,那么退出至少还有1个线程) || workQueue.isEmpty(),
        //则尝试使用 CAS 把 workerCount 减 1。
        //CAS成功则返回 null(结束当前线程)。如果 CAS 失败则 continue 重试
        if ((wc > maximumPoolSize || (timed && timedOut))
            && (wc > 1 || workQueue.isEmpty())) {
            if (compareAndDecrementWorkerCount(c))
                return null;
            continue;
        }

        //如果不满足退出条件,则从队列获取任务:
		//如果 timed(允许超时回收)则用 poll(timeout):会在超时后返回 null,下次循环触发上面的超时逻辑;
		//否则使用 take()(阻塞直到有任务)
        try {
            Runnable r = timed ?
                workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) :
                workQueue.take();
            //如果取到 r != null 就返回任务,供 runWorker 执行
            if (r != null)
                return r;
            timedOut = true;
        } catch (InterruptedException retry) {
            //如果线程在 poll/take 中被中断,则把 timedOut=false 并继续循环
            //(中断通常说明需要重新检查状态,例如 池变为shutdown)
            //把超时标志清零是防止误把中断当成超时导致退出。
            timedOut = false;
        }
    }
}
runWorker
Worker 的主循环执行体,线程池线程一直持续运行该方法。
//ThreadPoolExecutor#runWorker
final void runWorker(Worker w) {
    // 注意:调用runWorker的都是线程池里的线程了
    Thread wt = Thread.currentThread();
    //获取 firstTask,并置空。
    //firstTask 仅供 Worker 启动时一次性使用(避免重复执行)
    Runnable task = w.firstTask;
    w.firstTask = null;
    //见上,Woker构造时通过AQS上锁,现在解锁
    w.unlock();
    //标志位:是否因为异常或线程意外终止而退出循环。
    //初始化为 true,正常循环结束会把它设为 false
    boolean completedAbruptly = true;
    try {
        //执行 firstTask(若有),然后
        //无限循环! 从队列 getTask() 获取新任务,
        //直到 getTask() 返回 null(表示池要关闭且该线程应退出)
        while (task != null || (task = getTask()) != null) {
            //再次上锁
            w.lock();
            //如果 池已到 STOP 或更高 ||
            //当前线程已经被 interrupt() && runState 已到 STOP (再次检查) && 并且当前线程没有设置中断标志
            if ((runStateAtLeast(ctl.get(), STOP) ||
                 (Thread.interrupted() &&
                  runStateAtLeast(ctl.get(), STOP))) &&
                !wt.isInterrupted()){
                //确保当池进入 STOP 时,线程会被设置为中断状态;
            	//在某些情况下可能已被别处清除了中断标志(上面interrupted()就清除了一次)
                //所以需要恢复wt中断状态标识
                wt.interrupt();
            }
            try {
                //hook 可以在任务执行前做日志/计时/上下文设置等。
                beforeExecute(wt, task);
                try {
                    task.run();
                    //任务执行后的钩子,允许记录异常、清理上下文等。
                    afterExecute(task, null);
                } catch (Throwable ex) {
                    afterExecute(task, ex);
                    //这里重抛异常以保留外层逻辑对异常的处理
                    throw ex;
                }
            } finally {
                task = null;
                w.completedTasks++;
                w.unlock();
            }
        }
        //走到这算没有出现异常,否则会因为上面的throw 执行下面的finally
        completedAbruptly = false;
    } finally {
        //getTask() 返回 null 表示 Worker要退出了
        //可能是正常结束,或者因异常中断。
        //completedAbruptly 表示该线程是否是“异常中断/非正常退出”
        //这个标志影响是否需要先调整 workerCount。
        processWorkerExit(w, completedAbruptly);
    }
}

private void processWorkerExit(Worker w, boolean completedAbruptly) {
        if (completedAbruptly) // If abrupt, then workerCount wasn't adjusted
            decrementWorkerCount();

        final ReentrantLock mainLock = this.mainLock;
        mainLock.lock();
        try {
            //移除worker
            completedTaskCount += w.completedTasks;
            workers.remove(w);
        } finally {
            mainLock.unlock();
        }

        tryTerminate();

        int c = ctl.get();
        if (runStateLessThan(c, STOP)) {
            if (!completedAbruptly) {
                //计算在当前配置下“应该保留的最小线程数(min)”。
				//如果允许 core 线程超时回收(allowCoreThreadTimeOut == true)
                //则 min = 0(核心线程也可以被回收)。
				//否则要保留 corePoolSize 个线程。
                int min = allowCoreThreadTimeOut ? 0 : corePoolSize;
                //当 min == 0(即允许 core 超时回收),但队列 非空 时,把 min 提升到 1
                //防止饿死
                if (min == 0 && ! workQueue.isEmpty())
                    min = 1;
                //当前(快照)workerCount 已经 >= 上面计算的 min,说明不需要补线程,直接返回
                if (workerCountOf(c) >= min)
                    return;
            }
            //是异常退出 || 当 workerCountOf(c) < min 时
            //补充线程
            addWorker(null, false);
        }
    }
shutdown
平滑关闭:不再接受新任务 -> 清理空闲线程 -> 完成队列中任务
//ThreadPoolExecutor#shutdown
public void shutdown() {
    final ReentrantLock mainLock = this.mainLock;
    //修改线程池的状态需要加锁,保护对 workers 集合与状态的一致修改。
    mainLock.lock();
    try {
        checkShutdownAccess();
        //把 runState 推到 SHUTDOWN(但不立即中断正在运行的线程)
        advanceRunState(SHUTDOWN);
        //中断那些空闲的worker,使它们从 take() 中返回或响应中断,从而加速 shutdown。
        //如果某些线程正在执行任务,则不会马上被中断
        //(在 SHUTDOWN 时通常不会 interrupt 正在运行的任务,这与 STOP 不同)。
        interruptIdleWorkers();
        onShutdown(); // hook for ScheduledThreadPoolExecutor
    } finally {
        mainLock.unlock();
    }
    //检查是否满足终止条件(workers 都退出且队列为空等)
    //如果满足则推进到 TIDYING/TERMINATED 并通知等待的线程/回调。
    tryTerminate();
}
比较
ScheduledThreadPoolExecutor vs Timer
| 特性/维度 | Timer |
ScheduledThreadPoolExecutor |
|---|---|---|
| 底层架构 | 单线程 | 线程池(可配置核心线程数) |
| 任务执行 | 顺序执行,相互阻塞 | 并发执行,互不干扰(默认) |
| 异常处理 | 一个任务抛出未捕获异常,整个 Timer 线程终止,导致其他任务无法执行。 | 某个任务的异常不会影响线程池中其他线程,其他任务照常执行。 |
| 时间基准 | 基于绝对时间(Date),对系统时钟敏感。 |
基于相对时间,对系统时钟变化不敏感。 |
| 灵活性 | 低,只能执行 TimerTask。 |
高,可以执行 Runnable、Callable,功能更丰富(如获取 Future)。 |
| 精确性 | 依赖于前一个任务的执行时间,如果前一个任务耗时,后续任务会延迟。 | 更精确,因为多个线程可以同时执行,减少了任务间的相互影响。 |
| 资源管理 | 差,无法复用线程,创建和销毁开销大。 | 优秀,利用线程池,有效管理资源。 |
| JDK 版本 | 从 JDK 1.3 开始 | 从 JDK 1.5 开始(作为 java.util.concurrent 的一部分) |
| 推荐度 | 不推荐使用 | 推荐 |
Runnable vs Callable+Future
Runnable 接口不会返回结果或抛出检查异常,但是使用 Callable 接口可以返回结果和抛出异常。所以,如果任务不需要返回结果或抛出异常,可以使用 Runnable 接口,这样代码看起来会更加简洁。
execute() vs submit()
execute() 和 submit()是两种提交任务到线程池的方法,有一些区别:
返回值:
execute() 方法用于提交不需要返回值的任务。无法判断任务是否被线程池成功执行。可以提交 Runnable任务。
submit() 方法用于提交需要返回值的任务。可以提交 Runnable 或 Callable 任务。
submit() 方法返回一个 Future 对象,通过这个 Future 对象可以判断任务是否执行成功,并使用get方法获取任务的返回值(get()方法会阻塞当前线程直到任务完成, get(long timeout,TimeUnit unit)多了一个超时时间,如果在 timeout 时间内任务还没有执行完,就会抛出 java.util.concurrent.TimeoutException)。
异常处理:
在使用 submit() 方法时,可以通过 Future 对象处理任务执行过程中抛出的异常;
请注意,在使用 execute() 方法时,异常处理需要通过自定义的 ThreadFactory (在线程工厂创建线程的时候设置UncaughtExceptionHandler对象来 处理异常)或 ThreadPoolExecutor 的 afterExecute() 方法来处理。
shutdown() vs shutdownNow()
shutdown():关闭线程池,线程池的状态变为SHUTDOWN。线程池不再接受新任务了,但是队列里的任务得执行完毕。shutdownNow():关闭线程池,线程池的状态变为STOP。线程池会终止当前正在运行的任务,并停止处理排队的任务并返回正在等待执行的 List。
isTerminated() vs isShutdown()
isShutDown当调用shutdown()方法后返回为 true。isTerminated当调用shutdown()方法后,并且所有提交的任务完成后返回为 true
实践建议
线程池数量
如果我们设置的线程池数量太小的话,如果同一时间有大量任务/请求需要处理,可能会导致大量的请求/任务在任务队列中排队等待执行,甚至会出现任务队列满了之后任务/请求无法处理的情况,或者大量任务堆积在任务队列导致 OOM。这样很明显是有问题的,CPU 根本没有得到充分利用。
如果我们设置线程数量太大,大量线程可能会同时在争取 CPU 资源,这样会导致大量的上下文切换,从而增加线程的执行时间,影响了整体执行效率。
不同类别的业务用不同的线程池
不同类别的业务,可能线程耗时不一样。
所以配置时的核心线程数量、最大线程数量不一样。
以及不同业务对拒绝策略的容忍度不同。
只有合适的配置,才能发挥线程池应该起到的作用。
Demo:
ExecutorService pool = Executors.newFixedThreadPool(5); // 只有 5 个线程

//父任务
for(int i = 0;i<5;i++){
    pool.submit(() -> {
        System.out.println("parent start");
        Future<?> f = pool.submit(() -> {
            //子任务
            System.out.println("child running");
        });
        try {
            //等待 child 完成
            //但如果 pool 的所有线程已被 parent 占用,那么 child 无法执行,永远阻塞!
            // parent 依赖 child 完成,才能结束,但是child无法开始!
            f.get();
        } catch (Exception e) { e.printStackTrace(); }
        System.out.println("parent end");
    });
}
线程池命名
线程池虽然不支持直接命名。但是创建线程池时,可以传入自定义的线程工厂,来给线程池内所有线程命名标记。
关闭线程池务必记得关闭
负责耗时任务的线程池,需要重点配置
不应该将耗时任务与快速任务混在同一个核心线程池中执行。
一般配置选用 小核心线程数量、有界队列。
线程池和ThreadLocal公用导致的数据污染
详细见下。
ThreadLocal
ThreadLocal给每个线程提供“独立的变量副本”,即 变量 在不同线程里可以有不同的值而互不干扰。每个线程只能访问自己的副本。
**每个 Thread 有一个 ThreadLocalMap,由 ThreadLocal 对象作为 key(弱引用)来索引对应的 变量。**线程(Thread)持有实际的 map(threadLocals),而不是 ThreadLocal 持有全部线程的数据。ThreadLocal 只是作为 key,用来访问当前线程的map。
调用流程
Thread Scope{
    → ThreadLocal.get()
        → ThreadLocalMap map = getMap(Thread)
        → map.getEntry(ThreadLocal)
            → searching Map for Entry
        	→ return Entry(WeakReference<ThreadLocal>, value)
        return Entry.value
}
弱引用(WeakReference)作为 key 的影响:
当应用不再持有 ThreadLocal 对象时,Key 可以被 GC 回收。
但是回收后 map 中会留下 Entry(key==null)这个条目对象。由于 value 是强引用,如果不清理,value 会一直被Entry(线程)所持有,导致内存泄漏(尤其当 Thread 是长存活线程如线程池线程时)。
因此,GC发起后,如果WeakReference<ThreadLocal> key被回收,但是value被Entry强引用,value不会被回收。
所以需要ThreadLocalMap 在get/set/remove、扩容、或遇到 stale entry 时,运行 expungeStaleEntry 清理并压缩表。
ThreadLocal关键实现
核心数据结构
private final int threadLocalHashCode = nextHashCode();

private static final int HASH_INCREMENT = 0x61c88647;
private static AtomicInteger nextHashCode = new AtomicInteger();
private static int nextHashCode() {
    return nextHashCode.getAndAdd(HASH_INCREMENT);
}
ThreadLocal使用斐波那契散列(0x61c88647是2^32 * (√5-1)/2的十六进制近似)。
每当创建一个ThreadLocal对象,这个ThreadLocal.nextHashCode 这个值就会增长 0x61c88647 。
因此ThreadLocal作为ThreadLocalMap Entry的Key时,在Map的 2^k 容量下能够均匀分布,减少哈希冲突。
为什么index不是简单自增+1?:自增+1可能会导致连续 key 冲突,很不均衡;乘增(固定非1步长)可以把线性序号映射成较均匀的索引。
get
快路径:取当前线程 map = getMap(t);
如果 map != null,调用 map.getEntry(this) 尝试直接通过 hash 位置查找,即fast path:尝试直接索引命中:
- 命中则返回
e.value(带类型转换)。 - 未命中走
getEntryAfterMiss(...),沿Map线性查找:遇到 stale entry 会触发expungeStaleEntry(i)清理。
若没找到会调用 setInitialValue(),内部会调用 initialValue()(用户可重写或用 withInitial 提供 Supplier)。
ThreadLocalMap getMap(Thread t) {
	return t.threadLocals;
}

//自增1,用于搜索,len是防止越界
private static int nextIndex(int i, int len) {
    return ((i + 1 < len) ? i + 1 : 0);
}


private static int prevIndex(int i, int len) {
    return ((i - 1 >= 0) ? i - 1 : len - 1);
}

public T get() {
    Thread t = Thread.currentThread();
    // 获取当前线程的ThreadLocalMap
    ThreadLocalMap map = getMap(t);
    if (map != null) {
        //传入this(ThreadLocal)作为Key,获取Entry
        ThreadLocalMap.Entry e = map.getEntry(this);
        if (e != null) {
            return (T)e.value;
        }
    }
    return setInitialValue();
}

private Entry getEntry(ThreadLocal<?> key) {
    //计算理论上hash
    int i = key.threadLocalHashCode & (table.length - 1);
    Entry e = table[i];
    // Android-changed: Use refersTo().
    // 是否命中
    if (e != null && e.refersTo(key))
        return e;
    else
        return getEntryAfterMiss(key, i, e);
}

//未命中
private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) {
    Entry[] tab = table;
    int len = tab.length;
	//线性遍历
    while (e != null) {
        // Android-changed: Use refersTo() (twice).
        //命中
        if (e.refersTo(key))
            return e;
        //找到过期、陈旧的Entry(ThreadLocal Key已经被GC)
        if (e.refersTo(null))
            //清理
            expungeStaleEntry(i);
        else
            //没命中、没找到stale entry,i+1,线性遍历
            i = nextIndex(i, len);
        e = tab[i];
    }
    //线性遍历完还是没找到,说明:1.没有,需要set 2.Map没有初始化
    return null;
}

private T setInitialValue() {
    // 使用ThreadLcoal 有两种使用方法
    // 1.静态方法withInital(S s) 返回ThreadLocal<S>
    // 2.实现模板方法initialValue 返回初始Value
    T value = initialValue();
    Thread t = Thread.currentThread();
    ThreadLocalMap map = getMap(t);
    if (map != null) {
        map.set(this, value);
    } else {
        createMap(t, value); //懒加载
    }
    return value;
}

void createMap(Thread t, T firstValue) {
    t.threadLocals = new ThreadLocalMap(this, firstValue);
}
initialValue
initialValue():默认返回 null;常见用法是匿名子类重写该方法,或使用 withInitial。
withInitial(Supplier):从 Java 8 引入的便捷工厂,返回一个 SuppliedThreadLocal,其 initialValue() 由 supplier 提供。
protected T initialValue() {
    return null;
}

public static <S> ThreadLocal<S> withInitial(Supplier<? extends S> supplier) {
    return new SuppliedThreadLocal<>(supplier);
}

static final class SuppliedThreadLocal<T> extends ThreadLocal<T> {

    private final Supplier<? extends T> supplier;

    SuppliedThreadLocal(Supplier<? extends T> supplier) {
        this.supplier = Objects.requireNonNull(supplier);
    }

    @Override
    protected T initialValue() {
        return supplier.get();
    }
}
set
与get类似,
若 map 存在则 map.set(this, value),以ThreadLocal as Key,存入map中。
若map不存在则 createMap(t, value),构造新的 ThreadLocalMap(this, value)到Thread#threadLocals上,并放入以该value作为第一个entry。
set 不做同步,因为只会被当前线程访问其 Thread 的 map。
set 方法在插入过程中当遇到 stale entry,会调用 replaceStaleEntry(...) 来替换并清理 stale entries,最后可能触发 rehash()。
public void set(T value) {
    Thread t = Thread.currentThread();
    ThreadLocalMap map = getMap(t);
    if (map != null) {
        map.set(this, value);
    } else {
        createMap(t, value);
    }
}
remove
调用 m.remove(ThreadLocal),从 map 中删除对应 entry。
内部找到 entry 后 e.clear()(清掉弱引用),e.value = null(释放value强引用),
并 expungeStaleEntry(i) 做后续整理。
 public void remove() {
     ThreadLocalMap m = getMap(Thread.currentThread());
     if (m != null) {
         m.remove(this);
     }
 }
ThreadLocalMap关键实现
核心数据结构
ThreadLocalMap作为ThreadLocal的内部类,ThreadLocal.ThreadLocalMap 使用数组 + 线性探测实现(不是标准 HashMap 的链表/红黑树)。
每个 entry 的 key 是对 ThreadLocal 的 弱引用,value 是强引用。
static class Entry extends WeakReference<ThreadLocal<?>> {
    Object value;
    Entry(ThreadLocal<?> k, Object v) { super(k); value = v; }
}
ThreadLocalMap初始化。
初始容量INITIAL_CAPACITY = 16 = 2^4。
i作为索引,由threadLocalHashCode 与 INITIAL_CAPACITY 确定。
负荷因子,初始化为threshold = 2/3 * INITIAL_CAPACITY。
ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) {
    table = new Entry[INITIAL_CAPACITY];
    int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1);
    table[i] = new Entry(firstKey, firstValue);
    size = 1;
    setThreshold(INITIAL_CAPACITY);
}
getEntry
见ThreadLocal关键实现#get。
set
在插入时会遇到 stale entry(key==null)时清理并复用槽,必要时触发 table 扩容。
private void set(ThreadLocal<?> key, Object value) {
    Entry[] tab = table;
    int len = tab.length;
    //计算起始槽:当前Key应该在Map中的位置
    int i = key.threadLocalHashCode & (len-1);

    // 线性探测寻找合适位置
    for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) {
        ThreadLocal<?> k = e.get();

        if (k == key) {
            // 情况1:找到相同key,直接更新
            e.value = value;
            return;
        }

        if (k == null) {
            // 情况2:发现过期条目,其Key已经被GC,那么需要替换并清理,然后插入。
            replaceStaleEntry(key, value, i);
            return;
        }
    }

    // 情况3:找到空槽,创建新条目
    tab[i] = new Entry(key, value);
    int sz = ++size;

    // 插入新Entry后调用 cleanSomeSlots(i, sz) 做启发式扫描清理 stale entry
    // 返回 false 表示没有发现、删除stale entry && sz达到负载阈值,那么尝试rehash
    if (!cleanSomeSlots(i, sz) && sz >= threshold)
        rehash();
}
replaceStaleEntry
发现过期条目,其Key已经被GC,那么需要替换并清理,然后插入。
但不能简单覆盖而不做更多工作,因为此 stale 可能在一个簇(run)的中间,直接覆盖可能破坏 probing 的正确性,导致后续 item 无法被找到。
簇(run / cluster):簇是指哈希表中 从某个起始位置开始,连续的一段非 null 条目,直到遇到第一个
null为止。
private void replaceStaleEntry(ThreadLocal<?> key, Object value,
                               int staleSlot) {
    Entry[] tab = table;
    int len = tab.length;
    Entry e;

    //Key被GC的Entry的索引,从其开始
    int slotToExpunge = staleSlot;
    //向前查找,从Key为null的Entry开始
    //如果向前找到了过期数据,更新下标为 i,即slotToExpunge=i
    //直到Entry为null
    for (int i = prevIndex(staleSlot, len);
         (e = tab[i]) != null;
         i = prevIndex(i, len))
        // Android-changed: Use refersTo().
        if (e.refersTo(null))
            slotToExpunge = i;

    //向后查找,从Key为null的Entry开始
    //如果遇到 e.refersTo(key),等于想要插入的Entry的key
    //就把它的 value 设为新的 value
    for (int i = nextIndex(staleSlot, len);
         (e = tab[i]) != null;
         i = nextIndex(i, len)) {

        if (e.refersTo(key)) {
            e.value = value;

            tab[i] = tab[staleSlot];
            tab[staleSlot] = e;

            // 如果slotToExpunge == staleSlot
            // 这说明一开始向前查找时,并未找到Stale Entry,
            // 接着向后查找过程中,直到找到同Key时也未发现Stale Entry
            if (slotToExpunge == staleSlot)
                //那么从这个同Key的Entry开始 做启发式扫描
                slotToExpunge = i;

            // 从slotToExpunge开始
            // 三种:
            // 1.要么是向前扫描到的Satle Entry位置
            // 2.要么是向后扫描到的Satle Entry位置
            // 3.同Key的Entry的位置
            // 往后做启发式扫描 + 清理
            // 这个方法不负责清理,只负责扫描
            cleanSomeSlots(expungeStaleEntry(slotToExpunge), len);
            return;
        }


        // Android-changed: Use refersTo().
        // 不等于想要插入的Entry的Key
        // e.refersTo(null)说明是一个 Stale Entry &&
        // 同时slotToExpunge == staleSlot说明,一开始向前查找时,并未找到Stale Entry
        // 则更新slotToExpunge为当前位置,这个前提是向前扫描时未发现过期数据
        if (e.refersTo(null) && slotToExpunge == staleSlot)
            slotToExpunge = i;
    }

    // 如果向后找不到同Key的,那么直接在Key为null的Entry上更新
    tab[staleSlot].value = null;
    tab[staleSlot] = new Entry(key, value);

    // 如果;除了staleSlot以外,还发现了Key为null的 Stale Entry
    // 就要开启清理数据的逻辑:
    if (slotToExpunge != staleSlot)
        cleanSomeSlots(expungeStaleEntry(slotToExpunge), len);
}
cleanSomeSlots
//启发式扫描清理
private boolean cleanSomeSlots(int i, int n) {
    boolean removed = false;
    Entry[] tab = table;
    int len = tab.length;
    //做对数级探测以寻找 stale entry
    //如果找到 stale 则设置 n = len 以此做更多探测,并 expungeStaleEntry(i)
    // n >>>= 1 位运算,每次右移动 1 位
    // 无论如何都做一次探测
    do {
        //从新插入Entry的槽位的下一个,开始启发式扫描
        i = nextIndex(i, len);
        Entry e = tab[i];
        // Android-changed: Use refersTo().
        // 探测到下一个是过期的
        // n = 当前Map长度 (len是基础类型,不会随着清理而变小)
        // 然后就有多 log2(len) 次探测机会(下次探测位置是i+1)
        // 否则没探测到,n >>>= 1 结果为0,结束探测。
        if (e != null && e.refersTo(null)) {
            n = len;
            removed = true;
            i = expungeStaleEntry(i);
        }
    } while ( (n >>>= 1) != 0);
    //返回 false 表示没有发现、删除stale entry
    // true表示至少删除了一个
    return removed;
}
expungeStaleEntry
//tab[staleSlot] 对应的 entry 的 key 已经为 null
//清理该slot
private int expungeStaleEntry(int staleSlot) {
    Entry[] tab = table;
    int len = tab.length;

    // 释放value强引用
    tab[staleSlot].value = null;
    tab[staleSlot] = null;
    size--;

    // 从 i = nextIndex(staleSlot, len) 开始向后遍历
    // 直到遇到 null,说明run结束
    Entry e;
    int i;
    for (i = nextIndex(staleSlot, len);
         (e = tab[i]) != null;
         i = nextIndex(i, len)) {
        ThreadLocal<?> k = e.get();
        //这个Entry 的 key被GC了,清理
        if (k == null) {
            e.value = null;
            tab[i] = null;
            size--;
        } else {
            //Entry key 仍然存在,没有被GC
            //计算key理论上在Map(tab)中的索引
            int h = k.threadLocalHashCode & (len - 1);
            //如果计算出来的h索引 和 当前遍历到的i索引 不一致
            //那么需要尝试rehash 保证查找效率
            if (h != i) {
                tab[i] = null;
                //如果Entry Key理论上的索引h上已经有了数据
                //在tab中找到一个距离h最近的空slot (其Entry==null)
                while (tab[h] != null)
                    h = nextIndex(h, len);
                //放入Entry
                tab[h] = e;
            }
        }
    }
    return i;
}
rehash
private void rehash() {
    expungeStaleEntries();

    // 使用较低的倍增阈值以避免滞后
    // 如果全局清理过后发现,size 仍然大于 threshold * 3/4
    // 扩容
    if (size >= threshold - threshold / 4)
        resize();
}

//全局清理
private void expungeStaleEntries() {
    Entry[] tab = table;
    int len = tab.length;
    for (int j = 0; j < len; j++) {
        Entry e = tab[j];
        // Android-changed: Use refersTo().
        if (e != null && e.refersTo(null))
            expungeStaleEntry(j);
    }
}
resize
private void resize() {
    Entry[] oldTab = table;
    int oldLen = oldTab.length;
    // 新容量是旧的两倍
    int newLen = oldLen * 2;
    Entry[] newTab = new Entry[newLen];
    int count = 0;

    for (Entry e : oldTab) {
        if (e != null) {
            ThreadLocal<?> k = e.get();
            if (k == null) {
                e.value = null; // Help the GC
            } else {
                //Entry key 仍然存在,没有被GC
                //计算key理论上在Map(tab)中的索引
                int h = k.threadLocalHashCode & (len - 1);
				//如果Entry Key理论上的索引h上已经有了数据
                //在tab中找到一个距离h最近的空slot (其Entry==null)
                while (newTab[h] != null)
                    h = nextIndex(h, newLen);
                newTab[h] = e;
                count++;
            }
        }
    }

    setThreshold(newLen);
    size = count;
    table = newTab;
}
remove
private void remove(ThreadLocal<?> key) {
    Entry[] tab = table;
    int len = tab.length;
    int i = key.threadLocalHashCode & (len-1);
    for (Entry e = tab[i];
         e != null;
         e = tab[i = nextIndex(i, len)]) {
        // Android-changed: Use refersTo().
        if (e.refersTo(key)) {
            e.clear();
            expungeStaleEntry(i);
            return;
        }
    }
}
InheritableThreadLocal关键实现
使用ThreadLocal的时候,正常情况下子线程无法取得父线程中创建的ThreadLocal。
而使用InheritableThreadLocal,可以实现子线程继承父线程的局部变量。
继承行为并非自动发生,它只在一种特定情况下触发:在父线程中通过 new Thread() 创建子线程对象时,自动在 Thread 类的构造函数中完成继承。
与 ThreadLocal 使用 Thread#threadLocals 字段存储数据不同,InheritableThreadLocal 使用 Thread 类中另一个专门的字段Thread#ThreadLocal.ThreadLocalMap inheritableThreadLocals。
默认情况下,inheritThreadLocals 参数为 true。
只有当父线程的 inheritableThreadLocals 不为 null时,才会执行继承逻辑。
public class InheritableThreadLocal<T> extends ThreadLocal<T> {
    /**
     * 重写 getMap 方法,返回线程的 inheritableThreadLocals 字段。
     */
    @Override
    ThreadLocalMap getMap(Thread t) {
        return t.inheritableThreadLocals;
    }

    //所以,当我们调用 itl.set("value") 时:
    //会调用 InheritableThreadLocal 重写的 getMap,获取当前线程的 inheritableThreadLocals。
	//如果当前线程的 inheritableThreadLocals 为 null,
    //则调用 createMap 方法,初始化 inheritableThreadLocals 并设置第一个值。

	//重写 createMap 方法,创建的是 inheritableThreadLocals 而不是 threadLocals。
    @Override
    void createMap(Thread t, T firstValue) {
        t.inheritableThreadLocals = new ThreadLocalMap(this, firstValue);
    }
}

private void init(ThreadGroup g, Runnable target, String name,
                 long stackSize, AccessControlContext acc,
                 boolean inheritThreadLocals) { // 注意这个参数!
    // ... 其他初始化代码 ...

    Thread parent = currentThread(); // 获取当前线程(即父线程)

    // ...

    if (inheritThreadLocals && parent.inheritableThreadLocals != null) {
        // 核心逻辑:如果父线程的 inheritableThreadLocals 不为空,则创建继承的 Map
        this.inheritableThreadLocals =
            ThreadLocal.createInheritedMap(parent.inheritableThreadLocals);
    }

    // ...
}
ThreadLocal.createInheritedMap(ThreadLocalMap parentMap) 是执行实际拷贝工作的工厂方法。它创建了一个新的 ThreadLocalMap,其内部调用了 ThreadLocalMap 的一个特殊私有构造函数:这个过程的核心是 key.childValue(e.value)。
protected T childValue(T parentValue) {
	return parentValue; //默认实现:直接传递父值的引用
}
这就是InheritableThreadLocal的实现:浅拷贝。子线程获得的 InheritableThreadLocal 变量与父线程中的是同一个对象。
问题
1.浅拷贝带来的线程安全问题
场景:如果父线程传递的是一个可变对象(如 HashMap, ArrayList),父线程和子线程将共享这个对象的引用。
风险:任何一方对这个共享对象的修改都会对另一方可见,如果没有适当的同步控制,会导致数据竞争和不确定的行为。
解决方案:重写 childValue 方法,实现深拷贝或返回一个全新的对象。
private static final InheritableThreadLocal<HashMap<String, String>> CONTEXT =
    new InheritableThreadLocal<HashMap<String, String>>() {
        @Override
        protected HashMap<String, String> childValue(HashMap<String, String> parentValue) {
            return parentValue == null ? null : new HashMap<>(parentValue); // 深拷贝
        }
    };
2.线程池中的数据污染:
场景:在广泛使用线程池的应用中,线程是被复用的,创建新任务(Runnable)时并不会创建新的线程。
问题:因此,当线程池中的线程执行一个新任务时,它携带的是上一个任务(可能是完全无关的任务)设置的 InheritableThreadLocal 值,这会造成严重的数据污染。
解决方案:需要在任务提交到线程池之前手动设置上下文,并在任务执行完毕后显式清理。或者使用像阿里的 TransmittableThreadLocal 这样的高级库来解决线程池上下文传递问题。
3.内存泄漏风险:
与 ThreadLocal 类似,如果子线程是长生命周期线程(如线程池中的线程),而父线程已经不再使用某个 InheritableThreadLocal 实例,但由于子线程的 ThreadLocalMap 持有对其的强引用(通过 Entry.value),会导致父线程的 InheritableThreadLocal 值无法被回收。必须在子线程中适时调用 remove()。
小结
Thread 持有 ThreadLocalMap(无锁,线程私有)。
key 用 WeakReference,value 为强引用,容易导致“Key被回收但值未回收”的场景(内存泄漏)。
清理 stale 条目的策略是惰性触发(cleanSomeSlots、expungeStaleEntry)。
使用 remove()(特别在线程池场景)与 try/finally 是必须的工程实践。
ThreadLocal变量务必使用static final修饰:如果不是 static,每次 new 出来的对象都有自己独立的 ThreadLocal,就是不同实例不共享ThreadLocal Key,会出现Key冗余。即使在同一个线程下,每一个实例从ThreadLocalMap取得的Value都不同!
加 static 时,多个线程共享一个 ThreadLocal Key,但因为各自的ThreadLocalMap不相同,因此有独立的存储空间,是不同的Value。
为什么 ThreadLocalMap 设计成放在 Thread 而不是放在 ThreadLocal 本身?
因为需要把数据与线程绑定,并且避免跨线程同步(每个线程只访问自己的 map),把 map 存在 Thread 上使得查找很快且无需锁。
如果我们改用强引用作为 key,会怎样?
现代应用大量使用线程池,那么线程池里线程不会因为一次任务结束而销毁,它们会长期循环使用。
那么ThreadLocal 实例将永远被 ThreadLocalMap 引用。
而ThreadLocalMap 绑定在 Thread#threadLocals 上,那么在 Thread 存活期间,不可被 GC。
而 Thread 绑定在 线程池中,等同于“直到进程结束才回收”,风险很大,必须全程手动管理ThreadLocal。
参考
https://www.xiaolincoding.com/interview/juc.html
https://javaguide.cn/java/concurrent/java-concurrent-questions-01.html
https://liuyehcf.github.io/2017/09/25/操作系统原理-进程线程模型/