
Java多线程笔记(1)
Java内存模型、重要关键字、计算机组成基础
背景
为什么需要多线程/多核CPU
计算机系统中有很多速度慢得多的部件(如内存、硬盘、网络)。当一个线程在等待从硬盘读取数据时(这是一个非常慢的操作),单核CPU就会空闲。而在多核/多线程环境下,操作系统可以立即让另一个线程在那个空闲的核心上运行,从而让CPU始终保持忙碌,大大提高了整体资源的利用率。
多核CPU的协作方式
在 CPU 执行程序时,每条指令都在处理器上运行;指令执行往往需要读写数据。程序运行时的大量临时数据存放在主内存(物理内存)中,但主存的访问速度远慢于 CPU 的执行速度。
如果处理器每次对数据的操作都直接访问主存,程序会非常慢。为了解决这个性能差距,现代处理器在每个核心里都配有多级高速缓存(典型的有 L1、L2、L3 等),用于保存主存数据的本地副本,从而加快读写。
高速缓存带来的问题
举个简单例子:语句 i = i + 1; 在单线程下看起来没有问题。
但在多线程/多核环境中,每个核心都有自己的缓存副本,可能发生下面的情况:两个线程同时读取主存中 i 的值(每个线程在自己核心的缓存里有一份),线程 A 在本地加 1 并把结果写回主存;线程 B 仍然基于自己缓存中的旧值加 1,然后写回主存,导致最终主存中 i 的值只加了 1 而不是 2。这个现象就是缓存一致性问题 —— 当同一内存位置在多个缓存中都有副本时,如何保证这些副本在并发访问下仍然一致。
为了解决缓存不一致问题,硬件通常提供两类机制:
- 早期、简单的做法是用总线锁(bus lock,例如 x86 的 LOCK# 信号)让其他处理器在某段操作期间无法访问内存,从而保证原子性。但这种方法会阻塞总线上的所有事务,效率很低。现代处理器在大多数常见情况下并不通过长期锁住总线来实现原子性;总线锁仍可能在某些特殊情形(例如对不可缓存内存的访问、非常老的硬件模式或跨 NUMA/IO 区域)下被使用。
- 更普遍、更高效的方式是由硬件实现的缓存一致性协议(cache coherence protocol),它定义了各缓存控制器之间如何协同维护同一缓存行的状态与更新,从而保证多个私有缓存与共享主内存之间数据副本的一致性。常见设计思路包括基于“总线嗅探”(snooping)的协议和基于“目录”(directory-based)的协议:
- 在较小规模的多核芯片(核心数不太大且共享总线或环形互连)上,缓存控制器常用嗅探(snooping):每个缓存控制器监听总线或片上互连上的读/写请求,并根据请求调整自己缓存行的状态或响应数据。
- 在大规模或多插槽/多节点系统中,为了减少广播,常用目录协议,由目录记录哪些节点缓存了哪条缓存行,缓存一致性请求通过目录来转发/协调。
MESI(及变种):一个常见的嗅探型协议
在很多 x86 平台上(以及许多其他架构厂商的实现中)使用的一类协议就是 MESI 或其变体,MESI 把每个缓存行的状态限制为四种之一:
- M (Modified):缓存行被本缓存修改,主存是过时的;该缓存拥有该行的唯一有效副本。
- E (Exclusive):缓存行在本缓存中为独占且未被修改(与主存一致)。
- S (Shared):缓存行与其他缓存共享,且与主存一致。
- I (Invalid):缓存行无效,不能直接使用。
基于 MESI 的基本交互(用更贴近实现的术语描述)通常包括:
- 当核心需要读取某个缓存行但本地为
I,会发起一个读请求(BusRd/类似事务)。如果其他核心有M或E状态的副本,它们会把数据放到总线/响应者,从而使请求者得到数据;响应者在必要时把自己的状态降级为S。如果没有其他有效副本,数据就要从主存取回,请求者将该行置为S(或E,取决于实现和是否探测到共享)。 - 当核心要写某缓存行而本地没有写权限(例如本地是
S或I),它会发起一个获取独占/升级的事务(如 BusRdX / Upgrade / BusUpgr 等,不同实现名词有差别)。该事务会使其他缓存中对应行变为I(即发送无效化),请求核心在收集足够的无效确认之后才获得独占写权并把本行置为M,然后执行写入。 - 当核心已经以
S状态持有某行但想改写时,通常可以发起一次“升级(Upgrade/Upgr)”请求,这样无需重读数据,只需使其他副本无效,然后把本行变为M再写入。
注意:不同厂商对 MESI 有扩展或变体,但总体思想是一致的:通过有限的状态,协调副本的一致性。
x86 与 ARM
- x86 系列(Intel/AMD):传统上在多核 x86 处理器上常见的是基于嗅探的 MESI 类协议(各厂商在实现上有细微扩展,如 MESIF、MOESI 等优化),并且在实现层面会尽可能利用缓存一致性来实现原子操作(例如 LOCK 前缀指令通常会走缓存一致性协议获得缓存行的独占权限,而不是总是锁总线)。在多插槽 / 多节点系统或特殊情形下,仍可能使用更重的机器级手段或额外的互斥机制。x86 的内存模型相对较强(强序),这也影响多线程程序的可见性与同步语义。
- ARM(包括 ARMv7/ARMv8 等):ARM 平台也采用类似的缓存一致性协议(可看作 MESI 或 MESI-like)的机制来维护缓存行一致性;不过实际实现细节因芯片厂商与平台而异。ARM 架构的内存模型总体上比 x86 弱一些(即对操作重排序的允许度更大),因此在编写并发程序或内核同步代码时,程序员或编译器需要显式使用内存栅栏(例如 DMB/DSB 在 ARM 上)来获得必要的可见性与顺序保证。除此之外,ARM 在大规模系统上也会采用目录式协议或其他互连机制来扩展一致性。
JMM的介绍
Java 内存模型(Java Memory Model,JMM)定义了 Java 程序中的变量、线程,如何与主内存、工作内存进行交互的规则。它主要涉及到多线程环境下的共享变量可见性、指令重排等问题,是理解并发编程中的关键概念。
并发编程中比较关键的两个问题就是同步、互斥:
同步,意味着线程之间要密切合作,按照一定的顺序来执行任务。比如说,线程 A 先执行,线程 B 再执行。
互斥,意味着线程之间要抢占资源,同一时间只能有一个线程访问共享资源。比如说,线程 A 在访问共享资源时,线程 B 不能访问。
同步关注的是线程之间的协作,互斥关注的是线程之间的竞争。
tips1:
在JVM的内存模型中,对于每一个线程来说,栈都是私有的,而堆是共有的。
当一个对象被创建时,它的所有非静态成员变量(包括volatile变量)都随着对象本身一起存储在堆(Heap) 内存中。
也就是说,在栈中的变量(局部变量、方法定义的参数、异常处理的参数)不会在线程之间共享,也就不会有内存可见性的问题,也不受内存模型的影响。被多个线程共同访问和操作的非静态成员变量称为共享变量。
所以,可见性主要针对的是共享变量。这些共享变量,正如背景所言,会被放入CPU的高速缓存当中,所以也就引发了多线程的核心问题。
tips2:
计算机在执行程序时,为了提高性能,编译器和处理器常常会对指令做重排。
为什么指令重排序可以提高性能?
指令重排是减少流水线“停顿”(尤其是由数据/内存延迟引起的)的一种重要技术。
流水线(pipeline)技术是指在程序执行时,把多条指令进行重叠操作的并行处理的技术。
原始顺序:
r1 = LOAD x      // 高延迟
r2 = r1 + 1
r3 = LOAD y      // 要等 r2 吗?看代码顺序是后发起的
r4 = r3 + 2
重排后:
r1 = LOAD x
r3 = LOAD y      // 提前发起 load y,与 load x 并行等待
r2 = r1 + 1
r4 = r3 + 2
结果:两次内存加载的等待可以部分重叠,算术指令在数据到达后能立即执行,流水线空闲周期减少 → 吞吐率提高。
多线程的两大核心问题
如何保障共享数据一致性?
包含三个子问题:原子性(atomicity)、可见性(visibility)、有序性(ordering)。
常见错误:竞态条件(race)、ABA 问题、内存重排导致的不可见更新等。
常用手段:原子操作(CAS/atomic classes)、互斥(synchronized/Lock)、volatile、不可变对象、线程安全集合。
线程之间如何通信协作?
常用手段:通知/等待(wait/notify、Condition)、信号量(semaphore)、屏障(barrier)、队列/管道(blocking queue)、消息传递(actor/model)。
目的:在正确的时间顺序上交换数据或控制权,减少忙等(busy-wait)并提高并发度。
tips:
活跃性问题,常常也被忽略但是十分重要。
常见错误:死锁(deadlock)、活锁(livelock)、饿死(starvation)、优先级反转(priority inversion)。
保障共享数据一致性的三大要求
多线程在工作时,如果需要对共享数据进行操作,那么往往需要原子性、可见性、有序性的实现(不一定三个特性都要),以此保证共享数据的一致性,执行流的正确性。
-
原子性(竞态条件):多个线程同时修改共享数据时,结果可能是不可预测的。我们期望的是一个操作或者多个操作,要么全部执行并且执行的过程不会被任何因素打断,要么就都不执行。
x = 10; //语句1 y = x; //语句2 x++; //语句3 x = x + 1; //语句4 //其实只有语句1是原子性操作,其他三个语句都不是原子性操作。 //语句1是直接将数值10赋值给x,也就是说线程执行这个语句的会直接将数值10写入到工作内存中。 //语句2实际上包含2个操作,它先要去读取x的值,再将x的值写入工作内存,虽然读取x的值以及 将x的值写入工作内存 这2个操作都是原子性操作,但是合起来就不是原子性操作了。 //同样的,x++和 x = x+1包括3个操作:读取x的值,进行加1操作,写入新的值。 //所以上面4个语句只有语句1的操作具备原子性。 //也就是说,只有简单的读取、赋值(而且必须是将数字赋值给某个变量,变量之间的相互赋值不是原子操作)才是原子操作。 -
可见性(数据竞争):一个线程修改数据后,其他线程可能无法立即看到最新值。我们期望的是多个线程访问同一个变量时,一个线程修改了这个变量的值,其他线程能够立即看得到修改的值。
(如后台线程修改数据后,主线程读取旧值)//线程1执行的代码 int i = 0; i = 10; //线程2执行的代码 j = i; //假若执行线程1的是CPU1,执行线程2的是CPU2。由上面的分析可知,当线程1执行 i =10这句时,会先把i的初始值加载到CPU1的高速缓存中,然后赋值为10,那么在CPU1的高速缓存当中i的值变为10了,却没有立即写入到主存当中。 //此时线程2执行 j = i,它会先去主存读取i的值并加载到CPU2的缓存当中,注意此时内存当中i的值还是0,那么就会使得j的值为0,而不是10. //这就是可见性问题,线程1对变量i修改了之后,线程2没有立即看到线程1修改的值。 -
有序性:代码编写顺序,与实际上的代码执行顺序常常不一致。如果多线程之间依赖某一共享数据进行执行,可能导致不可预期的错误(由CPU/编译器优化,重排序导致)。我们期望的是所见即所得,代码执行顺序与代码编写顺序尽可能一致。
//线程1:
context = loadContext();  //语句1
inited = true;       //语句2
//线程2:
while(!inited){
 	sleep()
}
doSomethingwithconfig(context);
//上面代码中,由于语句1和语句2没有数据依赖性,因此可能会被重排序。
//假如发生了重排序,在线程1执行过程中先执行语句2,而此是线程2会以为初始化工作已经完成,那么就会跳出while循环,去执行doSomethingwithconfig(context)方法,而此时context并没有被初始化,就会导致程序出错。
//从上面可以看出,指令重排序不会影响单个线程的执行,但是会影响到线程并发执行的正确性。
Happens-Before(先行发生)原则
Happens-Before(先行发生)原则是对 **Java 内存模型(JMM)**中所规定的可见性的更高级的语言层面的描述。
可以用这个原则解决并发环境下两个操作之间的可见性问题。
如果两个操作的执行次序无法从happens-before原则推导出来,那么它们就不能保证它们的有序性,虚拟机可以随意地对它们进行重排序。
定义
程序次序规则
同一个线程内,按程序顺序执行的操作 A 在语义上 先行发生于 后面的操作 B。
锁规则
一个 unlock 操作 先行发生于 后面对同一个锁的 lock 操作。(注意:不止针对synchronized、也对lock接口相关的生效)
All Lock implementations must enforce the same memory synchronization semantics as provided by the built-in monitor lock, as described in section 17.4 of The Java™ Language Specification:
A successful lock operation has the same memory synchronization effects as a successful Lock action.
A successful unlock operation has the same memory synchronization effects as a successful Unlock action.
volatile 变量规则
对一个 volatile 变量的写操作 先行发生于 后面对这个volatile变量的读操作。
线程启动规则
Thread start()方法 先行发生于 此线程的每一个动作。
线程终止规则
线程中的所有操作都先行发生于对此线程的终止检测。
可以通过 Thread.join()方法和 Thread.isAlive()的返回值等手段检测线程是否已经终止执行。
线程中断规则
对线程 interrupt()方法的调用 先行发生于 被中断线程的检测中断的代码。
可以通过 Thread.interrupted()方法检测到是否有中断发生。
对象终结规则
一个对象的初始化完成(构造函数结束)先行发生于它的 finalize()方法的开始。
传递性
如果操作 A 先行发生于 操作 B,操作 B 先行发生于 操作 C,那就可以得出操作 A 先行发生于操作 C 的结论。如果前七条都不成立,那么这一条没有使用价值。
注意
- Happens-before 关系保证正确同步的多线程程序的执行结果不被改变。
- Happens-before 关系给编写正确同步的多线程程序的程序员创造了一个幻境:正确同步的多线程程序是按 Happens-before 指定的顺序来执行的。实际上,CPU/编译器仍然可以对执行顺序进行重排,只要依赖关系不发生冲突。
内存屏障
前言
MESI协议本身是完美的,但在实践中遇到了性能瓶颈。我们的两位主角Store Buffer、Invalidate Queue就是为了解决这些瓶颈而登场的。
瓶颈一:写操作太慢
场景:核心A想修改一个处于S状态(共享状态)的缓存行。
MESI流程:
- 核心A必须先给所有其他核心发送一个 “无效化(Invalidate)” 消息。
- 然后等待所有其他核心回复 “确认(Acknowledge)” 消息,表示它们已将自己的副本置为无效(
I)。 - 核心A阻塞等待,收到所有确认后,核心A才能将它的缓存行状态改为
E或M,然后才能执行写入。
问题:这个“等待所有确认”的过程非常漫长(在CPU时钟周期尺度上看)!核心A啥也干不了,就在那傻等,浪费宝贵的计算资源。
解决方案:Store Buffer (存储缓冲区)
-
是什么:在每个CPU核心和它的缓存之间加的一个非常小的、高速的缓冲区。
-
怎么做:
-
当核心A要执行一个写操作时,它不再傻等,而是直接把要写入的数据和地址扔进自己的
Store Buffer。同时,发送无效化消息。 -
不阻塞等待其他核心回复
InvAck,核心A继续执行后面的指令。 -
当其他核心都回复了
InvAck后,存储在Store Buffer里的数据才会被真正地写回到核心A自己的缓存行中。
-
好处:核心不用阻塞,极大地提升了效率。
副作用:
Store Buffer的引入带来了一个新的问题:导致了指令重排序和内存可见性问题。
考虑以下代码序列(在两个线程上执行):
// Core 0执行
X = 10;
Y = 1;

// Core 1执行
while (Y == 0) { /* spin */ }
print(X);
假设初始状态 X=0, Y=0。
- 从Core 0的视角看,它先写
X,后写Y。 - 但从Core 1的视角看,由于Store Buffer的存在,Core 0的写入顺序可能“乱序”:
- Core 0将
X=10放入Store Buffer,并发送BusRdX。 - Core 0继续执行,将
Y=1也放入Store Buffer。 - 由于某些原因(比如总线繁忙、Y所在的缓存行是E状态),获取
Y独占权的先完成了。于是Y=1先从Store Buffer提交到了Core 0的L1缓存。 - Core 1一直在监听总线,它看到了
Y被Core 0修改的消息,于是将自己的Y缓存行无效化(I状态),然后从Core 0的L1缓存中读取到Y=1。 - Core 1跳出循环,去读取
X。但此时,Core 0的X=10可能还在Store Buffer里,尚未提交到L1缓存!所以Core 1读到的X可能还是旧的初始值0。
- Core 0将
这就导致了违反直觉的结果:Core 1打印出了 X=0,尽管按照代码顺序 X=10 发生在 Y=1 之前。
瓶颈二:无效化确认太慢
场景:Core 1收到了Core 0发来的“无效化”消息。
问题:如果Core 1正在处理其他事情,或者无效化消息很多,它可能无法立即处理这个无效化请求并回复确认。这会拖慢Core 0(虽然Core 0有Store Buffer,但最终还是要等InvAck确认后,才能写入缓存)。
解决方案:Invalidate Queue (无效化队列)
-
是什么:在每个CPU核心的缓存之前加的一个小队列。
-
怎么做:
- 当Core 1收到一个“无效化”消息时,它看都不看,直接回复 “确认”。
- 然后把这个“无效化”请求扔到自己的Invalidate Queue里排队,等自己有空了再慢慢处理(即真正地把本地对应的缓存行置为
I状态)。
好处:极大加快了确认响应速度,让请求方(Core 0)能更快地完成操作。
副作用:
它加剧了内存可见性问题。
例子:
// Core 0执行
X = 10;
Y = 1;

// Core 1执行
while (Y == 0) { /* spin */ }
print(X);
Core 1在while (Y == 0);循环时,可能早就收到了Core 0发来的针对Y的无效化消息,并迅速回复了确认。但这个消息还在Core 1的Invalidate Queue里躺着没处理!
所以当Core 1跳出循环去读X时,它看到的自己缓存里那个X=0的副本还是S状态(它自以为有效的),于是直接使用了这个旧值,完全忽略了它已经被Core 0失效的事实。
Store Buffer和Invalidate Queue是伟大的性能优化,但它们破坏了程序的顺序性和可见性,导致了一些反直觉的结果。这对于编写底层系统代码、并发代码的程序员来说是灾难性的。
总结
因此,CPU提供了内存屏障指令,让程序员有能力告诉CPU:“这里需要强一致性”。
写屏障
相当于对Store Buffer的操作。
- 作用:一条写屏障指令之后的写操作,必须等到该屏障之前的所有写操作都从Store Buffer写到缓存之后,才能开始执行。
- 解决上面的问题:在
X=10;和Y=1;之间插入写屏障,能保证X=10肯定已经写入缓存(等待InvAck,才能使其他副本失效)后,Y=1才会被执行和可见。确保其他Core能够拿到最新值。(如果没有写屏障flush Store Buffer,那么在读屏障之后就算去读缓存行,发现值没变,那数据还是不一致,没拿到另一个Core应该写入的数据)
读屏障
相当于对Invalidate Queue的操作。
- 作用:一条读屏障指令之后的读操作,必须等到该屏障之前的所有Invalidate Queue中的消息都处理完之后,才能开始执行。
- 解决上面的问题:在Core 0的
while (Y == 0);循环之后、print(X)之前插入读屏障,能保证在读取X之前,先把Invalidate Queue里关于X的无效化请求处理掉,从而确保自己读到的是最新的X值。(如果没有读屏障,那么写屏障之后,另外一个Core没有处理Invalidate Queue,写不了缓存,副本不会失效,那读到的数据还是旧的)
高级语言中的体现:你在Java中使用的 volatile 关键字,或者在C++中使用的 std::atomic,其底层实现最终都会在编译后的指令中插入合适的内存屏障,来保证操作的原子性和可见性。
内存屏障(英语:Memory barrier),也称内存栅栏,是一类同步屏障指令,它使得 CPU 或编译器在对内存进行操作的时候, 严格按照一定的顺序来执行, 也就是说在内存屏障之前的指令和之后的指令不会由于系统优化等原因而导致乱序。大多数现代计算机为了提高性能而采取乱序执行,这使得内存屏障成为必须。
为了性能优化,JMM 在不改变结果的前提下,会允许编译器和处理器对指令序列进行重排序。JMM 提供了内存屏障阻止这种重排序。
不同硬件实现内存屏障的方式不同,Java内存模型(JMM)屏蔽了这种底层硬件平台的差异,由JVM来为不同的平台生成相应的机器码。
所以内存屏障分为两个层面:
- 硬件层面的内存屏障
- JVM层面的内存屏障
补充
如果一个写操作还停留在 该核的 store buffer 里、还没“写回”到缓存行(或还没被其它核看到),那么:
- 同一线程/同一核的后续读 有可能直接从 store buffer 得到新值(称为 store-to-load forwarding);
- 同一线程的寄存器 只有在编译器/优化把值保存在寄存器里的情况下才会被读到(那是编译器层面的优化,不是硬件自动把内存值放寄存器);
- 其它核的读 看不到 store buffer 中的值,只有等写被提交到缓存层并通过缓存一致性协议广播后其它核才能看到新值;否则它们会从自己的缓存(L1/L2)或从内存总线上取得旧值。
硬件层面的内存屏障
- Load(读)屏障:确保屏障之前的读操作 先于 屏障之后的读操作完成。
- Store(写)屏障:确保屏障之前的写操作 先于 屏障之后的写操作完成。
- Full(全)屏障:同时具有Load屏障和Store屏障的功能,确保屏障之前的读写操作 先于 屏障之后的读写操作完成。
不同硬件通过不同的指令实现这三种屏障。
| Intel x86架构指令 | 等效其他架构指令(ARM) | 含义 | 解决的问题 |
|---|---|---|---|
LFENCE (Load Fence) |
DMB LD |
LoadLoad 屏障 | 确保屏障之前的读操作 先于 屏障之后的读操作完成。较少见,用于特殊场景(如序列化指令)。 |
SFENCE (Store Fence) |
DMB ST |
StoreStore 屏障 | 确保屏障之前的写操作 先于 屏障之后的写操作完成。即刷新Store Buffer。 |
MFENCE (Full Fence) |
DMB SY/ALL |
全能型屏障 | 确保屏障之前的读写操作 先于 屏障之后的读写操作完成。它会刷新当前处理器的Store Buffer到其缓存,并处理Invalidate Queue内的消息 |
LOCK 指令前缀 |
- | 原子操作 + 隐式屏障 | x86的LOCK前缀修饰的指令(如CMPXCHG)不仅保证原子性,还隐含了一个MFENCE级别的全屏障效果。 |
重要提示:x86架构是强内存模型(TSO, Total Store Order),其本身已经保证了StoreLoad之外的其他顺序(比如不会对StoreStore重排序)。因此,在x86上,SFENCE和LFENCE指令在很多场景下是“无操作”(No-op),而MFENCE或LOCK指令才是关键。但在弱内存模型(如ARM、PowerPC)上,所有类型的屏障都可能需要显式使用,开销也更大。
JVM层面的内存屏障
JVM层面的内存屏障实现禁止指令重排序有四种指令:
- LoadLoad: 确保该屏障之前的读操作(Load)先于 之后的读操作完成。
- StoreStore: 确保该屏障之前的写操作(Store)先于 之后的写操作完成,并且之前的写数据对其他处理器可见。
- LoadStore: 确保该屏障之前的读操作(Load)先于 之后的写操作(Store)完成。
- StoreLoad: 这是一个“全”屏障,它确保该屏障之前的所有写操作(Store)都对其他处理器可见之后,才执行该屏障之后的读操作(Load)。这是开销最大的一种屏障。
volatile(易挥发的)
- volatile关键字的作用是什么?
- volatile能保证原子性吗?
- 之前32位机器上共享的long和double变量的为什么要用volatile? 现在64位机器上是否也要设置呢?
- i++为什么不能保证原子性?
- volatile是如何实现可见性的? 内存屏障。
- volatile是如何实现有序性的? happens-before等
- 说下volatile的应用场景?
作用
一旦一个共享变量(类的成员变量、类的静态成员变量)被volatile修饰之后,那么就具备了两层语义:
- 可见性:对一个
volatile变量的写操作,对**所有后续的读操作(不限于同一个线程)**都是立即可见的。一个线程修改了volatile变量,通过内存屏障的配合,会触发缓存一致性协议,使所有其他处理器中缓存了该变量的缓存行失效。当另一个线程读取它时,会因为缓存失效而被迫从数据的拥有者(可能是另一个核心的缓存,也可能是主内存)重新获取最新的值,从而保证了可见性。 - 有序性(禁止指令重排序):编译器和使用乱序执行(Out-of-Order Execution)的 CPU 不能对
volatile变量的读写操作与它前后的其他内存操作进行随意重排序。这通过内存屏障和 happens-before原则来实现。
这些高级语义的底层实现,完全依赖于 JVM 在编译生成的机器码中插入内存屏障指令。
volatile 有序性、可见性实现原理
前言
为了提高处理速度,处理器不直接和内存进行通信,而是先将内存的数据读到内部缓存后再进行操作,但操作完后写入内存的时间是不确定的,其他处理器获取数据不一定是最新的,所以会出现各线程共享变量数据不一致的结果。为了解决这种情况,内存屏障诞生了。
JVM对volatile的插入屏障策略
Linux ARM
ARM 架构是典型的弱内存模型。
- 硬件特性:
- 它既有Store Buffer,也有Invalidate Queue。
- 为了极致性能,**它对指令重排序非常激进。ARM 的 CPU Load 与 Load,Load 与 Store,Store 与 Store,Store 与 Load 都会乱序。**默认情况下,几乎不保证任何顺序。
- 屏障实现:
- 在这种弱模型上,JVM必须严格插入所有四种屏障来实现
volatile的语义。
- 在这种弱模型上,JVM必须严格插入所有四种屏障来实现
- 使用的指令:
- ARMv7 使用
DMB(数据内存屏障)指令来实现屏障。DMB可以配置不同的选项来指定屏障的强度(例如,DMB ISH指在“内部共享域”范围内同步)。DMB指令同时完成了“清空本地Store Buffer到缓存”和“处理本地Invalidate Queue”的工作。
- ARMv8 引入了更精细的
LDAR(加载-获取)和STLR(存储-释放)指令对,可以更高效地实现同步原语。
- ARMv7 使用
因此在ARM架构下,JVM对volatile的插入屏障策略是非常保守的。
- 在每个
volatile读操作的后面插入一个LoadLoad屏障;在每个volatile读操作的后面插入一个LoadStore屏障。防止后续的普通读/写操作被重排序到volatile读之前。 - 在每个
volatile写操作的前面插入一个StoreStore屏障;在每个volatile写操作的后面插入一个 StoreLoad 屏障。
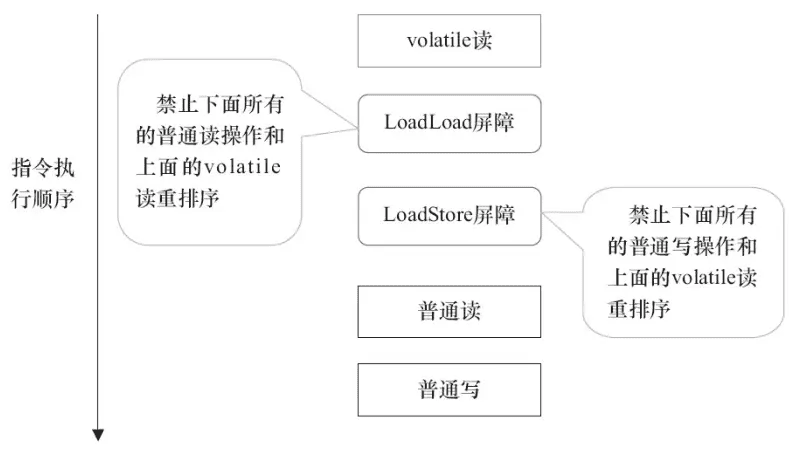
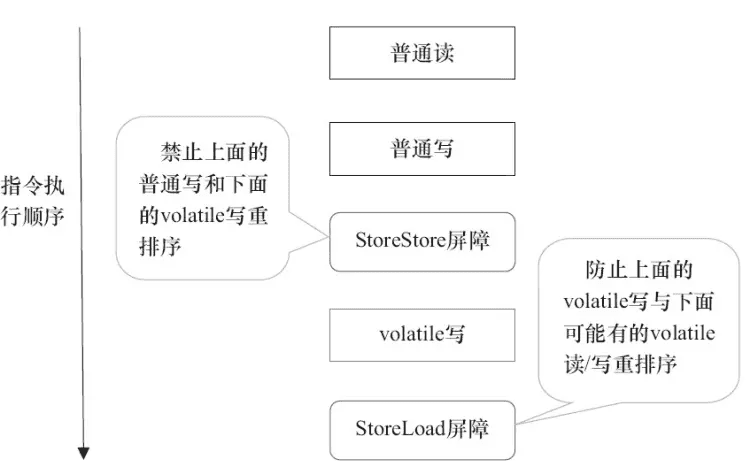
来看源码部分,看看JVM 是如何在ARM架构下插入内存屏障的。可以看到在 ARM架构下使用的是 dmb 来实现的。
//https://github.com/openjdk/jdk/blob/9a69bb807beb6693c68a7b11bee435c0bab7ceac/src/hotspot/cpu/arm/macroAssembler_arm.cpp
void MacroAssembler::membar(Membar_mask_bits order_constraint,
                            Register tmp,
                            bool preserve_flags,
                            Register load_tgt) {

  if (order_constraint == StoreStore) {
    dmb(DMB_st, tmp);
  } else if ((order_constraint & StoreLoad)  ||
             (order_constraint & LoadLoad)   ||
             (order_constraint & StoreStore) ||
             (load_tgt == noreg)             ||
             preserve_flags) {

    dmb(DMB_all, tmp);
  } else {
    // LoadStore: speculative stores reordeing is prohibited
    // By providing an ordered load target register, we avoid an extra memory load reference

    //使用cmp和b(两个指令)
    //cmp(load_tgt, load_tgt): 这是一个比较操作,结果总是相等,不会跳转。
    //b(not_taken, ne): 这是一个条件分支,条件“不相等”永远不会成立,所以永远不会跳转。
	//这两条指令组合起来相当于一个序列化指令
    //它们会阻止CPU将屏障后的存储操作推测执行到屏障前的加载操作之前
    //廉价地实现顺序保证LoadStore屏障,避免DMB指令的开销。
    Label not_taken;
    bind(not_taken);
    cmp(load_tgt, load_tgt);
    b(not_taken, ne);
  }
}

  //https://github.com/openjdk/jdk/blob/1fe45265e446eeca5dc496085928ce20863a3172/src/hotspot/cpu/arm/assembler_arm_32.hpp#L523
  enum DMB_Opt {
    DMB_all = 0xf,
    DMB_st  = 0xe,
  };

  void dmb(DMB_Opt opt, Register reg) {
    if (VM_Version::arm_arch() >= 7) {
      emit_int32(0xF57FF050 | opt);
    } else if (VM_Version::arm_arch() == 6) {
      bool preserve_tmp = (reg == noreg);
      if(preserve_tmp) {
        reg = Rtemp;
        str(reg, Address(SP, -wordSize, pre_indexed));
      }
      mov(reg, 0);
      // DataMemoryBarrier
      emit_int32(0xe << 28 |
                0xe << 24 |
                0x7 << 16 |
                reg->encoding() << 12  |
                0xf << 8  |
                0xb << 4  |
                0xa);
      if(preserve_tmp) {
        ldr(reg, Address(SP, wordSize, post_indexed));
      }
    }
  }
对于有volatile修饰的变量,会在JVM生成的字节码中加入ACC_VOLATILE的标识。后续会调用 OrderAccess::fence()对volatile修饰的变量进行进一步处理,这个函数的实现是与具体平台相关的。
//src/hotspt/os_cpu/linux_arm/orderAccess_linux_arm.hpp:
inline void OrderAccess::fence()      { dmb_sy(); }

inline static void dmb_sy() {
   if (!os::is_MP()) {
     return;
   }
#ifdef AARCH64
   __asm__ __volatile__ ("dmb sy" : : : "memory");
#else
   if (VM_Version::arm_arch() >= 7) {
#ifdef __thumb__
     __asm__ volatile (
     "dmb sy": : : "memory");
#else
     __asm__ volatile (
     ".word 0xF57FF050 | 0xf" : : : "memory");
#endif
   } else {
     intptr_t zero = 0;
     __asm__ volatile (
       "mcr p15, 0, %0, c7, c10, 5"
       : : "r" (zero) : "memory");
   }
#endif
}
可以看到是使用 dmb sy 指令实现的。
通过查询ARM官方的文档我们可以知道,DMB SY的作用:
是一个内存屏障,确保在全系统域内,屏障之前的读写操作 先于 屏障之后的读写操作完成。也就是说禁止重排序。同时它会刷新当前处理器的Store Buffer到其缓存,并处理Invalidate Queue内的消息。
Linux x86
x86 架构拥有相对强内存模型。
- 硬件特性:
- 它没有Invalidate Queue。这意味着一个CPU核心总会看到自己缓存的一致性视图,不会读取到已失效的数据(解决了读可见性问题)。
- 它有Store Buffer,但它遵守“存储转发”(Store Forwarding):如果后续的读操作依赖于Store Buffer中还未提交的数据,CPU会直接从Store Buffer中取数据,保证逻辑正确。
- 除了
StoreLoad情况,x86硬件本身保证了不会对“写-写”和“读-读/写”操作进行重排序。即,它天然保证了StoreStore、LoadLoad和LoadStore屏障的语义。
- 屏障实现:
- 因此,在x86上,JVM只需要为
volatile写操作插入一个StoreLoad屏障,就能同时满足StoreStore和StoreLoad的要求(因为StoreStore是x86天然保证的)。 - 对于
volatile读操作,由于x86天然的LoadLoad和LoadStore保证,JVM不需要插入任何屏障。
- 因此,在x86上,JVM只需要为
- 使用的指令:
- 在x86上,
StoreLoad屏障对应的指令是LOCK前缀或MFENCE指令。LOCK前缀用于修饰一个“读-修改-写”指令(如CMPXCHG),它原子化执行操作的同时,会锁定内存总线,并清空本核心的Store Buffer,相当于一个内存屏障。MFENCE是更轻量级的选择,它专门用于保证内存操作的顺序。
- 在x86上,
对于有volatile修饰的变量,会在JVM生成的字节码中加入ACC_VOLATILE的标识。后续会调用 OrderAccess::fence()对volatile修饰的变量进行进一步处理,简单看下 Linux 平台的 x86 架构的实现。
//src/hotspt/os_cpu/linux_x86/orderAccess_linux_x86.hpp:
inline void OrderAccess::fence() {
   // always use locked addl since mfence is sometimes expensive
#ifdef AMD64
  __asm__ volatile ("lock; addl $0,0(%%rsp)" : : : "cc", "memory");
#else
  __asm__ volatile ("lock; addl $0,0(%%esp)" : : : "cc", "memory");
#endif
  compiler_barrier();
}
可以看到无论是 AMD 64 还是 x86 都是使用 lock addl 指令实现的。
对Class文件查看汇编指令时,被 volatile 修饰的变量,如果对其进行写操作,可以看见会多一个lock前缀的指令:lock addl $0x0,(%rsp)。
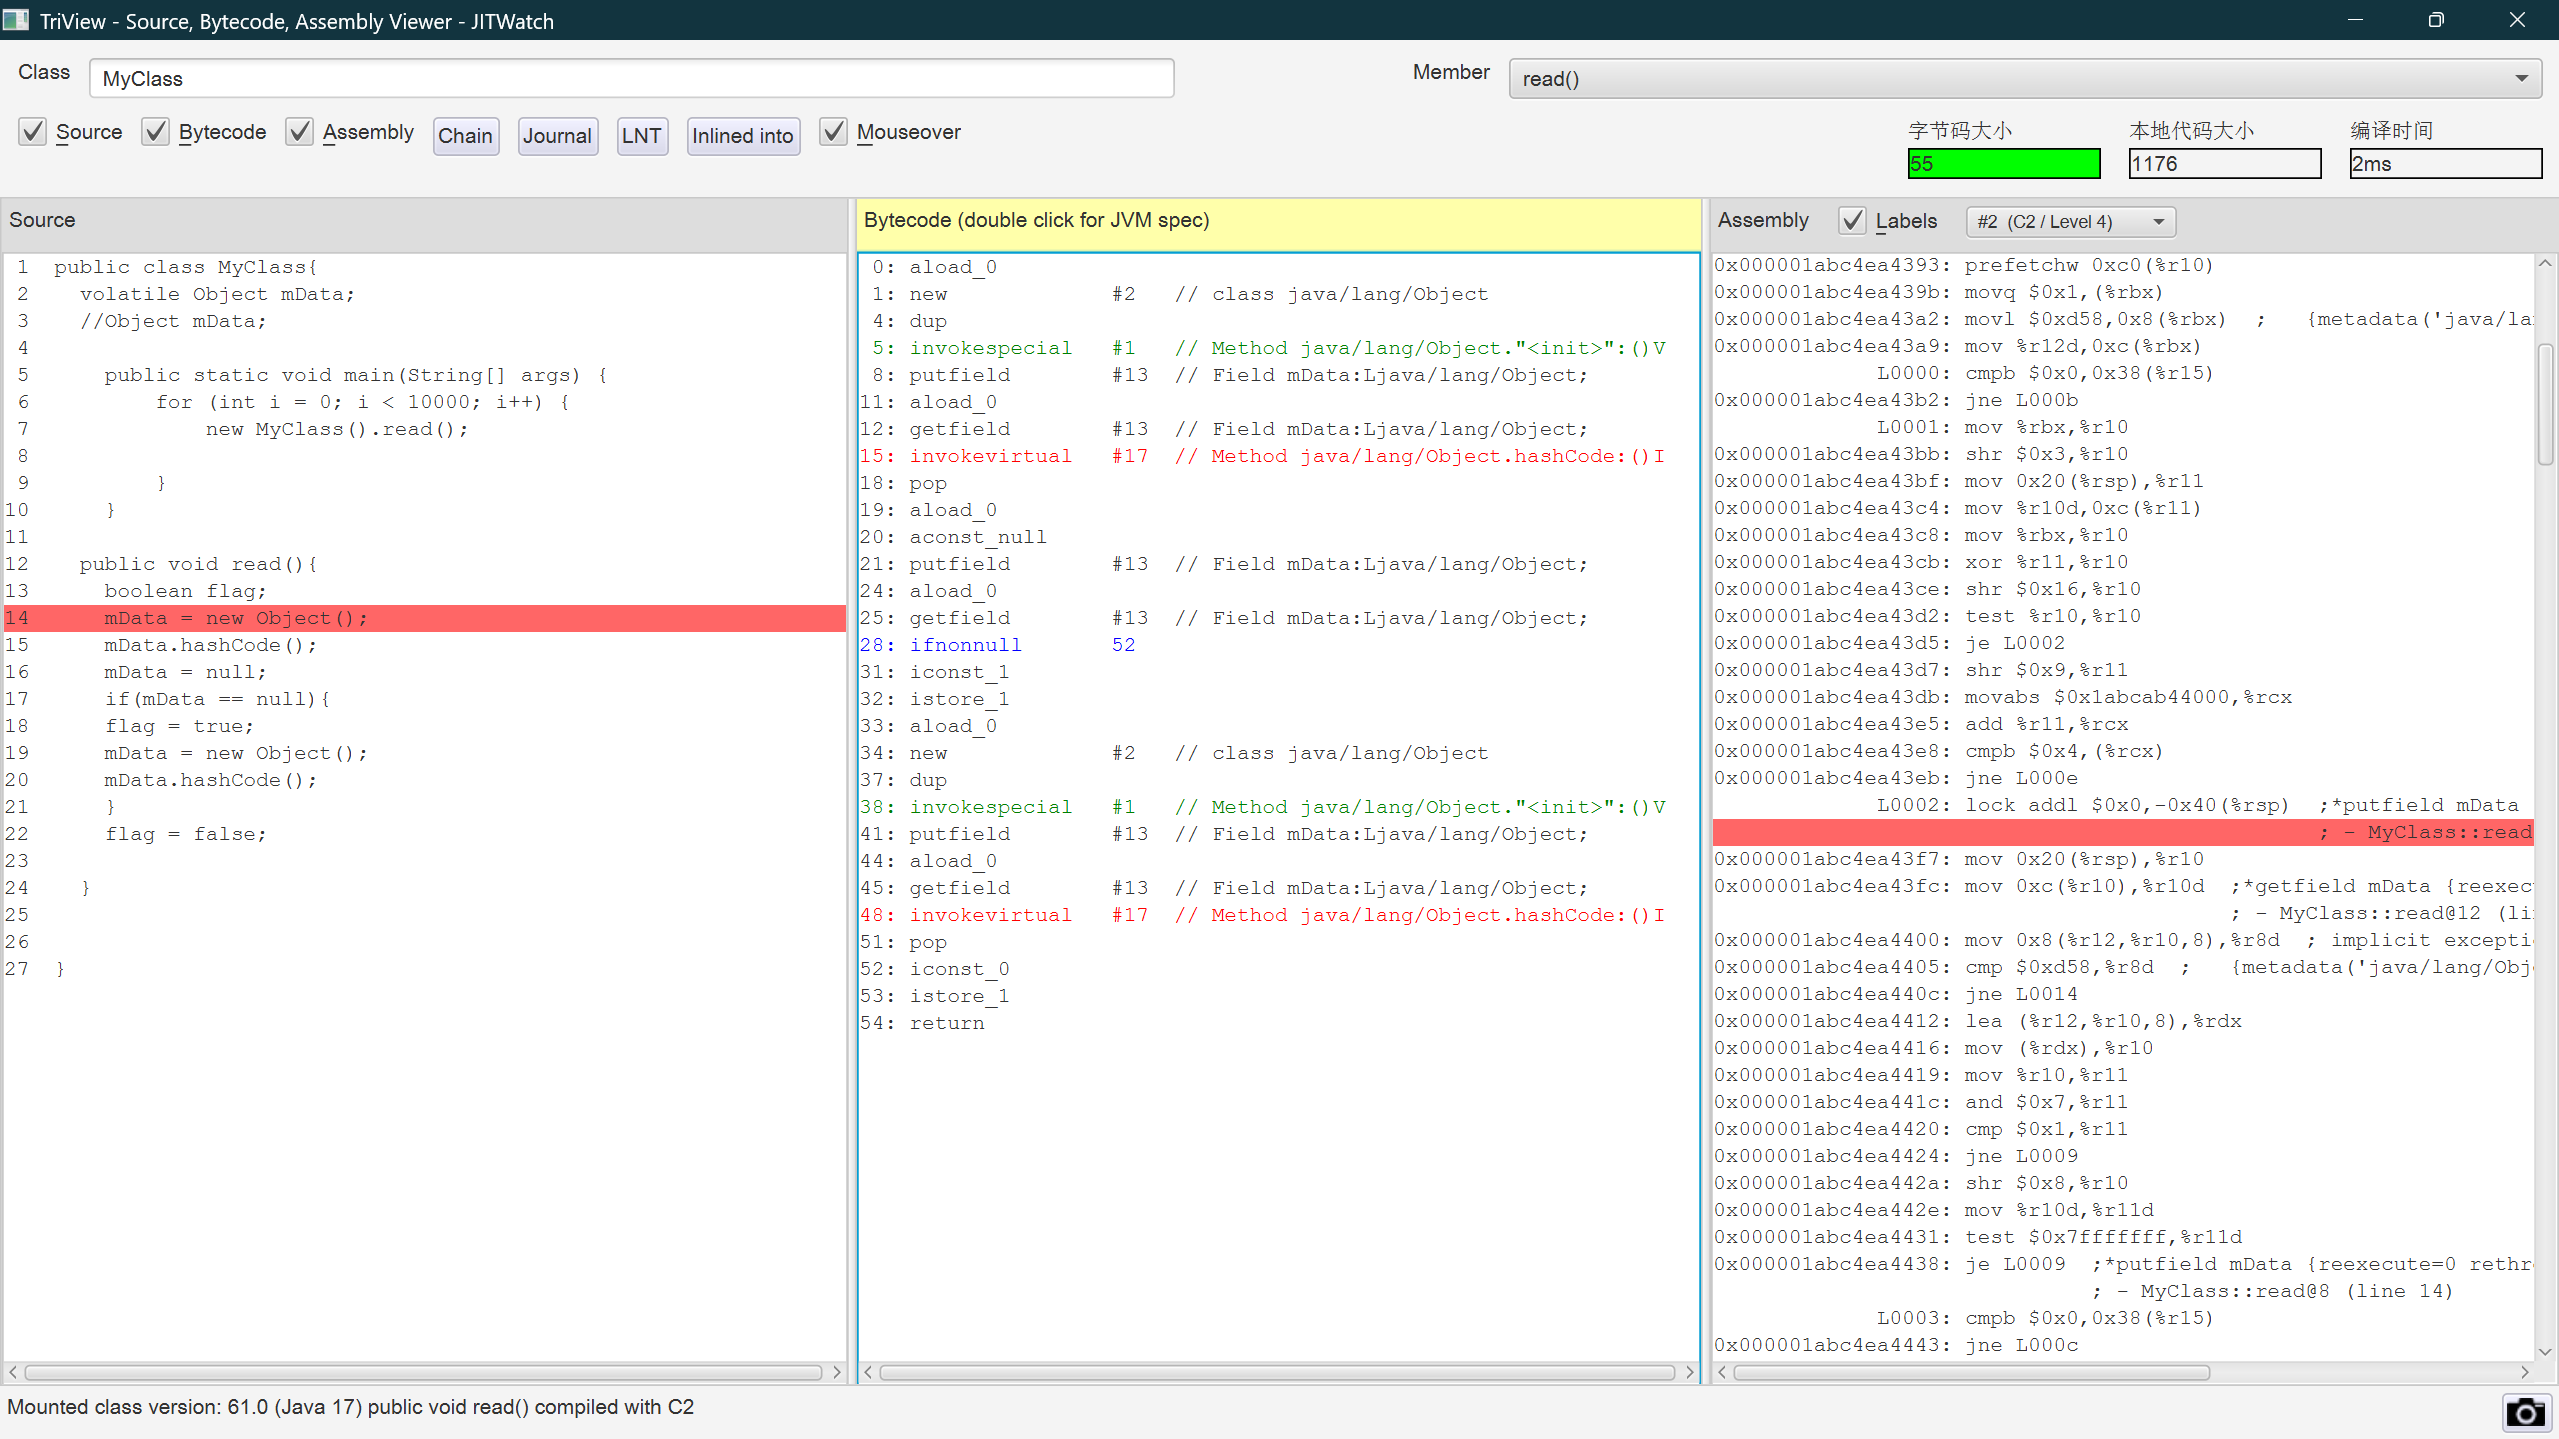
volatile 修饰变量的写操作
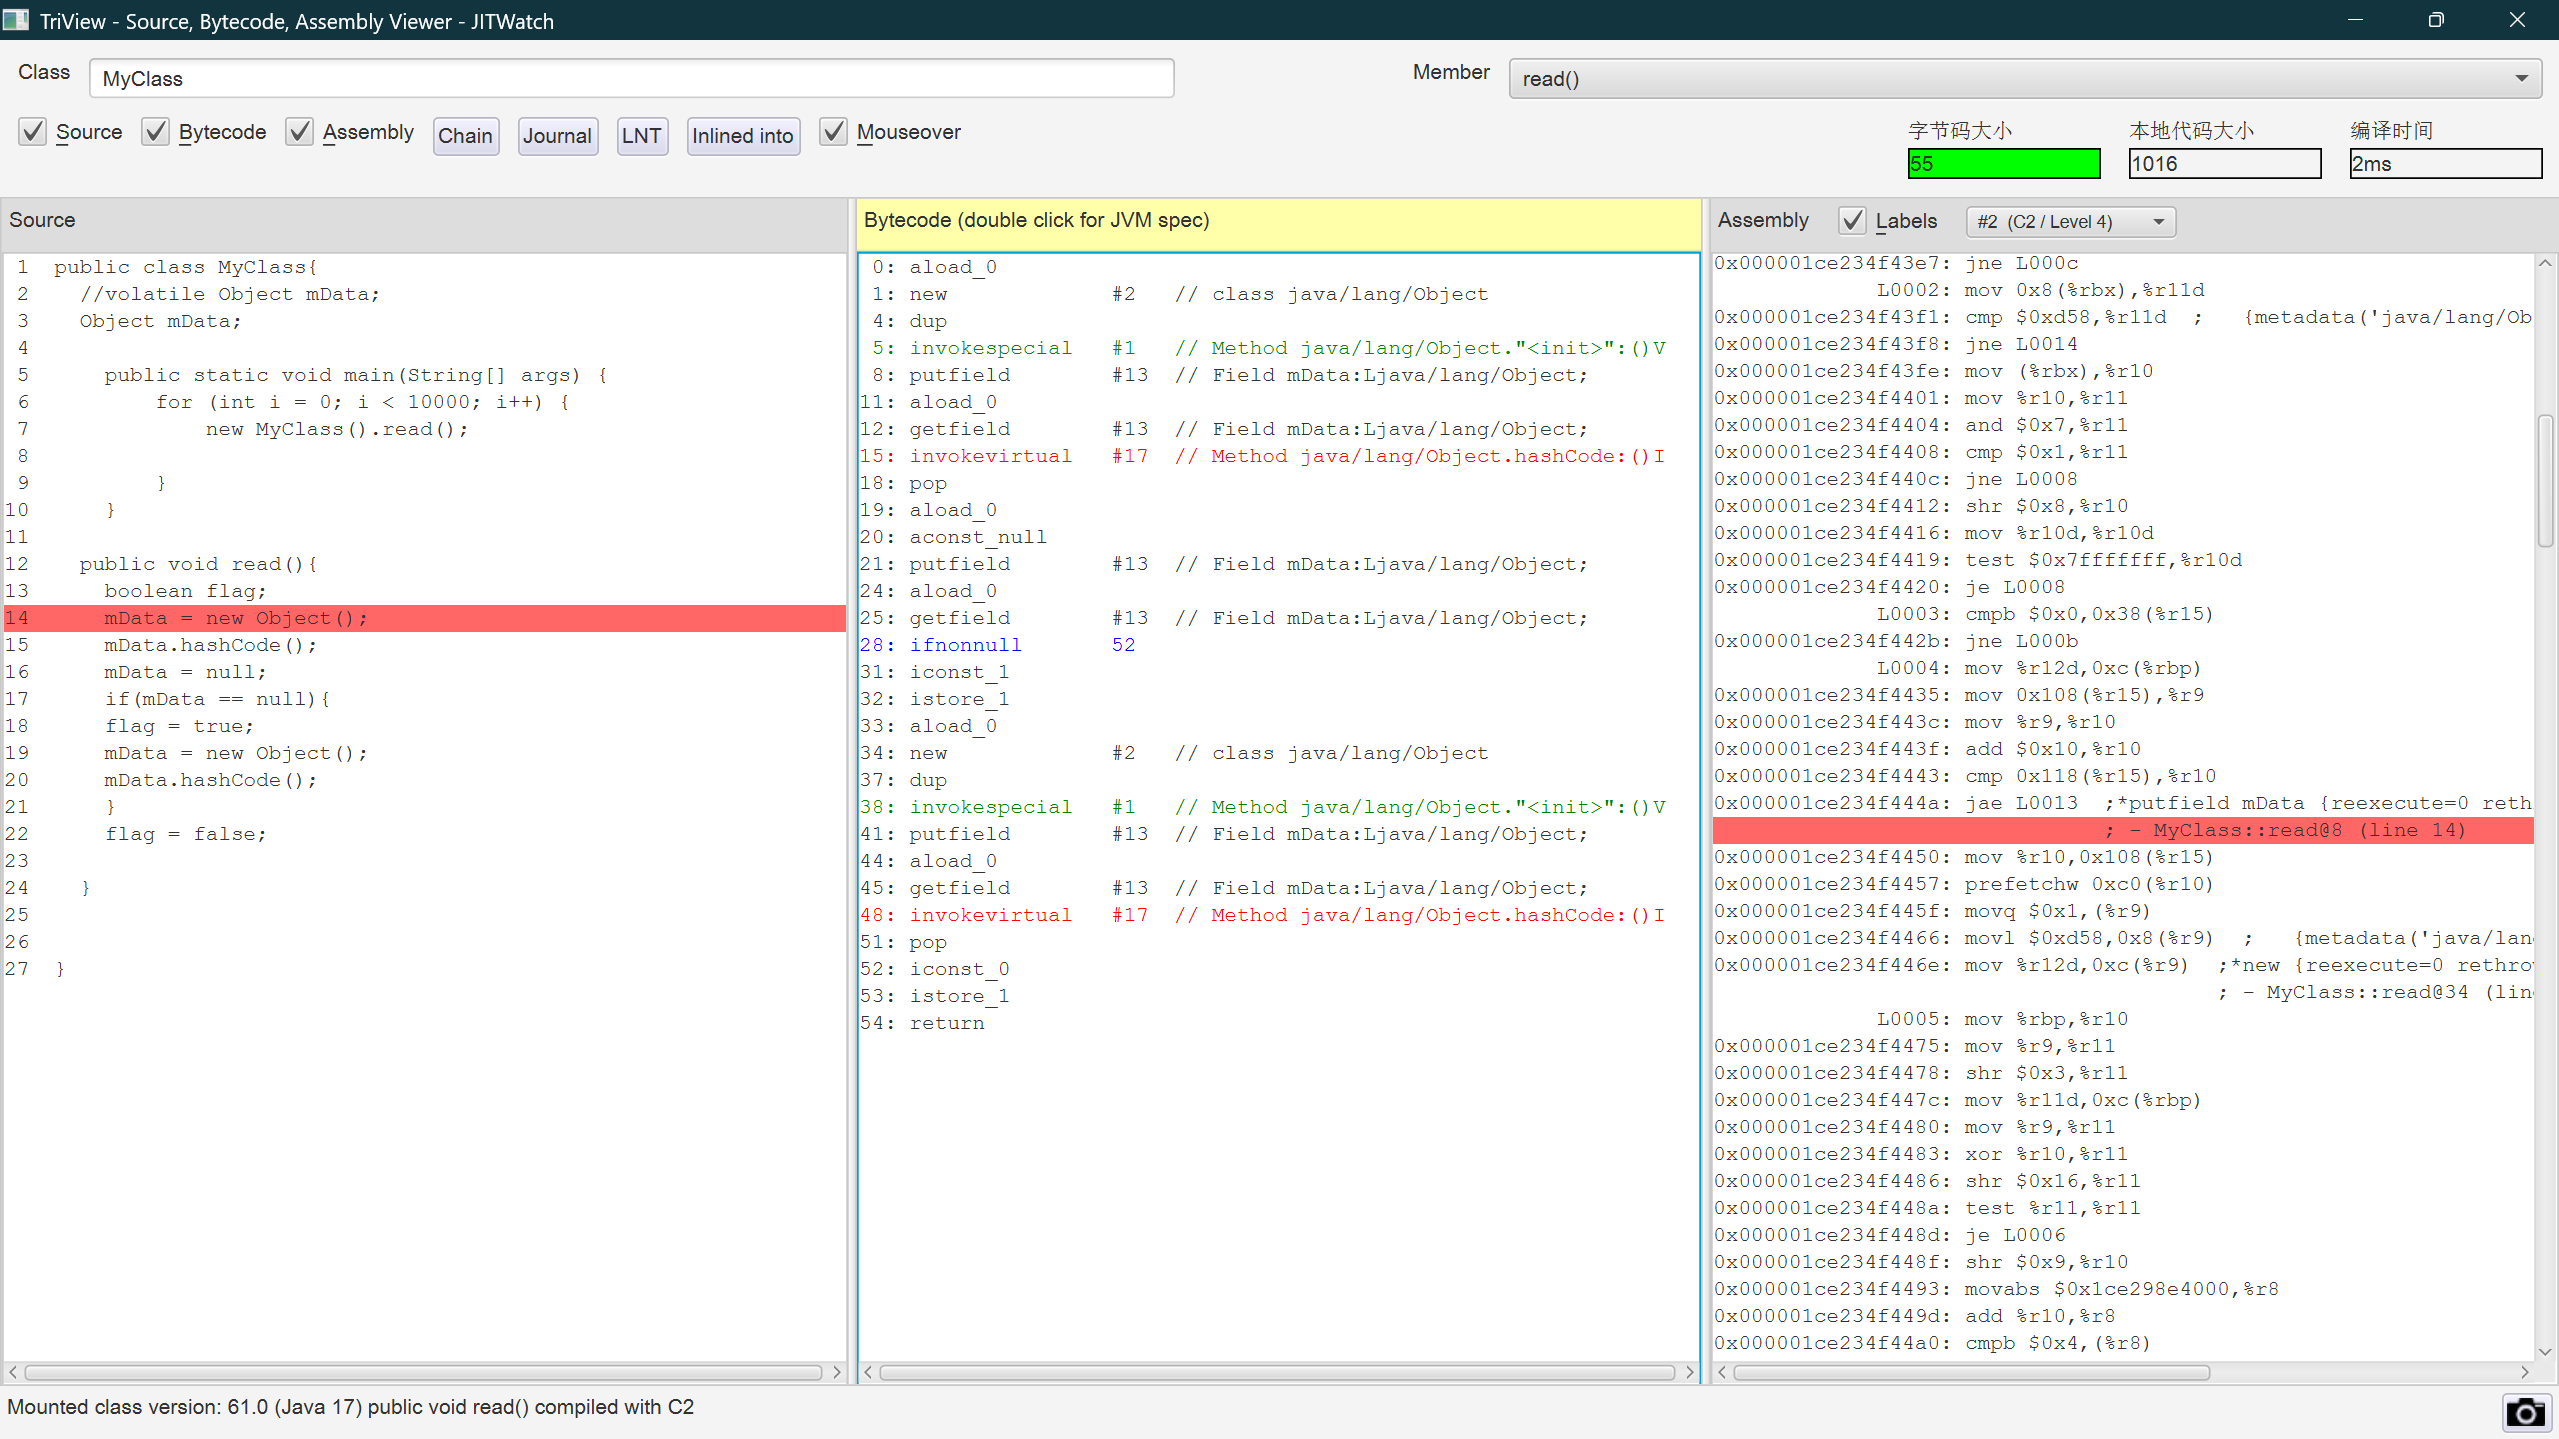
非volatile 修饰变量的写操作
在 x86 上,实际只有 StoreLoad 这一个 Barrier 是有效的,因为x86 上没有 Invalidate Queue,每次 Store 数据又都会去 Store Buffer 排队,所以 StoreStore, LoadLoad 都不需要。x86 又能保证 Store 操作都会走 Store Buffer ,Store 不会被重排到 Load 之前,LoadStore 也是不需要的。只剩下一个 StoreLoad Barrier 在 x86 平台的 JVM 上被使用。
可以看到 x86 下使用的是 lock 来实现 StoreLoad。
这个 LOCK 指令强制将Store Buffer中的数据刷入缓存(并使其他缓存行失效),保证了可见性。同时又作为一个StoreLoad,禁止重排序,保证了有序性。
//https://github.com/openjdk/jdk/blob/9a69bb807beb6693c68a7b11bee435c0bab7ceac/src/hotspot/cpu/x86/assembler_x86.hpp
enum Membar_mask_bits {
    StoreStore = 1 << 3,
    LoadStore  = 1 << 2,
    StoreLoad  = 1 << 1,
    LoadLoad   = 1 << 0
  };

  // Serializes memory and blows flags
  void membar(Membar_mask_bits order_constraint) {
    // We only have to handle StoreLoad
    if (order_constraint & StoreLoad) {
	  //所有可用芯片都支持“lock”指令,这些指令足以作为屏障,
      //并且比使用 cpuid 指令的替代方案快得多。我们在这里使用锁定的添加 [esp-C],0。
      int offset = -VM_Version::L1_line_size();
      if (offset < -128) {
        offset = -128;
      }

      lock();
      addl(Address(rsp, offset), 0);// Assert the lock# signal here
    }
  }
volatile禁止重排序场景
- 第二个操作是volatile写,不管第一个操作是什么都不会重排序到其后面。
- 第一个操作是volatile读,不管第二个操作是什么都不会重排序到其前面。
- 第一个操作时volatile写,第二个操作时volatile读,也不会发生重排序。
禁止使用volatile的条件
在需要原子性时不可以仅使用volatile
没有实现锁。如果多线程并发执行自增操作,结果无法预测。
对变量的写操作依赖于当前值
自增操作(依赖当前值)
public class VolatileExample1 {
    private volatile int count = 0;

    // 线程不安全的自增操作
    public void increment() {
        count++; // 实际是三步操作:读取旧值 → 修改值 → 写回新值
    }
}
问题:
count++ 是 读 → 改 → 写 的复合操作,若多线程同时调用 increment(),可能出现以下情况:
- 线程 A 读取
count=0; - 线程 B 也读取
count=0; - 线程 A 将
count改为 1 并写回; - 线程 B 将
count改为 1 并写回;
最终count实际只增加了 1(而不是预期的 2)。
结论:
对 volatile 变量的写操作如果依赖当前值(如自增),读取->修改->写回,这一系列操作必须是不可分的,否则任一调动链打断,就会导致预期结果无法出现,必须使用 synchronized 或 AtomicInteger。
该变量包含在有其他变量参与的不变式中
多变量依赖的不变式
public class VolatileExample2 {
    private volatile int lower = 0;
    private volatile int upper = 10;

    // 检查 lower <= upper 的不变式
    public boolean isValid() {
        return lower <= upper;
    }

    // 线程 A 调用:设置 lower=5
    public void setLower(int value) {
        if (value > upper) throw new IllegalArgumentException();
        lower = value;
    }

    // 线程 B 调用:设置 upper=4
    public void setUpper(int value) {
        if (value < lower) throw new IllegalArgumentException();
        upper = value;
    }
}
问题:
- 初始状态:
lower=0,upper=10; - 线程 A 调用
setLower(5),检查5 <= 10通过; - 线程 B 调用
setUpper(4),检查4 >= 0通过; - 线程 A 执行
lower=5; - 线程 B 执行
upper=4;
最终lower=5且upper=4,破坏了lower <= upper的不变式。
结论:
若变量与其他变量存在不变式(如 lower <= upper),读取->检查->修改,这一系列操作必须是不可分的,否则任一调动链打断,就会导致预期结果无法出现,仅仅用 volatile 无法保证原子性,需使用 synchronized 或锁机制。
解决:
public class FixedInvariant {
    private int lower = 0;
    private int upper = 10;

    // 用 synchronized 保证原子性
    public synchronized void setLower(int value) {
        if (value > upper) throw new IllegalArgumentException();
        lower = value;
    }

    public synchronized void setUpper(int value) {
        if (value < lower) throw new IllegalArgumentException();
        upper = value;
    }
}
原理:
- 线程 A 调用
setLower(5)时,会获取对象锁。 - 线程 B 调用
setUpper(4)时,必须等待线程 A 释放锁。 - 线程 A 的
检查 → 修改操作是原子的,不会被线程 B 打断。 - 最终
lower=5,upper=10(因为线程 B 的setUpper(4)会因4 < 5抛出异常)。
常使用volatile的场景
状态标志
简单布尔值控制线程启停。
实际应用有:Livedata#postValue的延迟推送数据。
需求:一个线程需要根据另一个线程设置的标志终止循环。
示例:
public class ShutdownThread {
    private volatile boolean shutdownRequested = false;

    // 工作线程
    public void doWork() {
        while (!shutdownRequested) {
            // 执行任务...
        }
        System.out.println("线程安全退出");
    }

    // 外部线程调用此方法终止工作线程
    public void shutdown() {
        shutdownRequested = true;
    }
}
解释:
- 为什么用
volatile:
工作线程需要立即感知shutdownRequested被修改为true。
若不用volatile,工作线程可能因本地缓存问题,永远无法检测到shutdownRequested的变化。 - 符合条件:
对shutdownRequested的写操作是直接赋值(不依赖当前值),且不参与其他变量的不变式。
安全发布对象
如单例模式中的双重检查锁定。
需求:实现线程安全的单例模式。
示例:
public class Singleton {
    private static volatile Singleton instance;

    private Singleton() {}

    public static Singleton getInstance() {
        if (instance == null) {
            // 第一次检查:避免更多的锁竞争
            //(每个线程都竞争进入接下来的synchronized代码块,只需要instance为不空,就没必要竞争,直接返回结果。
            // instance是volatile对象,只要被创建,内存屏障立马通知其他核心更新,减少后续锁竞争)
            synchronized (Singleton.class) {
                //使用synchronized是为了保证原子性、以及!可见性!
                if (instance == null) {
                    // 第二次检查:避免多次重复new:线程2经过判断为null,准备竞争锁去创建对象,
                    // 但是线程1已经在创建对象,instance指向完全初始化的对象后,内存屏障立马通知其他核心更新,
                    // 线程1释放锁,线程2进入锁判断发现不为null结束。
                    instance = new Singleton();
                    // volatile 的作用主要是禁止指令重排序,保证一定完全初始化
                }
            }
        }
        return instance;
    }
}
解释:
-
为什么用
volatile: -
当通过
new Singleton()创建一个对象时,实际会经历以下步骤:instance = new Singleton(); // 实际分为 3 步: //1. 分配内存空间(堆内存中开辟一块内存) //2. 调用构造方法初始化对象(执行 `private Singleton() {}`) //3. 将 `instance` 引用指向分配的内存地址(赋值操作)new Singleton()的步骤可能被 JVM 重排序为:- 分配内存空间;
- 将引用指向内存(此时
instance != null); - 调用构造方法初始化对象
若没有volatile,其他线程可能拿到未初始化的instance。
-
符合条件:
instance的写操作是直接赋值,且不依赖其他变量。
观察者模式
状态变更的即时通知。
需求:一个线程更新状态,其他线程需要立即感知。
示例:
public class SensorDataMonitor {
    private volatile double currentTemperature;

    // 传感器线程调用此方法更新温度
    public void updateTemperature(double temperature) {
        currentTemperature = temperature;
    }

    // 监控线程调用此方法获取最新温度
    public void displayTemperature() {
        System.out.println("当前温度:" + currentTemperature);
    }
}
解释:
- 为什么用
volatile:
确保监控线程能立即读取到传感器线程写入的最新温度值。
若不用volatile,监控线程可能因缓存问题读到旧值。 - 符合条件:
直接赋值,不依赖当前值,且独立于其他变量。
读多写少的计数器
写操作冲突极少时的高性能读取。
需求:一个计数器,写操作极少,读操作频繁。
示例:
public class LowContentionCounter {
    private volatile int count = 0;

    // 仅偶尔调用此方法
    public void increment() {
        count++;  // 不保证原子性,但写操作极少时冲突概率低
    }

    // 频繁调用此方法
    public int getCount() {
        return count;  // volatile 保证读取最新值
    }
}
解释:
- 为什么用
volatile:
写操作极少时,volatile的可见性足够满足需求,且比synchronized或AtomicInteger性能更高。 - 风险:
count++不是原子操作,写操作较多时需改用AtomicInteger。
synchronized (/ˈsɪŋkrənʌɪz/)
- Synchronized可以作用在哪里? 分别通过对象锁和类锁进行举例。
- Synchronized本质上是通过什么保证线程安全的? 分三个方面回答:加锁和释放锁的原理,可重入原理,保证可见性原理。
- Synchronized由什么样的缺陷? Java Lock是怎么弥补这些缺陷的。
- Synchronized和Lock的对比,和选择?
- Synchronized在使用时有何注意事项?
- Synchronized修饰的方法在抛出异常时,会释放锁吗?
- 多个线程等待同一个Synchronized锁的时候,JVM如何选择下一个获取锁的线程?
- Synchronized使得同时只有一个线程可以执行,性能比较差,有什么提升的方法?
- 我想更加灵活的控制锁的释放和获取(现在释放锁和获取锁的时机都被规定死了),怎么办?
- 什么是锁的升级和降级? 什么是JVM里的偏斜锁、轻量级锁、重量级锁?
- 不同的JDK中对Synchronized有何优化?
使用注意
在应用Sychronized关键字时需要把握如下注意点:
- 一把锁只能同时被一个线程获取,没有获得锁的线程只能等待;
- 核心原则:锁的粒度越小越好,持有时间越短越好!也就是说尽可能的选择同步代码块,而不是同步方法。
- synchronized(this)、synchronized(非static方法),意味着每个实例都对应有自己的一把锁,不同实例之间互不影响;synchronized(*.class)、synchronized(static方法)的时候,所有实例公用同一把锁。
- synchronized(非this) 比 synchronized(this) 可以实现更细致的颗粒度。
- synchronized修饰的方法,无论方法正常执行完毕还是抛出异常,最后都会释放锁
synchronized修饰的目标
从修饰的目标来分可以分为实例对象锁、类对象锁。
实例对象锁
synchronized(object)、 synchronized(this)、synchronized(非static方法)。
synchronized(非static方法)、synchronized(this) 对比
对于一些方法中,可能存在着不需要同步的代码块,那么只需要用synchronized(this)修饰部分需要同步的代码块即可。性能比synchronized(非static方法),修饰一整个方法好。
public class Counter {
    private int count = 0;

    // synchronized修饰非static方法
    // 锁是当前的 Counter 实例对象,例如 counter1, counter2
    // 当一个线程访问 某个实例 的同步方法时,该实例会被锁定。
    // 其他线程要访问同一个实例的任何一个同步方法都会被阻塞。
    // 但不同实例之间的同步方法互不干扰。
    public synchronized void increment() {
        count++;
    }

    public void decrement() {
        Do Something
        // 确保所有对共享资源(这里的 count)的相关操作(包括读取、判断、修改)都放在同步块内
        // 锁是当前实例 (this),效果同synchronized修饰非static方法
        synchronized (this) {
            count--;
        }
    }

}
synchronized(非this)、 synchronized(this) 对比
如果一个类中有很多个synchronized方法或者synchronized(this),在同一个实例中,synchronized方法或者synchronized(this)之间会互斥。
但如果使用synchronized(非this),与 synchronized(非this)代码块 、 synchronized方法、synchronized(this) 之间是非互斥的,它们之间锁的对象不同。
public class Counter {
    private int count = 0;
    // 专门用于做锁的对象,通常声明为 final
    private final Object lock = new Object();
    public void increment() {
        // 锁是自定义的 lock 对象
        synchronized (lock) {
            count++;
        }
    }

    public void reset() {
        // 锁是类的 Class 对象,效果同同步静态方法
        synchronized (Counter.class) {
            count = 0;
        }
    }
}
类对象锁
synchronized(*.class)、synchronized(static方法)对比
对于一些方法中,可能存在着不需要同步的代码块,那么只需要用synchronized(*.class)修饰部分需要同步的代码块即可。性能比synchronized(static方法),修饰一整个方法好。
public class MyClass {
    // 静态同步方法
    public static synchronized void staticSyncMethod() {
        // 使用MyClass.class作为锁
    }

    // 实例方法中的同步代码块
    public void instanceMethod() {
        synchronized(MyClass.class) {
            // 同样使用MyClass.class作为锁
        }
    }
}
线程A调用staticSyncMethod()时,线程B若尝试进入instanceMethod()的同步块,会被阻塞,反之亦然。
当 synchronized(static方法)、synchronized(*.class)时,锁的是当前类的 Class 对象,不属于某个对象。当前类的 Class 对象锁被获取,不影响 实例对象锁 的获取,两者不互斥,本质上是 this 和 Class 的不同。
由于静态成员变量不专属于任何一个对象,因此通过 Class 锁可以控制静态成员变量的并发操作。
需要注意的是如果线程 A 调用了一个对象的非静态 synchronized 方法,线程 B 需要调用这个对象所属类的静态 synchronized 方法,是不会发生互斥的!因为访问静态 synchronized 方法占用的锁是当前类的Class对象,而访问 非静态 synchronized 方法占用的锁是当前对象(this)的锁。
原子性实现(加锁和释放锁)的原理
原子性,简单的的说就是一个线程在执行过程中不会被其他线程干扰。
直接看看synchronized修饰的方法、代码块背后的原理。
public void test(Object value){
        boolean postTask;
        synchronized (lock) {
            postTask = pendingData == NOT_SET;
            pendingData = value;
        }
        if (!postTask) {
            return;
        }
        setValue(value);
	}

public synchronized void setValue(Object value){
		mData = pendingData;
		pendingData = NOT_SET;
}

//反编译结果
public void test(java.lang.Object);
    descriptor: (Ljava/lang/Object;)V
    flags: (0x0001) ACC_PUBLIC
    Code:
      stack=2, locals=5, args_size=2
         0: aload_0
         1: getfield      #7                  // Field lock:Ljava/lang/Object;
         4: dup
         5: astore_3
-------------------------------
         6: monitorenter
         7: aload_0
         8: getfield      #16                 // Field pendingData:Ljava/lang/Object;
        11: aload_0
        12: getfield      #13                 // Field NOT_SET:Ljava/lang/Object;
        15: if_acmpne     22
        18: iconst_1
        19: goto          23
        22: iconst_0
        23: istore_2
        24: aload_0
        25: aload_1
        26: putfield      #16                 // Field pendingData:Ljava/lang/Object;
        29: aload_3
        30: monitorexit
------------------------------
        31: goto          41
        34: astore        4
        36: aload_3
------------------------------
        37: monitorexit
        38: aload         4
        40: athrow
        41: iload_2
        42: ifne          46
        45: return
        46: aload_0
        47: aload_1
        48: invokevirtual #19                 // Method setValue:(Ljava/lang/Object;)V
        51: return

public synchronized void setValue(java.lang.Object);
    descriptor: (Ljava/lang/Object;)V
--------flags: (0x0021) ACC_PUBLIC, ACC_SYNCHRONIZED -------------------
    Code:
      stack=2, locals=2, args_size=2
         0: aload_0
         1: aload_0
         2: getfield      #16                 // Field pendingData:Ljava/lang/Object;
         5: putfield      #23                 // Field mData:Ljava/lang/Object;
         8: aload_0
         9: aload_0
        10: getfield      #13                 // Field NOT_SET:Ljava/lang/Object;
        13: putfield      #16                 // Field pendingData:Ljava/lang/Object;
        16: return
      LineNumberTable:
        line 20: 0
        line 21: 8
        line 22: 16
从反编译的结果来看,JVM对于同步方法和同步代码块的处理方式不同,对于同步方法,JVM采用ACC_SYNCHRONIZED标记符来实现同步;而对于同步代码块,JVM则采用 monitorenter和monitorexit 这两个指令实现同步。
ACC_SYNCHRONIZED标记符
当某个线程要访问某个方法的时候,会检查是否有ACC_SYNCHRONIZED标志,如果有设置,则需要先获得锁,然后开始执行方法,方法执行之后再释放锁。
这时如果其他线程来请求执行方法,会因为无法获得锁而被阻塞。值得注意的是,如果在方法执行过程中,发生了异常,并且方法内部并没有处理该异常,那么在异常被抛到方法外面之前,监视器锁会被自动释放。
Synchronized锁的原理
锁对象
锁其实就是一个对象,每一个对象都能够作为synchronized的锁。
HotSpot JVM中,对象在内存中存储的结构可以分为三种:对象头(Object Header)、实例数据(Instance Data)和对齐填充(Padding)。
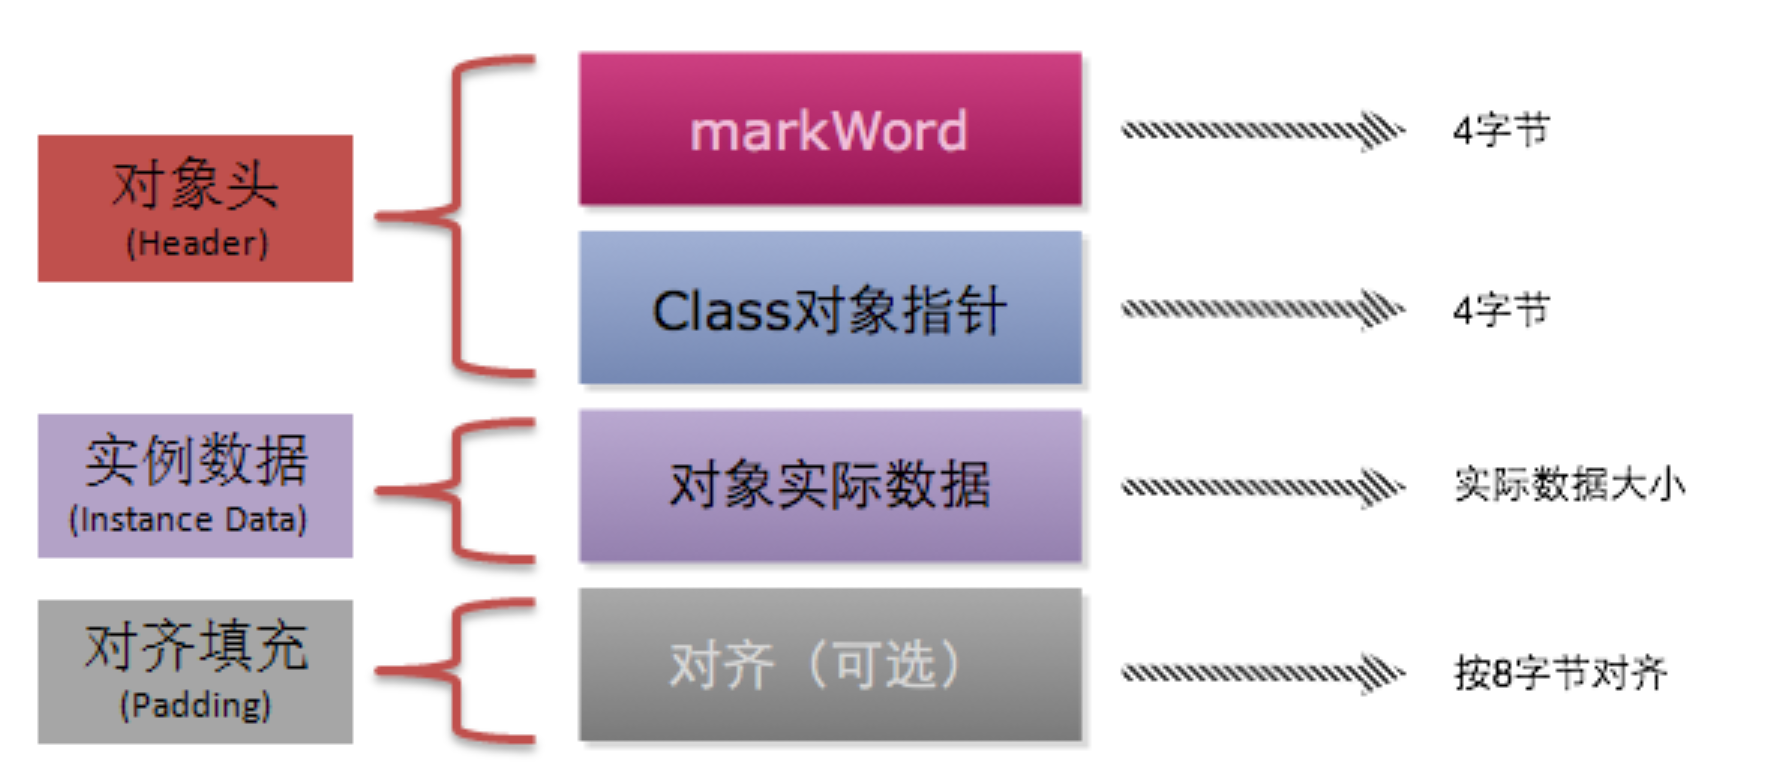
锁对象的信息是存储在对象头(Object Header)中的,主要是一个叫Mark Word的区域。
| 长度 | 内容 | 说明 |
|---|---|---|
| 32/64bit | Mark Word | 存储对象的 hashCode 、锁信息等 |
| 32/64bit | Class Metadata Address | 类型指针指向对象的类元数据,JVM通过这个指针确定该对象是哪个类的实例。 |
| 32/64bit | Array length | 数组的长度(如果是数组) |
Mark Word 的格式:
| 状态 | 29 bit 或 61 bit | 1 bit 是否支持偏向锁? | 2 bit 锁标志位 |
|---|---|---|---|
| 未锁定 | hashcode、GC年龄 | 0 | 01 |
| 可偏向 | 持有偏向锁的线程ID、epoch偏向时间戳、GC年龄 | 1 | 01 |
| 轻量级锁定 | 指向线程的栈中Lock Record的指针 |
向左合并,用于记录指针 | 00 |
| 重量级锁定 | 指向对象的管程Monitor的指针 |
向左合并,用于记录指针 | 10 |
| GC 标记 | - | - | 11 |
四种锁状态
在 JDK 1.6 及其以后,一个对象作为synchronized的锁有四种锁状态,它们级别由低到高依次是:
- 无锁状态
- 偏向锁状态:匿名可偏向锁、可偏向的偏向锁、不可偏向的偏向锁、禁用偏向的偏向锁
- 匿名可偏向锁: 偏向锁线程ID为空;低三位为101
- 可偏向的偏向锁: 就是我们认知的偏向锁,通过CAS进行更新锁对象头的Mark Word线程ID;
- 不可偏向的偏向锁:可以理解只偏向一次,一旦被指向一个线程,再有线程竞争直接升级锁;
- 禁用偏向的偏向锁:单个类偏向撤销的计数达到 20,就会进行批量重偏向。距上次批量重新偏向(偏向T1重新偏向到T2) 25 秒内,
Klass的锁撤销计数达到 40,就会发生批量撤销,此时JVM会认为这个类不适合使用偏向锁,由此会禁用此类的偏向锁,低三位变为001,如果有竞争直接升级为轻量锁。
- 轻量级锁状态
- 重量级锁状态
几种锁会随着竞争情况逐渐升级,锁的升级很容易发生,但是锁降级发生的条件就比较苛刻了,锁降级只发生在Stop The World阶段。
锁升级流程
无锁
一个对象刚被创建出来,还没有任何线程来竞争它,此时处于无锁状态。低三位为001。
JVM启动时会延时初始化偏向锁,默认是4000ms。之所以需要延时初始化偏向锁,是JVM启动时是多线程启动,如果一开始就初始化偏向锁,可能会引发锁升级导致启动速度下降。
在初始化之前创建的对象为无锁状态。
初始化后会将所有加载的Klass#prototype_header修改为匿名可偏向样式(当创建一个对象时,会通过Klass#prototype_header来初始化该对象的对象头)。
也就是说初始化结束后,所有对象的对象头Mark Word都为匿名可偏向状态,指向线程的ID为空,低三位101。
**而对于无锁状态的锁对象,如果有竞争,会直接进入到轻量级锁。**这也是为什么JVM启动前4秒,如果锁对象有竞争会直接进入到轻量级锁的原因。
因此只有锁对象处于匿名可偏向状态,线程才能拿到偏向锁。而处于无锁状态的锁对象,只能进入到轻量级锁状态。
补充:匿名可偏向状态,意味着对象的Mark Word没有保存对象的hashcode!!!如果计算hashcode后,第一次获取锁就直接是轻量级锁;如果在同步块执行时,计算hashcode,锁会直接升级为重量级锁。
偏向锁 (Biased Locking)
偏向锁的目的是:消除在无竞争情况下(即锁始终由一个线程持有)的同步开销。它的假设是极端的:“这个锁一旦被第一个线程获得,以后就再也不会被其他线程竞争了”。
加锁
CASE(_monitorenter): {
  //锁对象
  oop lockee = STACK_OBJECT(-1);
  // derefing's lockee ought to provoke implicit null check
  CHECK_NULL(lockee);
  // 1
  // 在栈中找到第一个空闲的Lock Record
  // 会找到栈中最高的
  BasicObjectLock* limit = istate->monitor_base();
  BasicObjectLock* most_recent = (BasicObjectLock*) istate->stack_base();
  BasicObjectLock* entry = NULL;
  while (most_recent != limit ) {
    if (most_recent->obj() == NULL) entry = most_recent;
    else if (most_recent->obj() == lockee) break;
    most_recent++;
  }
  // entry不为null,代表还有空闲的Lock Record
  if (entry != NULL) {
    // 将Lock Record的obj指针指向锁对象
    entry->set_obj(lockee);
    int success = false;
    uintptr_t epoch_mask_in_place = (uintptr_t)markOopDesc::epoch_mask_in_place;
    // markoop即锁对象头的mark word
    markOop mark = lockee->mark();
    intptr_t hash = (intptr_t) markOopDesc::no_hash;
    // 2
    // implies UseBiasedLocking
    // 如果为偏向模式,即判断标识位是否为101
    if (mark->has_bias_pattern()) {
      uintptr_t thread_ident;
      uintptr_t anticipated_bias_locking_value;
      thread_ident = (uintptr_t)istate->thread();
     // code 4:这里有几步操作,下文分析
      anticipated_bias_locking_value =
          //计算 是否偏向、 Klass是否开启偏向模式、 Epoch是否过期
          //klass()->prototype_header() 包含是否开启偏向模式、Klass的Epoch
        (((uintptr_t)lockee->klass()->prototype_header() | thread_ident)
         ^ (uintptr_t)mark) //当前锁对象的Mark Word
         &~((uintptr_t) markOopDesc::age_mask_in_place); //忽略GC Age
      // 4
      if  (anticipated_bias_locking_value == 0) {
        // already biased towards this thread, nothing to do
        // 偏向的是自己 且 Klass开启偏向模式 且 Epoch未过期,啥都不做
        if (PrintBiasedLockingStatistics) {
          (* BiasedLocking::biased_lock_entry_count_addr())++;
        }
        success = true;
      }
      // 3
      // class的prototype_header不是偏向模式
      else if ((anticipated_bias_locking_value & markOopDesc::biased_lock_mask_in_place) != 0) {
        // 尝试撤销偏向 用klass()->prototype_header()替换掉对象的Mark Word
        // 大概率是恢复无锁状态
        markOop header = lockee->klass()->prototype_header();
        if (hash != markOopDesc::no_hash) {
          header = header->copy_set_hash(hash);
        }
        // 利用CAS操作将mark word替换为class中的mark word
        if (Atomic::cmpxchg_ptr(header, lockee->mark_addr(), mark) == mark) {
          if (PrintBiasedLockingStatistics)
            (*BiasedLocking::revoked_lock_entry_count_addr())++;
        }
      }
      // epoch过期,重新偏向
      else if ((anticipated_bias_locking_value & epoch_mask_in_place) !=0) {
        // 构造一个偏向当前线程的mark word
        markOop new_header = (markOop) ( (intptr_t) lockee->klass()->prototype_header() | thread_ident);
        if (hash != markOopDesc::no_hash) {
          new_header = new_header->copy_set_hash(hash);
        }
        // CAS替换对象头的mark word
        if (Atomic::cmpxchg_ptr((void*)new_header, lockee->mark_addr(), mark) == mark) {
          if (PrintBiasedLockingStatistics)
            (* BiasedLocking::rebiased_lock_entry_count_addr())++;
        }
        else {
          // 重偏向失败,代表存在多线程竞争,则调用monitorenter方法进行锁升级
          CALL_VM(InterpreterRuntime::monitorenter(THREAD, entry), handle_exception);
        }
        success = true;
      }
      else {
        // try to bias towards thread in case object is anonymously biased
        // 尝试偏向该线程,只有匿名可偏向能成功
        // 构建了匿名可偏向的mark word
        markOop header = (markOop) ((uintptr_t) mark & ((uintptr_t)markOopDesc::biased_lock_mask_in_place |(uintptr_t)markOopDesc::age_mask_in_place |epoch_mask_in_place));
        if (hash != markOopDesc::no_hash) {
          header = header->copy_set_hash(hash);
        }
        // 用位运算设置thread ID
        markOop new_header = (markOop) ((uintptr_t) header | thread_ident);、
        // 只有匿名可偏向才能成功
        if (Atomic::cmpxchg_ptr((void*)new_header, lockee->mark_addr(), header) == header) {
          // CAS修改成功
          if (PrintBiasedLockingStatistics)
            (* BiasedLocking::anonymously_biased_lock_entry_count_addr())++;
        }
        else {
          // 失败说明存在竞争,进入monitorenter
          CALL_VM(InterpreterRuntime::monitorenter(THREAD, entry), handle_exception);
        }
        success = true;
      }
    }
    // 5
    // traditional lightweight locking
    // false走轻量级锁逻辑
    // 这是偏向锁、轻量锁混用的代码
    // T1持有偏向锁A,T2争夺A,CAS必然失败,走向InterpreterRuntime::monitorenter
    // T1持有轻量锁B,T2争夺B,CAS可能成功,因为T1此时可能释放了锁
    if (!success) {

      //lockee是锁对象,创建一个以其Mark Word作为蓝本的无锁状态Mark Word
      //然后写入Lock Record的Displaced Mark Word
      markOop displaced = lockee->mark()->set_unlocked();
      entry->lock()->set_displaced_header(displaced);

      bool call_vm = UseHeavyMonitors;
      //CAS操作,锁对象头现在的Mark Word 修改为 指向Lock Record的指针
      //这里还有需要注意的!:
	  //轻量级锁的锁标志位为 00,转换为数字后就是 4 的倍数。
      //比如 0100 表示 4, 1000 表示 8。
	  //如果 Lock Record 的地址是均为 4 的倍数,那么设置完 Lock Record 地址后,
      //Mark Word 的末两位值就是 00 了,就是说一个操作完成了两件事:
	  //第一件事情: 将锁对象头的Mark Word修改成指向Lock Record的指针
	  //第二件事情: 因为Lock Record的地址 均为4的倍数 ,即 锁标志位修改为00
      if (call_vm || Atomic::cmpxchg_ptr(entry, lockee->mark_addr(), displaced) != displaced) {
        // 如果锁对象是偏向锁,CAS必然不成功
        //偏向锁,锁对象的Mark Word低三位是101,刚刚构建的Mark Word低三位是001,CAS必然失败,只能走向锁升级。
        // 如果锁对象是无锁状态/轻量级锁,CAS有可能成功。
        // 如果成功,说明此时锁对象已经被释放,可以获取
        // 如果失败,说明此时锁对象仍然被持有,只能走向判断是否重入或者锁升级
        // 这里是判断是否是轻量锁重入,不是偏向锁,偏向锁的在上方
        if (!call_vm && THREAD->is_lock_owned((address) displaced->clear_lock_bits())) {
          // 如果是锁重入,则直接将Displaced Mark Word设置为null
          // 因为轻量级锁重入是使用lock record的数量来计入的
          entry->lock()->set_displaced_header(NULL);
        } else {
          CALL_VM(InterpreterRuntime::monitorenter(THREAD, entry), handle_exception);
        }
      }
    }
    UPDATE_PC_AND_TOS_AND_CONTINUE(1, -1);
  } else {
    // 没拿到lock record,重新执行
    istate->set_msg(more_monitors);
    UPDATE_PC_AND_RETURN(0); // Re-execute
  }
}
第一个线程T1访问synchronized同步块时:
1.在T1栈顶找到空闲Lock Record(都是预先创建好了的),
2.检查锁对象头的Mark Word低三位是否为101?
2.1 不是101,锁升级
3.是101,检查Mark Word的线程ID是否为自己?
4.线程ID是自己,则直接获得锁,success = true;
3.1 线程ID不是自己,检查Klass是否支持偏向?
3.1.1 不支持偏向,使用CAS将Klass#prototype_header替换 Mark Word,无论CAS是否成功都会进入5(没有设置success = true)。
3.2 线程ID不是自己,Klass支持偏向,检查epoch是否等于Klass#epoch?
3.2.1 不等于:通过CAS重偏向(说明锁偏向过给其他线程,但是被释放了,现在可以重新偏向)
3.2.2 CAS成功,T1持有锁。success = true。
3.2.3 CAS失败,说明还有锁竞争,锁撤销+锁升级:InterpreterRuntime::monitorenter。
3.3 线程ID不是自己,Klass支持偏向,epoch等于Klass#epoch,如果对象是匿名可偏向状态(即未偏向任何线程,线程ID为空;如果不是匿名可偏向状态,success == false)
3.4 T1进行CAS操作,将自己的线程ID写入锁对象头的Mark Word。
3.4.1 如果CAS成功,那么T1就持有了偏向锁。success = true。
3.4.2 如果失败,说明还有锁竞争,锁撤销+锁升级:InterpreterRuntime::monitorenter。
5.如果success == false:
5.1 如果强制使用重量级锁,走向InterpreterRuntime::monitorenter。
5.2 如果不强制使用,修改锁对象头的Mark Word为无锁状态(001),然后复制到线程T1的Lock Record中,然后使用CAS将锁对象头的Mark Word修改为指向Lock Record的指针(定义中的轻量锁加锁前/释放锁后,锁对象头的Mark Word低三位为001,也就是无锁状态;上锁时为00。从这一步开始往后,都算是轻量锁的逻辑!!!)
5.2.1 CAS成功,锁升级为轻量级锁。
5.2.2 如果CAS失败
5.2.2.1 如果是锁重入,则将空闲的Lock Record的Displaced Mark Word设置为null,起到一个锁重入计数的作用。
5.2.2.2 不是锁重入,说明还有锁竞争,锁撤销+锁升级:InterpreterRuntime::monitorenter。
以上是偏向锁加锁的流程(包括部分轻量级锁的加锁流程),如果禁用偏向锁||当前锁已偏向其他线程||Klass偏向模式关闭||epoch值过期||获取偏向锁的过程中存在其他锁竞争||,五种情况,都会进入到InterpreterRuntime::monitorenter方法, 在该方法中会对偏向锁撤销和升级。
此时,如果另一个线程T2来访问synchronized同步块,尝试获取锁,它会发现Mark Word中的线程ID不是自己,再经历上述流程。
锁释放
当T1释放偏向锁时(即退出同步块)(注意:释放偏向锁和下面的撤销偏向锁不是一个动作),并没有立即恢复Mark Word,Mark Word仍然保留着T1的线程ID。这种设计是为了优化:如果T1想要再次获取锁,无需CAS操作,只需要判断,即可再次持有锁。(源码,见轻量级锁的锁释放)
锁撤销、锁重偏向、锁升级
InterpreterRuntime::monitorenter如果允许偏向锁,则走向ObjectSynchronizer::fast_enter,否则走向ObjectSynchronizer::slow_enter。
//注意这个方法,是偏向锁、轻量级锁混用。
//如果是轻量级锁,即使进入fast_enter也不会执行什么,主要看slow_enter。
IRT_ENTRY_NO_ASYNC(void, InterpreterRuntime::monitorenter(JavaThread* thread, BasicObjectLock* elem))
  ...
  Handle h_obj(thread, elem->obj());
  assert(Universe::heap()->is_in_reserved_or_null(h_obj()),
         "must be NULL or an object");
  if (UseBiasedLocking) {
    // Retry fast entry if bias is revoked to avoid unnecessary inflation
    ObjectSynchronizer::fast_enter(h_obj, elem->lock(), true, CHECK);
  } else {
    ObjectSynchronizer::slow_enter(h_obj, elem->lock(), CHECK);
  }
  ...
IRT_END

void ObjectSynchronizer::fast_enter(Handle obj, BasicLock* lock, bool attempt_rebias, TRAPS) {
 if (UseBiasedLocking) {
    //如果是正常的Java线程,执行BiasedLocking::revoke_and_rebias方法
    //如果是VM线程则会执行BiasedLocking::revoke_at_safepoint。
    if (!SafepointSynchronize::is_at_safepoint()) {
      //不在安全点,那么调用revoke_and_rebias
      //attempt_rebias为true,可重偏向
      BiasedLocking::Condition cond = BiasedLocking::revoke_and_rebias(obj, attempt_rebias, THREAD);
      if (cond == BiasedLocking::BIAS_REVOKED_AND_REBIASED) {
        return;
      }
    } else {
      //在安全点,还可以动的线程就是VM thread了
      //禁止锁偏向VM线程
      assert(!attempt_rebias, "can not rebias toward VM thread");
      BiasedLocking::revoke_at_safepoint(obj);
    }
    assert(!obj->mark()->has_bias_pattern(), "biases should be revoked by now");
 }
 //只要不是重偏向成功了,都要走slow_enter
 slow_enter (obj, lock, THREAD) ;
}
看比较关键的revoke_and_rebias。
BiasedLocking::Condition BiasedLocking::revoke_and_rebias(Handle obj, bool attempt_rebias, TRAPS) {

  //断言,assert true,则会继续往下执行
  //assert false 报错
  //这个方法不能在安全点调用
  assert(!SafepointSynchronize::is_at_safepoint(), "must not be called while at safepoint");

  markOop mark = obj->mark();
  if (mark->is_biased_anonymously() && !attempt_rebias) {
     //如果是匿名可偏向且attempt_rebias==false
     //锁对象的hashcode方法被调用会出现这种情况
     //需要撤销偏向锁,锁对象头Mark Word低三位被修改为001(设置为无锁状态)、更新GC年龄
    markOop biased_value       = mark;
    markOop unbiased_prototype = markOopDesc::prototype()->set_age(mark->age());
    markOop res_mark = (markOop) Atomic::cmpxchg_ptr(unbiased_prototype, obj->mark_addr(), mark);
    //返回BIAS_REVOKED,后续要走slow_enter
    if (res_mark == biased_value) {
      return BIAS_REVOKED;
    }
  } else if (mark->has_bias_pattern()) {
    // 锁对象头Mark Word低三位为101,也就是锁已经偏向某个线程,会走到这里
    Klass* k = obj->klass();
    markOop prototype_header = k->prototype_header();
    //code 1: 如果对应Klass关闭了偏向模式
    if (!prototype_header->has_bias_pattern()) {
      markOop biased_value       = mark;
      //把Klass#prototype_header设置给当前锁对象头的Mark Word,设置为无锁状态
      markOop res_mark = (markOop) Atomic::cmpxchg_ptr(prototype_header, obj->mark_addr(), mark);
      assert(!(*(obj->mark_addr()))->has_bias_pattern(), "even if we raced, should still be revoked");
      //返回BIAS_REVOKED,后续要走slow_enter
      return BIAS_REVOKED;
    //code 2: 如果epoch过期
    } else if (prototype_header->bias_epoch() != mark->bias_epoch()) {
      if (attempt_rebias) {
        //code 2.1 如果允许重偏向
        assert(THREAD->is_Java_thread(), "");
        markOop biased_value       = mark;
        markOop rebiased_prototype = markOopDesc::encode((JavaThread*) THREAD, mark->age(), prototype_header->bias_epoch());
        //通过CAS操作,将本线程的 ThreadID 、时间戳、GC年龄尝试写入对象头中
        markOop res_mark = (markOop) Atomic::cmpxchg_ptr(rebiased_prototype, obj->mark_addr(), mark);
        if (res_mark == biased_value) {
          //不用走slow_enter
          return BIAS_REVOKED_AND_REBIASED;
        }
      } else {
        //code 2.2 如果不允许重偏向,那么就撤销偏向,
        //锁对象Mark Word改为无锁状态(为后续走slow_enter做铺垫,准备升级轻量锁)
        //锁对象头Mark Word低三位被修改为001、更新GC年龄
        markOop biased_value       = mark;
        markOop unbiased_prototype = markOopDesc::prototype()->set_age(mark->age());
        markOop res_mark = (markOop) Atomic::cmpxchg_ptr(unbiased_prototype, obj->mark_addr(), mark);
        if (res_mark == biased_value) {
          //返回BIAS_REVOKED,后续要走slow_enter
          return BIAS_REVOKED;
        }
      }
    }
  }
  //执行到这里有以下两种情况:
  //1.对象低三位不是101,可能用于应对轻量级锁
  //2.对象低三位是101,但是上面的CAS操作失败了
  //code 3:启发式处理
  HeuristicsResult heuristics = update_heuristics(obj(), attempt_rebias);
  if (heuristics == HR_NOT_BIASED) {
    //情况1
    //低三位不是101,直接返回状态,后续走slow_enter
    return NOT_BIASED;
  } else if (heuristics == HR_SINGLE_REVOKE) {
    //处理情况2
    //code 4:撤销单个线程(最常见情况!!!!!)
    //最常见情况!!!!!
    //最常见情况!!!!!
    //最常见情况!!!!!
    //一般有:T1持有偏向锁L,T2想竞争;T1/T2线程调用锁hashcode方法
    Klass *k = obj->klass();
    markOop prototype_header = k->prototype_header();
    if (mark->biased_locker() == THREAD &&
        prototype_header->bias_epoch() == mark->bias_epoch()) {
      // mark->biased_locker() == THREAD 说明是当前线程持有这个锁
      // 走到这里说明需要撤销的是偏向当前线程的锁
      // 在当前线程调用Object#hashcode方法时会走到这一步
      // 那么只要遍历当前线程的栈就好了,所以不需要等到safepoint再撤销。
      ResourceMark rm;
      if (TraceBiasedLocking) {
        tty->print_cr("Revoking bias by walking my own stack:");
      }
      //注意这里的revoke_bias方法,不会在safepoint调用
      BiasedLocking::Condition cond = revoke_bias(obj(), false, false, (JavaThread*) THREAD);
      ((JavaThread*) THREAD)->set_cached_monitor_info(NULL);
      assert(cond == BIAS_REVOKED, "why not?");
      return cond;
    } else {
      // 撤销偏向失败,必须在safepoint调用revoke_bia方法
      // 下面代码最终会在safepoint调用revoke_bias方法,必然会走slow_enter
      VM_RevokeBias revoke(&obj, (JavaThread*) THREAD);
      VMThread::execute(&revoke);
      return revoke.status_code();
    }
  }

  assert((heuristics == HR_BULK_REVOKE) ||
         (heuristics == HR_BULK_REBIAS), "?");
   //code5:批量撤销、批量重偏向的逻辑,在safepoint触发
  VM_BulkRevokeBias bulk_revoke(&obj, (JavaThread*) THREAD,
                                (heuristics == HR_BULK_REBIAS),
                                attempt_rebias);
  VMThread::execute(&bulk_revoke);
  return bulk_revoke.status_code();
}
code 4情况一般发生于:
锁已经偏向线程T1:
如果是T1调用Object#hashcode,只要遍历T1的栈就能拿到Lock Record,可以直接调用revoke_bias,不需要等到safepoint再撤销。
此时线程T2尝试获取锁,则撤销请求会被push到VM Thread中等到safepoint的时候再执行。
VMThread内部维护了一个VMOperationQueue类型的队列,用于保存内部提交的VM线程操作VM_operation。GC、偏向锁的撤销等操作都是在这里被执行。
revoke_bias方法:
static BiasedLocking::Condition revoke_bias(oop obj, bool allow_rebias, bool is_bulk, JavaThread* requesting_thread) {
  //obj是锁对象
  markOop mark = obj->mark();
  // 如果没有开启偏向模式,则直接返回NOT_BIASED
  if (!mark->has_bias_pattern()) {
    ...
    return BiasedLocking::NOT_BIASED;
  }

  uint age = mark->age();
  // 构建两个mark word,一个是匿名偏向模式(101),一个是无锁模式(001)
  markOop   biased_prototype = markOopDesc::biased_locking_prototype()->set_age(age);
  markOop unbiased_prototype = markOopDesc::prototype()->set_age(age);

  ...
  //获取当前锁对象头Mark Word中存的 线程ID
  JavaThread* biased_thread = mark->biased_locker();
  ...

  // code 1:判断偏向线程是否还存活
  bool thread_is_alive = false;
  // 如果当前线程就是偏向线程,那么存活
  if (requesting_thread == biased_thread) {
    thread_is_alive = true;
  } else {
     // 否则遍历当前jvm的所有线程,如果能找到,则说明偏向的线程还存活
    for (JavaThread* cur_thread = Threads::first(); cur_thread != NULL; cur_thread = cur_thread->next()) {
      if (cur_thread == biased_thread) {
        thread_is_alive = true;
        break;
      }
    }
  }
  // 如果偏向的线程已经不存活了
  if (!thread_is_alive) {
    // 允许重偏向则将对象mark word设置为匿名偏向状态,否则设置为无锁状态
    if (allow_rebias) {
      obj->set_mark(biased_prototype);
    } else {
      obj->set_mark(unbiased_prototype);
    }
    ...
    return BiasedLocking::BIAS_REVOKED;
  }

  //线程还存活则遍历线程栈中所有的Lock Record

  //cached_monitor_info 保存了这个线程当前持有的所有锁的快照
  //每个条目 (MonitorInfo) 记录「锁定的对象 + 栈上对应的 lock record + 附加标志」
  GrowableArray<MonitorInfo*>* cached_monitor_info = get_or_compute_monitor_info(biased_thread);
  BasicLock* highest_lock = NULL;
  for (int i = 0; i < cached_monitor_info->length(); i++) {
    MonitorInfo* mon_info = cached_monitor_info->at(i);
    // 这个锁对象 等于 当前锁对象吗
    if (mon_info->owner() == obj) {
      //等于,说明当前线程存活的同时,还持有锁(在同步块内)
      ...
      //此时需要升级为轻量级锁,存在锁竞争,requesting_thread想要这个锁
      //直接修改偏向线程栈中的Lock Record:
      //为了处理锁重入的case
      //创建一个Mark Word为null
      markOop mark = markOopDesc::encode((BasicLock*) NULL);
      //获得当前锁对象指向的Lock Record
      highest_lock = mon_info->lock();
      //设置其Displaced Mark Word 为刚刚创建的Mark Word
      //注意这里是循环,如果出现锁重入,mon_info->owner() == obj会不止成立一次
      //为了符合轻量锁重入的语义,那么就得把非栈顶(最外层锁)的Lock Record Displaced Mark Word,设置为null
      //那么循环结束后,highest_lock就是栈上离当前执行点最近、最“高”的lock,也是锁重入最外层的
      highest_lock->set_displaced_header(mark);
    } else {
      ...
    }
  }
  if (highest_lock != NULL) {
    // 设置Lock Record Displaced Mark Word为无锁状态
    // 然后将obj锁对象的mark word设置为指向该Lock Record的指针
    highest_lock->set_displaced_header(unbiased_prototype);
    obj->release_set_mark(markOopDesc::encode(highest_lock));
    ...
  } else {
    // 走到这里说明线程存活,但是不在同步块中
    ...
    if (allow_rebias) {
       //设置为匿名偏向状态
      obj->set_mark(biased_prototype);
    } else {
      // 将mark word设置为无锁状态
      obj->set_mark(unbiased_prototype);
    }
  }

  return BiasedLocking::BIAS_REVOKED;
}
-
查看偏向的线程T1是否存活:如果已经不存活了,则直接撤销偏向锁:如果允许重偏向,那么撤销到匿名可偏向状态,允许公平竞争;不允许重偏向,那么撤销到无锁状态。(JVM维护了一个链表存放所有存活的线程,通过遍历该链表判断某个线程是否存活)
-
如果T1存活,去判断线程T1是否还在同步块中:
如果不在,则撤销偏向锁:如果允许重偏向,那么撤销到匿名可偏向状态,允许公平竞争;不允许重偏向,那么撤销到无锁状态。
如果在,执行3。
(这里判断是否在同步块的方法:在偏向锁的获取中,每次进入同步块的时候都会在栈中找到第一个可用(即栈中最高的)的
Lock Record,将其obj字段指向锁对象。每次解锁的时候都会把最低的相关的Lock Record移除掉,所以可以通过遍历线程栈中的Lock Record来判断是否还在同步块中。轻量级锁的重入也是基于Lock Record的计数来判断) -
升级为轻量级锁:将偏向线程所有相关
Lock Record的Displaced Mark Word设置为null,再将最高位的Lock Record的Displaced Mark Word设置为无锁状态,然后将锁对象头Mark Word指向最高位的Lock Record(和偏向锁上锁最后的思路一样,但是这里没有用到CAS指令,因为是在safepoint/当前线程操作自己栈不用等到安全点),T1锁升级。
补充
当T2请求偏向T1的锁时,如果没有触发到批量重偏向/批量撤销的阈值(由update_heuristics方法确定),那锁对象头Mark Word会被撤销为无锁状态;如果T1还在临界区中,锁会升级为轻量级锁。在之后的slow_enter中(下面介绍),如果锁对象是无锁状态,则会升级为轻量级锁;如果为轻量级锁,升级为重量级锁。
而如果到达了批量重偏向的阈值,则会触发批量重偏向:
-
更新类的 epoch 字段:
- 每个类(
Klass)的prototype_header中包含一个bias_epoch(偏向纪元)。 - 执行
incr_bias_epoch()将 epoch 加 1。 - 这个 epoch 相当于一个“版本号”,用于标识当前有效的偏向状态。
- 每个类(
-
遍历所有 Java 线程的栈:
- 对每个线程,获取其持有的 synchronized 锁对象。
- 如果某个锁对象:
- 属于当前类(
owner->klass() == k_o) - 且仍处于偏向模式(
mark->has_bias_pattern())
- 属于当前类(
- 则将其 mark word 中的
bias_epoch更新为新的 epoch(cur_epoch)。 - 注意:这里 并没有改变偏向的线程 ID,只是更新了 epoch。
关键点:通过更新 epoch,使得旧的偏向记录“过期”。后续如果该对象被新线程访问,会因为 epoch 不匹配而触发 轻量级重偏向(无需撤销),从而快速将偏向权转移给新线程。
-
对当前对象 o 尝试重偏向(revoke_bias):
- 调用
revoke_bias(o, attempt_rebias_of_object && ..., true, requesting_thread)。 - 如果
attempt_rebias_of_object为 true(通常是因为当前请求线程希望获得偏向),且类仍支持偏向(has_bias_pattern()),则会将对象 o 的偏向设置为当前线程(requesting_thread)。 - 这一步是 真正将当前对象偏向给新线程。
- 调用
而如果到达了批量撤销的阈值,则会触发批量撤销:
-
关闭Klass的偏向模式:
- 调用
klass->set_prototype_header(markOopDesc::prototype())。 markOopDesc::prototype()返回一个 无偏向模式 的标准 mark word(通常是无锁状态,hash 为 0)。- 此后,该类的新创建对象 默认不再启用偏向锁。
- 调用
-
遍历所有线程的栈,撤销每个该类实例的偏向:
- 获取其持有的 synchronized 锁对象:
- 如果对象属于该Klass 且 当前处于偏向模式
- 调用
revoke_bias(owner, false, true, ...),强制撤销偏向。 revoke_bias(..., false, ...)表示 不尝试重偏向,直接撤销。
- 撤销后,对象可能进入 无锁 或 轻量级锁 状态(取决于是否被其他线程持有)。
- 获取其持有的 synchronized 锁对象:
-
撤销当前对象 o 的偏向:
-
同样调用
revoke_bias(o, false, true, ...),确保当前对象也不再偏向。 -
因为走的是revoke_bias:如果T1还在临界区中,锁会升级为轻量级锁,在slow_enter中升级为重量级锁;如果T1不在临界区中,锁被撤销为无锁状态,在slow_enter中升级为轻量级锁。
-
也就是说,如果一个锁已经偏向线程T1,当线程T2尝试获得该锁时,无论线程A是什么状态,该锁都会升级成轻量级锁或重量级锁(不考虑重偏向的情况)。
优点
加锁和解锁不需要额外的消耗,和执行非同步方法比仅存在极小的差距。
缺点
如果遇到大量锁竞争,会消耗很大的资源,因为需要来到安全点,暂停相关线程,撤销偏向锁。
轻量级锁
目的:在竞争程度很低(即线程交替执行同步块,多个线程尽可能在不同时段获取同一把锁)的情况下,避免直接调用操作系统层面的重量级互斥锁,减少用户态到内核态的切换开销。
加锁/轻量级锁的由来
CASE(_monitorenter): {
  oop lockee = STACK_OBJECT(-1);
  ...
  if (entry != NULL) {
   ...
   // 上面省略的代码中如果CAS操作失败也会调用到InterpreterRuntime::monitorenter

    // traditional lightweight locking
    // false走轻量级锁逻辑
    // 这是偏向锁、轻量锁混用的代码
    // T1持有偏向锁A,T2争夺A,CAS必然失败,走向InterpreterRuntime::monitorenter
    // T1持有轻量锁B,T2争夺B,CAS可能成功,因为T1此时可能释放了锁
    if (!success) {

      //lockee是锁对象,创建一个以其Mark Word作为蓝本的无锁状态Mark Word
      //然后写入Lock Record的Displaced Mark Word
      markOop displaced = lockee->mark()->set_unlocked();
      entry->lock()->set_displaced_header(displaced);

      bool call_vm = UseHeavyMonitors;
      //CAS操作,锁对象头现在的Mark Word 修改为 指向Lock Record的指针
      //这里还有需要注意的!:
	  //轻量级锁的锁标志位为 00,转换为数字后就是 4 的倍数。
      //比如 0100 表示 4, 1000 表示 8。
	  //如果 Lock Record 的地址是均为 4 的倍数,那么设置完 Lock Record 地址后,
      //Mark Word 的末两位值就是 00 了,就是说一个操作完成了两件事:
	  //第一件事情: 将锁对象头的Mark Word修改成指向Lock Record的指针
	  //第二件事情: 因为Lock Record的地址 均为4的倍数 ,即 锁标志位修改为00
      if (call_vm || Atomic::cmpxchg_ptr(entry, lockee->mark_addr(), displaced) != displaced) {
        // 如果锁对象是偏向锁,CAS必然不成功:
        // 偏向锁,锁对象的Mark Word低三位是101,刚刚构建的Mark Word低三位是001,CAS必然失败,只能走向锁升级。

        // 如果锁对象是无锁状态/轻量级锁,CAS有可能成功。
        // 如果成功,说明此时锁对象已经被释放,可以获取
        // 如果失败,说明此时锁对象仍然被持有,只能走向判断是否重入或者锁升级
        // 这里是判断是否是轻量锁重入(没有偏向锁,偏向锁的重入判断在上方代码)
        if (!call_vm && THREAD->is_lock_owned((address) displaced->clear_lock_bits())) {
          // 如果是锁重入,则直接将Displaced Mark Word设置为null
          // 因为轻量级锁重入是使用lock record的数量来计入的
          entry->lock()->set_displaced_header(NULL);
        } else {
          CALL_VM(InterpreterRuntime::monitorenter(THREAD, entry), handle_exception);
        }
      }
    }
    UPDATE_PC_AND_TOS_AND_CONTINUE(1, -1);
  } else {
    istate->set_msg(more_monitors);
    UPDATE_PC_AND_RETURN(0); // Re-execute
  }
}
如果没有开启偏向锁,就会走到success == false,因为锁对象一开始就是无锁状态(001),这时候CAS也可以成功,那么上锁一开始就是轻量级锁:
线程T1在栈帧中找到空闲的Lock Record。
把锁对象头的Mark Word修改为无锁状态,复制到线程T1 Lock Record中。
通过CAS,把entry(Lock Record)的指针 修改到 锁对象头的Mark Word中。
(后续恢复锁对象头的Mark Word,期望锁对象头的Mark Word中有T1 Lock Record的指针,交换值是无锁状态的原Mark Word)
如果CAS成功,线程T1就获得了轻量级锁。
如果CAS失败,说明锁对象头的Mark Word并非无锁状态了,锁已经被持有了,分两种情况:
-
如果锁对象头的Mark Word中的指针指向当前线程T1的Lock Record,代表这是一次锁重入。就把刚创建的
Lock Record(中的Displaced Mark Word字段)设置为null,起到了一个重入计数器的作用。然后结束。 -
说明至少有两条线程在竞争锁,锁需要升级,走到
InterpreterRuntime::monitorenter。
如果开启了偏向锁:
见上述的偏向锁,排除重偏向的情况,存在当前锁已偏向其他线程||Klass偏向模式关闭||epoch值过期||获取偏向锁的过程中存在其他锁竞争||,四种情况,都会进入到InterpreterRuntime::monitorenter方法, 在该方法中会对偏向锁撤销和升级,即可得到轻量级锁。InterpreterRuntime::monitorenter又会走到fast_enter、slow_enter。
//注意这个方法,是偏向锁、轻量级锁混用。
//如果是轻量级锁,即使进入fast_enter也不会执行什么,主要看slow_enter。
IRT_ENTRY_NO_ASYNC(void, InterpreterRuntime::monitorenter(JavaThread* thread, BasicObjectLock* elem))
  ...
  Handle h_obj(thread, elem->obj());
  assert(Universe::heap()->is_in_reserved_or_null(h_obj()),
         "must be NULL or an object");
  if (UseBiasedLocking) {
    // Retry fast entry if bias is revoked to avoid unnecessary inflation
    ObjectSynchronizer::fast_enter(h_obj, elem->lock(), true, CHECK);
  } else {
    ObjectSynchronizer::slow_enter(h_obj, elem->lock(), CHECK);
  }
  ...
IRT_END
fast_enter的流程在偏向锁的锁撤销中已经分析过。主要是调用revoke_and_rebias方法,其核心逻辑为:
假设T2竞争偏向T1的锁。此时不在safepoint,如果当前锁Mark Word低三位是101,不允许重偏向,先进行锁撤销,把锁对象改为无锁状态。
如果锁撤销成功,准备进入slow_enter;
如果锁撤销失败,发起到safepoint执行revoke_bias的请求,那么等到safepoint时,T1存活且还持有锁在同步块中,将偏向线程所有相关Lock Record的Displaced Mark Word设置为null,再将T1最高位的Lock Record的Displaced Mark Word 设置为无锁状态,然后将锁对象头Mark Word指向T1最高位的Lock Record,此时T1持有的锁升级为轻量级锁,然后T2继续执行slow_enter。(此时,T2仍然无法获取到锁)
来看slow_enter。
void ObjectSynchronizer::slow_enter(Handle obj, BasicLock* lock, TRAPS) {
  markOop mark = obj->mark();
  assert(!mark->has_bias_pattern(), "should not see bias pattern here");
  // 如果是锁对象的Mark Word是无锁状态(001) (这个无锁判断是针对于偏向锁经过revoke_and_rebias后,变成无锁状态的)
  if (mark->is_neutral()) {
    //设置Lock Record的Displaced Mark Word字段为无锁状态(保存当前锁对象的mark word)
    lock->set_displaced_header(mark);
    //CAS 锁对象头Mark Word修改为 栈中Lock Record的指针
    if (mark == (markOop) Atomic::cmpxchg_ptr(lock, obj()->mark_addr(), mark)) {
      //如果成功 结束方法
      TEVENT (slow_enter: release stacklock) ;
      return ;
    }
  } else if (mark->has_locker() && THREAD->is_lock_owned((address)mark->locker())) {
    assert(lock != mark->locker(), "must not re-lock the same lock");
    assert(lock != (BasicLock*)obj->mark(), "don't relock with same BasicLock");
    // 如果是重入,则设置Lock Record的Displaced Mark Word为null
    lock->set_displaced_header(NULL);
    //结束方法
    return;
  }

  ...
  // 走到这一步说明 锁对象的Mark Word不是无锁状态,是轻量级锁,需要膨胀为重量级锁
  // 注意这里 没有自旋,只要轻量级锁发生竞争,那么不管如何都会引起锁膨胀
  lock->set_displaced_header(markOopDesc::unused_mark());
  ObjectSynchronizer::inflate(THREAD, obj())->enter(THREAD);
}
锁释放
这里的锁释放,偏向锁和轻量级锁是混用的。
CASE(_monitorexit): {
  oop lockee = STACK_OBJECT(-1);
  CHECK_NULL(lockee);
  // derefing's lockee ought to provoke implicit null check
  // find our monitor slot
  BasicObjectLock* limit = istate->monitor_base();
  BasicObjectLock* most_recent = (BasicObjectLock*) istate->stack_base();
  // 从低往高遍历栈的Lock Record
  while (most_recent != limit ) {
    // 如果Lock Record关联的是该锁对象
    if ((most_recent)->obj() == lockee) {
      BasicLock* lock = most_recent->lock();
      //获得Displaced Mark Word
      markOop header = lock->displaced_header();
      // Lock Record释放锁对象
      most_recent->set_obj(NULL);
      // 如果是偏向锁,Lock Record释放锁对象就好了。
      // 否则要走轻量级锁/重量级锁的释放流程
      if (!lockee->mark()->has_bias_pattern()) {
        bool call_vm = UseHeavyMonitors;
        // header != NULL说明不是重入
        // 则需要将Displaced Mark Word 恢复到锁对象头的Mark Word
        if (header != NULL || call_vm) {
          if (call_vm || Atomic::cmpxchg_ptr(header, lockee->mark_addr(), lock) != lock) {
            // CAS失败或者是重量级锁则会走到这里,先不把锁对象释放
            // 然后调用monitorexit方法
            most_recent->set_obj(lockee);
            CALL_VM(InterpreterRuntime::monitorexit(THREAD, most_recent), handle_exception);
          }
        }
      }
      //执行下一条命令
      UPDATE_PC_AND_TOS_AND_CONTINUE(1, -1);
    }
    //处理下一条Lock Record
    most_recent++;
  }
  // Need to throw illegal monitor state exception
  CALL_VM(InterpreterRuntime::throw_illegal_monitor_state_exception(THREAD), handle_exception);
  ShouldNotReachHere();
}

IRT_ENTRY_NO_ASYNC(void, InterpreterRuntime::monitorexit(JavaThread* thread, BasicObjectLock* elem))

  Handle h_obj(thread, elem->obj());
  ...
  ObjectSynchronizer::slow_exit(h_obj(), elem->lock(), thread);
  // Free entry. This must be done here, since a pending exception might be installed on
  //Lock Record释放锁对象
  elem->set_obj(NULL);
  ...
IRT_END
slow_exit实际上调用了fast_exit。
void ObjectSynchronizer::slow_exit(oop object, BasicLock* lock, TRAPS) {
  fast_exit(object, lock, THREAD);s
}
void ObjectSynchronizer::fast_exit(oop object, BasicLock* lock, TRAPS) {
  ...
  markOop dhw = lock->displaced_header();
  markOop mark;
  if (dhw == NULL) {
     // 重入锁,什么也不做
   	 ...
     return ;
  }

  mark = object->mark();
  // 如果锁对象头Mark Word==Lock Record Displaced Mark Word
  // 说明是轻量级锁,CAS替换对象头的mark word
  if (mark == (markOop) lock) {
     assert (dhw->is_neutral(), "invariant");
     if ((markOop) Atomic::cmpxchg_ptr (dhw, object->mark_addr(), mark) == mark) {
        TEVENT (fast_exit: release stacklock);
        return;
     }
  }
  //走到这里说明是重量级锁或者解锁时发生了竞争,膨胀后调用重量级锁的exit方法。
  ObjectSynchronizer::inflate(THREAD, object)->exit(true, THREAD);
}
如果是轻量级锁,尝试CAS恢复锁对象的Mark Word。若解锁时有竞争导致CAS失败,会调用inflate方法进行重量级锁膨胀,升级到到重量级锁后再执行exit方法。
重量级锁
重量级锁通过对象内部的监视器(monitor)实现,其依赖于底层操作系统的Mutex Lock实现。容易出现额外的用户态到内核态切换的开销,以及线程上下文切换的开销。
加锁、锁膨胀
slow_enter获取轻量级锁未成功时,会在inflate中完成锁膨胀:
void ObjectSynchronizer::slow_enter(Handle obj, BasicLock* lock, TRAPS) {
	...
  // 如果是锁对象的Mark Word是无锁状态(001)
  if (mark->is_neutral()) {
    //设置Lock Record的Displaced Mark Word字段为无锁状态
    lock->set_displaced_header(mark);
    //CAS 锁对象头Mark Word修改为 栈中Lock Record的指针
    if (mark == (markOop) Atomic::cmpxchg_ptr(lock, obj()->mark_addr(), mark)){
      //如果成功 结束方法
      TEVENT (slow_enter: release stacklock) ;
      return ;
    }
  } else if (mark->has_locker() && THREAD->is_lock_owned((address)mark->locker())) {
    ...
    // 如果是重入,则设置Lock Record的Displaced Mark Word为null
    lock->set_displaced_header(NULL);
    //结束方法
    return;
  }

  ...
  // 走到这一步说明 锁对象的Mark Word不是无锁状态,是轻量级锁,需要膨胀为重量级锁
  // 注意这里 没有自旋,只要轻量级锁发生竞争,那么不管如何都会引起锁膨胀
  lock->set_displaced_header(markOopDesc::unused_mark());
  ObjectSynchronizer::inflate(THREAD, obj())->enter(THREAD);
}

ObjectMonitor * ATTR ObjectSynchronizer::inflate (Thread * Self, oop object) {
  ...
  for (;;) {
      const markOop mark = object->mark();
      assert (!mark->has_bias_pattern(), "invariant")
      // mark是以下状态中的一种:
      // *  Inflated(重量级锁状态)     - 直接返回
      // *  Stack-locked(轻量级锁状态) - 膨胀
      // *  INFLATING(膨胀中)    - 忙等待直到膨胀完成
      // *  Neutral(无锁状态)      - 膨胀
      // *  BIASED(偏向锁)       - 非法状态,在这里不会出现

      // CASE: inflated
      if (mark->has_monitor()){
          // 已经是重量级锁状态了,直接返回
          ObjectMonitor * inf = mark->monitor();
          ...
          return inf;
      }
      // CASE: inflation in progress
      if (mark == markOopDesc::INFLATING()){
         // 正在膨胀中,说明另一个线程正在进行锁膨胀,continue重试
         TEVENT(Inflate: spin while INFLATING);
         // 在该方法中会进行spin/yield/park等操作完成自旋动作
         ReadStableMark(object);
         continue;
      }
      // 当前是轻量级锁
      //见下
	  if (mark->has_locker()) {
 		...
      }
      // 无锁状态
      // CASE: neutral
      //见下
      ...

      ...
      return m;
}
inflate主要是一个for循环,为了处理多线程同时调用inflate的情况。然后会根据锁对象的状态进行不同的处理:
- 已经是重量级状态,说明膨胀已经完成,返回并继续执行
ObjectMonitor::enter方法。 - 如果是轻量级锁则需要进行膨胀操作。
- 如果是膨胀中状态,则进行忙等待。
- 如果是无锁状态则需要进行膨胀操作。
轻量级锁膨胀
 	// 当前是轻量级锁
	if (mark->has_locker()) {
      // 1
      // 当前轻量级锁状态,先分配一个ObjectMonitor对象,并初始化值
      ObjectMonitor * m = omAlloc(Self);
      m->Recycle();
      m->_Responsible  = NULL;
      m->OwnerIsThread = 0;
      m->_recursions   = 0;
      m->_SpinDuration = ObjectMonitor::Knob_SpinLimit;   // Consider: maintain by type/class
      // 2
      // 将锁对象的mark word设置为INFLATING (0)状态
      markOop cmp = (markOop) Atomic::cmpxchg_ptr(markOopDesc::INFLATING(), object->mark_addr(), mark);
      if (cmp != mark) {
        //CAS失败 重试
        omRelease(Self, m, true);
        continue ;       // Interference -- just retry
      }
      // 3
      // 设置header为lock record中的displaced mark word
      markOop dmw = mark->displaced_mark_helper();
      assert(dmw->is_neutral(), "invariant");
      // 设置monitor的字段
      m->set_header(dmw);
      // owner为 锁对象头指向的Lock Record
      m->set_owner(mark->locker());
      m->set_object(object);
      ...
      // 4
      // 将锁对象头设置为重量级锁状态
      object->release_set_mark(markOopDesc::encode(m));
      ...
      return m ;
    }
- 调用
omAlloc获取一个可用的ObjectMonitor对象。在omAlloc方法中会先从线程私有的monitor集合omFreeList中分配对象,如果omFreeList中已经没有monitor对象,则从JVM全局的gFreeList中分配一批monitor到omFreeList中; - 通过CAS尝试将Mark Word设置为
markOopDesc:INFLATING(0),标识当前锁正在膨胀中。如果CAS失败,说明同一时刻其它线程已经将Mark Word设置为markOopDesc:INFLATING,当前线程进行自旋等待锁膨胀完成。 - 如果CAS成功,设置monitor的各个字段:设置
monitor的header字段为持有锁线程的Lock Record Displaced Mark Word,owner字段为Lock Record,obj字段为锁对象等; - 设置锁对象头的
Mark Word为重量级锁状态:即指向第一步分配的monitor对象。
无锁状态锁膨胀
  // 无锁状态
  // CASE: neutral
  // 分配以及初始化ObjectMonitor对象
  ObjectMonitor * m = omAlloc (Self) ;
  // prepare m for installation - set monitor to initial state
  m->Recycle();
  m->set_header(mark);
  // owner为NULL
  m->set_owner(NULL);
  m->set_object(object);
  m->OwnerIsThread = 1 ;
  m->_recursions   = 0 ;
  m->_Responsible  = NULL ;
  m->_SpinDuration = ObjectMonitor::Knob_SpinLimit ;       // consider: keep metastats by type/class
    // 用CAS修改锁对象头的mark word为重量级锁状态
  if (Atomic::cmpxchg_ptr (markOopDesc::encode(m), object->mark_addr(), mark) != mark) {
      // 不成功说明有另外一个线程在执行inflate,释放monitor对象
      m->set_object (NULL) ;
      m->set_owner  (NULL) ;
      m->OwnerIsThread = 0 ;
      m->Recycle() ;
      omRelease (Self, m, true) ;
      m = NULL ;
      continue ;
      // interference - the markword changed - just retry.
      // The state-transitions are one-way, so there's no chance of
      // live-lock -- "Inflated" is an absorbing state.
  }
- 调用omAlloc分配一个ObjectMonitor对象
- 初始化monitor对象
- 设置monitor的header字段为当前锁对象头的mark word,owner字段为null,obj字段为锁对象
- 设置锁对象头的mark word为重量级锁状态,即指向第一步分配的monitor对象
可以看到轻量级锁膨胀和无锁状态膨胀的不同之处在于第2步,没有使用INFLATING标识。
把 Mark Word CAS 为 INFLATING,是想作为“忙/占用(BUSY)”的标志,目的是减少重复膨胀,防止竞态导致对象 header在膨胀过程中“闪变/flicker”。
其它尝试膨胀的线程看到 INFLATING 就自旋/等待,避免多个线程同时做膨胀(避免重复构造 monitor、双重安装等)。
TEVENT(Inflate: spin while INFLATING)
INFLATING
无锁状态时:对象的 Mark Word只在对象头里。膨胀时直接把它复制到 monitor._header 再把 monitor 指针写回对象头即可;
轻量级锁:为了实现轻量级锁,此时“锁对象头原始 Mark Word”不在锁对象里,而在持有锁线程的Lock Record上——这就引入了竞态:持锁线程可能正准备 unlock 并把Lock Record Displaced Mark Word写回锁对象头;同时竞争线程因为重量级锁的语义,把Monitor指针修改到锁对象头Mark Word。如果两者并发,会导致 header 之间来回“闪变”。
此时,Mark Word中存储的是指向重量级锁(Monitor) 的指针。
膨胀完成之后,会调用ObjectMonitor::enter方法获得锁。
void ATTR ObjectMonitor::enter(TRAPS) {
  // 获取当前线程的指针
  Thread * const Self = THREAD;
  void * cur;
  // owner为null代表无锁状态,如果能CAS设置成功,则当前线程直接获得锁
  // CAS失败,cur得到_owner实际指向的值
  cur = Atomic::cmpxchg_ptr (Self, &_owner, NULL) ;
  if (cur == NULL) {
     ...
     return;
  }
  // 如果是重入的情况
  if (cur == Self) {
     // TODO-FIXME: check for integer overflow!  BUGID 6557169.
     _recursions ++;
     return;
  }
  // 如果当前线程是拥有cur Lock Record的线程
  // 即锁膨胀前持有轻量级锁的线程(轻量级锁膨胀时候,会将owner指向持有轻量级锁线程的Lock Record的指针)。
  if (Self->is_lock_owned ((address)cur)) {
    assert (_recursions == 0, "internal state error");
    // 重入计数重置为1/
    _recursions = 1;
    // 设置owner字段为当前线程(设置前owner是指向持有锁线程的Lock Re
    OwnerIsThread = 1;
    return;
  }

  ...
  // 其他线程
  // 在调用系统的同步操作之前,先尝试自旋获得锁
  if (Knob_SpinEarly && TrySpin (Self) > 0) {
     ...
     //自旋的过程中获得了锁,则直接返回
     Self->_Stalled = 0;
     return;
  }

  ...

  {
    ...

    for (;;) {
      jt->set_suspend_equivalent();
      // 在该方法中调用系统同步操作
      EnterI (THREAD);
      ...
    }
    Self->set_current_pending_monitor(NULL);

  }

  ...

}
-
当前是无锁、锁重入,简单操作后返回。
-
当前线程是之前持有轻量级锁的线程,则为首次进入,设置recursions为1,owner为当前线程,该线程成功获得锁并返回。
-
先自旋尝试获得锁,尽可能减少开销。
-
进行同步操作,调用
EnterI方法。
这里注意,轻量级锁膨胀成功时,会把owner字段设置为持有该锁的线程的Lock Record的指针,并在竞争时判断。这么做的原因是:为了方便进行重入的判断。如果锁膨胀直接把owner设置为线程指针,那么不好分清楚究竟是重入还是持锁线程第一次进入ObjectMonitor::enter。
这里有个自旋操作,直接看TrySpin对应的方法:
// TrySpin对应的方法
int ObjectMonitor::TrySpin_VaryDuration (Thread * Self) {
    // Dumb, brutal spin.  Good for comparative measurements against adaptive spinning.
    int ctr = Knob_FixedSpin;  // 固定自旋次数
    if (ctr != 0) {
        while (--ctr >= 0) {
            //CAS 使用无限循环来不断尝试获取锁
            //如果锁当前未被持有,当前线程将尝试获取锁。如果成功,返回1;
            //如果锁已被其他线程持有,或者在尝试获取锁的过程中锁被其他线程获取,则返回-1
            if (TryLock (Self) > 0) return 1;
            SpinPause ();
        }
        return 0;
    }
    // 上一次自旋次数
    for (ctr = Knob_PreSpin + 1; --ctr >= 0; ) {
      if (TryLock(Self) > 0) {  // 尝试获取锁
        // Increase _SpinDuration ...
        // Note that we don't clamp SpinDuration precisely at SpinLimit.
        // Raising _SpurDuration to the poverty line is key.
        int x = _SpinDuration ;
        if (x < Knob_SpinLimit) {
           if (x < Knob_Poverty) x = Knob_Poverty ;
           _SpinDuration = x + Knob_BonusB;
        }
        return 1;
      }
      ...
从方法名和注释可以看出,这就是自适应自旋,和网上说的轻量级锁CAS失败会自旋的说法并不一致。实际上,目前来看是只有重量级锁CAS失败会自旋。
ObjectMonitor
每个重量级锁对象存在着一个ObjectMonitor对象与之关联。这个ObjectMonitor对象也称为管程或监视器锁。
一个ObjectMonitor内部有以下几个关键字段:
_owner:指向当前持有锁的线程。_cxq:一个链表。在多个线程同时竞争锁时,为了减少对_EntryList的操作竞争,这些线程会先通过 CAS 操作自旋地尝试入队到_cxq。在入队时用头插(push front)+ CAS 重试,所以_cxq` 是一个后进先出(LIFO)的结构。_EntryList:同步队列。一个链表,存放所有等待锁的线程。这些线程在尝试获取锁失败后,会进入阻塞状态,并被放入这个队列中。当持有锁的线程释放锁时,会从这个队列中唤醒一个或多个线程来重新竞争锁。_WaitSet:**等待队列。**一个链表,存放所有调用了Object.wait()方法的线程。这些线程已经主动放弃了锁,并进入等待状态,直到被其他线程通过notify()或notifyAll()唤醒。被唤醒的线程会从_WaitSet转移到_EntryList中,重新参与锁竞争。
其中_cxq ,_EntryList ,_WaitSet都是由ObjectWaiter组成的链表结构。_cxq 是“入口”队列,新来的竞争线程首先进入这里。_EntryList 是“待唤醒”队列,在锁释放时,JVM 会根据内部策略决定如何在这两个队列之间转移线程。
Monitor等待
void ATTR ObjectMonitor::EnterI (TRAPS) {
        // 尝试自旋
    if (TrySpin (Self) > 0) {
        ...
        return ;
    }
    ...
    // 将线程封装成node节点中
    ObjectWaiter node(Self) ;
    Self->_ParkEvent->reset() ;
    node._prev   = (ObjectWaiter *) 0xBAD ;
    node.TState  = ObjectWaiter::TS_CXQ ;
    // 将node节点插入到_cxq队列的头部,cxq是一个单向链表
    ObjectWaiter * nxt ;
    for (;;) {
        node._next = nxt = _cxq ;
        if (Atomic::cmpxchg_ptr (&node, &_cxq, nxt) == nxt) break ;
        // CAS失败的话 再尝试获得锁,这样可以降低插入到_cxq队列的频率
        if (TryLock (Self) > 0) {
            ...
            return ;
        }
    }

    ...
    // SyncFlags默认为0,如果没有其他等待的线程,则将_Responsible设置为自己
    if ((SyncFlags & 16) == 0 && nxt == NULL && _EntryList == NULL) {
        Atomic::cmpxchg_ptr (Self, &_Responsible, NULL) ;
    }


    TEVENT (Inflated enter - Contention) ;
    int nWakeups = 0 ;
    int RecheckInterval = 1 ;

    for (;;) {
		//C执行一次CAS尝试拿锁
        if (TryLock (Self) > 0) break ;
        assert (_owner != Self, "invariant") ;

        ...

        // park self
        if (_Responsible == Self || (SyncFlags & 1)) {
            // 当前线程是_Responsible时,调用的是带时间参数的park
            TEVENT (Inflated enter - park TIMED) ;
            Self->_ParkEvent->park ((jlong) RecheckInterval) ;
            // Increase the RecheckInterval, but clamp the value.
            RecheckInterval *= 8 ;
            if (RecheckInterval > 1000) RecheckInterval = 1000 ;
        } else {
            //否则直接调用park挂起当前线程
            TEVENT (Inflated enter - park UNTIMED) ;
            Self->_ParkEvent->park() ;
        }

        if (TryLock(Self) > 0) break ;

        ...

        if ((Knob_SpinAfterFutile & 1) && TrySpin (Self) > 0) break ;

       	...
        // 在释放锁时,_succ会被设置为EntryList或_cxq中的一个线程
        if (_succ == Self) _succ = NULL ;

        // Invariant: after clearing _succ a thread *must* retry _owner before parking.
        OrderAccess::fence() ;
    }

    // 走到这里说明已经获得锁了
	// 将当前线程的node从cxq或EntryList中移除
    UnlinkAfterAcquire (Self, &node) ;
    if (_succ == Self) _succ = NULL ;
	if (_Responsible == Self) {
        _Responsible = NULL ;
        OrderAccess::fence();
    }
    ...
    return ;
}
当一个线程尝试获得重量级锁且没有竞争到时,该线程会被封装成一个ObjectWaiter对象插入到_cxq的队首,然后调用park函数挂起当前线程,进入BLOCKED状态。(在Linux系统上,park函数底层调用的是gclib库的pthread_cond_wait,JDK的ReentrantLock底层也是用该方法挂起线程的。)
当线程释放锁时,会根据唤醒策略,从_cxq或_EntryList中挑选一个线程作为Heir presumptive进行unpark唤醒。Heir presumptive被唤醒后会尝试获得锁,但synchronized是非公平锁,所以Heir presumptive不一定能获得锁。
如果线程获得锁后调用Object#wait方法,则会将线程加入到_WaitSet中,进入WAITING或TIMED_WAITING状态。当被Object#notify唤醒后,会将线程从_WaitSet移动到_cxq或_EntryList中去,进入BLOCKED状态。
需要注意的是,当调用一个锁对象的wait或notify方法时,若当前锁的状态是偏向锁或轻量级锁,则会先膨胀成重量级锁。
_Responsible和_succ两个字段的作用:
当竞争发生时,选取一个线程作为_Responsible,_Responsible线程调用的是有时间限制的park方法,其目的是防止出现搁浅现象。
_succ线程是Heir presumptive。
Monitor释放
void ATTR ObjectMonitor::exit(bool not_suspended, TRAPS) {
    Thread * Self = THREAD ;
    ...
    // 处理异常以及其他情况

    //释放锁
    for (;;) {

        if (Knob_ExitPolicy == 0) { //默认为0
            //简单释放锁策略
            OrderAccess::release_store(&_owner, (void*)NULL);
            // drop the lock
            OrderAccess::storeload();//内存屏障,让其它线程看到释放动作
            if ((intptr_t(_EntryList)|intptr_t(_cxq)) == 0 || _succ != NULL) {
                //若没有等待者(_EntryList 和 _cxq 都为空)或已存在 successor (_succ != NULL)
                //直接返回 —— 完成释放。
                TEVENT(Inflated exit - simple egress);
                return;
            }
            TEVENT(Inflated exit - complex egress);
            //但释放到唤醒等待者之间存在一个短暂窗口:其他线程可能在你释放后马上抢到锁或注册为 successor。
            //为了处理这种 race,这里会做一次CAS
            if (!Atomic::replace_if_null(THREAD, &_owner)) {
                //说明有线程获取到了锁
                //那么直接返回
                return;
            }
            TEVENT(Exit - Reacquired);
        } else {
            //其他释放锁策略
            ...
        }

        ObjectWaiter * w = NULL ;
        // 根据QMode的不同会有不同的唤醒策略,默认为0
        // Knob_QMode 是一个全局变量,
        // 它可以由 Intel 的 PIN 工具框架定义的,通过在 PIN 工具代码中使用命令行参数 -qmode 设置其值。
        int QMode = Knob_QMode ;

        if (QMode == 2 && _cxq != NULL) {
            // QMode == 2 : cxq中的线程有更高优先级
            // 直接唤醒cxq的队首线程,是等待时间最长的线程,也就是队列中第一个入队的
            // 唯一会提前返回的
            return ;
        }

        if (QMode == 3 && _cxq != NULL) {
            // QMode == 3 将cxq中的元素插入到EntryList的队尾
            //继续执行
            ...
        }

        if (QMode == 4 && _cxq != NULL) {
            // QMode == 4 将cxq插入到EntryList的队首
            //继续执行
            ...
        }

		//QMode = 0,1,3,4会执行到这
        w = _EntryList  ;
        if (w != NULL) {
			// 如果EntryList不为空,则直接唤醒EntryList的队首元素
            assert (w->TState == ObjectWaiter::TS_ENTER, "invariant") ;
            ExitEpilog (Self, w) ;
            return ;
        }

		// EntryList为null,则处理cxq中的元素
        w = _cxq ;
        if (w == NULL) continue ;

        // 如果 _EntryList 为空但 _cxq != NULL,代码会用 CAS 安全地把 _cxq 取走(drain)
        // 因为之后要将cxq的元素移动到EntryList,所以这里将cxq字段设置为null
        for (;;) {
            assert (w != NULL, "Invariant") ;
            ObjectWaiter * u = (ObjectWaiter *) Atomic::cmpxchg_ptr (NULL, &_cxq, w) ;
            if (u == w) break ;
            w = u ;
        }
        TEVENT (Inflated exit - drain cxq into EntryList) ;

        //然后根据 QMode 进一步处理:
        if (QMode == 1) {
            // QMode == 1 : 将cxq中的元素转移到EntryList,并反转顺序
            // cxq是LIFO,后进先出,现在翻转,那么改为FIFO
            ObjectWaiter * s = NULL ;
            ObjectWaiter * t = w ;
            ObjectWaiter * u = NULL ;
            while (t != NULL) {
                guarantee (t->TState == ObjectWaiter::TS_CXQ, "invariant") ;
                t->TState = ObjectWaiter::TS_ENTER ;
                u = t->_next ;
                t->_prev = u ;
                t->_next = s ;
                s = t;
                t = u ;
            }
            _EntryList  = s ;
            assert (s != NULL, "invariant") ;
        } else {
            // QMode == 0,3,4
            // 将cxq中的元素转移到EntryList
            _EntryList = w ;
            ObjectWaiter * q = NULL ;
            ObjectWaiter * p ;
            for (p = w ; p != NULL ; p = p->_next) {
                guarantee (p->TState == ObjectWaiter::TS_CXQ, "Invariant") ;
                p->TState = ObjectWaiter::TS_ENTER ;
                p->_prev = q ;
                q = p ;
            }
        }


		// _succ不为null
		// 说明已经有个继承人了,所以不需要当前线程去唤醒,减少线程上下文切换
        if (_succ != NULL) continue;

        w = _EntryList  ;
		// 唤醒EntryList第一个元素
        if (w != NULL) {
            guarantee (w->TState == ObjectWaiter::TS_ENTER, "invariant") ;
            ExitEpilog (Self, w) ;
            return ;
        }
    }
}
- 设置owner为null,即释放锁,这个时刻其他的线程能获取到锁。这里是一个非公平锁的优化;
- 如果当前没有等待的线程则直接返回就好了,因为不需要唤醒其他线程。或者如果说succ不为null,代表当前已经有个"醒着的"继承人线程,那当前线程不需要唤醒任何线程;
- 当前线程重新获得锁,因为之后要操作
cxq和EntryList队列以及唤醒线程; - 根据
QMode的不同,会执行不同的唤醒策略。
从cxq或EntryList中获取头节点,通过ObjectMonitor::ExitEpilog方法唤醒该节点对应的线程,唤醒操作最终由unpark完成。
根据QMode的不同(默认为0),有不同的处理方式:
QMode= 0:暂时什么都不做;QMode= 2且cxq非空:取cxq队列队首的ObjectWaiter对象,调用ExitEpilog方法,该方法会唤醒线程,然后立即返回;QMode= 3且cxq非空:把cxq队列插入到EntryList的尾部;QMode= 4且cxq非空:把cxq队列插入到EntryList的头部;
只有QMode=2的时候会提前返回,等于0、1、3、4的时继续执行:
-
如果
EntryList的首元素非空,就取出来调用ExitEpilog方法,该方法会唤醒ObjectWaiter对象的线程,然后立即返回; -
如果
EntryList的首元素为空,就将cxq的所有元素放入到EntryList中,然后再从EntryList中取出来队首元素执行ObjectMonitor::ExitEpilog方法,然后立即返回; -
被唤醒的线程,继续竞争
monitor;
| QMode | 策略描述 | 唤醒顺序 | 适用场景 |
|---|---|---|---|
| 0 | 默认策略,优先唤醒 EntryList,为空时转移 cxq | EntryList FIFO | 公平性较好 |
| 1 | 反转 cxq 后设为 EntryList | 反转后的顺序 | 特定优化场景 |
| 2 | 直接唤醒 cxq 头节点 | cxq LIFO | 性能优化,减少操作 |
| 3 | cxq 转移到 EntryList 尾部 | 保持 FIFO | 公平性最佳 |
| 4 | cxq 转移到 EntryList 头部 | 近似 LIFO | 吞吐量优化 |
hashCode与锁
当一个对象已经计算过hashCode后,它就再也无法进入偏向锁状态了,下次加锁直接是轻量级。
而当一个对象当前正处于偏向锁状态,计算其hashCode时,它的偏向状态会被立即撤销,并且会膨胀为重量级锁。计算并保存 identity-hash 必须把 hash 永久/持久地保存到对象的头上或与对象同寿命的地方,而轻量级锁使用的临时结构(Lock Record)存在于线程栈上,释放锁后就不存在了,不能满足“hash 要长期可见”的要求。
内核态、用户态切换与线程上下文切换
用户态、内核态切换,线程上下文切换(context switch) 常被混用。
但严格说 CPU 的上下文切换比单纯的模式切换更重。模式切换不一定伴随着上下文切换。但是线程上下文切换一定涉及内核态(需要内核调度)。
模式切换(mode switch)
- 只是权限层级的切换(用户态 → 内核态 → 用户态)。
- 发生在:系统调用(read/write、nanosleep 等syscall)、硬件中断、异常(比如页面错误)时。
- 开销:保存/恢复一些寄存器、切换到内核栈、做权限切换检查等(相对较轻,但非免费)。
线程上下文切换(context switch)
- 把 CPU 从一个线程/进程切到另一个,涉及保存当前线程的寄存器状态、加载下一个线程的寄存器、可能切换页表(地址空间)、刷新 TLB、内核调度决策等。
- 比模式切换昂贵得多(通常几十到几百倍的 CPU 周期,且可能引起缓存/TLB 失效等间接成本)。
- 发生在:线程阻塞(sleep、等待IO)、被抢占、线程主动让出,或者调度器决定切换。
竞争锁失败
重量级锁,若经过自旋仍无法获得锁(尽可能停留在用户态),JVM 会把线程 T2 放入锁对象对应 Monitor 的等待队列,并调用阻塞原语以挂起线程T2(在Linux 实现中是调用 futex ;在 Windows 是 WaitForSingleObject / SRW 等)。
这是一次 系统调用(syscall):CPU 从用户态切到内核态去执行内核代码,核内把线程标记为不可运行,并从可运行队列移走到等待队列 —— 同时产生 线程上下文切换。
释放锁并唤醒等待者
线程 T1 在释放锁时(monitorExit)发现有人等待,需要内核执行唤醒操作:把阻塞线程T2从等待队列移到可运行队列。
这也是 syscall,同样触发模式切换(进入内核)并可能导致线程上下文切换(把 CPU 控制权交给被唤醒线程或其他线程)。
被唤醒线程重新尝试获取锁
被唤醒的线程 T2 变为可运行,内核调度器在合适时机把它上下文切入 CPU。线程 T2 返回用户态并继续尝试拿到锁(可能再次 CAS 成功或再次被竞争)。
Monitorenter和Monitorexit指令
执行 monitorenter 指令就是线程试图去获取,synchronized想锁住的对象的 Monitor 的所有权,抢到了就是成功获取锁了;执行 monitorexit 指令则是释放了Monitor的所有权。每一个对象在同一时间只与一个Monitor相关联,而一个Monitor在同一时间只能被一个线程获得。
每个Monitor有着一个记录着被锁次数的计数器。未被锁定的计数器为0,当一个线程获得对象的锁(执行Monitorenter)后,该对象的Monitor计数器自增变为 1 ;当同一个线程再次获得该对象的锁的时候,计数器再次自增。当同一个线程释放锁(执行Monitorexit指令)的时候,计数器再自减。当计数器为0的时候,锁将被释放,其他线程便可以获得锁。
monitorenter:加锁。如果缓存失效就发起总线事务,读取最新数据。(被上一个持锁的线程修改后,缓存行失效)。
monitorexit:释放锁。线程在释放锁时,通过全屏障,刷新当前核心的Store Buffer到其缓存,同时使其他核心的缓存失效。(如果临界区内 没有实际修改任何共享变量,JVM 可能跳过更新操作以优化性能。对于存在修改的场景,无论修改是否涉及 volatile 变量,都必须强制更新)
一个线程在尝试获得与这个对象相关联的Monitor的所有权的时候,monitorenter指令会发生如下情况之一:
- 计数器为0,意味着目前还没有被获得,那这个线程就会立刻获得然后把锁计数器+1,一旦+1,别的线程再想获取,就需要等待;
- 如果这个线程已经拿到了这个锁的所有权,又重入了这把锁,那锁计数器就会累加,变成2,并且随着重入的次数,会一直累加;
- 这把锁已经被别的线程获取了,等待锁释放;
什么是可重入?什么是可重入锁?
可重入:若一个程序或子程序可以“在任意时刻被中断然后操作系统调度执行另外一段代码,这段代码又调用了该子程序不会出错”,则称其为可重入(reentrant或re-entrant)的。即当该子程序正在运行时,执行线程可以再次进入并执行它,仍然获得符合设计时预期的结果。与多线程并发执行的线程安全不同,可重入强调对单个线程执行时重新进入同一个子程序仍然是安全的。
可重入锁:又名递归锁,是指在同一个线程在外层方法获取锁的时候,再进入该线程的内层方法会自动获取锁(前提锁对象得是同一个对象或者同一个class),不会因为之前已经获取过还没释放而阻塞。
class MyClass{
    private final volatile int res = 0;

    //test方法获取了本实例对象的锁,然后在increase方法又获取了本实例对象的锁
    //即 重入锁
    //如果不可重入,那么test方法获取了本实例对象的锁后,本实例对象的锁没有释放
    //increase方法又去获取本实例对象的锁,造成阻塞,DEADLOCK
    public void test(){
        //DO SOMETHING
        synchronized(this){
            increase();
        }
    }

    public void increase(){
        synchronized(this){
            if(res >= 0){
            	res++;
            }
        }
    }
}
为什么出现了两条 monitorexit 指令?
编译器需要确保方法中每条monitorenter指令后都要执行对应的monitorexit 指令。为了保证在方法异常时,monitorenter和monitorexit指令也能正常配对执行。编译器会自动产生一个异常处理器,它的目的就是用来执行monitorexit指令,防止出现死锁。
第一条 monitorexit:
- 目的:处理正常退出的情况。
- 流程:当同步代码块内的所有指令都顺利执行完毕,没有抛出任何异常时,程序会执行这条指令。它释放当前线程持有的锁,然后通过
goto指令跳转到方法的返回部分,完全跳过异常处理程序。
第二条 monitorexit:
- 目的:处理异常退出的情况。
- 流程:这是通过 异常表(Exception Table) 实现的。异常表是字节码的一部分,它像一个“监控区”。
- 它声明:同步代码块的范围如果抛出了任何类型 的异常,控制流就立即跳转到异常处理程序的开头。
- 在异常处理程序中,首先执行第二条
monitorexit指令来确保锁被释放,然后再用athrow指令将捕获到的异常原封不动地重新抛出
有序性、可见性实现原理
以ARM为例。
内存屏障
有序性、可见性实现原理依然是通过Monitorenter和Monitorexit指令,或者说其背后的内存屏障。
monitorenter 与 volatile 读有一样的内存屏障,即在monitorenter之后加入 LoadLoad 和 LoadStore。
monitorecit 与 volatile 写有一样的内存屏障,在monitorexit之前加入 StoreStore 内存屏障,在monitorexit之后加入 StoreLoad 内存屏障。
和 volatile 一样,JVM 会使用 DMB 指令来实现这些屏障。在 ARMv8 上,也可能使用 LDAR/STLR 这对具有获取-释放语义的指令来实现锁操作,它们本身隐含了屏障效果,比多次使用 DMB 更高效。
// 共享变量
int sharedVar = 0;
Object lock = new Object();

// 线程A
synchronized (lock) {
    sharedVar = 42; // 修改共享变量
}
// monitorexit:插入StoreStore+StoreLoad屏障,强制通过缓存一致协议通知其他核心更新sharedVar

// 线程B
synchronized (lock) {
    // monitorenter:插入LoadLoad+LoadStore屏障
    //从主内存读取sharedVar
    System.out.println(sharedVar); // 输出42
}
Happens-Before 规则
synchronized内部的代码通过Happens-Before(先行发生)原则的第一条程序次序规则确保有序性的实现。
程序次序规则:在一个线程内(很明显synchronized的锁的实现,确保了synchronized修饰的代码块/方法,在一个线程内执行),按照控制流顺序,书写在前面的操作先行发生于书写在后面的操作。只是保证了单线程中的程序执行顺序是看起来按照书写顺序的,CPU/编译器仍然可以对此进行重排,只要依赖关系不发生冲突,确保有序性的实现。
临界区里可能有成百上千个变量的读写,为什么只在锁的入口和出口插屏障就足够了?
这是因为 Happens-Before 规则中的第二条管程锁定规则:
一个 unlock 操作先行发生于后面对同一个锁的 lock 操作。
JVM 通过在释放锁时插入“写屏障”,强制刷新所有修改;在获取锁时插入“读屏障”,强制清空无效队列。这就保证了:
- 线程A在临界区里做的所有写操作,都在其释放锁(写屏障)时被“推送”出去了。
- 线程B在获取锁(读屏障)时,做好了“接收”所有这些新数据的准备。
- 因此,当线程B进入临界区时,它必然能看到线程A所做的全部修改。
注意
内存屏障是针对于整个代码块的,也就是说synchronized代码块外,虽然能够保证有序性,但是synchronized`代码块内是无法禁止指令重排和处理器优化的,即使有着Happens-Before确保也一样。
final
- 所有的final修饰的字段都是编译期常量吗?
- 如何理解private所修饰的方法是隐式的final?
- 说说final类型的类如何拓展? 比如String是final类型,我们想写个MyString复用所有String中方法,同时增加一个新的toMyString()的方法,应该如何做?
- final方法可以被重载吗? 可以
- 父类的final方法能不能够被子类重写? 不可以
- 说说final域重排序规则?
- 说说final的原理?
- 使用 final 的限制条件和局限性?
final修饰的目标
类
当某个类的整体定义为final时。表明这个类是无法被继承的。
注意:final类中的所有方法都隐式为final,因此无法覆盖。所以在final类中给任何方法添加final关键字是没有任何意义的。
如果想要复用final类中的方法,无法继承,如何解决?
设计模式主要关系有:继承/实现、组合。
继承/实现(X),尝试组合。
class MyClass{
    private FinalClass fc;

    // ...init & other methods

    // 调用final的方法
    public String print(){
        return fc.print();
    }

    // 添加新方法
    public String myPrint(){
        //...
    }
}
变量
final修饰的变量分为,编译期常量,非编译期常量。
编译期常量指的就是程序在编译时就能确定这个常量的具体值。 非编译期常量就是只有程序在运行时才能确定常量的值,因此也称为运行时常量。
都是常量,一旦确定无法修改,只不过确定的时机不一样。
static final修饰的变量,不意味着这一定是编译期常量,也可以是运行时常量。
static关键字的主要作用是:修饰的变量并不属于一个对象实例,而是属于这个类的。static变量在类被 JVM 加载的那一刻就被分配了,由于那时还没有任何对象被创建出来,所以它不可能在堆里。它必须存储在一个与类信息共存的地方。这个地方就是方法区。
方法
- private 方法是隐式的final
- final 方法是可以被重载的
- final 修饰的方法无法被覆写
子类可以覆写父类private方法,同时改为public的原因在于:private方法是隐式的final,没有继承到该方法,它只是定义了一个全新的、属于自己的 public 方法,这个方法恰好与父类某个 private 方法同名而已。
参数
final来修饰方法参数的原因是防止方法参数在调用时被篡改。
如果修饰基础类型,值不能修改。
如果修饰引用类型,仅指向引用对象的对象不能修改。(也就是说还可以通过被引用对象的方法,对被引用对象进行改变,但是指向引用对象的对象,不能被修改指向其他对象)
有序性的实现
以ARM架构为例。
写 final 域的重排序规则
JMM 禁止编译器把 final 域的写操作重排序到构造函数之外。JMM要求在写 final 域之后,构造函数 return 之前,插入一个 StoreStore 内存屏障。这个屏障禁止处理器把 final 域的写操作重排序到构造函数之外。
这意味着: 在对象引用被任何其他线程可见之前,对象的 final 字段必定已经被正确初始化了。
读 final 域的重排序规则
JMM 会在读 final 域的操作之前插入一个 LoadLoad 内存屏障。这确保在读一个对象的 final 字段时,必定先已经读到了该对象的引用(该对象已经构造完毕),从而能读到正确初始化后的 final 值。
public class FinalFieldExample {
    final int x;
    int y;
    static FinalFieldExample instance;
    public FinalFieldExample() {
        x = 1; // 写 final 域
        //StoreStore屏障 更新Store Buffer
        y = 2; // 写普通域
        //构造函数return
    }

    //线程A
    public static void writer() {
        instance = new FinalFieldExample();
    }

    //线程B
    public static void reader() {
        FinalFieldExample obj = instance; // 读对象引用
        if (obj != null) {
            //LoadLoad屏障 确认Invalidate Queue
            int a = obj.x; // 读 final 域 (保证能看到 1)
            int b = obj.y; // 读普通域 (可能看到 0, 即默认值)
            System.out.println("a = " + a + ", b = " + b);
        }
    }
}
假设线程 A 执行 writer(),线程 B 执行 reader()。
得益于 final 的禁止重排序规则:
- 对于线程 B 来说,
int a = obj.x这条语句一定能看到被正确初始化的值1。因为写final域 (x=1) 的操作不能被重排序到构造函数之外,所以在线程 A 将instance引用赋值给obj时,x肯定已经是1了。 - 然而,
int b = obj.y这条语句可能会看到y的默认值0。因为写普通域 (y=2) 的操作没有特殊保护,可能被重排序到instance赋值操作之后。如果发生了这种重排序,线程 B 就可能看到一个尚未完全初始化的对象,从而读到y=0。
这个有序性有一个重要的前提:在构造函数内部,不能让正在构造的 this 引用逸出。
public class ThisEscape {
    final int x;

    public ThisEscape() {
        x = 1;
        // 错误!在构造完成前就发布了this引用
        SomeClass.register(this); // this引用“逸出”了
        // 其他初始化操作...
    }
}
如果在构造函数中把 this 传递给其他方法或线程,那么对方可能在你还没执行完构造函数(比如 x 还没被赋值)时就开始操作x,final 的禁止重排序规则也无法保证这种情况下的线程安全,final 的有序性只是保证了final变量一定会在构造函数结束前完成初始化。
注意
JAVA多线程和并发的一些问题 帮助理解
https://www.cnblogs.com/dolphin0520/p/3932934.html
参考
https://www.cnblogs.com/dolphin0520/p/3920373.html
https://www.cnblogs.com/cswiki/p/14747524.html
https://pdai.tech/md/java/thread/java-thread-x-key-volatile.html
https://juejin.cn/post/7212101193437724728#heading-6
https://ylgrgyq.com/memory-barrier.html
https://www.zhihu.com/question/289712546/answer/2451481994
https://juejin.cn/post/6844904144273145863
https://gist.github.com/yulewei/1e72eea56f7075573c73a2624fe94578
https://mp.weixin.qq.com/s/zvBxfVrB7czS7qU5SW_n7Q
https://www.cnblogs.com/hongdada/p/14087177.html
https://tech.youzan.com/javasuo-yu-xian-cheng-de-na-xie-shi/
https://github.com/farmerjohngit/myblog/issues/13
https://blog.csdn.net/L__ear/article/details/106394728