
Android Jetpack(1) Lifecycle源码阅读记录
Pre
从本篇开端,对Jetpack旗下的框架进行源码的阅读,同时做一些记录。
第一篇,Lifecycle 是LIvedata的基础,考虑到后面也要阅读Livedata的源码,所以第一个框架选择Lifecycle。
The First Rule Of Code Club:Don‘t only talk about code
发现问题
在 Android 开发中,组件(如 Activity/Fragment)的生命周期需要与业务逻辑(如网络请求、数据加载)绑定,但传统方式会导致:
-
高耦合:生命周期回调中充斥业务逻辑。
-
代码冗余:多个 Activity/Fragment 需要重复实现相同逻辑。
-
内存泄漏:若
onDestroy未被调用(如配置变更),资源无法释放。 -
逻辑分散:生命周期逻辑与业务逻辑耦合度高。
belike:
class MyActivity extends AppCompatActivity {


    public void onCreate(...) {
       super.onCreate(...)
       a = new A();
       b = new B();
       c = C.create();
       d = D.Builder.build();
    }

    public void onDestroy() {
        a = null;
        b = null;
        c.destory();
        //d = null;
        super.onDestroy();
    }
}
解决思路
核心需求
- 需要将 生命周期事件 动态通知给多个 业务模块(如网络请求、动画、数据加载)。
- 让 Activity/Fragment与 生命周期管理逻辑 解耦。
- 让 非Activity/Fragment 的组件拥有生命周期
关键思路
-
观察者模式
Why?
- 解耦事件源与监听者:Activity/Fragment(事件源)无需知道具体监听者是谁,同时监听者只需监听抽象的生命周期事件。
- 支持动态注册/注销:业务模块可以灵活订阅或取消生命周期事件。
- 扩展性:新增监听者无需修改 Activity 代码,入侵性小。
-
状态抽象
Why?
- 简化逻辑:业务模块只需关注目标状态(如“在 RESUMED 时执行逻辑”),而非具体回调方法。
- 容错性:状态机可以处理非法状态流转(例如跳过中间状态直接到
DESTROYED)。
-
使用接口
Why?
- 通用性:例如任何组件(如 Service、自定义 View)只需实现
LifecycleOwner,即可提供生命周期。 - 可测试性:例如Mock
LifecycleOwner方便单元测试。 - 框架无关性:例如业务模块只用依赖
Lifecycle接口,而非具体 Activity。
- 通用性:例如任何组件(如 Service、自定义 View)只需实现
-
代理模式
Why?
- 代理对象:
ReportFragment被注入到 Activity 中,代理了 Activity 的生命周期回调。 - 职责分离:
- Activity 本身不直接处理生命周期事件的分发。
ReportFragment负责监听生命周期事件,并转发给LifecycleRegistry。
- 拓展性:让ReportFragment代替 非Activity/Fragment 的组件感知生命周期,实现生命周期回调
- 代理对象:
解决方案
注册-->分发-->执行回调
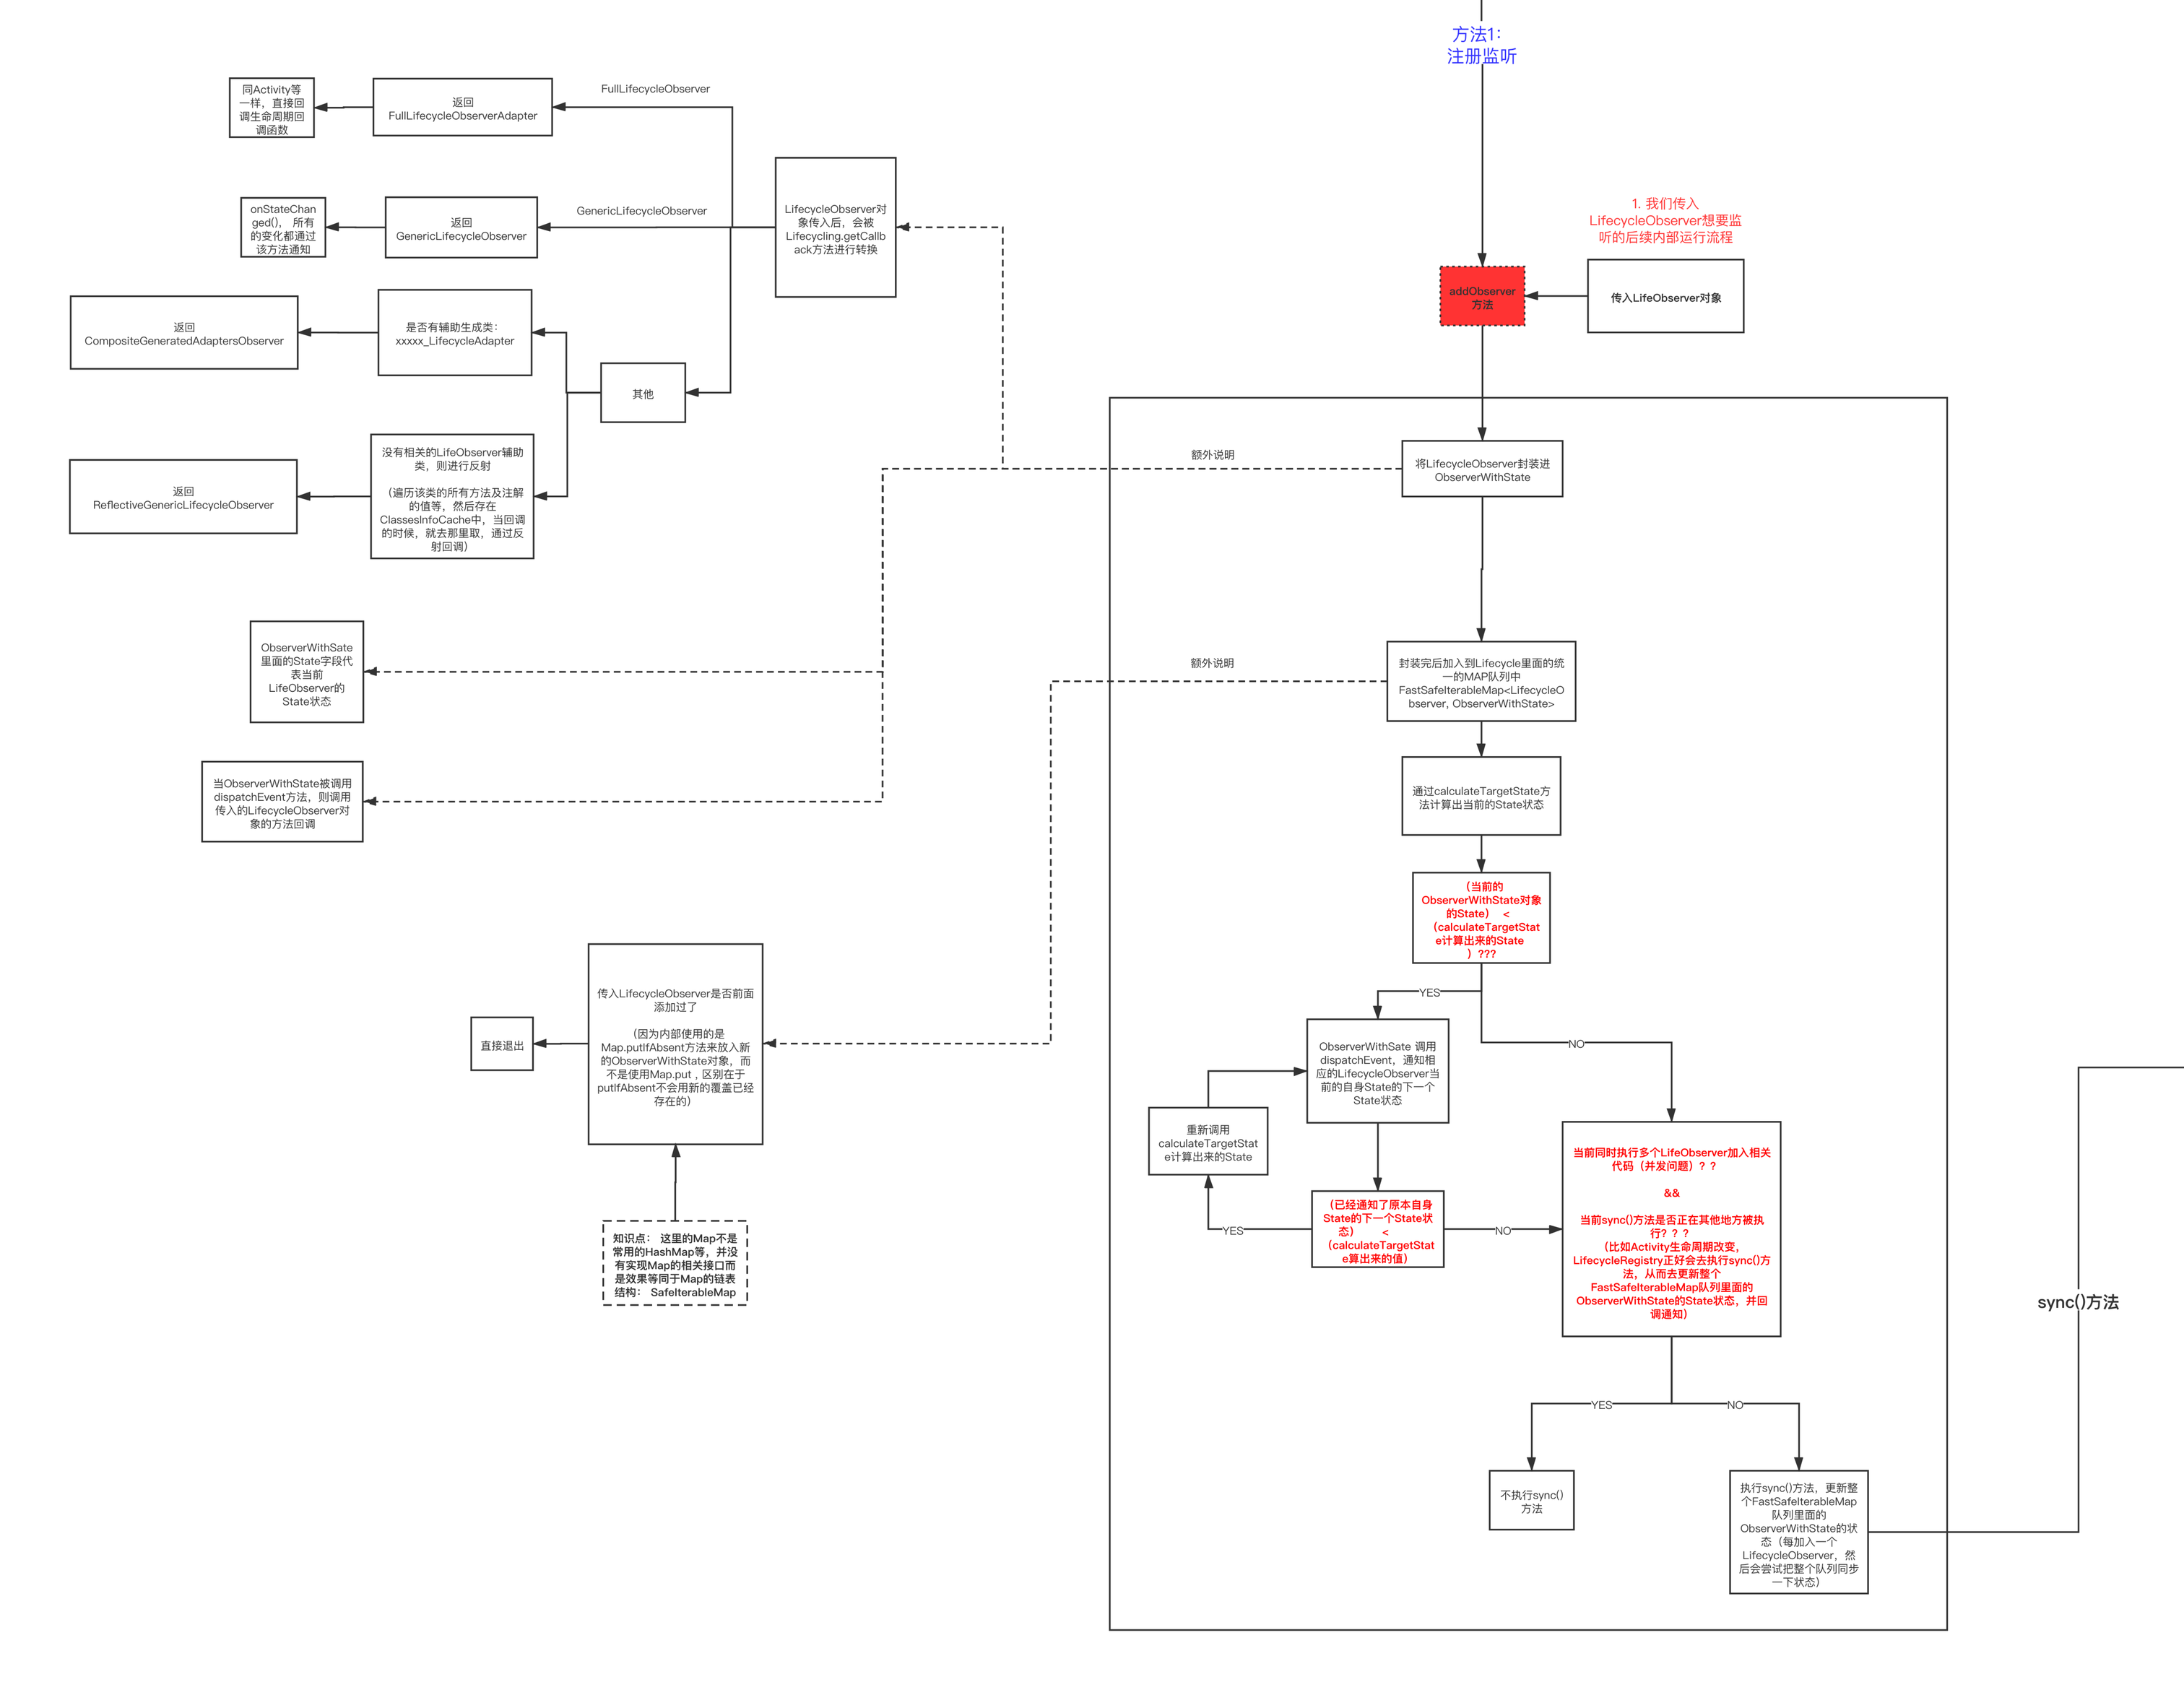
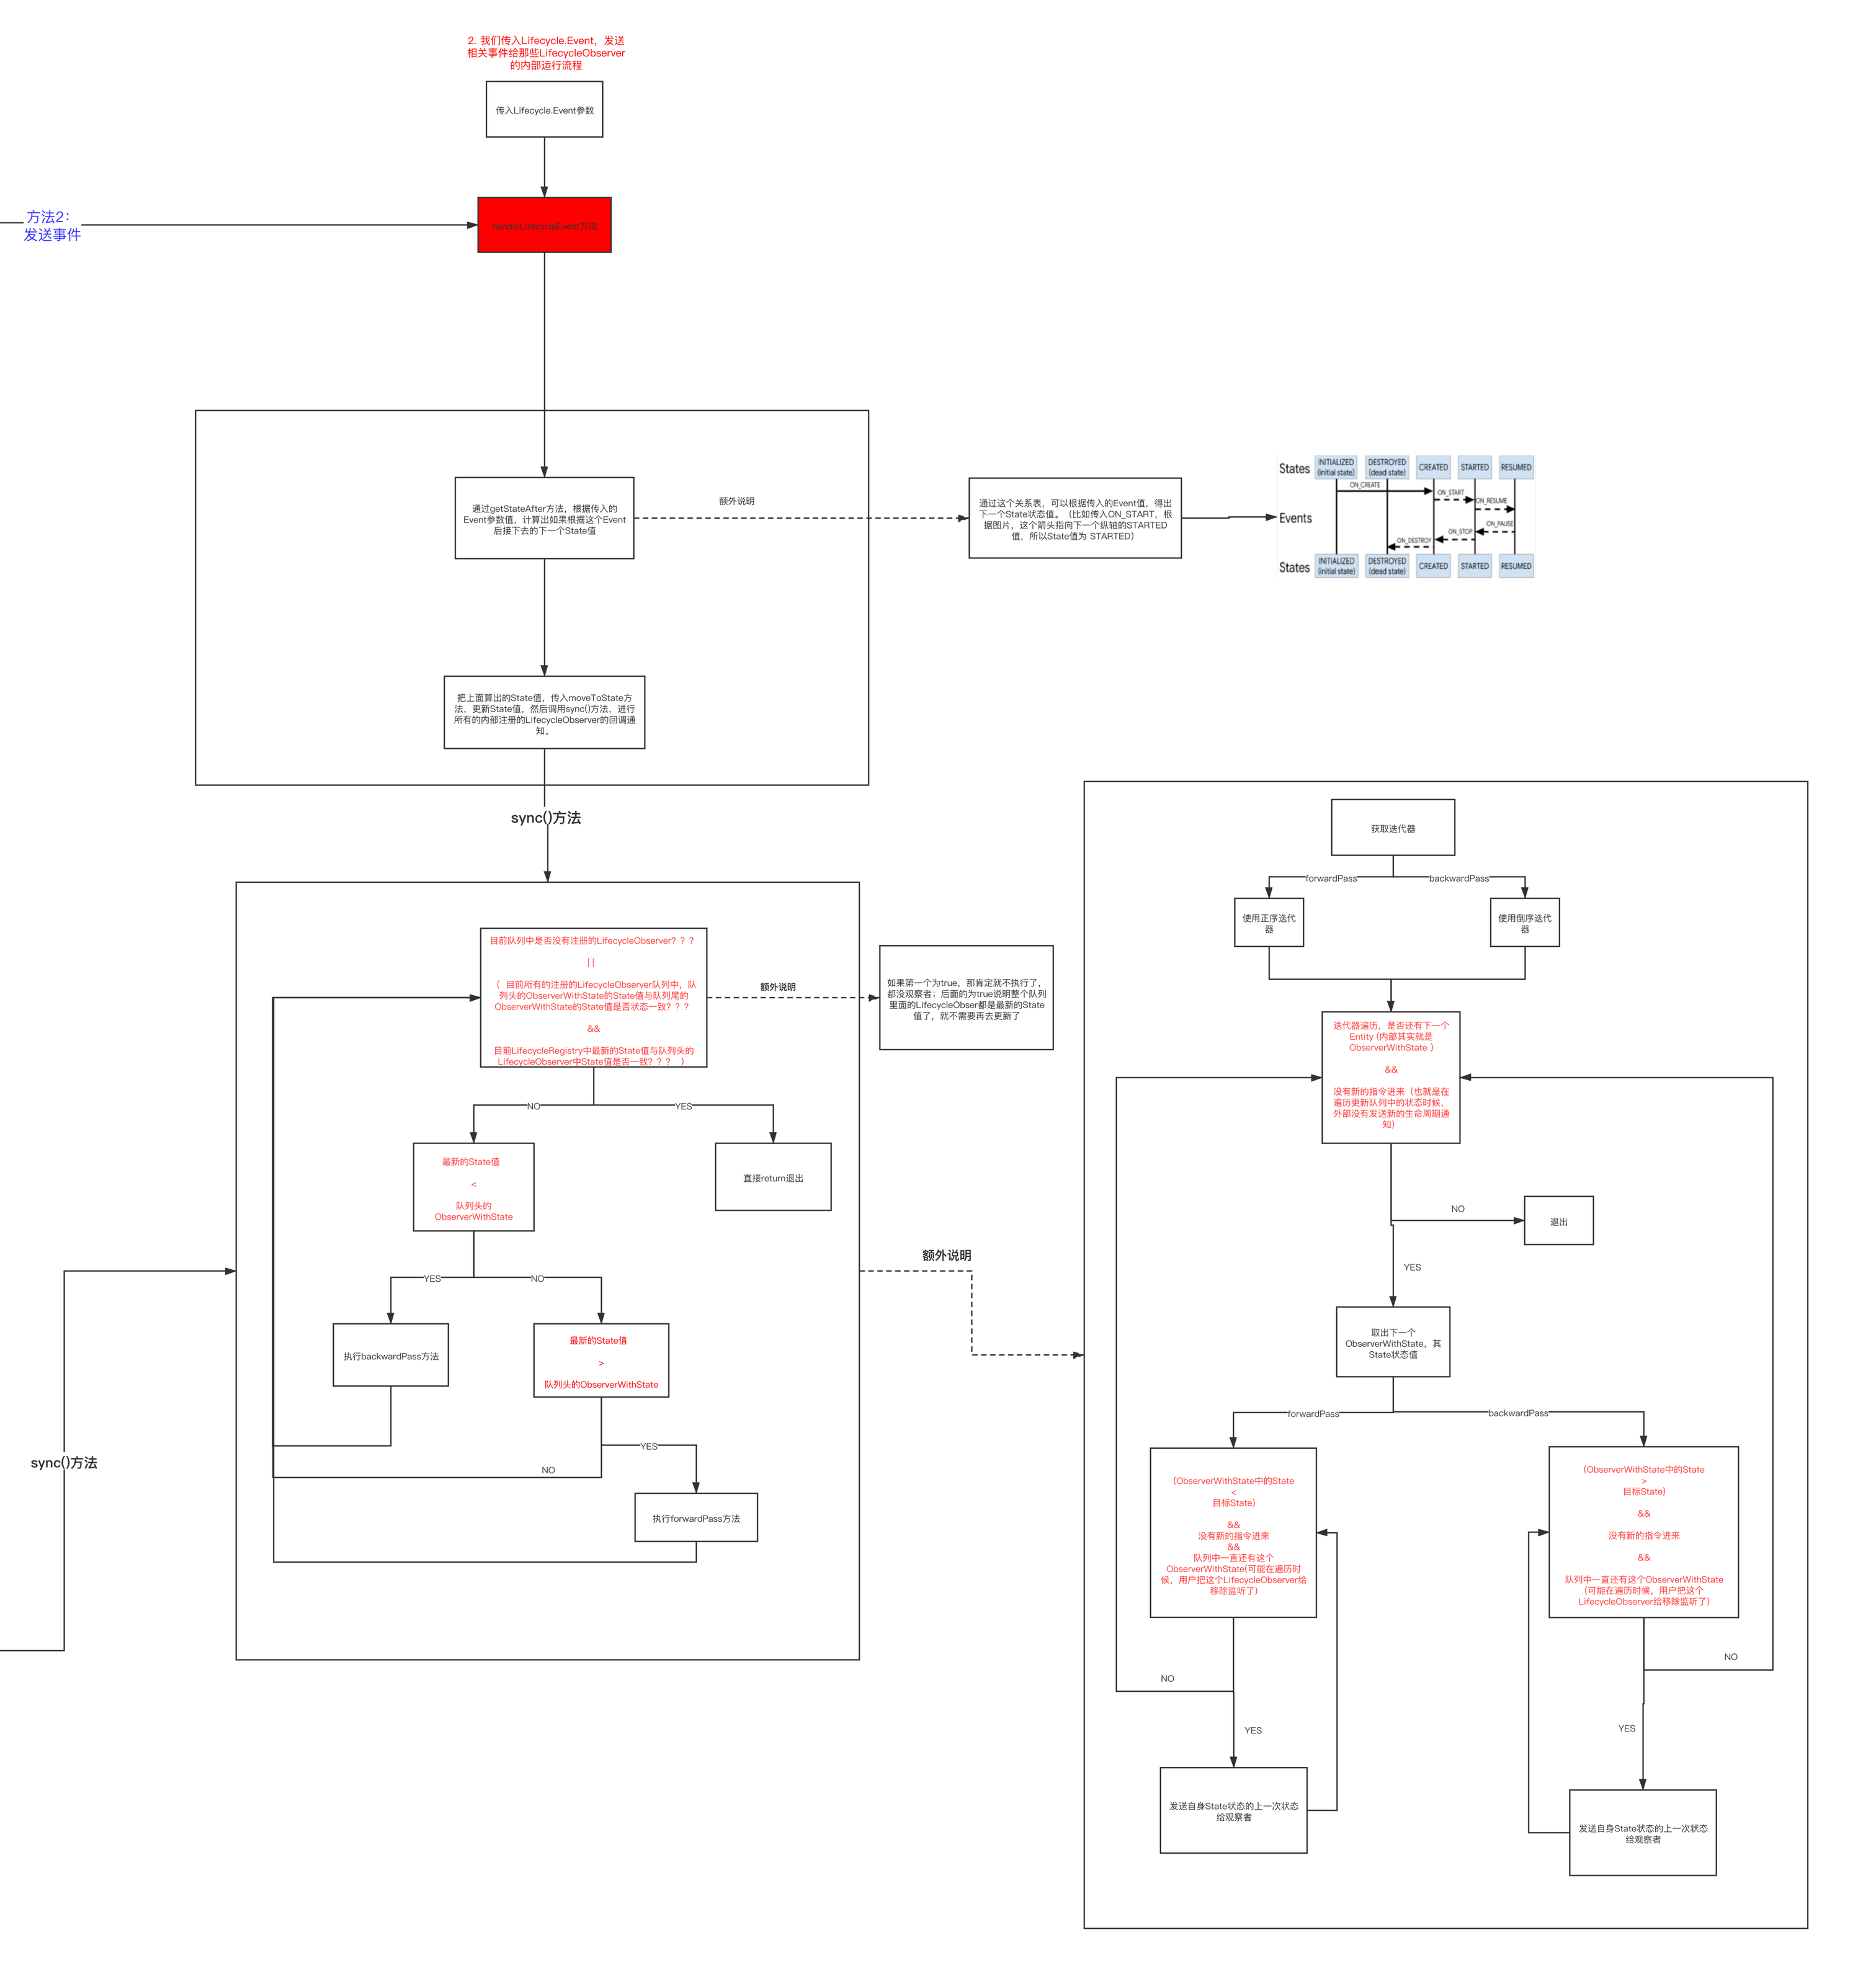
图自 https://juejin.cn/post/6844904061519544334
注意
为什么Lifecycle可以感知到Activity生命周期?
在API < 29的情况下,Activity使用ReportFragment进行代理分发,ReportFragment作为无UI的组件被加入到Activity中,由FragmentActivity的生命周期中同步 Fragment 与 Activity 的生命周期状态,在ReportFragment的生命周期回调中分发状态,实现无入侵。
但是其他组件情况有所不同。
| 组件类型 | 是否使用 ReportFragment |
原因 |
|---|---|---|
| Activity | ✅ 是 | 生命周期封闭,需通过 ReportFragment 代理事件。 |
| Fragment | ❌ 否 | 自身实现 LifecycleOwner,直接管理生命周期事件分发。 |
| Service | ❌ 否 | 没有集成 Lifecycle ,需手动实现分发生命周期事件,或者使用LifecycleService |
| 自定义组件 | ❌ 否 | 没有集成 Lifecycle ,需手动实现分发生命周期事件(如果是自定义View,可以通过findViewTreeLifecycleOwner获得父View绑定的LifecycleOwner,ComponentActivity为DecorView绑定其自身,如果父View没有绑定,那么会一路迭代查到DecorView) |
在 API >= 29 及以上,Activity 会直接通过 Activity.registerActivityLifecycleCallbacks() 进行状态分发,不再需要 ReportFragment。
@JvmStatic
public fun injectIfNeededIn(activity: Activity) {
    if (Build.VERSION.SDK_INT >= 29) {
        // 在 API 29+ 上,我们可以直接注册正确的生命周期回调
        LifecycleCallbacks.registerIn(activity)
    }
    //在 API 29 之前,为了保持与旧版本 ProcessLifecycleOwner(在 lifecycle-runtime 更新时可能不会更新,并且需要支持不从支持库扩展自 FragmentActivity 的 Activity)的兼容性,请使用框架 fragment 来获取生命周期事件的正确时间
    val manager = activity.fragmentManager
    if (manager.findFragmentByTag(REPORT_FRAGMENT_TAG) == null) {
        manager.beginTransaction().add(ReportFragment(), REPORT_FRAGMENT_TAG).commit()
        // Hopefully, we are the first to make a transaction.
        manager.executePendingTransactions()
    }
}
为什么注释@OnLifecycleEvent会被Lifecycle弃用
注释的性能不如直接实现方法
Java 7 的接口不支持默认实现,Java 8 支持。
为什么State设计成五个,Event设计成七个?为什么设计成两个类,而不是只用State描述?
祭出 Google 官方给出的图。
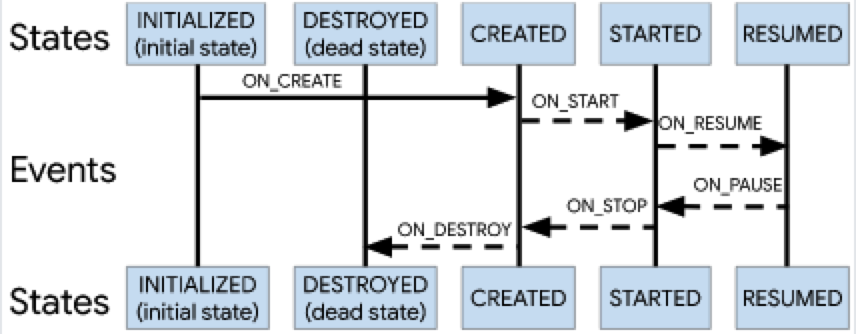
生命周期状态(Lifecycle states)。您可以将状态(State)视为图形中的节点,将 事件Event 视为这些节点之间的边。
-
State是生命周期的稳定阶段,为什么设计成5个是因为 可以简化状态判断逻辑,只需要配合Event,原来的7个State,就可以简化为5个。为什么可以简化,见下文。 -
Event是生命周期回调的映射,为什么设计成7个是因为 为了确保精确控制状态迁移,同时和Activity/Frgament中的OnXXX对应。 -
分离设计 符合状态机理论,职责清晰且灵活。
标准状态机包含:
- 状态(States):系统的稳定阶段。
- 事件(Events):触发状态迁移的动作。
- 迁移规则(Transitions):定义事件如何改变状态。
为什么Event可以简化State?
因为Event可以帮助识别State,即使是同一个State,来自的Event不同也可以判断出真实的生命周期。
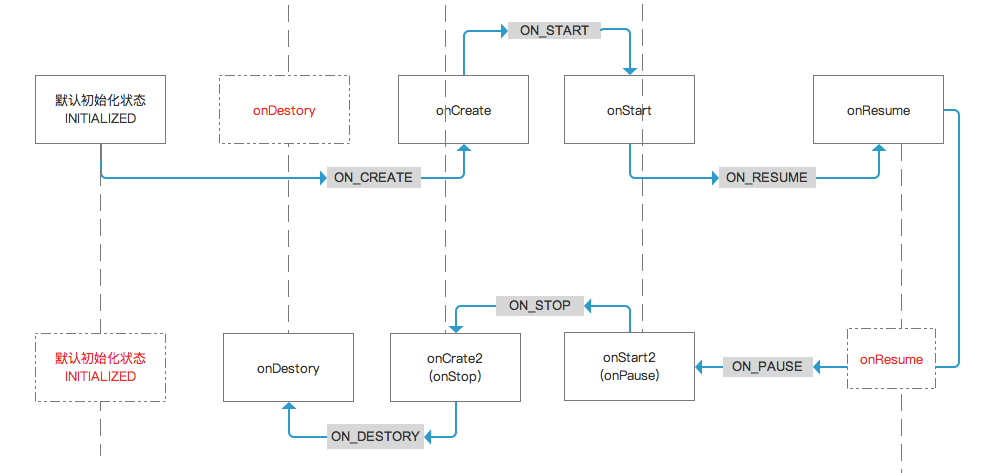
图自 https://juejin.cn/post/6844904061519544334
在Event事件中有着downFrom()、downTo()、upFrom()、upTo() 四个状态降级、升级的方法。
如果对照官方图,那么就是左边的最低级,上面的大于下面的。
//从对应的State,想要降级,需要的事件。
@JvmStatic
public fun downFrom(state: State): Event? {
    return when (state) {
        State.CREATED -> ON_DESTROY
        State.STARTED -> ON_STOP
        State.RESUMED -> ON_PAUSE
        else -> null
    }
}

//降级到对应的State需要的事件。
@JvmStatic
public fun downTo(state: State): Event? {
    return when (state) {
        State.DESTROYED -> ON_DESTROY
        State.CREATED -> ON_STOP
        State.STARTED -> ON_PAUSE
        else -> null
    }
}

//从对应的State, 想要升级, 需要的事件。
@JvmStatic
public fun upFrom(state: State): Event? {
    return when (state) {
        State.INITIALIZED -> ON_CREATE
        State.CREATED -> ON_START
        State.STARTED -> ON_RESUME
        else -> null
    }
}

//升级到对应的State需要的事件。
@JvmStatic
public fun upTo(state: State): Event? {
    return when (state) {
        State.CREATED -> ON_CREATE
        State.STARTED -> ON_START
        State.RESUMED -> ON_RESUME
        else -> null
    }
}
tips:
我们可以看到对于Enum类的比较,是通过顺序之间的减法实现的。也就是说是Enum Class中声明的顺序决定其数值,那么对于LifecycleRegistry#addObserver方法中的statefulObserver.state < targetState表达式就比较好理解了——如果当前加入的Observer的状态落后于计算出来的State状态。
    public enum class State {
        DESTROYED, //0
        INITIALIZED, //1
        CREATED, //2
        STARTED, //3
        RESUMED; //4
    }

public final int compareTo(E o) {
    Enum<?> other = o;
    Enum<E> self = this;
    if (self.getClass() != other.getClass() && // optimization
        self.getDeclaringClass() != other.getDeclaringClass())
        throw new ClassCastException();
    return self.ordinal - other.ordinal;
}
//source:https://github.com/openjdk/jdk/blob/master/src/java.base/share/classes/java/lang/Enum.java#L215
override fun addObserver(observer: LifecycleObserver) {
    //如果当前Owner的状态是 DESTROYED,就初始化为 DESTROYED
    //不然,无论是其他什么状态都初始化为 INITIALIZED
    //1.初始化为 INITIALIZED 是为了把之前的Owner经历过的状态 依次 分发给 observer
    //所以有些人就把这样的操作称为“粘性”——先发送数据,后订阅,也可以接收到数据
    //2.初始化为 DESTROYED 那么就没必要把之前Owner经历过的状态 依次 分发给 observer
    val initialState = if (state == State.DESTROYED) State.DESTROYED else State.INITIALIZED
	//...
    //创建一个ObserverWithState,方便后续分发状态,因为需要知道Observer处于什么状态,才能确定要分发给Observer什么状态
    val statefulObserver = ObserverWithState(observer, initialState)
	//...
    var targetState = calculateTargetState(observer)
    //...
    //实际上这个循环的作用就是 让当前的观察者的状态从初始状态同步到当前宿主的状态
    while (statefulObserver.state < targetState && observerMap.contains(observer)
    ) {
        //...
    }

}
addObserverCounter有什么用?
主要用于 延迟同步,实现性能优化。
什么情况 addObserverCounter 会不等于1,举个例子:
假设在添加观察者 A 的过程中,其回调中又添加了观察者 B:
- 添加
A时,addingObserverCounter从0→1。 - 在
A的 回调中触发添加B,此时addingObserverCounter为2,标记为isReentrance = true。
在嵌套调用中,如果每次add都sync,那么就会可能出现,尚未完成所有观察者的状态更新,就再次更新的情况,导致冗余计算。不如只在顶层后序位置,进行更新。
以上是addObserverCounter 在addObserve方法的作用。
同时, moveToState 方法中为什么也要进行 addingObserverCounter 的判断?
也是为了避免多次调用sync。如果不在顶层进行sync,那么如果sync方法触发A回调时,对Owner状态进行修改, sync 方法就会再一次执行造成性能浪费。
addObserve(A) -> addingObserverCounter++ -> sync -> A的回调,调用了curState/handleLifecycleEvent -> moveToState判断addingObserverCounter -> 因为moveToState触发新状态,需要分发状态,也会执行sync,所以不需要针对新的 curState 再启动新的 sync() 后面直接return即可,同时用 mNewEventOccureed 字段告诉已经执行的 sync() 方法,进行新的一轮队列更新。(详细见sync方法的解释)
override fun addObserver(observer: LifecycleObserver) {
        addingObserverCounter++
    	...
        if (!isReentrance) {
            // we do sync only on the top level.
            sync()
        }
        addingObserverCounter--
}
private fun moveToState(next: State) {
        if (state == next) {
            return
        }
        check(!(state == State.INITIALIZED && next == State.DESTROYED)) {
            "State must be at least CREATED to move to $next, but was $state in component " +
                "${lifecycleOwner.get()}"
        }
        state = next
        if (handlingEvent || addingObserverCounter != 0) {
            newEventOccurred = true
            // we will figure out what to do on upper level.
            return
        }
        handlingEvent = true
        sync()
        handlingEvent = false
        //如果Owner状态为Destroyed,那么没必要维护ObserveMap了
        //创建一个新的,等待GC
        if (state == State.DESTROYED) {
            observerMap = FastSafeIterableMap()
        }
}
为什么addObserver中while同步后,还需要sync同步?
while循环快速处理新观察者,避免遍历所有观察者。sync()兜底全局一致性,确保宿主状态变更后所有观察者同步。
while循环分发状态时,观察者回调可能会导致宿主状态变更,其他观察者的状态可能落后,所以需要sync() 补发状态。
为什么要保证状态正确(Observer的有序性)?
防止逻辑错误。
比如,若观察者状态高于宿主状态(例如观察者为 RESUMED,宿主为 CREATED),会导致逻辑错误(如试图在不可见状态下操作 UI)。
或者,观察者 2 的状态超过观察者 1 的状态,观察者 1 没有初始化完成数据,观察者 2 就使用。造成空指针或者空数据异常。
FastSafeIterableMap数据结构
见——HashMap 番外篇
在这里,在这里需要知道的是,使用(Fast)SafeIterableMap是为了:允许在回调中,进行add/remove Observer。因为sync方法是使用Iterator进行遍历,实现同步状态、分发事件的。正常情况下,在迭代过程中是不允许对集合进行修改的,否则会抛出ConcurrentModificationException异常。
ObserverWithState的作用
可以知道在LifecycleRegistry#addObserver中,使用了一个ObserverWithState类对传入的observer进行包装,其中的作用是什么?
辅助LifecycleRegistry分发事件、更新状态,起到了Adapter的作用,链接LifecycleObserver与LifecycleEventObserver、DefaultLifecycleObserver、SingleGeneratedAdapterObserver、ReflectiveGenericLifecycleObserver、CompositeGeneratedAdaptersObserver。
override fun addObserver(observer: LifecycleObserver) {
    ...
    val initialState = if (state == State.DESTROYED) State.DESTROYED else State.INITIALIZED
    val statefulObserver = ObserverWithState(observer, initialState)
    ...

}

    internal class ObserverWithState(observer: LifecycleObserver?, initialState: State) {
        var state: State
        var lifecycleObserver: LifecycleEventObserver

        init {
            //在这里,可以发现传入的observer被进行了转换,转换为LifecycleEventObserver类。
            lifecycleObserver = Lifecycling.lifecycleEventObserver(observer!!)
            state = initialState
        }

        //可以调用该方法,传入event,从而更新observer的状态 以及 实现event的回调
        //dispatchEvent在 LifecycleRegistry#backwardPass、forwardPass 调用 用于分发事件、更新状态
        fun dispatchEvent(owner: LifecycleOwner?, event: Event) {
            //根据传入的event获得 一个新状态
            val newState = event.targetState
            //新状态 与 当前Observer的状态 取最小的
            //为什么要取最小的?需要考虑状态回退的问题。
            //比如想从 Resumed 回退到 Started (回到桌面导致)
            //(在Event Enum中 Started < Resumed)
            //传来的事件是onPause
            //那么state = Resumed,newState = Started
            //结果就是 state = Started,确保观察者状态不超过宿主状态造成逻辑错误			   //这避免了观察者状态因延迟更新而停留在高状态(如 RESUMED),导致与宿主实际状态不一致的问题
            //如果是升级状态,那么先回保留当前状态(注意:触发回调传入的是事件event,而不是state),最后通过state = newState直接更新
            state = min(state, newState)
            //注意这里是先回调,再更新State
            //回调事件
            lifecycleObserver.onStateChanged(owner!!, event)
            //更新当前观察者状态
            state = newState
        }
    }

	//event#targetState
	//返回由Event导致的State
    public val targetState: State
            get() {
                when (this) {
                    ON_CREATE, ON_STOP -> return State.CREATED
                    ON_START, ON_PAUSE -> return State.STARTED
                    ON_RESUME -> return State.RESUMED
                    ON_DESTROY -> return State.DESTROYED
                    ON_ANY -> {}
                }
                throw IllegalArgumentException("$this has no target state")
    }
Observer的有序性 与 observerMap的 不变性
不变性:在任何时刻对于观察者1和观察者2:如果加入顺序(观察者1)早于 加入顺序(观察者2),那么状态(观察者1)>= 状态(观察者2)。也就是说,新的观察者的状态小于等于之前的(父)观察者的状态。
Invariant: at any moment of time for observer1 & observer2:
if addition_order(observer1) < addition_order(observer2), then state(observer1) >= state(observer2)
这样的不变性,实际上是为了保证 Observer 的有序性——新的观察者的状态小于等于之前的(父)观察者的状态。在以下代码中,正是其实现。
override fun addObserver(observer: LifecycleObserver) {
    ...
    val initialState = if (state == State.DESTROYED) State.DESTROYED else State.INITIALIZED
    val statefulObserver = ObserverWithState(observer, initialState)
    ...
    var targetState = calculateTargetState(observer)
    ...
    while (statefulObserver.state < targetState && observerMap.contains(observer)
        ) {
        	//把当前观察者的State存入,以此应对嵌套调用addObserver的情况
            pushParentState(statefulObserver.state)
        	//从对应的State, 想要升级, 需要的事件
        	//每次得到一个事件,从而实现依次更新状态、分发事件!
            val event = Event.upFrom(statefulObserver.state)
        	//传给ObserverWithState进行事件回调
            statefulObserver.dispatchEvent(lifecycleOwner, event)
            popParentState()
            //传给ObserverWithState#dispatchEvent 会使得 观察者的状态更新
        	//再次计算 当前观察者状态 与 父观察者的状态(如果有) 与 全局状态 的最小值
        	//以便下一次while循环的判断,从而实现依次更新状态、分发事件
            targetState = calculateTargetState(observer)
    }
}
private fun calculateTargetState(observer: LifecycleObserver): State {
    	//取得前一个(父)观察者(嵌套调用发生)
        val map = observerMap.ceil(observer)
    	//当前传入的观察者状态
        val siblingState = map?.value?.state
    	//父观察者状态
        val parentState =
            if (parentStates.isNotEmpty()) parentStates[parentStates.size - 1] else null
    	//取min
        return min(min(state, siblingState), parentState)
    }
parentStates的作用
实际上,parentStates的作用与 Observer的 有序性 与 observerMap的 不变性 紧密相关。或者说正是维持两者性质的关键。
    // we have to keep it for cases:
    // void onStart() {
    //     mRegistry.removeObserver(this);
    //     mRegistry.add(newObserver);
    // }
    // newObserver should be brought only to CREATED state during the execution of
    // this onStart method. our invariant with observerMap doesn't help, because parent observer
    // is no longer in the map.
    private var parentStates = ArrayList<State>()
正是为了应对,在observer的生命周期回调中removeObserver移除自身,又addObserver新观察者的情况发生。
假如Observer链表中仅存在一个Observer1,这个Observer在onStart()中,从链表observerMap中移除,且添加一个新的Observer2。
在onStart()回调执行过程中,实际上Observer1的状态还没转变为STARTED,而是还处在CREATED。
fun dispatchEvent(owner: LifecycleOwner?, event: Event) {
	val newState = event.targetState
 	state = min(state, newState)
 	//注意这里是先回调,再更新State
 	lifecycleObserver.onStateChanged(owner!!, event)
 	state = newState
}
fun onStart() {
     mRegistry.removeObserver(this);
     mRegistry.add(newObserver);
}
在onStateChange()回调到onStart()中,Observer1从observerMap中移除,添加Observer2。
Observer2在addObserver中同步,targetState通过calculateTargetState()获取,假如不引入parentStates,将会使Observer2直接同步到STARTED。
//这里假定没有mParentStates
private fun calculateTargetState(observer: LifecycleObserver): State {
    	// 由于Observer1已移除,map == null
        val map = observerMap.ceil(observer)
    	//siblingState == null
        val siblingState = map?.value?.state
    	//父观察者状态
        //val parentState = ...
    	//取min,那么Observer2的State就会变成STARTED,比Observer1优先进入。
        return min(state, siblingState)
}
此时会导致Observer2优先Observer1进入STARTED状态,破坏了observerMap的不变性。
引入parentStates,就是为了解决以上的情况。由于parentStates缓存了Observer1的值,即使Observer1从链表中移除,依然能从parentStates中获取,防止后续添加的Observer2初始化时越界,导致observerMap的 不变性 失效。
也就是说parentStates 做到了一个Backup的作用。
分发生命周期的核心——Sync方法
首先,需要知道,LifecycleRegistry——是作为生命周期分发的枢纽,其具有对加入的观察者进行轮询状态更新的方法。
Activity/Fragment/自定义组件等,可以通过持有LifecycleRegistry在对应的生命周期回调函数中,进行生命周期的分发的通知。
对于Activity/Fragment,Google已经内置了相关的代码,无需手动初始化LifecycleRegistry、手动分发。
对于自定义组件,我们则需要知道LifecycleRegistry分发事件/状态的方法有哪些:
1.传入State,告诉要跳到这个State状态(其实等于使用currentState)
registry.markState(Lifecycle.State.CREATED)

public open fun markState(state: State) {
 	enforceMainThreadIfNeeded("markState")
 	currentState = state
}

//将Lifecycle 移动到给定状态,并将必要的事件分派给观察者。
registry.currentState = ...
actual override var currentState: State
	get() = state
	set(state) {
            enforceMainThreadIfNeeded("setCurrentState")
            moveToState(state)
}
2.传入Event,然后跳到相应的Event对应的State状态
registry.handleLifecycleEvent(Lifecycle.Event.ON_RESUME)
public actual open fun handleLifecycleEvent(event: Event) {
        enforceMainThreadIfNeeded("handleLifecycleEvent")
        moveToState(event.targetState)
}
以上两者,最终的调用是前往moveToState方法。
在ReportFragment的各个生命周期方法中(onStart、onResume等),都会调用dispatch方法分发对应的生命周期状态,调用流程ReportFragment#dispatch - > handleLifecycleEvent -> moveToState -> sync -> backwardPass/forwardPass -> dispatchEvent -> onStateChanged。
针对于不依赖ReportFragment (Androidx.Fragment),也大相径庭,通过LifecycleCallbacks#dispatch -> handleLifecycleEvent/currentState -> moveToState -> sync -> backwardPass/forwardPass -> dispatchEvent -> onStateChanged。
那么,就来看看moveToState方法。
private fun moveToState(next: State) {
    //当前的State状态已经和要求变化的State一致,没有必要运行下去
    //所以传入多个相同State值,该方法也只会执行一次
    if (state == next) {
        return
    }
    //如果当前状态是INITIALIZED,传入的是DESTROYED,那么就会报错
    //确保组件必须经历 onCreate() 初始化资源后,才能通过 onDestroy() 释放资源。
	//INITIALIZED 是在 onCreate之前的状态
    check(!(state == State.INITIALIZED && next == State.DESTROYED)) {
        "State must be at least CREATED to move to $next, but was $state in component " +
            "${lifecycleOwner.get()}"
    }

    //更新状态
    state = next

    //handlingEvent 看下面代码,
    //只有在moveToState内会设置true、false,表示正在sync遍历观察者队列进行更新。
    //addingObserverCounter 前面有解释
    if (handlingEvent || addingObserverCounter != 0) {

    //如果进入是因为mHandlingEvent为true引起的,说明同步过程中发生新事件
    //某个观察者的回调(如 onStart())触发了新的生命周期状态变更,导致一个新的State传入本方法(markToSate/handleLifecycleEvent -> 本方法)。
    //对于队列更新方法sync,那些已经更新好的那些观察者,就算不是最新的了。
    //那么就要重新更新一遍,所以需要mNewEventOccurred在sync()方法里面
    //告诉它有新的Event值进来了,提前中止这一次队列更新,进行下一次队列更新,从而减少不必要的分发。
    //sync()的核心逻辑,只要!isSynced为true,无论mNewEventOccurred如何继续执行
    //private fun sync() {
    //    while (!isSynced) {
    //		  mNewEventOccurred = false !
    //        if (...) {
    //            while(!mNewEventOccurred){}
    //        }
    //        if (...) {
    //            while(!mNewEventOccurred){}
    //        }
    //    }
    //}


    //如果进入是因为addingObserverCounter(addObserver也会调用到sync)
    //进行addingObserverCounter的判断,也是为了避免多次调用sync。
    //如果不在顶层进行sync,那么在A的回调如果添加新的观察者B,观察者B又在回调中有新事件发送,sync方法就会再一次执行造成性能浪费。
	//add(A) -> sync -> A的回调, add(B) [sync未结束] -> addingObserverCounter++ ->
    //B的回调,调用了curState/handleLifecycleEvent ->
    //moveToState判断addingObserverCounter ->
    //到当前if语句,因为A的sync未结束,所以不需要针对新的State再启动新的sync() ,所以后面接return
    //同时用mNewEventOccureed字段告诉已经执行的sync()方法,进行新的一轮队列更新。

        newEventOccurred = true

        //return 就是不用往下走
        return
    }
    //表明正在sync
    handlingEvent = true
    sync()
    //表明sync结束
    handlingEvent = false

    //observerMap 存储了所有注册的 LifecycleObserver 实例。
    //如果宿主(如 Activity/Fragment)已被销毁(状态为 DESTROYED)
    //但 observerMap 仍保留这些观察者的强引用,会导致观察者无法被垃圾回收(尤其是观察者持有宿主或 Context 时)。
	//所以将 observerMap 替换为新的空实例,断开对旧观察者的引用,帮助垃圾回收器回收内存。
    if (state == State.DESTROYED) {
        observerMap = FastSafeIterableMap()
    }
}
我们发现moveToState只是进行了宿主状态的相关更新,那么真正的事件分发就在sync方法中了。
接下来就可以进入最为关键的——sync方法。
//仅发生在堆栈的顶部(永远不会在嵌套add中调用),因此它不必考虑 parents
private fun sync() {
    //因为在调用sync前,可能在addObsever中的while事件回调导致Owner被GC,所以是too late
    //如果宿主为空,就没有必要分发事件了,否则可能会造成错误
    val lifecycleOwner = lifecycleOwner.get()
        ?: throw IllegalStateException(
            "LifecycleOwner of this LifecycleRegistry is already " +
                "garbage collected. It is too late to change lifecycle state."
        )

    //isSynced属性的代码在下方
    while (!isSynced) {
        //注意,newEventOccurred只有在sync方法中才能被设置为false
        //moveToState、backwardPass、forwardPass都无法设置
        newEventOccurred = false
        //当前宿主状态 与 链表头观察者状态 比较
        //如果链表头观察者状态 超过 宿主状态,链表队列降级。
        if (state < observerMap.eldest()!!.value.state) {
            //降级,见下方
            //可以发现启动降级的条件是判断链表头,降级时却是从链表尾开始!!!
            //这实际上还是为了为此ObserverMap的不变性
            //新的观察者的状态小于等于之前的(父)观察者的状态。
            backwardPass(lifecycleOwner)
        }
        //为什么这里需要判断newEventOccurred,而上面不需要?
        //因为第一行就设置了为newEventOccurred = false,是不需要判断的,必然为false,
        //但是在backwardPass降级过程中,触发的回调是可能调用moveToState中的newEventOccurred变为true,
        //所以需要检查newEventOccurred。

        //当前宿主状态 与 链表尾观察者状态 比较, 同时检查是否 有新事件发送到moveToState
        //如果链表头观察者状态 落后 宿主状态,链表队列升级
        val newest = observerMap.newest()
        if (!newEventOccurred && newest != null && state > newest.value.state) {
            //升级,见下方
            //可以发现启动升级的条件是判断链表尾,升级时却是从链表头开始!!!
            //这实际上还是为了为此ObserverMap的不变性
            //新的观察者的状态小于等于之前的(父)观察者的状态。
            forwardPass(lifecycleOwner)
        }
    }
    //设置为false,moveToState才能正常调用到sync
    newEventOccurred = false
    //sync过后,才能通过StateFlow获取最新的State
    _currentStateFlow.value = currentState
}

private val isSynced: Boolean
 	get() {
    //没有观察者,那么没必要同步了
 	if (observerMap.size() == 0) {
                return true
 	}
    //observerMap.eldest() 获得链表头的状态
    //observerMap.newest() 获得链表尾的状态
 	val eldestObserverState = observerMap.eldest()!!.value.state
 	val newestObserverState = observerMap.newest()!!.value.state
    // 判断 链表头的状态  链表尾的状态 是否都等于 Owner的状态
    //为什么只用判断头尾的状态?见子标题
 	return eldestObserverState == newestObserverState && state == newestObserverState
}

private fun forwardPass(lifecycleOwner: LifecycleOwner) {
        @Suppress()
    	//可以发现启动升级的条件是判断链表尾,升级时却是从链表头开始!!!
    	//正向顺序遍历
    	//可以发现升级是正向遍历,也就是从链表头开始
        val ascendingIterator: Iterator<Map.Entry<LifecycleObserver, ObserverWithState>> =
    		//注意这里使用iteratorWithAdditions,而不是ascendingIterator
    		//这是为了动态感知 observerMap 的变更,确保任何在遍历期间新增的 Observer 都能立刻参与状态同步,避免遗漏。
            observerMap.iteratorWithAdditions()
    	//注意这里有 newEventOccurred 这个哨兵变量
    	//如果在升级时,有回调发送新的状态,那么newEventOccurred就会变为true,然后提前结束这次升级
        while (ascendingIterator.hasNext() && !newEventOccurred) {
            val (key, observer) = ascendingIterator.next()
            //注意这里有 newEventOccurred 这个哨兵变量
            //如果在升级时,有回调发送新的状态,那么newEventOccurred就会变为true,然后提前结束这次升级
            //回到sync方法中,准备重新判断是升级,还是降级
            while (observer.state < state && !newEventOccurred && observerMap.contains(key)
            ) {
                //眼熟?在addObserver方法中。
                //考虑嵌套add-remove的情况,所以需要backup当前状态
                pushParentState(observer.state)
                //从当前State,想要升级,获取得到需要什么事件
                //注意这里是个while循环,所以会一次次升级,从而实现依次分发事件
                val event = Event.upFrom(observer.state)
                    ?: throw IllegalStateException("no event up from ${observer.state}")
                //把得到的事件分发,更新状态
                observer.dispatchEvent(lifecycleOwner, event)
               	//弹出当前状态,没必要继续存着节约内存,同时保证其他方法执行calculateTargetState的结果正确
                popParentState()
            }
        }
}

private fun backwardPass(lifecycleOwner: LifecycleOwner) {
        //可以发现启动降级的条件是判断链表尾,降级时却是从链表尾开始!!!
        //逆向顺序遍历
    	//可以发现降级是逆向遍历,也就是从链表尾开始
        val descendingIterator = observerMap.descendingIterator()
    	//因为新增的 Observer通常刚添加,状态应是初始值,不需要降级,所以没有实现一个descendingIteratorWithAddtion的类
        while (descendingIterator.hasNext() && !newEventOccurred) {
            val (key, observer) = descendingIterator.next()
            //注意这里有 newEventOccurred 这个哨兵变量
            //如果在降级时,有回调发送新的状态,那么newEventOccurred就会变为true,然后提前结束这次降级
            //回到sync方法中,准备重新判断是升级,还是降级
            while (observer.state > state && !newEventOccurred && observerMap.contains(key)
            ) {
                //从当前State,想要降级,获取得到需要什么事件
                val event = Event.downFrom(observer.state)
                    ?: throw IllegalStateException("no event down from ${observer.state}")
                pushParentState(event.targetState)
                observer.dispatchEvent(lifecycleOwner, event)
                popParentState()
            }
        }
}
为什么只用判断头尾的状态?
-
降级:判断链表头,若头节点状态已降级到宿主状态,则所有中间观察者状态必然已降级(
backwardPass从尾到头处理)。 -
升级:判断链表尾,若尾节点状态已升级到宿主状态,则所有中间观察者状态必然已升级(
forwardPass从头到尾处理)。 -
结论:头尾状态与宿主状态一致 → 中间所有观察者状态一致。
使用数学归纳证明:
假设链表中有 n 个观察者:
基例:若头尾状态一致,且与宿主状态一致,当 n=2 时,中间无其他观察者,显然同步完成。
归纳:假设 n=k 时成立,当 n=k+1 时,新增观察者(在尾部)的状态会在 forwardPass 或 backwardPass 中被同步,最终头尾状态仍一致。
检查头尾状态的时间复杂度为 O(1),而遍历所有观察者的时间复杂度为 O(n),性能优越。
为什么Sync方法先判断降级,再去判断升级?
如果先进行升级判断,然后执行升级,如果此时宿主状态降级,可能导致升级时分发的生命周期回调出现逻辑错误。
如果错误地先执行升级, Observer A 升往 RESUMED 状态,Observer A 会执行那些只在 RESUMED 状态下才允许的操作,比如启动动画、响应用户输入等。由于 Activity 实际上已经从 RESUMED 降级到了 STARTED,Observer A 与 Activity 状态不匹配,就可能出现UI 更新操作错误(例如尝试访问已经不可见或即将销毁的界面资源)。
而选择先降级,那么可以保证Observer 一定不会越过宿主的状态。
为什么升级判断的是链表尾,遍历是从链表头开始 && 降级判断的是链表头,遍历是逆向?
升级:先注册的观察者(链表头)可能需要优先初始化(例如初始化数据库),后注册的观察者可能依赖这些资源。
降级:后注册的观察者可能依赖先注册的观察者的资源,需先释放后注册的观察者(例如先关闭 UI 组件,再释放数据层)。
最主要的还是保证ObserverMap的有序性:新的观察者的状态小于等于之前的(父)观察者的状态。
为什么在Sync方法中已经判断出需要降级,还需要去判断是否需要前进操作?
举例说明,假设observerMap中状态都是3 (STARTED),数据结构为[3,3,3,3],此时传入新的State = 1,那么需要降级。
更新一半后,[3,3,1,1],此时传入新的State = 2,先判断链表头 -> 执行降级 -> 从链表尾执行 -> 结果[2,2,1,1] -> 再判断链表尾 -> 执行升级 -> 从链表头执行 -> [2,2,2,2]。
也就是说,一次sync可能会要处理多次State,降级升级都要进行,所以都要判断。
有哪些不同的观察者类型?
在ObserverWithState的作用中,我们提到构造ObserverWithState时,传入的Observer会被进行一层包装,包装的结果有以下的类型:
LifecycleEventObserver
//该类可以接收任何生命周期更改并将其分派给接收方。
//如果某个类同时实现此接口和 androidx.lifecycle.DefaultLifecycleObserver
//则将首先调用 DefaultLifecycleObserver 的方法,然后调用 LifecycleEventObserver.onStateChanged
//如果某个类实现此接口并同时使用 OnLifecycleEvent,则将忽略注释。
public fun interface LifecycleEventObserver : LifecycleObserver {
    public fun onStateChanged(source: LifecycleOwner, event: Lifecycle.Event)
}
DefaultLifecycleObserver
public interface DefaultLifecycleObserver : LifecycleObserver {

     // This method will be called after the [LifecycleOwner]'s `onCreate` method returns.
    public fun onCreate(owner: LifecycleOwner) {}

     // This method will be called after the [LifecycleOwner]'s `onStart` method returns.
    public fun onStart(owner: LifecycleOwner) {}

    //This method will be called after the [LifecycleOwner]'s `onResume`method returns.
    public fun onResume(owner: LifecycleOwner) {}

    //This method will be called before the [LifecycleOwner]'s `onPause` method is called.
    public fun onPause(owner: LifecycleOwner) {}

     // This method will be called before the [LifecycleOwner]'s `onStop` method is called.
    public fun onStop(owner: LifecycleOwner) {}

     // This method will be called before the [LifecycleOwner]'s `onDestroy` method is called.
    public fun onDestroy(owner: LifecycleOwner) {}
}
SingleGeneratedAdapterObserver
CompositeGeneratedAdaptersObserver
//帮助判断是否引用了compiler,同时配合Adapter实现事件回调
public class TestObserver_LifecycleAdapter implements GeneratedAdapter {
  final TestObserver mReceiver;

  TestObserver_LifecycleAdapter(TestObserver receiver) {
    this.mReceiver = receiver;
  }


  @Override
  public void callMethods(LifecycleOwner owner, Lifecycle.Event event, boolean onAny,
      MethodCallsLogger logger) {
    boolean hasLogger = logger != null;
    if (onAny) {
      //调用了我们自定义的观察者的方法
      mReceiver.xxx(owner,event);
      return;
    }
    if (event == Lifecycle.Event.ON_CREATE) {
      mReceiver.x(owner);
      return;
    }
    if (event == Lifecycle.Event.ON_START) {
       mReceiver.xx(owner);
      return;
    }
  }
}

internal class SingleGeneratedAdapterObserver(
    private val generatedAdapter: GeneratedAdapter
) : LifecycleEventObserver {
    override fun onStateChanged(source: LifecycleOwner, event: Lifecycle.Event) {
        generatedAdapter.callMethods(source, event, false, null)
        generatedAdapter.callMethods(source, event, true, null)
    }
}

internal class CompositeGeneratedAdaptersObserver(
    private val generatedAdapters: Array<GeneratedAdapter>
) :
    LifecycleEventObserver {
    override fun onStateChanged(source: LifecycleOwner, event: Lifecycle.Event) {
        val logger = MethodCallsLogger()
        for (adapter in generatedAdapters) {
            adapter.callMethods(source, event, false, logger)
        }
        for (adapter in generatedAdapters) {
            adapter.callMethods(source, event, true, logger)
        }
    }
}
ReflectiveGenericLifecycleObserver
//反射
@Deprecated
class ReflectiveGenericLifecycleObserver implements LifecycleEventObserver {
    private final Object mWrapped;
    //这里用到的ClassesInfoCache及CallbackInfo 后续会提到
    private final ClassesInfoCache.CallbackInfo mInfo;

    ReflectiveGenericLifecycleObserver(Object wrapped) {
        this.mWrapped = wrapped;
        //通过class获取到 这个类自己的、父类的、实现的接口的,带有OnLifecycleEvent注释的方法
        this.mInfo = ClassesInfoCache.sInstance.getInfo(this.mWrapped.getClass());
    }

    public void onStateChanged(@NonNull LifecycleOwner source, @NonNull Lifecycle.Event event) {
        //调用反射得到方法
        this.mInfo.invokeCallbacks(source, event, this.mWrapped);
    }
}
上述都是LifecycleObserver的实现/继承类。
为什么会有这么多类型呢?实际上是因为LifecycleObserver接口本身只有一行代码,就是声明本身。
public interface LifecycleObserver
lifecycleEventObserver方法
我们知道LifecycleObserver的包装适配,是在ObserverWithState中完成的。
    internal class ObserverWithState(observer: LifecycleObserver?, initialState: State) {
        var state: State
        var lifecycleObserver: LifecycleEventObserver

        init {
        	//在这里进行包装
            lifecycleObserver = Lifecycling.lifecycleEventObserver(observer!!)
            state = initialState
        }

		...
    }
那么就来看看lifecycleEventObserver这个方法。(注意,只有lifecycleEventObserver这个方法比较关键,后续的源码偏向生成代码、反射的应用可以不用了解,因为这些关于生成代码、反射的代码已经被弃用、判断为过时了,但是理解其中的思路是对其他框架源码的阅读是有帮助的。)
@JvmStatic
@Suppress("DEPRECATION")
public actual fun lifecycleEventObserver(`object`: Any): LifecycleEventObserver {
    //是否是LifecycleEventObserver的子类
    val isLifecycleEventObserver = `object` is LifecycleEventObserver
    //是否是DefaultLifecycleObserver的子类
    val isDefaultLifecycleObserver = `object` is DefaultLifecycleObserver
    //都是,构建使用二者的DefaultLifecycleObserverAdapter
    if (isLifecycleEventObserver && isDefaultLifecycleObserver) {
        //包装为Adapter帮助实现事件分发的回调
        return DefaultLifecycleObserverAdapter(
            `object` as DefaultLifecycleObserver,
            `object` as LifecycleEventObserver
        )
    }
    //如果只是DefaultLifecycleObserver的子类
    if (isDefaultLifecycleObserver) {
        //同样包装为DefaultLifecycleObserverAdapter,但是另外一个为null
        return DefaultLifecycleObserverAdapter(`object` as DefaultLifecycleObserver, null)
    }
    //假如是LifecycleEventObserver则直接返回
    if (isLifecycleEventObserver) {
        return `object` as LifecycleEventObserver
    }
    //以上都不是,那么应该是直接继承了LifecycleObserver
    val klass: Class<*> = `object`.javaClass
    //通过 getObserverConstructorType 判断使用生成代码还是反射
    //实际上就是通过判断 类名<ClassName>_LifecycleAdapter.class的适配类是否存在,从而判断是否引入了compiler,如果存在就使用GENERATED_CALLBACK。
    //见下方
    val type = getObserverConstructorType(klass)
    //假如使用生成代码
    if (type == GENERATED_CALLBACK) {
        // classToAdapters在getObserverConstructorType#resolveObserverCallbackType中第一次生成
        // 获取在getObserverConstructorType填充好的构造器列表
        val constructors = classToAdapters[klass]!!
        if (constructors.size == 1) {
            //返回一个用构造器生成实例 是adapterClass的实例
            val generatedAdapter = createGeneratedAdapter(
                constructors[0], `object`
            )
            //使用SingleGeneratedAdapterObserver 适配
            return SingleGeneratedAdapterObserver(generatedAdapter)
        }
        //如果构造函数的数量大于1 (说明有父类/接口,其中有事件回调的方法),生成GeneratedAdapter数组
      	//使用CompositeGeneratedAdaptersObserver 适配,能够调用所有的Adapter事件回调方法
        val adapters: Array<GeneratedAdapter> = Array(constructors.size) { i ->
            createGeneratedAdapter(constructors[i], `object`)
        }
        return CompositeGeneratedAdaptersObserver(adapters)
    }
    //以上都不是,那么使用反射生成
    //ReflectiveGenericLifecycleObserver 实现了 LifecycleEventObserver
    //在 onStateChanged() 调用了 invokeCallbacks() 方法通过反射的形式来调用自定义的 LifecycleObserver 中相关方法。
    return ReflectiveGenericLifecycleObserver(`object`)
}
生成代码与反射的应用
private fun getObserverConstructorType(klass: Class<*>): Int {
    	//这里实际上是调用resolveObserverCallbackType 获取type
    	//存在class对应的type缓存直接返回,节约资源
        val callbackCache = callbackCache[klass]
        if (callbackCache != null) {
            return callbackCache
        }
    	//不存在就去 找到 kClass对应的AdapterClass 应该是什么type
        val type = resolveObserverCallbackType(klass)
    	//存入缓存数组 下次不用再去反射获取
        this.callbackCache[klass] = type
        return type
}

    /**
     * 尝试获取生成的适配器构造器
     * 类名生成规则:原始类名 + "_LifecycleAdapter"
     * 示例:com.example.MyObserver -> com.example.MyObserver_LifecycleAdapter
     */
    private fun generatedConstructor(klass: Class<*>): Constructor<out GeneratedAdapter>? {
        return try {
            // 构造全限定类名
            val packageName = klass.`package`?.name ?: ""
            // 匿名类返回null
            val className = klass.canonicalName ?: return null

            // 处理包名和类名的分割逻辑
            val simpleName = if (packageName.isEmpty()) {
                className
            } else {
                className.substring(packageName.length + 1) // +1 跳过包名后的点
            }

            // 生成适配器类名
            // 示例:原始类名 + "_LifecycleAdapter"
            val adapterName =
                getAdapterName(
                    if (fullPackage.isEmpty()) name
                    else name.substring(fullPackage.length + 1)
            )

            // 通过类名反射,得到Adapter的Class对象
            @Suppress("UNCHECKED_CAST")
            val aClass = Class.forName(
                if (fullPackage.isEmpty()) adapterName else "$fullPackage.$adapterName"
            ) as Class<out GeneratedAdapter>

            // compiler生成的 AdapterClass 需要传入kclass(ObserverClass),才能辅助回调
            // 获取AdapterClass的构造器(构造器的参数类型为ObserverClass)
            val constructor = aClass.getDeclaredConstructor(klass)

            // 突破Java访问限制
            if (!constructor.isAccessible) {
                constructor.isAccessible = true
            }
            //返回目标构造器
            constructor
        } catch (e: ClassNotFoundException) {
            null // 预期中的情况,表示没有生成适配器类
        } catch (e: NoSuchMethodException) {
            throw RuntimeException("生成的适配器类缺少必要构造器", e)
        }
    }

/**
* 类型解析核心逻辑(多层级检查)
* 解析顺序:
* 1. 匿名类直接使用反射
* 2. 检查是否有生成适配器
* 3. 检查是否有反射注解方法
* 4. 递归检查父类和接口
*/
private fun resolveObserverCallbackType(klass: Class<*>): Int {
    	//匿名类直接使用反射
        if (klass.canonicalName == null) {
            return REFLECTIVE_CALLBACK
        }
    	//获取 klass(ObserverClass) 对应的 adapterClass 的构造器
        val constructor = generatedConstructor(klass)
    	//告诉应该 AdapterClass 应该是GENERATED_CALLBACK type
        if (constructor != null) {
            classToAdapters[klass] = listOf(constructor)
            return GENERATED_CALLBACK
        }

    	//如果constructor 为空 (AdapterClass 不是GENERATED_CALLBACK type)
    	//那么试试检查反射注解方法(@OnLifecycleEvent)
        @Suppress("DEPRECATION")
        val hasLifecycleMethods = ClassesInfoCache.sInstance.hasLifecycleMethods(klass)
    	//有注释,那么就用反射方法
        if (hasLifecycleMethods) {
            return REFLECTIVE_CALLBACK
        }
    	//如果以上都没 递归检查父类和接口,看看是否它的父类或者是实现的接口 是知道对应的type的
        val superclass = klass.superclass
        var adapterConstructors: MutableList<Constructor<out GeneratedAdapter>>? = null
        if (isLifecycleParent(superclass)) {
            if (getObserverConstructorType(superclass) == REFLECTIVE_CALLBACK) {
                return REFLECTIVE_CALLBACK
            }
            adapterConstructors = ArrayList(
                classToAdapters[superclass]!!
            )
        }
        for (intrface in klass.interfaces) {
            if (!isLifecycleParent(intrface)) {
                continue
            }
            if (getObserverConstructorType(intrface) == REFLECTIVE_CALLBACK) {
                return REFLECTIVE_CALLBACK
            }
            if (adapterConstructors == null) {
                adapterConstructors = ArrayList()
            }
            adapterConstructors.addAll(classToAdapters[intrface]!!)
        }
        if (adapterConstructors != null) {
            classToAdapters[klass] = adapterConstructors
            return GENERATED_CALLBACK
        }
    	//都没有,选择反射方案
        return REFLECTIVE_CALLBACK
}

/**
 * 在需要确定一个类是否使用@OnLifecycleEvent注解方法时调用,
 * 用于决定是否使用反射方式处理生命周期事件
 *
 * 1. 避免重复扫描类的方法列表(性能关键)
 * 2. 快速判断是否需要反射处理
 * 3. 预初始化反射信息提升后续处理速度
 *
 */
boolean hasLifecycleMethods(Class klass) {
    //检查缓存,看看之前是否判断过这个klass的结果
    if (mHasLifecycleMethods.containsKey(klass)) {
        return mHasLifecycleMethods.get(klass);
    }

    // 通过反射扫描方法
    // getDeclaredMethods()返回类直接声明的所有方法(含私有,不包括继承方法)
    Method[] methods = getDeclaredMethods(klass);

    // 注解检测循环
    // 寻找至少一个@OnLifecycleEvent注解方法
    for (Method method : methods) {
        // 通过反射API获取方法注解
        // getAnnotation()是运行时注解解析的核心方法
        OnLifecycleEvent annotation = method.getAnnotation(OnLifecycleEvent.class);

        if (annotation != null) {
            // createInfo提前初始化,实现性能优化,因为后续必然会使用ReflectiveGenericLifecycleObserver
            // 主动创建反射信息缓存,将耗时的反射操作前移
            // 注意:createInfo内部会填充mHasLifecycleMethods,节约下次判断时间
            createInfo(klass, methods);

            // 避免后续重复扫描,直接返回true
            return true;
        }
    }

    // 无注解处理
    // 确认类中没有生命周期注解方法,将结果写入缓存避免重复扫描
    mHasLifecycleMethods.put(klass, false);

    // 结果:后续调用可直接从缓存获取false
    return false;
}

/**
 * 当检测到类包含@OnLifecycleEvent注解方法时,需要构建完整的回调信息:
 * 聚合处理继承体系(父类+接口)中的生命周期方法
 * 验证方法签名合法性
 * 解析当前类的注解方法
 * 缓存优化后续调用性能
 */
//CallbackInfo收集使用了OnLifecycleEvent注解进行注释的方法
private CallbackInfo createInfo(Class klass, @Nullable Method[] declaredMethods) {
    // 需要合并父类的生命周期处理方法
    Class superclass = klass.getSuperclass();
    Map<MethodReference, Lifecycle.Event> handlerToEvent = new HashMap<>();

    // 递归获取父类信息(体现继承特性)
    if (superclass != null) {
        CallbackInfo superInfo = getInfo(superclass);
        if (superInfo != null) {
            // 合并父类处理方法(子类可覆盖父类方法)
            handlerToEvent.putAll(superInfo.mHandlerToEvent);
        }
    }

    // 合并接口定义的生命周期方法
    Class[] interfaces = klass.getInterfaces();
    for (Class intrfc : interfaces) {
        // 递归处理每个接口(支持多接口继承)
        for (Map.Entry<MethodReference, Lifecycle.Event> entry : getInfo(intrfc).mHandlerToEvent.entrySet()) {
            // 接口方法不能覆盖类方法(通过verifyAndPutHandler校验)
            verifyAndPutHandler(handlerToEvent, entry.getKey(), entry.getValue(), klass);
        }
    }

    // 避免重复获取方法列表
    Method[] methods = declaredMethods != null ? declaredMethods : getDeclaredMethods(klass);
    boolean hasLifecycleMethods = false;

    for (Method method : methods) {
        // 筛选OnLifecycleEvent注解的方法
        OnLifecycleEvent annotation = method.getAnnotation(OnLifecycleEvent.class);
        if (annotation == null) continue;

        hasLifecycleMethods = true;


		//参数验证
        Class<?>[] params = method.getParameterTypes();
        int callType = CALL_TYPE_NO_ARG;

        // 根据参数类型确定调用方式
        if (params.length > 0) {
            // 强制校验第一个参数必须是LifecycleOwner(编译期无法检查,需运行时保证)
            if (!params[0].isAssignableFrom(LifecycleOwner.class)) {
                throw new IllegalArgumentException("第一个参数必须兼容LifecycleOwner");
            }
            callType = CALL_TYPE_PROVIDER;
        }

        // 任务:处理带事件类型的特殊参数
        Lifecycle.Event event = annotation.value();
        if (params.length > 1) {
            if (event != Lifecycle.Event.ON_ANY) {
                throw new IllegalArgumentException("双参数方法只支持ON_ANY事件");
            }
            if (!params[1].isAssignableFrom(Lifecycle.Event.class)) {
                throw new IllegalArgumentException("第二个参数必须是Lifecycle.Event");
            }
            callType = CALL_TYPE_PROVIDER_WITH_EVENT;
        }

        // 强制约束参数数量(设计决策:最多两个参数)
        if (params.length > 2) {
            throw new IllegalArgumentException("最多允许两个参数");
        }

        //构建方法引用
        MethodReference methodRef = new MethodReference(callType, method);
        verifyAndPutHandler(handlerToEvent, methodRef, event, klass);
    }

    // 缓存处理结果
    CallbackInfo info = new CallbackInfo(handlerToEvent);
    mCallbackMap.put(klass, info);          // 缓存完整回调信息
    mHasLifecycleMethods.put(klass, hasLifecycleMethods); // 缓存注解存在标记

    return info;
}

/**
 * 验证并注册生命周期方法的核心校验方法
 *
 * - 当收集来自父类/接口/当前类的生命周期方法时
 * - 需要确保相同方法签名(方法名+参数类型)的事件处理不冲突
 *
 * 检测方法签名冲突,实现子类方法覆盖父类的逻辑
 *
 *
 * [覆盖机制]
 *
 * 执行顺序:
 * 1. 先添加父类方法(putAll)
 * 2. 再添加接口方法(循环verifyAndPutHandler)
 * 3. 最后处理当前类方法(通过verifyAndPutHandler添加)
 *
 * 覆盖逻辑本质:
 * 由于当前类的方法处理在后,当出现方法签名冲突时:
 * - 通过verifyAndPutHandler检测到已有条目(来自父类/接口)
 * - 若事件类型相同:等效覆盖
 * - 若事件类型不同:抛出异常
 *
 */
private void verifyAndPutHandler(
    Map<MethodReference, Lifecycle.Event> handlers,
    MethodReference newHandler,
    Lifecycle.Event newEvent,
    Class<?> klass
) {
    // 存在性检查:查找是否已有相同方法签名(注意MethodReference的equals、hashcode实现)
    Lifecycle.Event existingEvent = handlers.get(newHandler);

    if (existingEvent != null && newEvent != existingEvent) {
        // 冲突处理:相同方法名+参数类型但不同事件类型
        Method method = newHandler.mMethod;
        throw new IllegalArgumentException(
            "方法冲突: " + method.getName() + " in " + klass.getName() + "\n" +
            "已存在事件类型: " + existingEvent + "\n" +
            "新定义事件类型: " + newEvent
        );
    } else if (existingEvent == null) {
        // 无冲突时注册新方法(子类方法在此覆盖父类)
        handlers.put(newHandler, newEvent);
    }
    // existingEvent == newEvent时不做操作(允许重复定义相同事件)
}


/**
 * 方法引用包装类(关键反射调用逻辑)
 *
 * 需要统一处理不同参数类型的生命周期方法调用:
 */
@SuppressWarnings("WeakerAccess")
static class MethodReference {
    final int mCallType; // 调用类型标识
    final Method mMethod; // 反射方法对象

    MethodReference(int callType, Method method) {
        mCallType = callType;
        mMethod = method;
        mMethod.setAccessible(true); // 突破访问限制关键操作
    }

    //ReflectiveGenericLifecycleObserver调用反射方法的实际触发点
    /**
     * 执行反射调用的核心方法
     *
     * 当生命周期事件触发时需要动态调用观察者方法,处理不同参数类型的统一调用
     * 将事件正确传递到观察者方法
     */
    void invokeCallback(LifecycleOwner source, Lifecycle.Event event, Object target) {
        try {
            switch (mCallType) {
                case CALL_TYPE_NO_ARG:
                    mMethod.invoke(target); // 无参调用
                    break;
                case CALL_TYPE_PROVIDER:
                    mMethod.invoke(target, source); // 带LifecycleOwner调用
                    break;
                case CALL_TYPE_PROVIDER_WITH_EVENT:
                    mMethod.invoke(target, source, event); // 带带LifecycleOwner、Event调用
                    break;
            }
        } catch (InvocationTargetException e) {
            throw new RuntimeException("方法调用异常", e.getCause());
        } catch (IllegalAccessException e) {
            throw new RuntimeException(e);
        }
    }

    public boolean equals(Object o) {
            if (this == o) {
                return true;
            } else if (!(o instanceof MethodReference)) {
                return false;
            } else {
                MethodReference that = (MethodReference)o;
                return this.mCallType == that.mCallType && this.mMethod.getName().equals(that.mMethod.getName());
            }
    }

    public int hashCode() {
            return 31 * this.mCallType + this.mMethod.getName().hashCode();
    }
}
旧的Fragment 与 新的Fragment 在 FragmentActivity(AppCompatActivity)有什么不同表现?是如何影响Lifecycle机制的?
旧的Fragment:android.app.Fragment
新的Fragment:androidx.fragment.app.Fragment
使用以下的代码进行断点调试。
override fun onCreate(savedInstanceState: Bundle?) {

        super.onCreate(savedInstanceState)

        val manager = fragmentManager
        if (manager.findFragmentByTag("XXX") == null) {
            manager.beginTransaction().add(TestFragment(), "XXX").commit()
            // Hopefully, we are the first to make a transaction.
            manager.executePendingTransactions()
        }
        val manager2 = supportFragmentManager
        manager2.beginTransaction().add(TestFragment2(), "XX").commitNow();

    }

    override fun onStart() {
        super.onStart()
    }


    override fun onResume() {
        super.onResume()
    }

    override fun onPause() {
        super.onPause()
    }

    override fun onStop() {
        super.onStop()
    }

    override fun onDestroy() {
        super.onDestroy()
    }

    @SuppressLint("ValidFragment")
    internal class TestFragment(): android.app.Fragment() {
        override fun onActivityCreated(savedInstanceState: Bundle?) {
            super.onActivityCreated(savedInstanceState)
        }

        override fun onStart() {
            super.onStart()
        }

        override fun onResume() {
            super.onResume()
        }

        override fun onPause() {
            super.onPause()
        }

        override fun onStop() {
            super.onStop()
        }

        override fun onDestroy() {
            super.onDestroy()
        }
    }

    @SuppressLint("ValidFragment")
    internal class TestFragment2(): Fragment() {
        override fun onCreateView(
            inflater: LayoutInflater,
            container: ViewGroup?,
            savedInstanceState: Bundle?
        ): View? {
            return super.onCreateView(inflater, container, savedInstanceState)
        }

        override fun onCreate(savedInstanceState: Bundle?) {
            super.onCreate(savedInstanceState)
        }

        override fun onStart() {
            super.onStart()
        }

        override fun onResume() {
            super.onResume()
        }

        override fun onPause() {
            super.onPause()
        }

        override fun onStop() {
            super.onStop()
        }

        override fun onDestroy() {
            super.onDestroy()
        }
    }
最后的结果是
Activity的 onCreate、onStart、onResume 均先于 新、旧Fragment。
Activity的 onPause、onStop、onDestroy有所不同:
旧Fragment的 onPause、onStop、onDestroy 都先于 Activity。
新Fragment的 onPause、onStop、onDestroy 都晚于 Activity。
Why?究竟是什么导致了这样的现象?
public interface DefaultLifecycleObserver : LifecycleObserver {
    //This method will be called after the [LifecycleOwner]'s `onCreate method returns.
    public fun onCreate(owner: LifecycleOwner) {}
    //after
    public fun onStart(owner: LifecycleOwner) {}
    //after
    public fun onResume(owner: LifecycleOwner) {}

    //This method will be called before the [LifecycleOwner]'s `onPause` method is called.
    public fun onPause(owner: LifecycleOwner) {}
    //before
    public fun onStop(owner: LifecycleOwner) {}
    //before
    public fun onDestroy(owner: LifecycleOwner) {}
}

//FragmentActivity#onPause
@Override
protected void onPause() {
    //先super.onPause
    super.onPause();
    mResumed = false;
    //再mFragments.dispatchPause()
    //我们可以发现,在FragmentActivity#onPause中,是先Activity#onPause回调,才到AndroidX.Fragment#onPause回调
    mFragments.dispatchPause();
    //此mFragments是管理AndroidX Fragment的Controller,与Activity#mFragments不同
   	//mFragmentLifecycleRegistry负责协调处理 Fragment 作为宿主时的嵌套生命周期(如 ChildFragmentManager 中 Fragment 的生命周期需依赖宿主 Fragment 或 Activity 的状态)
mFragmentLifecycleRegistry.handleLifecycleEvent(Lifecycle.Event.ON_PAUSE);
}


//Activity#performPause
final void performPause() {
		//...
    	//Pre
        dispatchActivityPrePaused();
    	//此final FragmentController mFragments = FragmentController.createController(new HostCallbacks());
    	//非FragmentActivity中的mFragments,而是管理Android.app.Fragment的Controller
    	//所以performPause时,dispatchPause()在前,onPause()在后
    	//自然是Fragment先onPause,再是Activity#onPause回调
    	//对于performCreate自然也类似,只不过dispatchCreate在onCreate后罢了
    	//那么ReportFragment就合法实现了 DefaultLifecycleObserver的要求
        mFragments.dispatchPause();
        mCalled = false;
    	//Activity#onPause回调
        onPause();
        //...
    	//Post 支持AndroidX的事件分发
        dispatchActivityPostPaused();
		//...
}

//Android.app.Fragment
//也就是ReportFragment
void performPause() {
        if (mChildFragmentManager != null) {
            mChildFragmentManager.dispatchPause();
        }
        mState = STARTED;
        mCalled = false;
    	//执行Fragment的回调
    	//注意这里没有 handleLifecycleEvent,也就是Android.app.Fragment分发生命周期状态是通过ReportFragment中的代码实现的
        onPause();
        //...
}
读完源码后,可以发现在AndroidX 前后的Fragment生命周期,与Activity的生命周期之间的顺序是不一样的。旧Fragment的 onPause的确是先于 Activity,新Fragment的 onPause是晚于 Activity的。
那么问题来了?在Android X后,XFrgament的onPause是晚于 Activity的,那么究竟是如何做到DefaultLifecycleObserver的要求,也就是:先有Fragment#onPause的触发,才到LifecycleOwner的onPause的触发。
实际上!这就是在AndroidX 以后,不会使用AndroidX Fragment作为“ReportFragment”的原因。
Android X 以后实现Owener、Observer之间生命周期事件顺序分发的方法:
通过 activity.registerActivityLifecycleCallbacks(LifecycleCallbacks) 注册后,该回调会绑定到Activity 的生命周期事件上。
Application内部维护了一个mActivityLifecycleCallbacks列表,当Activity的生命周期事件发生时,会遍历这个列表并调用对应的回调方法。每当任何 Activity 的生命周期状态发生变化时,系统会自动调用对应的回调方法。
    @RequiresApi(29)
    internal class LifecycleCallbacks : Application.ActivityLifecycleCallbacks {
        override fun onActivityCreated(
            activity: Activity,
            bundle: Bundle?
        ) {}

        override fun onActivityPostCreated(
            activity: Activity,
            savedInstanceState: Bundle?
        ) {
            dispatch(activity, Lifecycle.Event.ON_CREATE)
        }

        override fun onActivityStarted(activity: Activity) {}

        override fun onActivityPostStarted(activity: Activity) {
            dispatch(activity, Lifecycle.Event.ON_START)
        }

        override fun onActivityResumed(activity: Activity) {}

        override fun onActivityPostResumed(activity: Activity) {
            dispatch(activity, Lifecycle.Event.ON_RESUME)
        }

        override fun onActivityPrePaused(activity: Activity) {
            dispatch(activity, Lifecycle.Event.ON_PAUSE)
        }

        override fun onActivityPaused(activity: Activity) {}

        override fun onActivityPreStopped(activity: Activity) {
            dispatch(activity, Lifecycle.Event.ON_STOP)
        }

        override fun onActivityStopped(activity: Activity) {}

        override fun onActivitySaveInstanceState(
            activity: Activity,
            bundle: Bundle
        ) {}

        override fun onActivityPreDestroyed(activity: Activity) {
            dispatch(activity, Lifecycle.Event.ON_DESTROY)
        }

        override fun onActivityDestroyed(activity: Activity) {}

        companion object {
            @JvmStatic
            fun registerIn(activity: Activity) {
                activity.registerActivityLifecycleCallbacks(LifecycleCallbacks())
            }
        }
    }
ProcessLifecycleOwner
为整个应用程序流程提供生命周期的类。
实际上是通过对活跃的Activity进行计数来分发事件的。
是通过ContentProvider来初始化的。
public class ProcessLifecycleOwnerInitializer extends ContentProvider {
    @Override
    public boolean onCreate() {
        LifecycleDispatcher.init(getContext());
        ProcessLifecycleOwner.init(getContext());
        return true;
    }
    ...
}

static void init(Context context) {
        sInstance.attach(context);
}

private ActivityInitializationListener mInitializationListener =
            new ActivityInitializationListener() {
                @Override
                public void onCreate() {
                }
                @Override
                public void onStart() {
                    activityStarted();
                }
                @Override
                public void onResume() {
                    activityResumed();
                }
};

//初始化实际上是调用了attach
void attach(Context context) {
        mHandler = new Handler();
    	//因为 ProcessLifecycleOwner 是针对于对整个应用的生命周期的监听
    	//会执行到这一步的话说明应用肯定被启动了,此时就到了 Lifecycle.Event.ON_CREATE
    	//且由于 attach 方法只会被调用一次,所以外部也只会收到一次 Lifecycle.Event.ON_CREATE 事件
        mRegistry.handleLifecycleEvent(Lifecycle.Event.ON_CREATE);
        Application app = (Application) context.getApplicationContext();
    	//注意:这里为什么要分两个回调?
    	//registerActivityLifecycleCallbacks 是对于全局Activity的
    	//ReportFragment#mInitializationListener 只是针对单个Activity的

    	//onPause 和 onStop 需要等待所有 Activity 退出前台,直接通过 ActivityLifecycleCallbacks 监听并配合计数器,可以高效判断何时分派 ON_PAUSE 和 ON_STOP,如果使用ReportFragment#mInitializationListener 在Activity Destroy时,如果进行延时判断容易出错,
    	//同时ReportFragment的onPause 和 onStop,都会先于 Activity。

    	//activityStarted()、activityResumed() 用ReportFragment#mInitializationListener 可以保证 Fragment 的 onStart()/onResume() 与 Activity 的实际可见状态严格同步。
    	//而某些系统或厂商定制 ROM 中,ActivityLifecycleCallbacks 的回调时序可能不稳定。
        app.registerActivityLifecycleCallbacks(new EmptyActivityLifecycleCallbacks() {
            @Override
            public void onActivityCreated(Activity activity, Bundle savedInstanceState) {
			//对每个 Activity的 ReportFragment 设置回调事件
            ReportFragment.get(activity).setProcessListener(mInitializationListener);
            }
            @Override
            public void onActivityPaused(Activity activity) {
                activityPaused();
            }
            @Override
            public void onActivityStopped(Activity activity) {
                activityStopped();
            }
        });
    }
onCreate只会发送一次,onDestory不会发送。
{@link Lifecycle.EventON_CREATE} will be dispatched once and {@link Lifecycle.EventON_DESTROY} will never be dispatched.
当第一个Activity触发ON_START/ON_RESUME时,立即分发对应事件。
当最后一个Activity触发ON_PAUSE/ON_STOP时,延迟700ms分发对应事件(防止配置变化误触发)。
ProcessLifecycleOwner will dispatch {@link Lifecycle.Event#ON_START},
{@link Lifecycle.Event#ON_RESUME} events, as a first activity moves through these events.
{@link Lifecycle.Event#ON_PAUSE}, {@link Lifecycle.Event#ON_STOP}, events will be dispatched with a delay after a last activity
对于您希望对应用程序进入前台或进入后台做出反应,并且您在接收生命周期事件时不需要毫秒级精度的使用案例,它非常有用。
It is useful for use cases where you would like to react on your app coming to the foreground or going to the background and you don't need a milliseconds accuracy in receiving lifecycle events.
ProcessLifecycleOwner 内部有多个变量辅助状态变化的判断。
    // 状态计数器
    private int mStartedCounter = 0;  // 处于STARTED状态的Activity计数
    private int mResumedCounter = 0;  // 处于RESUMED状态的Activity计数

    // 状态标记
    private boolean mPauseSent = true;   // 是否已发送PAUSE事件
    private boolean mStopSent = true;    // 是否已发送STOP事件
主要关注Resume、Pause状态的分发。
    // 延迟时间,用于防止配置变化(如旋转屏幕)导致的误判
    @VisibleForTesting
    static final long TIMEOUT_MS = 700; // 700毫秒,足够覆盖配置变化的时间

    private Handler mHandler;  // 用于延迟任务处理

    // 延迟执行的Runnable,用于处理PAUSE和STOP事件的分发
    private Runnable mDelayedPauseRunnable = new Runnable() {
        @Override
        public void run() {
            dispatchPauseIfNeeded();  // 检查是否需要分发PAUSE
            dispatchStopIfNeeded();   // 检查是否需要分发STOP
        }
    };

    // Activity恢复时的处理
    void activityResumed() {
        mResumedCounter++;
        if (mResumedCounter == 1) {
            if (mPauseSent) {
                // 如果之前已发送PAUSE,立即分发RESUME事件
                mRegistry.handleLifecycleEvent(Lifecycle.Event.ON_RESUME);
                mPauseSent = false;
            } else {
                // 取消延迟的发送PAUSE任务(旋转屏幕后快速恢复了,在700ms内,那么没必要去check,浪费资源)
                mHandler.removeCallbacks(mDelayedPauseRunnable);
            }
        }
    }

    // Activity暂停时的处理,启动延迟检查,不着急发放PAUSED 状态
    void activityPaused() {
        mResumedCounter--;
        // 当最后一个Activity暂停时,启动延迟检查 (是否是旋转屏幕)
        if (mResumedCounter == 0) {
            mHandler.postDelayed(mDelayedPauseRunnable, TIMEOUT_MS);
        }
    }


    // 检查并分发PAUSE事件
    private void dispatchPauseIfNeeded() {
        // 没有一个Activity Resumed
        if (mResumedCounter == 0) {
            mPauseSent = true;
            mRegistry.handleLifecycleEvent(Lifecycle.Event.ON_PAUSE);
        }
    }

    // 检查并分发STOP事件
    private void dispatchStopIfNeeded() {
        // 当所有Activity都停止且已发送PAUSE(dispatchPauseIfNeeded方法)时
        if (mStartedCounter == 0 && mPauseSent) {
            mRegistry.handleLifecycleEvent(Lifecycle.Event.ON_STOP);
            mStopSent = true;
        }
    }
参考
https://juejin.cn/post/6844904061519544334
https://blog.csdn.net/Beatles_The/article/details/114157480
https://github.com/leavesCZY/AndroidGuide/blob/master/
https://juejin.cn/post/7288540124225470516
- Pre
- 发现问题
- 解决思路
- 解决方案
- 注意
- 为什么Lifecycle可以感知到Activity生命周期?
- 为什么注释@OnLifecycleEvent会被Lifecycle弃用
- 为什么State设计成五个,Event设计成七个?为什么设计成两个类,而不是只用State描述?
- 为什么Event可以简化State?
- addObserverCounter有什么用?
- 为什么addObserver中while同步后,还需要sync同步?
- 为什么要保证状态正确(Observer的有序性)?
- FastSafeIterableMap数据结构
- ObserverWithState的作用
- Observer的有序性 与 observerMap的 不变性
- parentStates的作用
- 有哪些不同的观察者类型?
- ProcessLifecycleOwner
- 参考