
HashMap番外篇——SafeIterableMap 重点
Pre
作为HashMap的Extra篇。
SafeIterableMap是作为一个偏工具的数据结构,所以是以阅读源码为主,而不像框架一样,主要的是学习其架构思路和设计哲学。
对于SafeIterableMap,很容易“以貌取人”,实际上SafeIterableMap并没有实现Map接口,而是实现了Iterable接口。所以实际上来看,SafeIterableMap是一个链表。
public class FastSafeIterableMap<K, V> extends SafeIterableMap<K, V> {

    ......
}


//SafeIterableMap实现了Iterable接口
public class SafeIterableMap<K, V> implements Iterable<Map.Entry<K, V>> {

    ......
}
特性
-
支持键值对存储,用链表实现,不过伪装成Map。
-
支持在遍历的过程中编辑集合,不会抛出ConcurrentModifiedException。(只能调用map的put 或者 remove方法实现编辑,而不是调用Iterator的remove方法,Iterator的remove方法默认实现是抛出 UnsupportedOperationException)
default void remove() { throw new UnsupportedOperationException("remove"); } -
非线程安全。
LinkedList, which pretends to be a map and supports modifications during iterations. It is NOT thread safe.
Type parameters:
– Key type
– Value type
源码
非常清晰明了的结构图。
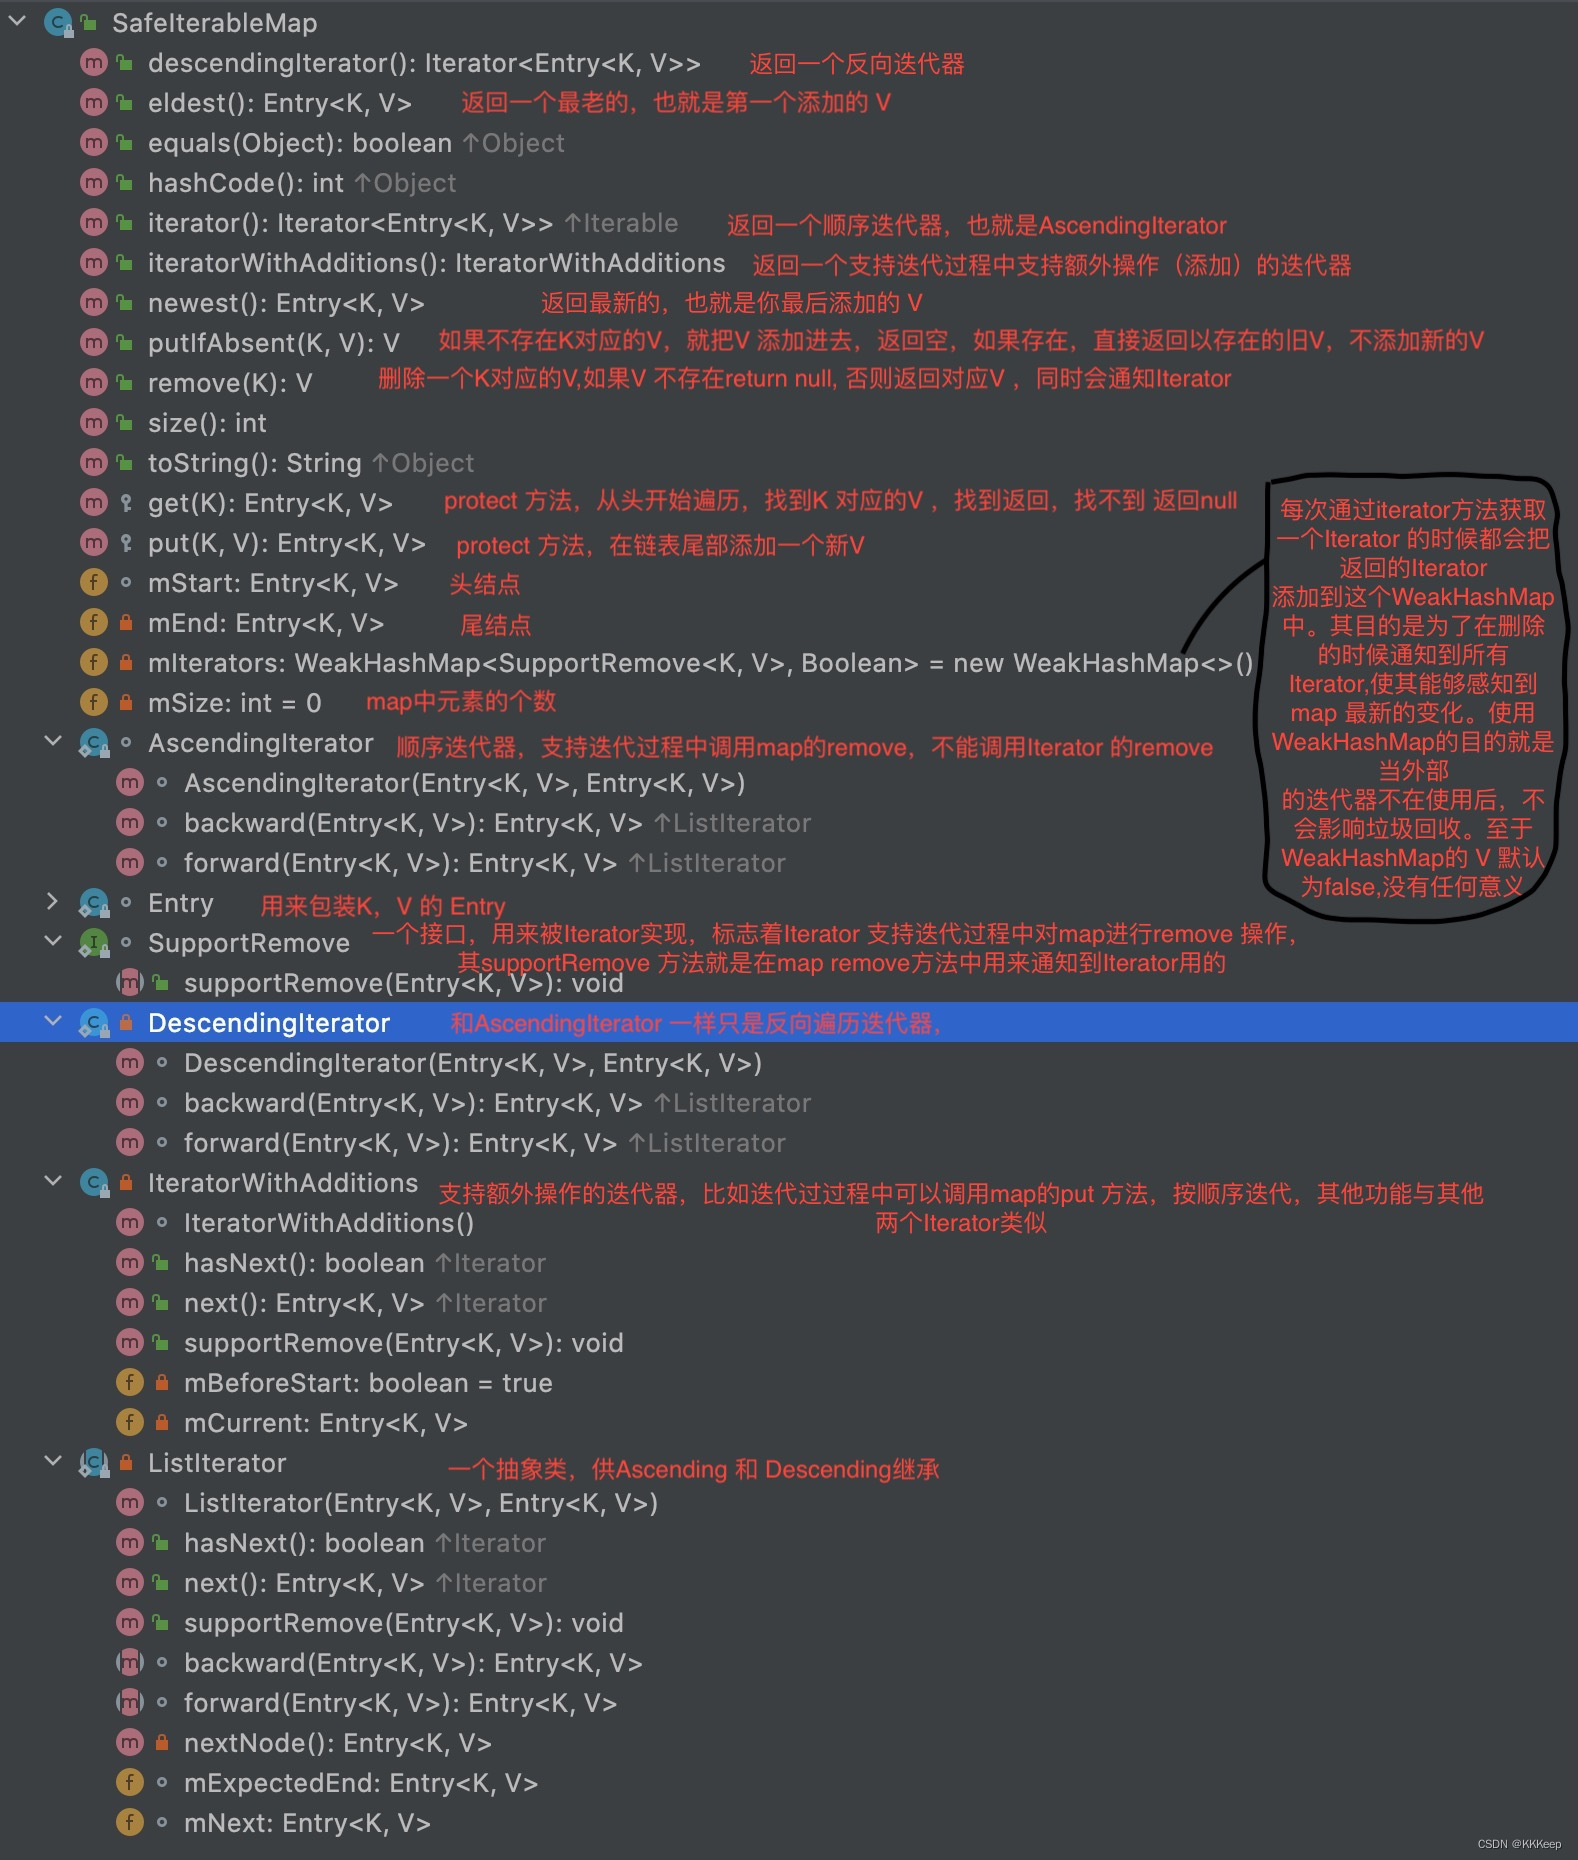
图自 https://blog.csdn.net/Just_keep/article/details/129755102
基础属性
SafeIterableMap类中的属性还是比较少的。
public class SafeIterableMap<K, V> implements Iterable<Map.Entry<K, V>> {
    Entry<K, V> mStart; //头节点
    private Entry<K, V> mEnd; //尾节点 注意这里可以把头节点理解为dummy节点,尾节点理解为游标,详细看put方法
    //在这里使用 WeakHashMap 而不是 List<WeakReference>,是因为可以不必手动删除包含 null 的 WeakReferences,这是可以学习的Trick。
    //这个属性是算是SIM的关键属性。
    //详细见后文——————为什么SafeIterableMap支持迭代中修改#SafeIterableMap#remove
    private final WeakHashMap<SupportRemove<K, V>, Boolean> mIterators = new WeakHashMap<>(); //与迭代器有关,注意这里的Boolean没有什么用,put时都是false,WeakHashMap 可以帮助清理掉key已经被回收的entry
    private int mSize = 0; // 当前集合中的元素个数
    ...
}
关键的数据结构
static class Entry<K, V> implements Map.Entry<K, V> {
        final K mKey; //自己的key
        final V mValue; //自己的value
        Entry<K, V> mNext; //指向下一个元素的指针
        Entry<K, V> mPrevious; //指向上一个的指针
		...
        @Override
        public V setValue(V value) {
            //只能通过构造函数传入
            throw new UnsupportedOperationException("An entry modification is not supported");
        }
        ....
    }
配合链表使用的话,数据结构实际上长这样。
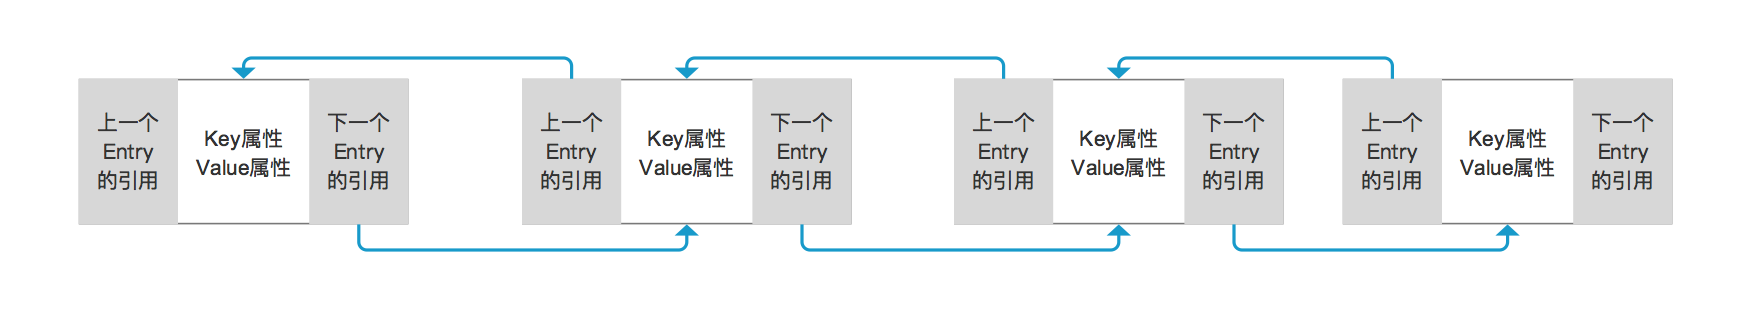
图自 https://juejin.cn/post/6844904061519544334
主要还是put、get方法的实现
put方法
//putIfAbsent方法 关键
public V putIfAbsent(@NonNull K key, @NonNull V v) {
        //检查之前对应的key是否存在
        Entry<K, V> entry = get(key);
        if (entry != null) {
            //存在就不put了,直接返回,不会覆盖原来的值,只是把之前存入的值返回
            return entry.mValue;
        }
    	//否则put,见下面
        put(key, v);
        return null;
}

protected Entry<K, V> put(@NonNull K key, @NonNull V v) {
    	//走到这,说明key必然不存在
        Entry<K, V> newEntry = new Entry<>(key, v);
        //链表长度增加
        mSize++;
    	//尾节点为空,其实头节点为空也同理,说明是第一次put
        if (mEnd == null) {
            //假如是第一次put,则设置新的节点作为mStart头节点,尾节点mEnd也指向新的节点(头节点)
            mStart = newEntry;
            mEnd = mStart;
            return newEntry;
        }
        //不是第一次put,尾插法
    	//把mStart当成dummy节点,mEnd当成游标
    	//则把mEnd的next指向newEntry,newEntry的previous指向之前的mEnd,mEnd移动指向newEntry,后续的添加就是依照上面,但是有着pre的属性,变成双向链表。
        //从这里我们知道mEnd和mStarr的mPrevious,始终为null
        mEnd.mNext = newEntry;
        newEntry.mPrevious = mEnd;
        mEnd = newEntry;
        return newEntry;
    }
get方法
protected Entry<K, V> get(K k) {
       Entry<K, V> currentNode = mStart;
       //链表的遍历
       //从mStart开始遍历
       while (currentNode != null) {
           if (currentNode.mKey.equals(k)) {
               //找到则返回
               break;
           }
           //否则继续
           currentNode = currentNode.mNext;
       }
       //没有找到返回mStart头部
       return currentNode;
   }
为什么SafeIterableMap支持迭代中修改?
SafeIterableMap 支持迭代过程中支持修改操作,是因为 自定义的Iterator 支持了。
SafeIterableMap 一共有三个 Iterator 实现类:
AscendingIterator (顺序迭代,不包括在迭代期间添加的新元素)
DescendingIterator (逆序迭代,不包括在迭代期间添加的新元素)
IteratorWithAdditions(顺序迭代,包括在迭代期间添加的新元素)
也就是说,
如果使用AscendingIterator /DescendingIterator 进行迭代,那么是无法遍历到在迭代期间添加的新元素的,调用map的put 或者 remove方法实现编辑是不会抛出ConcurrentModificationException,但是如果使用Iterator进行remove还是会抛出UnsupportedOperationException。
如果使用IteratorWithAdditions进行迭代,是可以遍历到在迭代期间添加的新元素的,后续同理。
原理
从源码开始。
SupportRemove && ListIterator
//SupportRemove 很简单
public abstract static class SupportRemove<K, V> {
        abstract void supportRemove(@NonNull Entry<K, V> entry);
}

private abstract static class ListIterator<K, V> extends SupportRemove<K, V>
            implements Iterator<Map.Entry<K, V>> {
    	//注意继承了SupportRemove<K, V>
    	//预期结束节点
        Entry<K, V> mExpectedEnd;
        Entry<K, V> mNext;
        ListIterator(Entry<K, V> start, Entry<K, V> expectedEnd) {
            this.mExpectedEnd = expectedEnd;
            this.mNext = start;
        }
        @Override
        public boolean hasNext() {
            //不存在mNext则遍历完成
            return mNext != null;
        }
        @SuppressWarnings("ReferenceEquality")
        @Override
    	//注意这里并不是实际的删除方法,SafeIterableMap#remove才是实际的删除方法
    	//这里只是处理一些删除节点时的额外的逻辑,比如尾节点的指向变化、mNext这个游标指针的移动
        public void supportRemove(@NonNull Entry<K, V> entry) {
            //该方法由SafeIterableMap的remove触发
            //而不是由Iterator#remove触发 见后续的SafeIterableMap#remove方法
            //假如移除的entry是最后一个,同时是mNext
            if (mExpectedEnd == entry && entry == mNext) {
                //则把这两个清空
                mNext = null;
                mExpectedEnd = null;
            }
            //假如移除最后一个,则把mExpectedEnd指向他的前一个
            if (mExpectedEnd == entry) {
                mExpectedEnd = backward(mExpectedEnd);
            }
            //假如需要移除的是mNext,则把mNext指向下一个
            if (mNext == entry) {
                mNext = nextNode();
            }
        }
        @SuppressWarnings("ReferenceEquality")
        private Entry<K, V> nextNode() {
            //获取下一个节点,由next()调用
            //假如不存在了就不处理,否则返回他的下一个,这个方法不对mNext进行修改,而是由next方法修改
            //链表没有下一个了或者为空,那么返回null
            //否则 return forward(mNext) 指向下一个
            if (mNext == mExpectedEnd || mExpectedEnd == null) {
                return null;
            }
            return forward(mNext);
        }

    	//这才是Iterator调用的方法
        @Override
        public Map.Entry<K, V> next() {
            //mNext预先获取下一个
            Map.Entry<K, V> result = mNext;
            //校对mNext指针,这个方法对mNext进行修改
            mNext = nextNode();
            return result;
        }
        //下面两个由子类实现
        abstract Entry<K, V> forward(Entry<K, V> entry);
        abstract Entry<K, V> backward(Entry<K, V> entry);
    }
AscendingIterator && DescendingIterator
static class AscendingIterator<K, V> extends ListIterator<K, V> {
        //传入头部和尾部
        AscendingIterator(Entry<K, V> start, Entry<K, V> expectedEnd) {
            super(start, expectedEnd);
        }

//        DescendingIterator(Entry<K, V> start, Entry<K, V> expectedEnd) {
//           super(start, expectedEnd);
//        }

        @Override
        Entry<K, V> forward(Entry<K, V> entry) {
        	//前进,返回下一个节点
            return entry.mNext;

            //假如是DescendingIterator则返回上一个节点
            //return entry.mPrevious;
        }

        @Override
        Entry<K, V> backward(Entry<K, V> entry) {
            //后撤,返回上一个节点
            return entry.mPrevious;

            //假如是DescendingIterator则返回下一个节点
            //return entry.mNext;

        }
    }

    @NonNull
    @Override
    public Iterator<Map.Entry<K, V>> iterator() {
        ListIterator<K, V> iterator = new AscendingIterator<>(mStart, mEnd);
        //注意获取迭代器时,都迭代器都放入了mIterators,false是没有意义的stub。
        //为什么要往mIterators中放入迭代器,请看下文。
        mIterators.put(iterator, false);
        return iterator;
    }

    @NonNull
    public Iterator<Map.Entry<K, V>> descendingIterator() {
        DescendingIterator<K, V> iterator = new DescendingIterator<>(mEnd, mStart);
        //
        mIterators.put(iterator, false);
        return iterator;
    }

    @NonNull
    public IteratorWithAdditions iteratorWithAdditions() {
        IteratorWithAdditions iterator = new IteratorWithAdditions();
        //
        mIterators.put(iterator, false);
        return iterator;
    }
IteratorWithAdditions
private class IteratorWithAdditions implements Iterator<Map.Entry<K, V>> extends SupportRemove<K, V>   {
        //继承自SupportRemove,而非ListIterator
    	//所以IteratorWithAdditions,并非使用头、尾节点来实现链表的遍历
    	//只使用头节点配合mCurrent,从而实现即使动态添加节点,也能遍历到。
        //当前节点
        private Entry<K, V> mCurrent;
        //开始之前:控制是否为初始状态
    	//默认为true,用于控制从哪里开始迭代
        private boolean mBeforeStart = true;

        IteratorWithAdditions() {
        }

    	//首先要明白,iterator的一般执行顺序是 hasNext -> next -> (remove) -> hasNext

        @SuppressWarnings("ReferenceEquality")
        @Override
    	//注意:这里并不是实际的删除方法,SafeIterableMap#remove才是实际的删除方法
    	//这里只是处理一些删除节点时的额外的逻辑,从而确保删除后,能够正确的迭代。
        public void supportRemove(@NonNull Entry<K, V> entry) {
            if (entry == mCurrent) {
            	//假如移除的是当前的节点,将当前节点回退到前驱节点
            	mCurrent = mCurrent.mPrevious;

                //然后进行判断 mCurrent是否为null
                //null 说明移除的节点是头节点(只有头节点的Previous为空),为了确保不漏掉头节点,设置mBeforeStart为 true,这样才能不漏掉头节点(next方法中)
                //非null 说明移除的节点是中间的节点,搭桥操作在 后续的 SafeIterableMap#remove中完成了,能够指向移除节点的后继节点),由于链表的数据结构,能够正常迭代下去,设置为false
                mBeforeStart = mCurrent == null;
            }
        }

        @Override
        public boolean hasNext() {
            //是初始状态?是则判断头节点是否为null
            if (mBeforeStart) {
                //只有在执行前next(), 或者进行remove()后, 才会走这里

                //true 说明链表不为空
                //false 说明链表为空
                return mStart != null;
            }
            //不是初始状态
            //判断mCurrent以及mCurrent.mNext是否为null
            //为什么判断mCurrent != null?需要考虑空链表时,先调用next再调用hasNext
            //算是防御性编程
            //检查当前节点是否有后继节点
            return mCurrent != null && mCurrent.mNext != null;
        }

        @Override
        public Map.Entry<K, V> next() {
            //是初始状态?是则初始化mCurrent,返回头节点
            if (mBeforeStart) {
                mBeforeStart = false;
                //返回头节点
                mCurrent = mStart;
            } else {
                //不是初始状态,则返回 mCurrent.mNext
                //注意:如果没有mBeforeStart,就会漏过第一个节点
                //因为返回的是 mCurrent.mNext
                //为什么判断mCurrent != null?需要考虑空链表时,两次调用next
                mCurrent = mCurrent != null ? mCurrent.mNext : null;
            }
            return mCurrent;
        }
    }
SafeIterableMap#remove
SupportRemove方法就在这里被调用。
//从此映射中删除键的映射(如果存在)。
//Params: key – 要从 map 中删除其映射的键返回:与指定键关联的前一个值,如果键没有映射,则为 null。
public V remove(@NonNull K key) {
        //通过get方法的进行链表遍历
    	//寻找是否存在key,不存在则返回null
        Entry<K, V> toRemove = get(key);
        if (toRemove == null) {
            return null;
        }
        //存在,则先size--,链表大小变化
        mSize--;
    	//如果mIterators不为空,就“通知”mIterators内的 每一个 迭代器,把其中的key对应的Entry删除,使得每一个迭代器都能感知到这个操作,从而实现 支持删除 的功能。
        if (!mIterators.isEmpty()) {
            for (SupportRemove<K, V> iter : mIterators.keySet()) {
                iter.supportRemove(toRemove);
            }
        }
    	//比较经典的链表操作。其实我们可以想像是搭一座天桥、或者是对整列火车进行操作。
    	//删除其中一节火车,同时保证整列火车正常运行,就要让被删除的前一节,指向,被删除的后一节
        //前者不为null则把前者的next指向toRemove的next
        if (toRemove.mPrevious != null) {
            toRemove.mPrevious.mNext = toRemove.mNext;
        } else {
            mStart = toRemove.mNext;
        }
        //如果他的后者不为null,则把他的后者的mPrevious指向他的mPrevious
        if (toRemove.mNext != null) {
            toRemove.mNext.mPrevious = toRemove.mPrevious;
        } else {
            mEnd = toRemove.mPrevious;
        }
        //然后置空
    	//这里其实是比较容易忘记的!
        toRemove.mNext = null;
        toRemove.mPrevious = null;
        //返回值
        return toRemove.mValue;
    }
为什么 AI/DI 无法遍历迭代期间添加的新元素?
AscendingIterator 无法遍历迭代期间添加的新元素,原因在于其 固定的预期结束节点(mExpectedEnd) 【见上述ListIterator源码】
AscendingIterator 的设计限制
- 构造函数中传入
start(起始节点)和expectedEnd(预期结束节点)。 - 在
nextNode()方法中,当当前节点mNext等于mExpectedEnd时,返回null,终止遍历。 - 预期结束节点
mExpectedEnd在迭代过程中不会更新。
对比 IteratorWithAdditions的动态性
IteratorWithAdditions没有固定的结束节点,而是通过检查当前节点的mNext是否存在来决定是否继续遍历。- 如果在迭代期间添加新元素到链表尾部,
IteratorWithAdditions的hasNext()会发现新的mNext,从而继续遍历。
为什么其他集合(非并发集合)不支持迭代中修改?
因为集合内部有一个modCount变量记录修改次数。
每修改一次 modCount 都会+1,迭代集合时Iterator 在被创建出来时记录了集合当前的一个状态,比如集合的修改次数modCount ,集合的size等。
在调用Iterator方法进行迭代的时候会去判断Iterator 中记录的modCount 次数是否和集合中最新的modCount 是否相等。如果相等意味着集合没有发生修改,如果不相等意味着集合一定发生了修改,那么就会抛出ConcurrentModificationException。
这是一个设计上的决策,为了实现快速失败(fail-fast)机制,可以帮助开发者尽早发现并发修改的问题。
tips:比如,CopyOnWriteArrayList 这样的并发集合,在迭代时允许修改,因为它在修改时会创建底层数组的新副本,所以迭代器使用的是旧的数组快照,不会抛出异常。以及,Java 8的Stream API在处理集合时,如果在流操作过程中修改源集合,也可能导致不确定的行为或异常。因此,通常建议不要在流处理期间修改源集合。
引申 FastSafeIterableMap
在Lifecycle中出现,所以就此记录一下,其中的Fast是如何实现的。
代码非常短,所以就直接整个呈现上来了。
FastSafeIterableMap重写了get,putIfAbsent,remove方法。
而且使用的是HashMap去存储元素,类型是HashMap<K, Entry<K, V>>。
HashMap存储的是<K, Entry<K, V>>,Entry<K, V>是SIM中关键的数据结构(上文有解析),是包裹了一层的。
    private var observerMap = FastSafeIterableMap<LifecycleObserver, ObserverWithState>()

override fun addObserver(observer: LifecycleObserver) {
        enforceMainThreadIfNeeded("addObserver")
        val initialState = if (state == State.DESTROYED) State.DESTROYED else State.INITIALIZED
        val statefulObserver = ObserverWithState(observer, initialState)
        //LifecycleRegistry#addObserver调用的是`putIfAbsent`方法
        val previous = observerMap.putIfAbsent(observer, statefulObserver)
        if (previous != null) {
            return
        }
        ...
    }
FastSafeIterableMap
public class FastSafeIterableMap<K, V> extends SafeIterableMap<K, V> {
	//继承了SafeIterableMap

    //这里有一个mHashMap!
    private final HashMap<K, Entry<K, V>> mHashMap = new HashMap<>();

    @Nullable
    @SuppressWarnings("HiddenTypeParameter")
    @Override
    protected Entry<K, V> get(K k) {
        //从HashMap中获取Entry<K, V>
        //相对于LifecycleRegistry则是
        //Key是Observer,返回Entry<LifecycleObserver, ObserverWithState>
        return mHashMap.get(k);
    }

    @Override
    public V putIfAbsent(@NonNull K key, @NonNull V v) {
        //先查找HashMap中是否存在这个Key对应的Enrty<K,V>,存在直接返回
        Entry<K, V> current = get(key);
        //注意:不会覆盖原来的值,只是把之前存入的值返回
        if (current != null) {
            return current.mValue;
        }
        //不存在,则存储这个Enrty<K,V>进入HashMap
        //相对于LifecycleRegistry则是
        //Key是Observer,存入Entry<LifecycleObserver, ObserverWithState>
        //put方法是父类的, 会返回一个Entry<K, V>
        mHashMap.put(key, put(key, v));
        return null;
    }

    @Override
    public V remove(@NonNull K key) {
        V removed = super.remove(key);
        //不仅把本身(SIM)的也删除,HashMap中存储的也删除。
        mHashMap.remove(key);
        return removed;
    }

    //这里是Trick,也是“Fast”之处,为什么使用配合SIM也一目了然。
    //HashMap可以实现O(1)的快速查找,SIM由于是链表,查找最差会到达On级别
    public boolean contains(K key) {
        return mHashMap.containsKey(key);
    }

    //返回,给定Key关联的Entry的,前一个的Entry。
    //为什么要返回前一个Entry,详细请见————Lifecycle的源码阅读记录
    @Nullable
    public Map.Entry<K, V> ceil(K k) {
        if (contains(k)) {
            return mHashMap.get(k).mPrevious;
        }
        return null;
    }
}
参考
https://blog.csdn.net/Just_keep/article/details/129755102
https://liweijieok.github.io/2021/04/26/FastSafeIterableMap/