
HashMap 知识点
内部数据结构
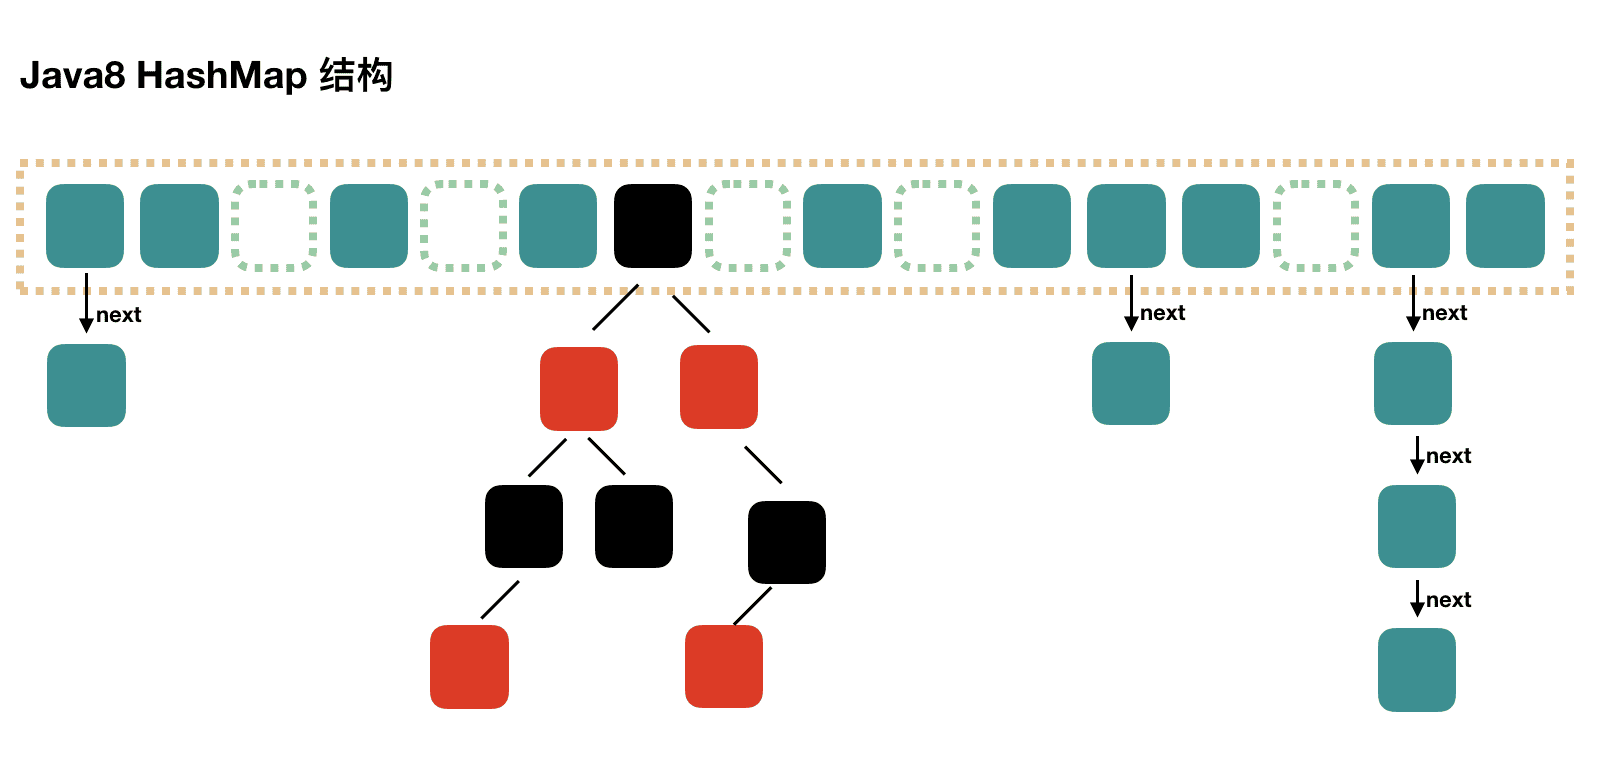
数组 + 链表/红黑树
JDK 1.8的优化
HashMap中Entry的链表长度大于阈值(默认为 8)时,就会将链表转化为红黑树(将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树),以减少搜索时间。
关键字段/影响性能的重要参数
int size
作用:当前键值对数量。
设计原因:用于判断是否超过 threshold 触发扩容。
注意:不是桶的数量,而是总元素数。
int threshold
作用:触发下一次扩容的阈值 = newCap * loadFactor(向下取整)。
在构造函数中如果显式指定 初始容量 initialCapacity 时,threshold 临时保存 初始容量 initialCapacity(通过 tableSizeFor 计算)。复用字段,减少内存占用。
一旦 table 被初始化,resize进行计算设置,threshold 就表示真正的扩容阈值。
HashMap中并没有显式的Capacity字段,一般使用都是用table.length代替。
只有在resize时,计算threshold时,capacity的概念才会凸显,newCap来源有:DEFAULT_INITIAL_CAPACITY = 16、table.length(现在容量)、oldThreshold(上一次的阈值)。
final float loadFactor
作用:负载因子,控制扩容的“松紧度”。
设计为 final:一旦构造完成就不能修改,保证一致性。
权衡:
- 高负载因子 → 更省内存,但冲突多;
- 低负载因子 → 更少冲突,但更耗内存。
TREEIFY_THRESHOLD
初始化为8,如果桶上的链表元素数量大于等于8,就会树化,链表变成红黑树。
UNTREEIFY_THRESHOLD
初始化为6,如果桶上的红黑树元素数量小于等于6,就会去树化,红黑树变成链表。
为什么树化/去树化的阈值之间要有差值?
之所以设计中间有差值,是因为:防止频繁的插入、删除,而出现频繁的树化/去树化的操作发生,影响HashMap性能。
允许空键空值?
允许,但是空键会覆盖。
当key == null时,index 为 0,如果key 再次为 null,index返回0,那么数据就会覆盖。
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
//source:https://github.com/openjdk/jdk/blob/master/src/java.base/share/classes/java/util/HashMap.java#L336C1-L339C6
工作原理
Put方法的原理
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

public V putIfAbsent(K key, V value) {
    return putVal(hash(key), key, value, true, true);
}

//onlyIfAbsent 如果是 true,那么只有在不存在该 key 时才会进行 put 操作
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {
    Node<K,V>[] tab; Node<K,V> p; int n, i;
    //懒初始化:table 在首次 put 时才分配(节省内存)。
    if ((tab = table) == null || (n = tab.length) == 0)
        //调用 resize() 进行初始化(容量为 16)或扩容(*2)。
        n = (tab = resize()).length;
    //若目标桶为空,直接创建新节点。
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    //桶非空:处理冲突
    else {
        Node<K,V> e; K k;
        // (a) 首节点匹配
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            e = p; //后续更新值
        else if (p instanceof TreeNode)
        //(b) 红黑树处理:
			//调用 TreeNode.putTreeVal(...),在树中查找或插入。
            //先按 hashCode,再按 compareTo(若 key 实现 Comparable),最后用 tieBreakOrder(类名 + identityHashCode)。
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        else {
        //(c) 链表处理 无限循环
            for (int binCount = 0; ; ++binCount) {
                //检查是否遍历到了尾部
                if ((e = p.next) == null) {
                    //先插入
                    p.next = newNode(hash, key, value, null);
                    //插入完成后,检查是否要树化(链表长度大于等于8,树化)
                    if (binCount >= TREEIFY_THRESHOLD - 1) // -1 是循环从0开始
                        //调用 treeifyBin(tab, hash) 尝试树化(但可能先扩容)。
                        treeifyBin(tab, hash);
                    break;
                }
                //遍历,有节点匹配e
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;
                //p指向下一个条目,方便e = p.next继续检查
                p = e;
            }
        }
        //更新已有节点的值
        if (e != null) { // existing mapping for key
            V oldValue = e.value;
            //onlyIfAbsent=true(如 putIfAbsent)且 oldValue 非 null,则不覆盖。
            //否则更新值
            if (!onlyIfAbsent || oldValue == null)
                e.value = value;
            //调用 afterNodeAccess(e):LinkedHashMap 用此实现 LRU(访问顺序)。
            afterNodeAccess(e);
            //返回旧值
            return oldValue;
        }
    }
    //更新计数、扩容、回调
    ++modCount;
    //size++ > threshold:触发扩容。
    if (++size > threshold)
        resize();
    //afterNodeInsertion(evict):LinkedHashMap 用此实现 removeEldestEntry。
    afterNodeInsertion(evict);
    return null;
}
比如调用 hashMap.put("book", 0) ,插入一个Key为“book"的元素,值为0。
这时使用哈希函数hash(key),可以计算出Entry(键值对对象) 的插入位置(index)。
但是,因为HashMap的长度是有限的,当插入的Entry越来越多时,必然会出现index冲突的情况。
这时候就想到用一个数组table做“挂钩”,把Entry对象设置为一个Node,table数组里每个元素存储的是一个链表的头结点Entry,每一个Entry对象通过Next指针指向它的下一个Entry节点。当新来的Entry映射到冲突的数组位置时,只需要插入到对应的链表即可。一个挂钩,下面挂着一条链子。
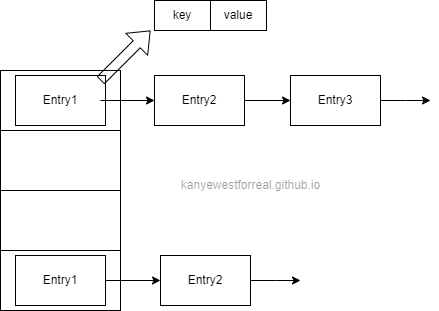
需要注意的是,新来的Entry节点插入链表时,使用的是头插法,是因为HashMap的发明者认为,后插入的Entry被查找的可能性更大,那么后插入的Entry放在桶的最上面,可以提高查找速度。
Get方法的原理
public V get(Object key) {
    Node<K,V> e;
    return (e = getNode(key)) == null ? null : e.value;
}
//平均 O(1) 时间复杂度(hash find);
//在冲突严重时(树化后)退化为 O(log n),而非 O(n)。
final Node<K,V> getNode(Object key) {
        Node<K,V>[] tab; Node<K,V> first, e; int n, hash; K k;
    	//若未初始化,结束,直接返回 null
        if ((tab = table) != null && (n = tab.length) > 0 &&
            //如果桶为空(没有这个key),返回null
            (first = tab[(n - 1) & (hash = hash(key))]) != null) {
            // 先检查桶第一个元素,如果hash 相等 且 key 相等,桶的第一个元素就是要找的
            // hashCode() 不同则 key 必不同
            if (first.hash == hash &&
                //一个用 == 检查,一个用equals检查
                ((k = first.key) == key || (key != null && key.equals(k))))
                return first;
            //第一个元素不是
            //处理链表或红黑树
            if ((e = first.next) != null) {
                //若是 TreeNode:
                //调用 ((TreeNode)first).getTreeNode(hash, key),进入红黑树查找。
                if (first instanceof TreeNode)
                    return ((TreeNode<K,V>)first).getTreeNode(hash, key);
                //否则遍历链表,逐个比较。
                do {
                    if (e.hash == hash &&
                        ((k = e.key) == key || (key != null && key.equals(k))))
                        return e;
                } while ((e = e.next) != null);
            }
        }
        return null;
}
首先会把输入的Key做一次Hash映射,得到对应的index,
由于刚才所说的Hash冲突,同一个位置有可能匹配到多个Entry,这时候就需要顺着对应链表的头节点,一个一个向下来查找。
初始化/扩容
什么时候会触发resize?
resize() 在以下 两种主要场景 下被调用:
首次插入元素时的懒初始化
- 当使用默认构造函数
new HashMap<>()创建对象时,table并未分配内存(为null)。 - 第一次调用
put()时,putVal()中检测到table == null,会调用resize()来初始化table为默认容量 16。 - 这不是“扩容”,而是 初始化。
✅ 触发条件:
table == null || table.length == 0
插入后元素数量超过阈值
每次成功插入一个新键值对(即 size 增加),会检查:
if (++size > threshold)
	resize();
其中 threshold = newCap * loadFactor(向下取整)。
newCap来源有:DEFAULT_INITIAL_CAPACITY = 16、tab.length(现在容量)、oldThreshold(上一次的阈值)。
例如:默认容量 16,负载因子 0.75 → threshold = 12,当 size 变为 13 时触发扩容。
✅ 触发条件:
size > threshold
批量插入(如 putAll 或构造时传入 Map)
putMapEntries() 会根据 m.size() 预估容量,并可能提前扩容,避免后续频繁触发。
树化前容量不足时也会触发 resize 而非树化
在 treeifyBin()中
if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
	resize();
即使链表长度 ≥8,但若 table.length < 64,优先 扩容 而不是树化。
✅ 这是一种优化:扩容可能自然分散冲突,避免不必要的树结构开销。
resize方法介绍
final Node<K,V>[] resize() {
    Node<K,V>[] oldTab = table;
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    int oldThr = threshold;
    int newCap, newThr = 0;
    //情况 A:已初始化,正常扩容
    if (oldCap > 0) {
        //已经是最大容量了,但是触发resize扩容
        //那么修改触发阈值threshold,不做其他操作
        if (oldCap >= MAXIMUM_CAPACITY) {
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }
        //否则,没有达到最大容量
        //扩容为 2 倍(保持 2 的幂)。
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                 oldCap >= DEFAULT_INITIAL_CAPACITY)
            //是大表了,oldCap >= 16(避免小表过早扩容)
            //双倍阈值threshold
            newThr = oldThr << 1;
    }
    //情况 B:未初始化,但 threshold > 0
    //(构造时指定了初始容量,则thresold = tableSizeFor(initialCapacity))
    else if (oldThr > 0)
  		//则 newCap = tableSizeFor(initialCapacity)
        newCap = oldThr;
    else {
        //完全默认构造
        newCap = DEFAULT_INITIAL_CAPACITY;//16
        //16*0.75 = 12
        //如果 size > threshold 触发resize
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }
    //如果是 情况A的小表 或者 情况B
    //那么兜底,计算threshold
    if (newThr == 0) {
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                  (int)ft : Integer.MAX_VALUE);
    }
    //更新threshold 下次扩容阈值
    threshold = newThr;
    @SuppressWarnings({"rawtypes","unchecked"})
    //创建新表 类似JDK 1.7 HashMap transfer方法
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
    table = newTab;
    //迁移旧数据
    if (oldTab != null) {
        //依次遍历桶
        for (int j = 0; j < oldCap; ++j) {
            Node<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;
                //情况 1:这个桶中只有一个节点(没有hash冲突,即没有链表、红黑树)
                if (e.next == null)
                    //直接 rehash 到新位置。
                    newTab[e.hash & (newCap - 1)] = e;
                //情况 2:这个桶是红黑树
                else if (e instanceof TreeNode)
                    //调用 TreeNode.split(),将树节点按 hash & oldCap 分为两组:
					//低位组(lo):保留在原索引 j
					//高位组(hi):迁移到 j + oldCap
					//若分组后节点数 ≤6,则 untreeify(转回链表)。
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                else {
                    //情况 3:这个桶是普通链表(重点!JDK8 改进)
                    //尾插法
                    //分两组迁移:基于 e.hash & oldCap 判断是否要移动到高位桶。
                    //低位组(lo):保留在原索引 j
					//高位组(hi):迁移到 j + oldCap
                    Node<K,V> loHead = null, loTail = null;
                    Node<K,V> hiHead = null, hiTail = null;
                    Node<K,V> next;
                    do {
                        next = e.next;
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                //尾插
                                loTail.next = e;
                            loTail = e;
                        }
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                //尾插
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);

                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
分组/分裂问题
介绍
关于情况2、3中的,按高低位分组问题:
当 HashMap 扩容时(比如从 16 → 32),桶的数量tab.length变多了。
因为index = hash &(n-1),index计算与桶的数量tab.length有关,原来在第 i 个桶里的元素,扩容后,不一定还在第 i 个桶,可能要移到新的桶中。
所以必须重新计算每个元素的新位置,这个过程叫 rehash(重新哈希)。
以扩容前,是16 = 10000举例,其掩码为 16 - 1 = 15 = 1111。
考虑一个元素的 hash 值,比如:
| Hash | index = hash & 1111(扩容前) | index = hash & 11111 (扩容后) |
|---|---|---|
0 1011 |
1011= 11 |
0 1011= 11 |
1 1011 |
1011= 11 |
1 1011= 27 |
差别在于:hash 的第 4 位(从0开始计数)是 0 还是 1。
所以,oldCap = 16 = 1 0000 & hash 来判断是否需要迁移到新桶。
if ((hash & oldCap) == 0) {
    // 第4位是0 → 新索引 = 旧索引 → 低位组
} else {
    // 第4位是1 → 新索引 = 旧索引 + oldCap → 高位组
}
为什么要分组?好处是什么?
避免重复计算 hash 和模运算
- 不需要重新调用
hash(key)或hash % newCap。 - 仅通过一次位与操作
hash & oldCap就能判断新位置。 - 性能极大提升,尤其在大数据量扩容时。
树节点也能高效分裂
- 红黑树在扩容时,同样按
hash & oldCap分为两棵子树。 - 分裂后,如果某棵树节点数 ≤6,会自动转回链表(节省内存)。
扩容是“原地分组”
- 每个旧桶的元素只会去两个新桶之一:
j或j + oldCap。 - 不需要全局打乱,迁移过程高度局部化。
删除
树化
去树化/链表化
Balance
//TODO
如何提升HashMap函数的查找、插入效率?
我们知道从Key映射到HashMap的对应位置Index,会用到一个hash(key)函数。
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
两个key使用hash函数得到相同的hash,表示发生了hash碰撞。
如果hash算法计算结果越分散均匀,Hash碰撞的概率就越小,那么hashmap的存取效率就会越高。(不用处理链表/红黑树)
明显的,hash 计算的速度越快,那么hashmap的存取效率也就会越高。
所有提高效率都可以从这两点入手。
为什么hash函数要进行 异或、位运算?
在hash函数中,进行扰动,可以提升hash的随机性,减少hash碰撞。
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
int h = key.hashCode(),h是32位, h >>> 16 得到的是其高16位。h ^ (h >>> 16) 进行异或运算,这样就低位就混合了高位的特征,增大了随机性。
(在JDK8之前,扰动函数会扰动多次,JDK8简化了这个操作)
为什么table初始化为16?为什么需要是2的次幂?
Java中HashMap的table默认初始化为 DEFAULT_INITIAL_CAPACITY = 1 << 4 ( aka 16 )容量。
否则,指定其他容量时,会调用threshold = tableSizeFor(initialCapacity)设置,直到table初始化前,threshold 都临时储存初始容量。
//作用:返回 ≥ cap 的最小 2 的幂。
static final int tableSizeFor(int cap) {
    int n = -1 >>> Integer.numberOfLeadingZeros(cap - 1);
    return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}
首先,在get、put方法中,可以发现HashMap通过 哈希值 与 table数组容量 确定元素在数组中的位置:
//n = tab.length 不是 size!
//n 表示有几个桶
index = (n - 1) & hash
当容量是2的次幂时,n - 1的二进制表示全是1:
- 容量16:
16 - 1 = 15→ 二进制1111 - 容量32:
32 - 1 = 31→ 二进制11111
这样,(n - 1) & hash 就相当于取哈希值的低几位,效果等同于取模运算 hash % capacity,但位运算的性能远高于取模运算。
因为位运算直接对内存数据进行操作,不需要转成十进制,所以位运算要比取模运算的效率更高
为什么不取10呢?
这是为了数据分布的更加均匀,也就是说 需要坐落在每一个Index的概率相等。
LeetCode:41. First Missing Positive
知道上述原理后,对于LeetCode这一题也是十分简单的。手写Hash函数,再Check 返回缺失值。
假设容量为10:10 - 1 = 9 → 二进制 1001
与运算 hash & 1001 时,只有第0位和第3位参与运算。
// 哈希值二进制示例
hash1 = 0010 & 1001 = 0000 → 位置0
hash2 = 0011 & 1001 = 0001 → 位置1
hash3 = 0100 & 1001 = 0000 → 位置0 // 冲突!
hash4 = 0101 & 1001 = 0001 → 位置1 // 冲突!
这会带来问题:
也就是说,当HashMap 容量为10的时候,有些index结果的出现几率会更大,而有些index结果永远不会出现。
因此,初始化/扩容为 2的n次幂,可以保证,后续在get/put entry时,尽可能的减少哈希碰撞,提高插入查找效率。
多线程不安全问题
头插法导致的死循环(CPU Usage 100%)
JDK1.7 中,如果两个线程并发触发了HashMap扩容,因为扩容时迁移使用 头插法插入元素 ,会形成环,使得后续查询因为死循环造成CPU占用率100%。
/**
 * 将当前哈希表中的所有Entry迁移到新表中(哈希表扩容/缩容核心方法)
 * @param newTable 新哈希表数组
 * @param rehash 是否需要重新计算哈希值(例如HashMap扩容时会触发)
 */
void transfer(Entry[] newTable, boolean rehash) {
    // 1. 获取新表的容量(新数组长度)
    int newCapacity = newTable.length;
    // 2. 遍历旧表的每一个桶(数组位置)
    for (Entry<K,V> e : table) {
        // 3. 遍历桶中的链表(处理链表中的每一个节点)
        while(null != e) {
            // 4. 保存下一个节点(防止链表断裂)
            Entry<K,V> next = e.next;
            // 5. 如果需要重新计算哈希值(例如扩容时)
            if (rehash) {
                // 6. 重新计算哈希值:如果key为null则哈希=0,否则用hash()方法计算
                e.hash = null == e.key ? 0 : hash(e.key);
            }
            // 7. 计算当前节点在新表中的位置(取模运算简化为位运算)
            int i = indexFor(e.hash, newCapacity);
            // 8. 头插法:将当前节点的next指向 新表 对应桶的链表头部
            e.next = newTable[i];
            // 9. 将当前节点设为新链表头部
            newTable[i] = e;
            // 10. 移动到链表的下一个节点
            e = next;

//newTable[i] 代表的是位置上的最上面那本书!
//头插法:
//假设新表的某个位置 i 原本已经有一摞书,现在要把一本新书 e 放在这摞书的最上面
//e.next = newTable[i]:把新书 e 的下一本指向 当前书摞的最上面 那本(newTable[i])。
//此时书摞还是 书A → 书B → null,因为e.next = newTable[i],则e.next = 书A,此时新书 e 的下一本是书摞的顶部书。
//newTable[i] = e: 把整个书摞的顶部标记为新书 e。现在书摞变成 e → 书A → 书B → null,新书 e 成为新的顶部。
        }
    }
}
举例
假设旧表长度为2,新表长度为4。
-
初始状态:
旧表中有两个桶,其中桶1的链表为:
EntryA → EntryB → null(哈希冲突导致链表结构)线程1和线程2同时触发扩容操作。
-
线程1执行到步骤4:
Entry<K,V> next = e.next; // 线程1此时e=EntryA,next=EntryB // 线程1在此处被挂起...! -
线程2完整执行整个transfer:
线程2将
EntryA和EntryB迁移到新表的桶,由于头插法,新表中桶的链表变为:EntryB → EntryA → null注意:头插法导致链表顺序反转
-
线程1恢复执行:
线程1仍持有旧的链表引用:
e=EntryA,next=EntryB继续执行迁移:
// 计算EntryA节点在新表中的位置
int i = indexFor(e.hash, newCapacity);
// 此时新表该位置已被线程2写入EntryB,所以EntryA.next = EntryB
e.next = newTable[i];
// 将EntryA设为链表头部(此时链表变成EntryA → EntryB)
newTable[i] = e;
// e=EntryB,继续处理下一个节点
e = next;
处理
EntryB时:Entry<K,V> next = e.next; // EntryB.next原本是null(线程2迁移后的状态) int i = indexFor(e.hash, newCapacity); e.next = newTable[i]; // 新表该位置当前是EntryA,所以EntryB.next = EntryA newTable[i] = e; // 链表变成EntryB → EntryA → EntryB(形成环!) -
最终结果:
新表中出现环形链表:
EntryB → EntryA → EntryB后续对该链表进行查询时,CPU会因死循环导致100%占用!
尾插法导致的数据覆盖
JDK1.8 中,如果两个线程并发执行 put 操作,并且两个数据的 hash 值冲突,就可能出现数据覆盖。
举例
假设哈希表初始状态如下:
- 桶位置
i为空(table[i] = null)。 - 线程A和线程B同时调用
put(key1, value1)和put(key2, value2),且key1和key2哈希冲突(即hash(key1) = hash(key2))。
-
线程A执行到插入逻辑:
// 伪代码:判断桶位置是否为空 if ((p = table[i]) == null) { // 直接插入新节点(线程A在此处被挂起) table[i] = newNode(hash, key1, value1, null); }- 线程A发现
table[i]为空,准备插入新节点Node(key1, value1),但尚未执行赋值操作。
- 线程A发现
-
线程B抢占执行:
if ((p = table[i]) == null) { // 线程B发现table[i]仍为空(因为线程A还未执行赋值) table[i] = newNode(hash, key2, value2, null); }- 线程B直接插入
Node(key2, value2),此时table[i]被赋值为新节点。
- 线程B直接插入
-
线程A恢复执行:
table[i] = newNode(hash, key1, value1, null); // 覆盖线程B的插入- 线程A继续执行赋值操作(不会再次检查table[i]是否为空),覆盖线程B已插入的节点。最终
table[i]中仅保留Node(key1, value1),key2的数据彻底丢失!
- 线程A继续执行赋值操作(不会再次检查table[i]是否为空),覆盖线程B已插入的节点。最终
解决方案
-
避免共享状态:在多线程环境中,尽量为每个线程分配独立的HashMap实例。
-
同步锁:对HashMap的写操作加锁(如
synchronized),但会大幅降低性能。synchronized(map) { map.put(key, value); } -
线程安全容器:直接使用
ConcurrentHashMap替代HashMap,其内部通过分段锁(JDK7)或CAS+synchronized(JDK8)保证并发安全。Map<String, Object> safeMap = new ConcurrentHashMap<>(); safeMap.put(key, value); // 无需额外同步
参考
https://juejin.cn/post/6844903518264885256
https://juejin.cn/post/6844903518331994119
https://cloud.tencent.com/developer/article/2427109
https://pdai.tech/md/java/collection/java-map-HashMap&HashSet.html