
Android Jetpack(2) Livedata源码阅读记录
发现问题
在传统的Android开发中,经常需要通过本地/网络进行异步获取数据,获取过程中会消耗一定的时间,这段时间常常是不可感知的空白期,大多数只有获取最终结果的回调,会出现许多状况:
- 生命周期管理缺失: 无法感知 Android 生命周期,如果直接使用数据去 UI 更新时可能引发崩溃或内存泄漏。UI不可见或已销毁就需要避免无效更新。
- 线程安全问题: UI 更新需主线程执行,但数据可能来自子线程,异步数据推送容易引发竞态条件。
- 内存泄漏:如果使用传统观察者模式,可能出现UI组件销毁后未取消订阅,导致持有引用,最后内存泄漏的情况发生,或者手动取消订阅过于模板代码。
- 粘性事件:新的观察者(UI)可能需要立即获取最新数据。
解决思路
核心需求
- 生命周期感知:数据变化时,仅通知处于活跃状态(如
STARTED/RESUMED)的观察者。 - 线程安全:确保数据更新和观察回调在主线程执行。
- 粘性事件管理:新观察者自动获取最后一次数据更新。
- 解耦数据与UI:数据持有者(如 ViewModel)不直接依赖 UI 组件(如 Activity)。
关键思路
-
观察者模式(核心设计模式)
Why?- 解耦数据源与观察者:
LiveData作为数据源,无需感知具体观察者(如 Activity/Fragment),观察者只需实现Observer接口。 - 动态订阅/注销:通过
observe()动态绑定生命周期,自动管理订阅关系。 - 多观察者支持:允许多个观察者订阅同一数据源(如多个 Fragment 共享 ViewModel 数据)。
How?
LiveData内部维护观察者列表,通过observe()注册LifecycleBoundObserver包装类。- 当数据变化时,遍历观察者列表,仅通知活跃状态的观察者。
- 解耦数据源与观察者:
-
生命周期状态驱动
Why?- 状态决定行为:观察者是否接收数据取决于其生命周期状态(如
RESUMED时活跃)。 - 容错性:自动处理非法状态(如 Activity 销毁时移除观察者,避免崩溃)。
How?
- 通过
LifecycleBoundObserver绑定Lifecycle状态,在ON_START/ON_RESUME时标记为活跃。 - 生命周期状态变化时,触发
activeStateChanged(),更新观察者状态。
- 状态决定行为:观察者是否接收数据取决于其生命周期状态(如
-
代理模式(生命周期绑定与分发)
Why?- 职责分离:
LifecycleBoundObserver代理观察者的生命周期管理,LiveData仅关注数据逻辑。 - 统一入口:通过
ReportFragment(隐式注入)代理 Activity/Fragment 的生命周期事件监听。
How?
LifecycleBoundObserver实现LifecycleEventObserver接口,代理观察者的生命周期回调。- 当生命周期状态变化时,
LifecycleBoundObserver通知LiveData更新观察者活跃状态。
- 职责分离:
-
版本控制(粘性事件管理)
Why?- 避免重复通知:新观察者仅需获取最新数据版本,而非历史变更。
- 状态同步:确保观察者初始化时与数据源版本一致。
How?
LiveData维护mVersion计数器,每次setValue()递增版本号。- 观察者注册时记录当前版本,若数据版本更新,则立即触发回调。
-
线程切换封装(主线程安全)
Why?- 线程透明性:开发者无需手动切换线程,
postValue()自动将数据更新抛到主线程。 - 安全性:强制
setValue()在主线程调用,避免并发问题。
How?
postValue()通过ArchTaskExecutor切换到主线程,最终调用setValue()。setValue()校验当前线程,非主线程抛出IllegalStateException。
- 线程透明性:开发者无需手动切换线程,
-
装饰器模式(观察者包装)
Why?- 功能增强:通过
LifecycleBoundObserver包装原始观察者,添加生命周期管理逻辑。 - 灵活性:支持扩展不同观察者类型(如
ForeverObserver脱离生命周期的观察)。
How?
observe()方法将原始Observer封装为LifecycleBoundObserver,绑定生命周期。observeForever()使用AlwaysActiveObserver,直接标记为活跃状态。
- 功能增强:通过
解决方案(核心源码)
核心类/接口
LiveData:数据持有者,管理观察者及生命周期。
Observer:观察者接口,定义onChanged(T),数据更新时负责分发。
LifecycleBoundObserver:包装观察者,绑定生命周期状态。
MutableLiveData:可变的LiveData子类,暴露setValue/postValue。
// 观察者注册
public void observe(@NonNull LifecycleOwner owner, @NonNull Observer<? super T> observer) {
    LifecycleBoundObserver wrapper = new LifecycleBoundObserver(owner, observer);
    owner.getLifecycle().addObserver(wrapper); // 绑定生命周期
}

// 数据更新分发
protected void setValue(T value) {
    mVersion++; // 版本号递增
    mData = value;
    dispatchingValue(null); // 遍历观察者,判断活跃状态后回调
}
观察者包装
ObserverWrapper 抽象类跟踪观察者状态,LifecycleBoundObserver 继承并实现生命周期绑定。
private abstract class ObserverWrapper {
    boolean mActive; // 观察者是否活跃
    int mLastVersion = START_VERSION; // 最后接收的数据版本
}

class LifecycleBoundObserver extends ObserverWrapper
    implements LifecycleEventObserver {
    public void onStateChanged(LifecycleOwner source, Lifecycle.Event event) {
        // 根据生命周期状态更新 mActive
    }
}
数据版本控制
LiveData 内部维护 mVersion,每次数据更新递增,观察者通过比较版本决定是否处理。
private int mVersion = START_VERSION;

protected void setValue(T value) {
    mVersion++;
    mData = value;
    dispatchingValue(this);
}
事件分发机制
dispatchingValue() 遍历观察者,仅通知活跃且版本落后的观察者。
void dispatchingValue(ObserverWrapper initiator) {
    if (initiator != null && !initiator.shouldBeActive()) return;
    observer.mObserver.onChanged((T) mData);
}
源码流程图(关键流程)
观察者注册阶段
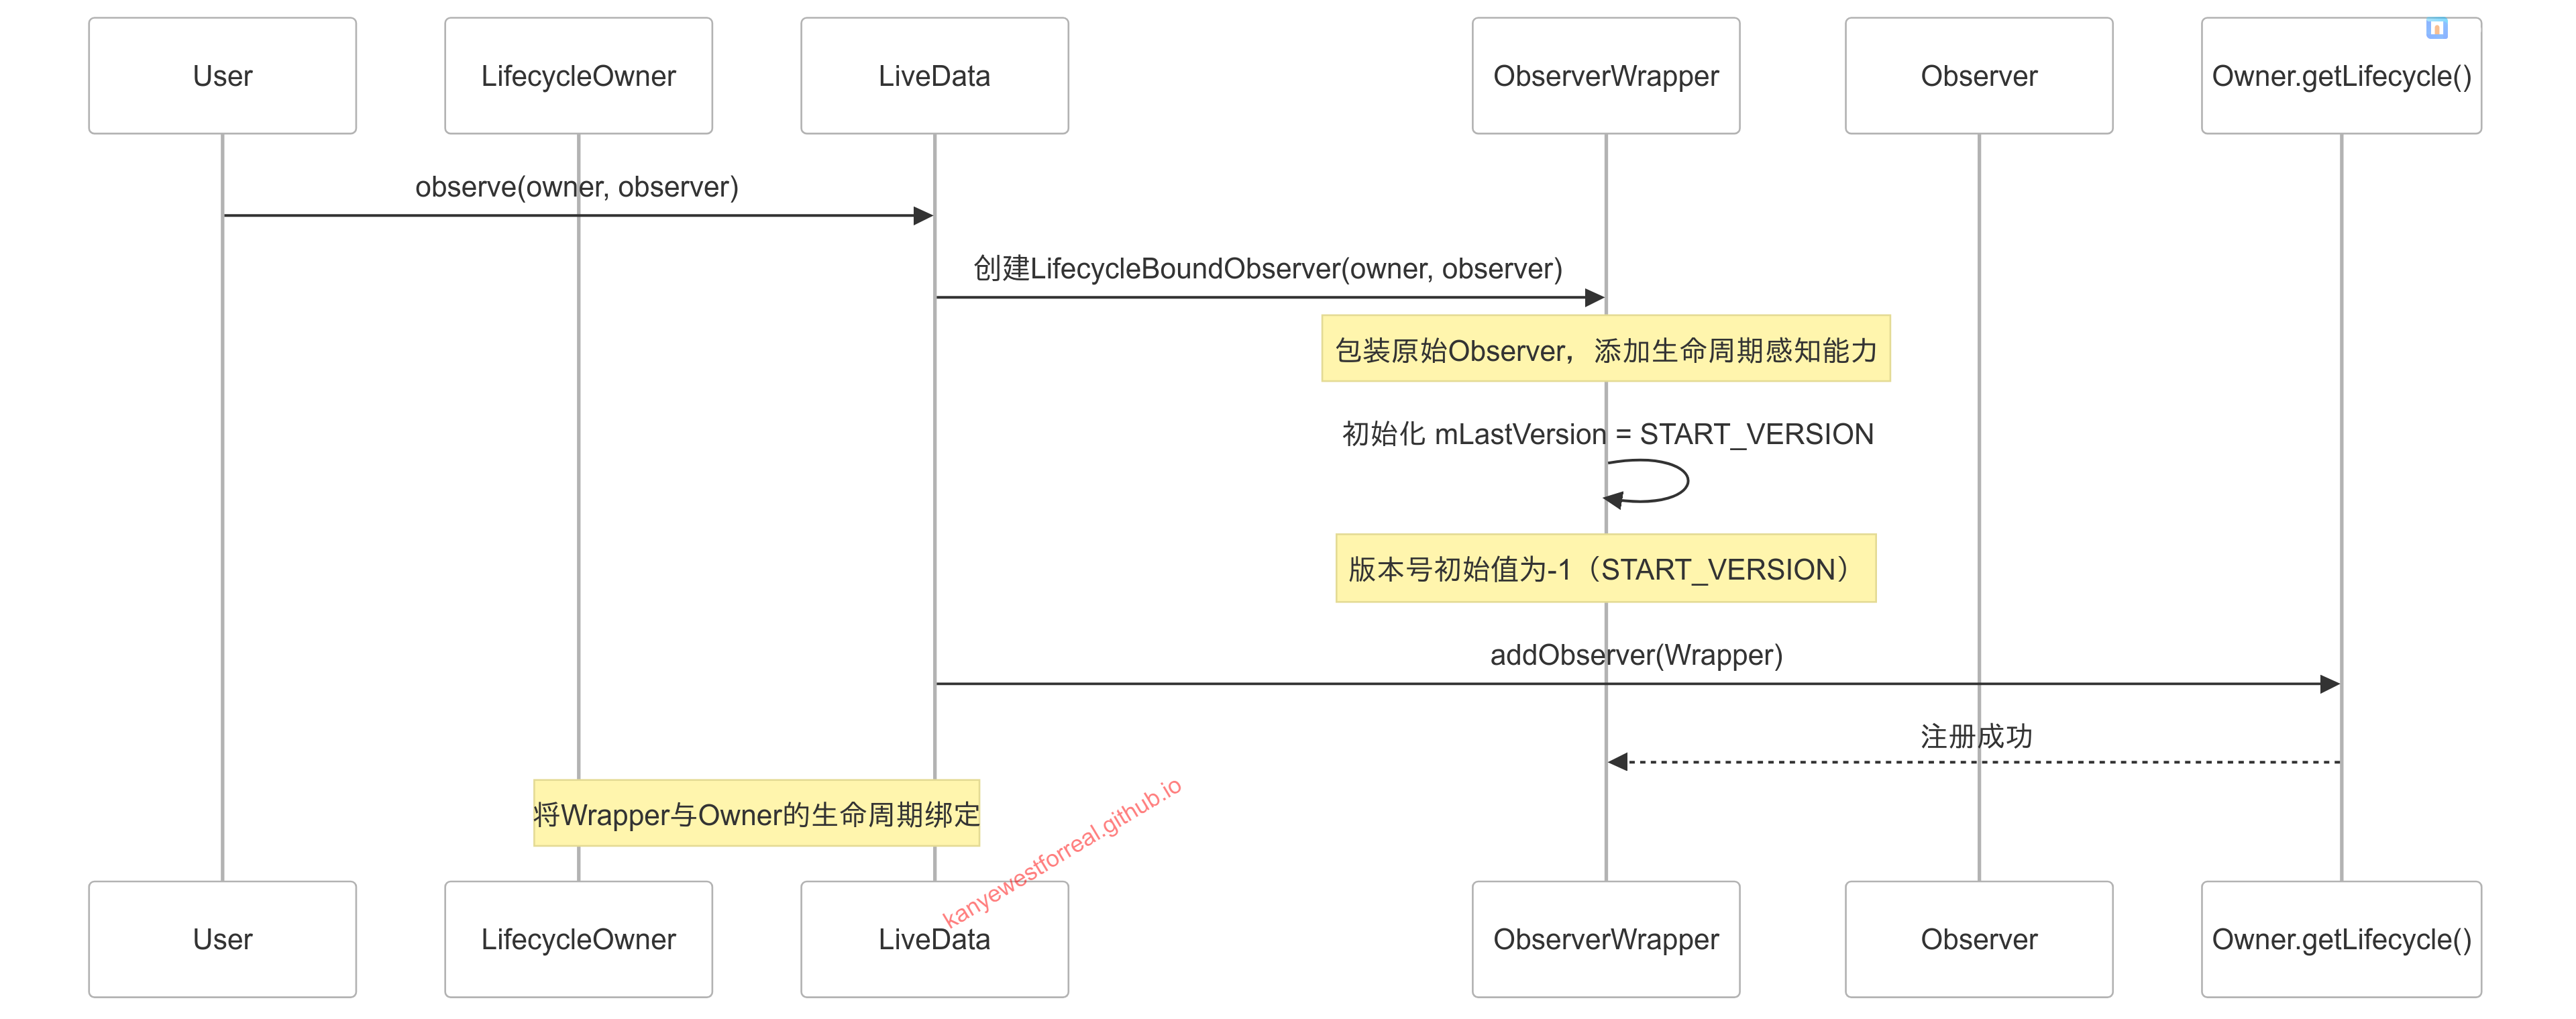
用户通过observe()方法将原始Observer与LifecycleOwner绑定。此时LiveData会创建一个LifecycleBoundObserver(继承ObserverWrapper,实现LifecycleEventObserver接口),该对象ObserverWrapper包含原始Observer和生命周期感知能力。初始化时会记录当前版本号为-1(START_VERSION),然后将ObserverWrapper注册到Owner的生命周期组件中,实现自动生命周期管理。
生命周期事件处理
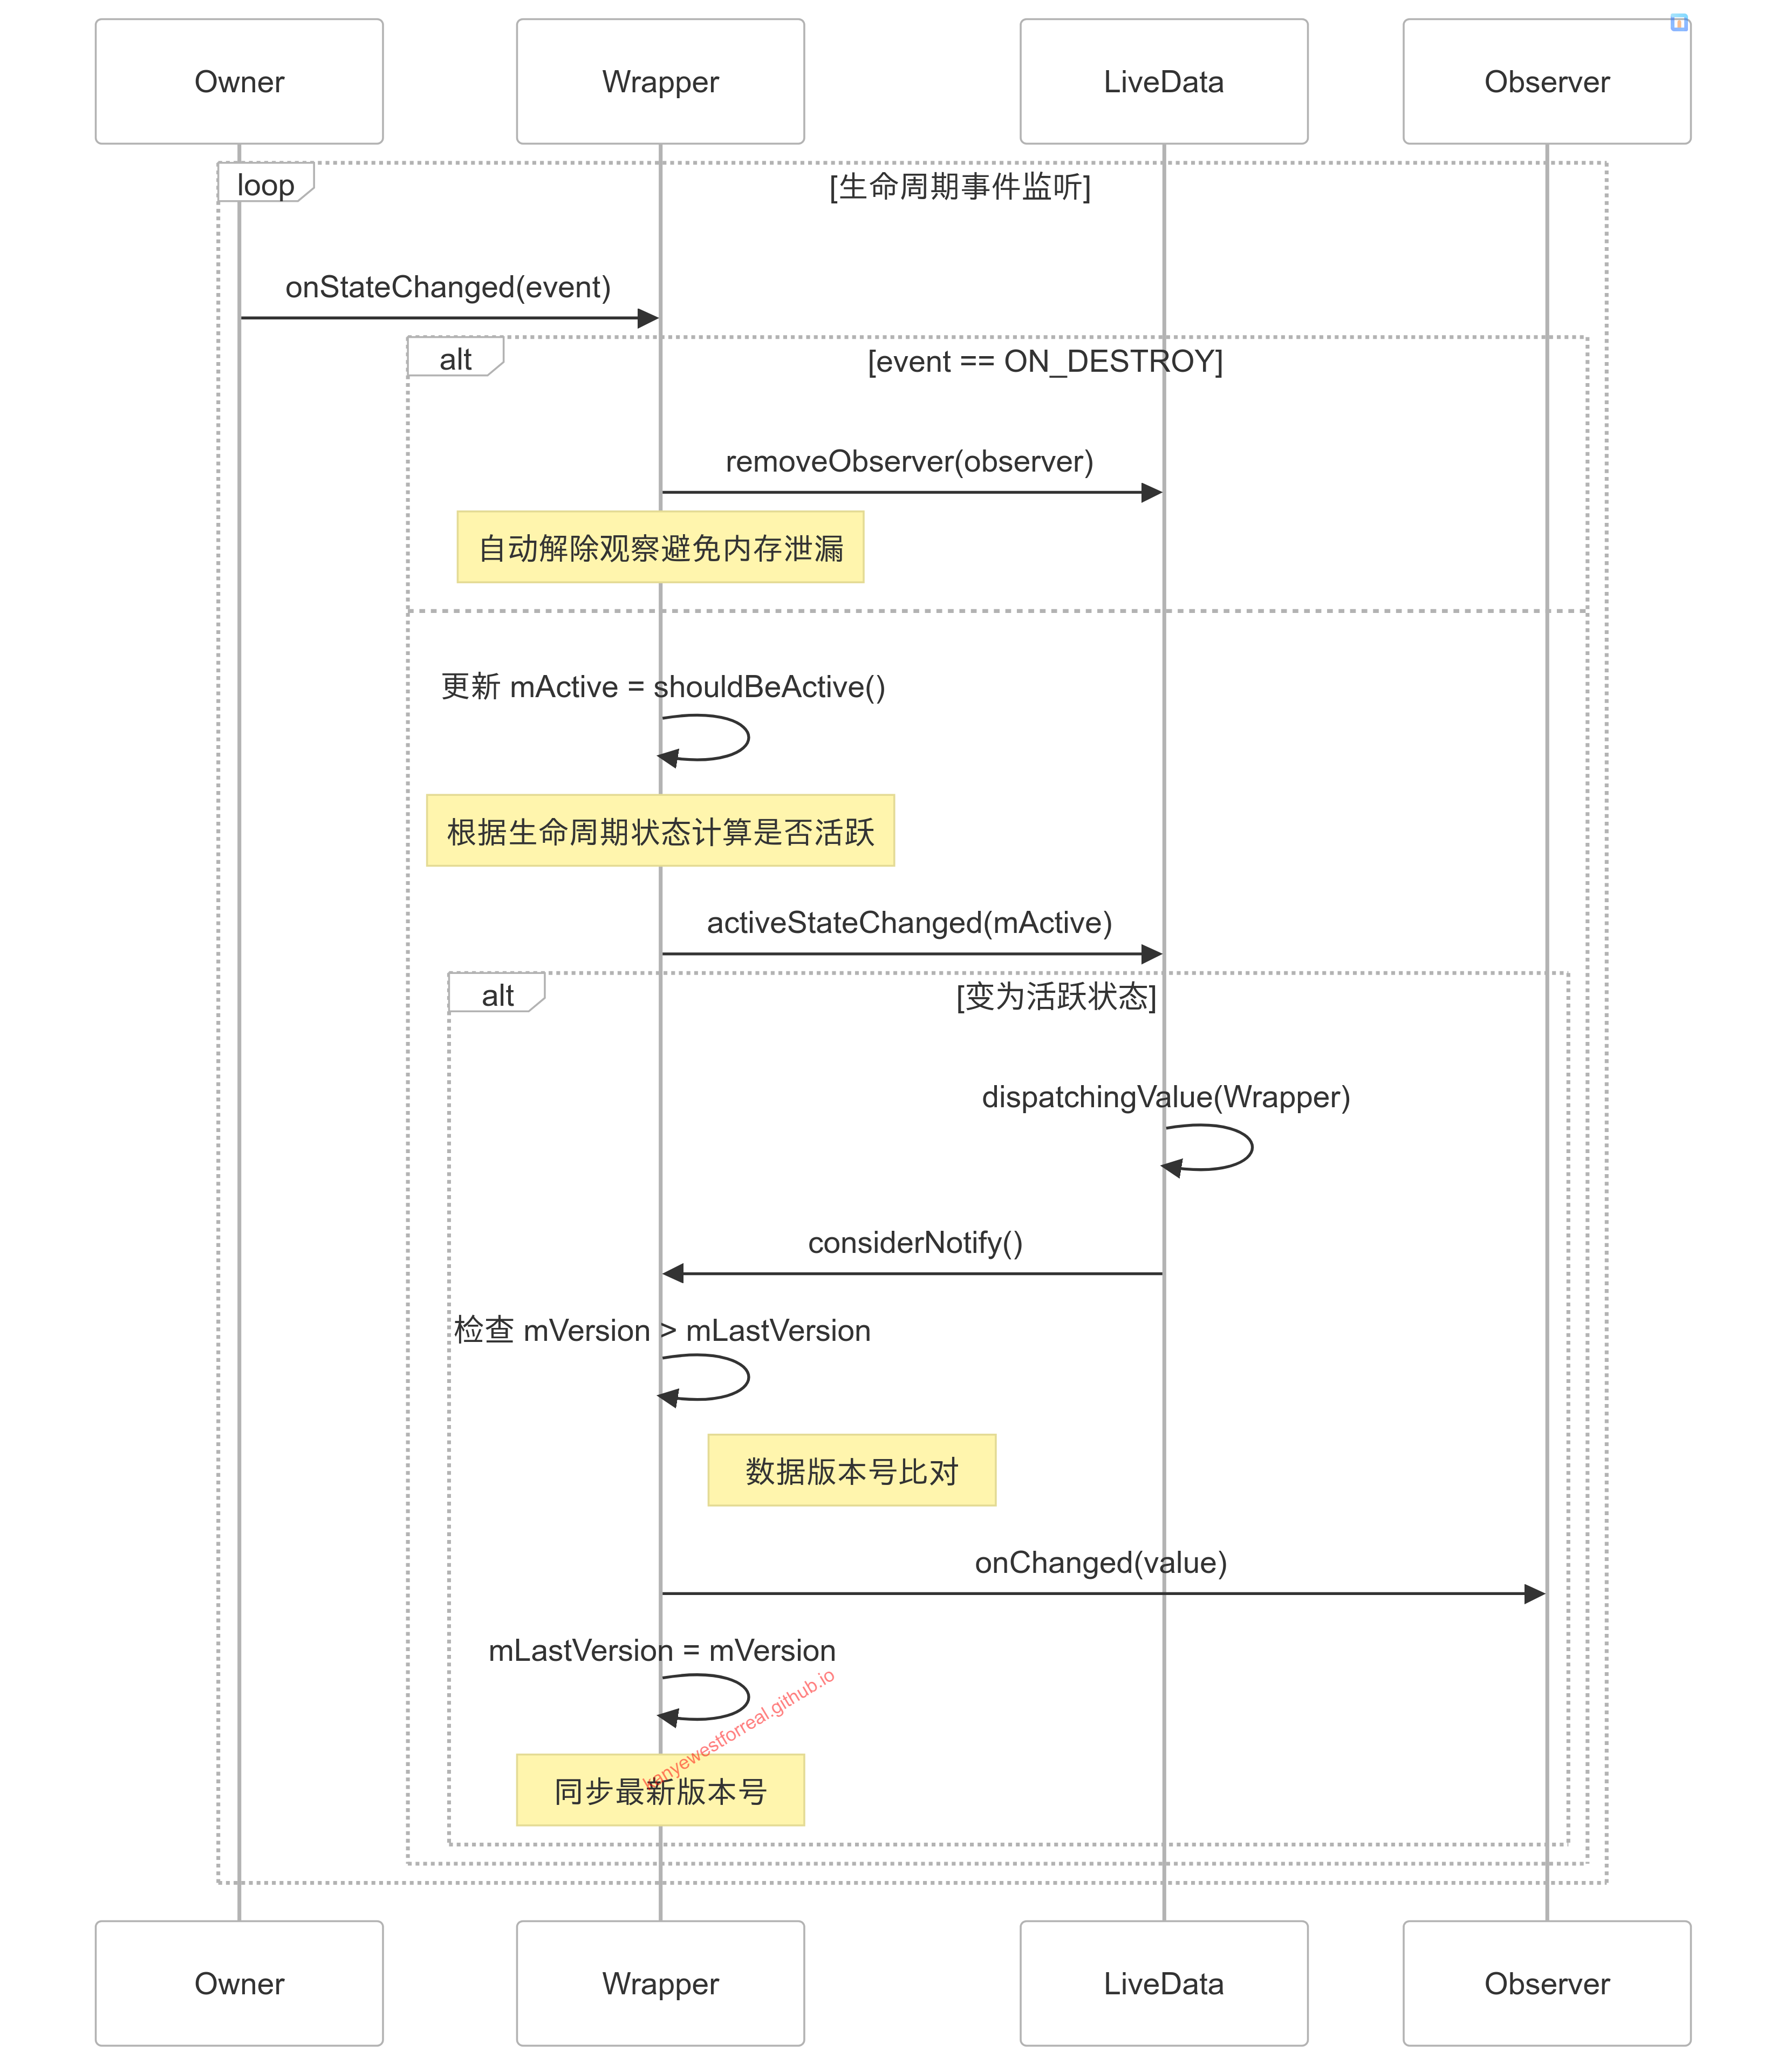
- 当生命周期变为ON_DESTROY时,自动调用
removeObserver()解除观察,这是LiveData防止内存泄漏的关键机制。 - 其他状态变化时,会重新计算活跃状态(例如ON_START/ON_RESUME时为活跃,ON_STOP/ON_PAUSE时为非活跃)。
- 当首次变为活跃状态时,立即触发
dispatchingValue(),通过版本号比对(当前版本号mVersion vs 观察者的mLastVersion),如果数据有更新则回调onChanged(),实现粘性事件特性。
数据更新流程
-
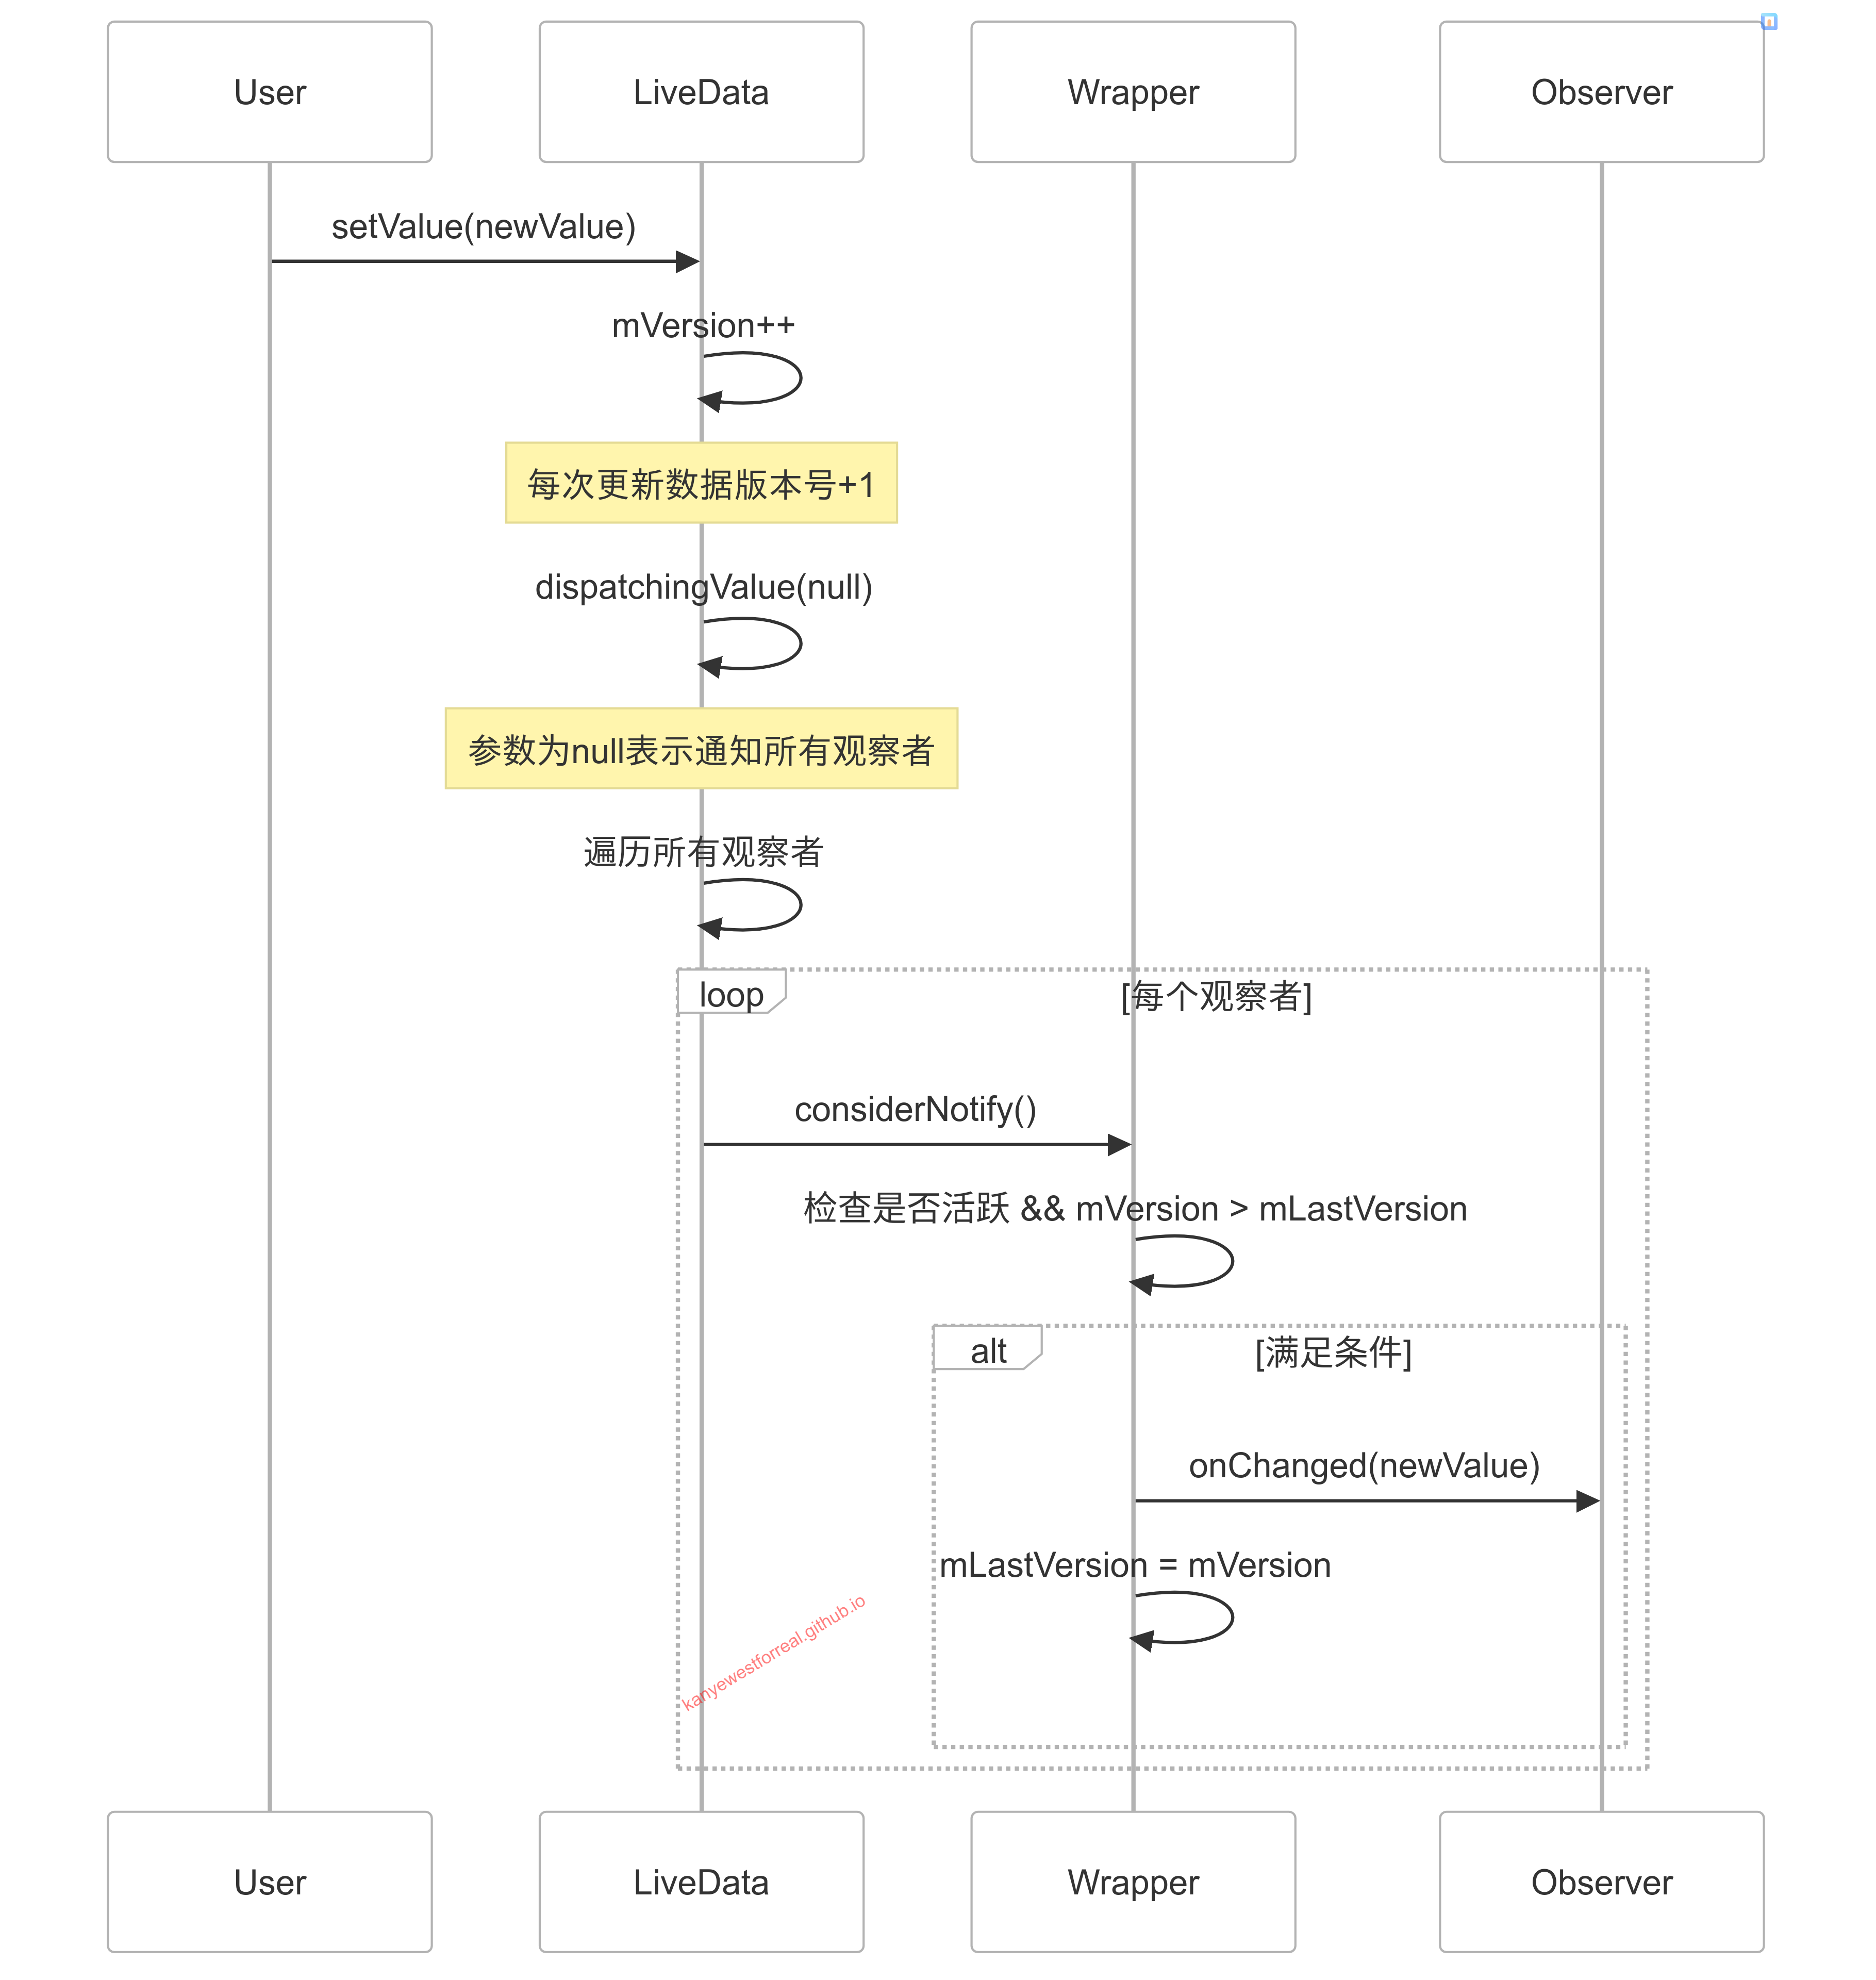
通过
setValue()更新数据时,mVersion自增1,标识数据版本更新。 -
调用
dispatchingValue(null)会遍历所有观察者:对于每个观察者,检查同时满足两个条件:
- 处于活跃状态(当前生命周期状态为STARTED/RESUMED)
- 观察者的mLastVersion < LiveData的mVersion
满足条件则立即分发数据给观察者,并更新观察者的版本号。
注意
observe()与 observeForever() 区别?何时需手动移除观察者?
新观察者如何收到数据?
observe()
先看看observe()的源码。
//在给定所有者的生命周期内将给定的观察者添加到观察者列表中。
//事件在主线程上调度。如果 LiveData 已有数据集,则会将其传送给观察者。
//仅当所有者处于 Lifecycle.State.STARTED 或 Lifecycle.State.RESUMED 状态为 (active) 时,观察者才会接收事件。
//如果Onwer 移动到Lifecycle.State.DESTROYED 状态,则观察者将被自动删除。
//当在 Owner 未激活时数据发生更改时,它不会收到任何更新。
//如果它再次变为活动状态,它将自动接收最后的可用数据。
//只要给定的 LifecycleOwner 未被销毁,LiveData 就会保留对观察者和Owner的强引用。
//当Owner被销毁时,LiveData 会删除对观察者和所有者的引用。
@MainThread
public void observe(@NonNull LifecycleOwner owner, @NonNull Observer<? super T> observer) {
    assertMainThread("observe");
    //如果给定的Onwer已处于DESTROYED 状态,则 LiveData 会忽略该调用。
    //若在DESTROYED后允许注册观察者,后续的LiveData.setValue()可能会触发对无效Observer的调用
    //即使强行绑定,LifecycleBoundObserver也会在onStateChanged()中立即移除自身(因为状态已经是DESTROYED)
    if (owner.getLifecycle().getCurrentState() == DESTROYED) {
        // ignore
        return;
    }
    //对传入的Observer进行包装
    LifecycleBoundObserver wrapper = new LifecycleBoundObserver(owner, observer);
    //一个 Observer 只允许和单个 LifecycleOwner 进行绑定。
    //因为如果允许一个 Observer 同时和多个不同的 LifecycleOwner 进行绑定的话,当某个 LifecycleOwner 进入 DESTROYED 状态时,LiveData 需自动移除关联的观察者,活跃的 LifecycleOwner 可能无法继续接收数据更新。
    //若一个 Observer 对应多个 LifecycleOwner,LiveData 需同时跟踪多个生命周期状态,这会显著增加状态管理的复杂度。
    //注意,一个LifecycleOwner 可以有多个 Observer
    //如果存在返回条目,不存在则存入链表、返回null
    ObserverWrapper existing = mObserver.putIfAbsent(observer, wrapper);
    //对先调用observeForever(),再调用observe()的处理
    //判断条件二:对于AlwaysActiveObserver,其没有覆写isAttachedTo 默认返回false
    if (existing != null && !existing.isAttachedTo(owner)) {
        throw new IllegalArgumentException("Cannot add the same observer"
                + " with different lifecycles");
    }
    //这里就是二次调用observe()的处理
    //如果给定的(onwer,observer) 这一对条目已在链表中,忽略,避免重复添加。
    if (existing != null) {
        return;
    }
    //将 Observer 的生命周期与当前 LifecycleOwner 严格关联。
    owner.getLifecycle().addObserver(wrapper);
}
observeForever()
再看看observeForever()的源码。
//将给定的观察者添加到观察者列表中。
//注意:这个方法不需要传入Onwer。如果LiveData 有一个这样的观察者,这个观察者将一直是活跃的。
//这意味着传入的这个观察者将接收所有数据,不依赖任何生命周期,并且永远不会被自动删除。
//应该手动调用 removeObserver(Observer) 以停止观察此 LiveData。
//拥有这一个观察者,Livedata将持续处于活跃状态。
@MainThread
public void observeForever(@NonNull Observer<? super T> observer) {
    assertMainThread("observeForever");
    //注意AlwaysActiveObserver#shouldBeActive() 总是返回true
    AlwaysActiveObserver wrapper = new AlwaysActiveObserver(observer);
    ObserverWrapper existing = mObservers.putIfAbsent(observer, wrapper);
    //处理先调用observe(),再调用observeForever()的情况
    //如果 Observer 已通过 observe() 绑定到 LifecycleOwner,其包装器为 LifecycleBoundObserver。
	//此时若尝试用 observeForever() 再次注册同一 Observer,会检测到 existing 是 LifecycleBoundObserver 类型,直接抛出异常,阻止混合绑定。
    if (existing instanceof LiveData.LifecycleBoundObserver) {
        throw new IllegalArgumentException("Cannot add the same observer"
                + " with different lifecycles");
    }
    //这里就是二次调用observeForever()的处理
    if (existing != null) {
        return;
    }
    //立刻设置为活跃状态,在该方法中准备进行数据回调。
    //这里我们可以看到与observe不同的是,新观察者一添加进来,observeForever立刻调用了activeStateChanged,尝试进行分发数据
    //而不像observe,是等待Owner分发生命周期状态时,才去调用activeStateChanged尝试进行分发数据
    wrapper.activeStateChanged(true);
}
总结
| 特性 | observe() |
observeForever() |
|---|---|---|
| 生命周期感知 | 是:自动绑定到 LifecycleOwner 的生命周期(如 Activity/Fragment)。 |
否:观察者永久活跃,不依赖任何生命周期。 |
| 自动移除 | 是:当 LifecycleOwner 进入 DESTROYED 状态时,观察者自动移除。 |
否:需手动调用 removeObserver(observer) 移除,否则可能引发内存泄漏。 |
| 活跃状态触发条件 | 仅当 LifecycleOwner 处于 STARTED 或 RESUMED 状态时接收更新。 |
始终接收更新,无论 UI 是否在前台。 |
| 包装类 | LifecycleBoundObserver(内部类,处理生命周期绑定与自动移除)。 |
AlwaysActiveObserver(内部类,强制观察者永久活跃)。 |
| 设计场景 | 适用于 UI 组件(如 Activity/Fragment),需自动管理生命周期。 | 适用于非 UI 场景(如后台服务、Repository 层),需长期监听数据变化。 |
也就是说,使用 observeForever() 时必须手动移除观察者。
LiveData 如何避免内存泄漏?
LifecycleBoundObserver 的作用是什么?
LifecycleOwner状态是如何影响数据分发的?
Lifecycle.State.STARTED 与 RESUMED 对 LiveData 的影响差异?
onInactive能不能判断是否还存在观察者?
问题一:
每一个Livedata被观察时,传入的观察者都被包装成LifecycleBoundObserver类,其继承了ObserverWrapper,实现了LifecycleEventObserver接口,同时观察者与传入的Owner进行关联。
也就是说LifecycleBoundObserver是具有感知Owner的生命周期的能力的。
当Owner的生命周期状态改变时,会回调对应的状态。
//LifecycleBoundObserver#onStateChanged
@Override
public void onStateChanged(@NonNull LifecycleOwner source,
        @NonNull Lifecycle.Event event) {
    Lifecycle.State currentState = mOwner.getLifecycle().getCurrentState();
    //注意:一个Owner可以有多个观察者。
    //DESTROYED前,移除与Owner关联的观察者,防止无法正常GC,这里就是避免内存泄露的主要代码
    //因为观察者可能隐式持有Activity/Fragment的引用(lambda调用其成员方法/变量)
    if (currentState == DESTROYED) {
        removeObserver(mObserver);
        return;
    }
    //确保在生命周期状态可能连续变化的场景下
    //能够稳定处理最终状态,避免因中间状态导致的错误或不一致。
    //这里之所以需要本地变量prevState和while循环配合,
    //是因为activeStateChanged -> dispatchingValue(this) -> considerNotify -> onChanged,会触发数据更新的回调
    //如果在onChanged进行Activity状态改变的操作,就会可能出现这样重入的情况
    //(注意:实际上,测试过启动新Activity、finishActivity、启动DialogActivity、moveTaskToBack,都只会触发一次while。
    //这个while循环是官方在解决changeActiveCounter重入问题时顺手更新的,可能是为了测试active/inactive方法,去手动hanle状态,发现的问题)
    // 初始化上一次状态为null
    Lifecycle.State prevState = null;
    // 循环条件:当前状态与上一次状态不一致时继续处理
    while (prevState != currentState) {
        // 记录当前状态为“上一次状态”
        prevState = currentState;
        //因为Owner状态发生了变更,需要判断LifecycleOwner是否活跃(活跃状态为STARTED/RESUMED)
		//判断结果影响这个Observer是否活跃,同时也会影响是否分发数据。
        activeStateChanged(shouldBeActive());
        // 重新获取最新的生命周期状态(可能在activeStateChanged分发数据的回调中触发了新的状态变化)
        currentState = mOwner.getLifecycle().getCurrentState();
    }
    //注意这是 一个 Observer的onStateChanged方法
}

//LifecycleBoundObserver#shouldBeActive
//用于判断LifecycleOwner是否活跃
@Override
boolean shouldBeActive() {
    //注意,这里LifecycleBoundObserver的活跃条件就是,
    //与其关联的Owner至少要处于STARTED状态,实际上就两个状态STARTED/RESUMED
	return mOwner.getLifecycle().getCurrentState().isAtLeast(STARTED);
}

//LifecycleBoundObserver#removeObserver
@MainThread
public void removeObserver(@NonNull final Observer<? super T> observer) {
 	assertMainThread("removeObserver");
 	ObserverWrapper removed = mObservers.remove(observer);
 	if (removed == null) {
            return;
  	}
 	removed.detachObserver();
    //设置为false,走向changeActiveCounter
 	removed.activeStateChanged(false);
}

//LifecycleBoundObserver#detachObserver
@Override
void detachObserver() {
 	mOwner.getLifecycle().removeObserver(this);
}

//ObserverWrapper#activeStateChanged
void activeStateChanged(boolean newActive) {
    //newActive来自Owner的状态判断结果
    //Owner状态没有变化,没必要往下走,浪费资源
    //比如不活跃到不活跃
    //STARTED到RESUMED
 	if (newActive == mActive) {
 		return;
 	}
    //活跃状态变更
 	//立即设置活跃状态,因此永远不会将值分派给不活跃的Owner
 	mActive = newActive;
    //根据传入的 新状态,改变活跃观察者数量。
    //活跃观察者数量 决定了 Livedata是否属于活跃状态
    //注意,Livedata是否属于活跃状态,
    //默认是不影响分发数据的(Livedata默认没有实现onInactive()/onActive())
    //只有 LifecycleOnwer 的活跃状态才影响分发数据!!!
    //如果自定义实现了,或者使用MediatorLiveData,在onInactive()/onActive(),手动释放Livedata的资源(比如截断数据传给Livedata这个过程),是可以影响分发数据的
 	changeActiveCounter(mActive ? 1 : -1);

    //只有Owner从非活跃到活跃,则分发数据这种情况。
    //对于以下两种
    //因为Owner从活跃到活跃,是不可能走到这里的,前面return了
    //Owner从活跃到不活跃,下面if语句不通过
 	if (mActive) {
 		dispatchingValue(this);
 	}
}


//Livedata#changeActiveCounter
@MainThread
void changeActiveCounter(int change) {
    //保存 改变前的 活跃观察者数量
    //活跃观察者数量 决定了 Livedata是否属于活跃状态
    int previousActiveCount = mActiveCount;
    //改变后的数量
    mActiveCount += change;
    //用于解决重入问题的flag
    if (mChangingActiveState) {
        return;
    }
    //表示正在进行修改活跃状态
    mChangingActiveState = true;
    try {
        while (previousActiveCount != mActiveCount) {
         	//改变前没有活跃观察者,改变后活跃观察者数量大于0
            //-> Livedata接下来应该是活跃的
            boolean needToCallActive = previousActiveCount == 0 && mActiveCount > 0;
            //改变前活跃观察者数量大于0,改变后活跃观察者数量小于0
            //-> Livedata接下来应该是不活跃的
            boolean needToCallInactive = previousActiveCount > 0 && mActiveCount == 0;
            //判断结束,保存当前的 活跃观察者数量,以防止出现重入问题
            //如果出现重入问题,那么mActiveCount改变,mChangingActiveState为true,不会新开循环
            //而这里的 previousActiveCount != mActiveCount,那么只会继续 在这个 while循环
            //否则 previousActiveCount == mActiveCount循环结束
            previousActiveCount = mActiveCount;
            //执行回调
            //回调中,可能出现移除/添加Livedata的观察者,这正是重入问题的来源
            if (needToCallActive) {
                //允许自定义时覆写的方法,可以在活跃/不活跃时,考虑获取/释放Livedata的资源
                onActive();
            } else if (needToCallInactive) {
                //注意onInactive无法说明没有观察者,只能说明,
                //Livedata所有观察者都处于不活跃状态(不是STARTED/RESUMED),使得Livedata可以判定为不活跃
                onInactive();
            }
        }
    } finally {
        //结束
        mChangingActiveState = false;
        //防止回调中抛出异常,使得一直陷入死循环
    }
}
总结
避免内存泄漏的方法:是在每个观察者接收到Owner分发的DESTROYED状态后,移除本身的观察。
同时也提供了一套活跃状态级联触发的机制。帮助实现数据分发,以及提供了Livedata活跃状态变更的回调,帮助释放Livedata占用的资源。
LifecycleOwner 的活跃状态:由 LifecycleBoundObserver.shouldBeActive() 判断,基于 LifecycleOwner 是否至少处于 STARTED 状态。用于传入activeStateChanged()。
Observer 的活跃状态:由 ObserverWrapper.mActive 标记,通过 activeStateChanged() 更新,并触发 LiveData 的活跃状态变化。
LiveData 的活跃状态:由 mActiveCount(活跃 Observer 总数)控制,通过 changeActiveCounter() 触发 onActive()/onInactive()。
三者关系:一个Owner 状态 → 多个Observer 状态 → 一个LiveData 状态 的级联触发。
从activeStateChanged/shouldBeActive的源码来看,很容易回答第四个问题:即——
Lifecycle.State.STARTED 与 RESUMED 对 LiveData 的影响差异?
无差异。
当Owner处于 Lifecycle.State.STARTED 或 Lifecycle.State.RESUMED 状态为 (active) 时,观察者才处于活跃状态。当组件退到 STARTED 以下(例如 onStop() 触发,状态变为 CREATED,或者是DESTROYED状态),观察者将无法接收到更新的数据。
所以当 Activity 进入后台,LiveData 的更新不会立即分发,而是等到下一次进入 STARTED/RESUMED 状态。也就是非活跃走到活跃状态。
注意:onInactive能不能判断是否还存在观察者?
这并不意味着没有观察者,可能仍然存在观察者,但它们关联的Owner的生命周期状态不是 Lifecycle.State.STARTED / Lifecycle.State.RESUMED (如返回堆栈中的 Activity)。
如果要判断是否还有观察者,请使用hasObservers()。
粘性数据是什么?
Livedata是如何实现粘性的?
如何避免重复消费(非粘性Livedata的实现)?
粘性数据指当新观察者注册时,LiveData 会立即向其发送最后一次更新的数据,即使该数据是在观察者注册前更新收到的。(注意,对 不希望收到最后一次更新的数据 的叫法,网上之称为数据倒灌)
实际上,这是为了帮助Activity 重建后,能够恢复重建前的UI,去重新观察 LiveData 时,Livedata仍然保存了一份数据,只要一观察Livedata,经过判断就会立即分发数据,所以能够收到重建前的数据。
首先要明确:
- 粘性数据:适合状态(如 UI 状态),需持久化最新值。
- 非粘性数据:事件(如 Toast、导航)应使用其他方案避免重复消费。
避免重复消费/收到粘性数据的方法
事件包装类
用 Event 类包裹数据,标记是否已被处理。
class Event<T>(private val content: T) {
    private var hasBeenHandled = false

    fun getContentIfNotHandled(): T? {
        return if (hasBeenHandled) null else {
            hasBeenHandled = true
            content
        }
    }
}

// ViewModel 中暴露 Event
val eventData = MutableLiveData<Event<String>>()

// 观察侧处理
viewModel.eventData.observe(this) { event ->
    event.getContentIfNotHandled()?.let { data ->
        // 处理数据
    }
}
使用 SingleLiveEvent
这是官方TodoApp给出的做法,自定义 LiveData 实现。
多个观察者可能只有一个能收到数据。
class SingleLiveEvent<T> : MutableLiveData<T>() {
    private val pending = AtomicBoolean(false)

    override fun observe(owner: LifecycleOwner, observer: Observer<in T>) {
        super.observe(owner) { t ->
            if (pending.compareAndSet(true, false)) {
                observer.onChanged(t)
            }
        }
    }

    override fun setValue(value: T) {
        pending.set(true)
        super.setValue(value)
    }
}
广为流传的自定义LiveEvent
与事件包装类思路类似,用一个哨兵变量标记。
一个对数据进行包装,一个对观察者进行包装。
多个观察者都能消费同一个数据。
open class LiveEvent<T> : MediatorLiveData<T>() {

    private val observers = ArraySet<ObserverWrapper<in T>>()

    @MainThread
    override fun observe(owner: LifecycleOwner, observer: Observer<in T>) {
        observers.find { it.observer === observer }?.let { _ -> // existing
            return
        }
        val wrapper = ObserverWrapper(observer)
        observers.add(wrapper)
        super.observe(owner, wrapper)
    }

    @MainThread
    override fun observeForever(observer: Observer<in T>) {
        observers.find { it.observer === observer }?.let { _ -> // existing
            return
        }
        val wrapper = ObserverWrapper(observer)
        observers.add(wrapper)
        super.observeForever(wrapper)
    }

    @MainThread
    override fun removeObserver(observer: Observer<in T>) {
        if (observer is ObserverWrapper && observers.remove(observer)) {
            super.removeObserver(observer)
            return
        }
        val iterator = observers.iterator()
        while (iterator.hasNext()) {
            val wrapper = iterator.next()
            if (wrapper.observer == observer) {
                iterator.remove()
                super.removeObserver(wrapper)
                break
            }
        }
    }

    @MainThread
    override fun setValue(t: T?) {
        //setValue调用说明有新的值
        //设置pending = true,可以消费这个值
        //如果是重建Activity时,由于ObserverWrapper也会重新初始化,pending = false,没有调用setValue
        //那么即使走到onChanged,因为pending = false,也不会分发这次值给观察者
        observers.forEach { it.newValue() }
        super.setValue(t)
    }

    private class ObserverWrapper<T>(val observer: Observer<T>) : Observer<T> {

        //通过pending标志,确保观察者只有在数据更新之后注册的情况下才会收到新的数据,而不会自动收到之前的数据。
        //比如,当Activity重建时,如果LiveEvent之前已经发送了数据,那么当Activity重新观察时,由于Wrapper在注册时pending是false,同时LiveData的版本号较高,会触发onChanged
        //setValue/activeStateChanged->dispatchingValue->considerNotify->onChanged。
        //但此时pending是false,所以不会执行真正的回调。这样就避免了粘性事件的问题。
        private var pending = false

        override fun onChanged(t: T?) {
            if (pending) {
                pending = false
                observer.onChanged(t)
            }
        }

        fun newValue() {
            pending = true
        }
    }
}
使用 Kotlin Flow
用 SharedFlow 或 Channel 替代 LiveData,避免粘性。
这里也各有特点,本篇文章不详细展开。
setValue和postValue的区别及使用场景?
为什么 要在主线程中设置值/LiveData的观察回调在主线程?
为何用 mPendingData 而非直接赋值 mData?
postValue() 的线程切换如何实现?
多次调用会合并吗?
private volatile Object mData;
volatile Object mPendingData = NOT_SET;
//两个都是volatile变量,通过内存屏障保证了有序性、可见性
//mData 用 volatile?保证其他线程getValue能取到最新值。防止指令重排,先赋值完,才允许分发数据。

//设置值。如果有活动的观察者,则值将分派给他们。必须从主线程调用此方法。
@MainThread
protected void setValue(T value) {
    assertMainThread("setValue");
   	//注意版本的更新,只在setValue中更新
    mVersion++;
    mData = value;
    //下面有介绍
    dispatchingValue(null);
}
//posetValue支持在子线程中调用。
//因为其会自动调度到主线程进行值的设置。
//同时使用volatile、synchronized保证不出现数据竞争,比如说多个子线程多次调用postValue(不保证每一个值都能分发)
//如果在主线程 执行已发布的任务之前 多次调用postValue,则只会set最后一个值
//注意!!!如果先调用postValue(a),再调用setValue(b)。
//LiveData观察者先接收到b,再接收到a,是会分发两次的,不重不漏。

protected void postValue(T value) {
    //用于判断是否要发布任务
    //true发布,false不发布
    boolean postTask;
    //这里是 PendingData的写
    synchronized (mDataLock) {
        //在mPostValueRunnable中,会设置mPendingData为NOT_SET
        //这里用mPendingData == NOT_SET判断
        //true说明上一次任务执行完了,来了新数据准备再开任务
        //false是post了新数据,但是任务还没执行
        postTask = mPendingData == NOT_SET;
        mPendingData = value;
    }
    //false说明post了新数据,但是任务还没执行,
    //没必要再开新的任务,节省资源,
    //同时保证数据不出现竞争(启动多个任务更新,可能导致旧的任务最后完成更新,数据错乱)
    //因为mPendingData是volatile变量,只要写入完,任务立马可见
    if (!postTask) {
        return;
    }
    //通过 ArchTaskExecutor 调度到主线程进行值的设置
    //本质上是通过主线程的Handler确保mPostValueRunnable在主线程执行。
    ArchTaskExecutor.getInstance().postToMainThread(mPostValueRunnable);
}

private final Runnable mPostValueRunnable = new Runnable() {
    @SuppressWarnings("unchecked")
    @Override
    public void run() {
        Object newValue;
        //这里是mPendingData的读

        //如果不使用同步代码,容易导致出现数据竞争:
        //在执行任务发布value,其他线程调用postValue修改mPendingData值为X,那么发布的value就会不符合预期
        synchronized (mDataLock) {
            //不在代码块中执行setValue,而只是设置newValue,
            //是因为setValue要执行数据分发,如果分发中观察者的回调想要postValue
            //而这里占有mDatalock锁,那么就会导致死锁。所以使用newValue进行快照中介。
            newValue = mPendingData;

            mPendingData = NOT_SET;
            //只有共享变量的正确赋值,才能保证正确工作
            //算是任务完成,因为已经pending完数据给newValue,设置mPendingData为NOT_SET,
            //synchronized最后通过storeload内存屏障 推送mPendingData,同时释放锁
            //如果此时有其他线程想要争取此锁,那么mPendingData == NOT_SET结果为true,
            //从而可以发布新任务
        }
        setValue((T) newValue);
    }
};
为什么 要在主线程中设置值/LiveData的观察回调在主线程?
看完源码,这个问题的答案已经很明显了。
LiveData 的核心设计是确保观察者在主线程安全地处理数据(例如更新 UI)。若在子线程直接更新值,可能引发线程竞争或 UI 更新异常。postValue 通过内部线程切换机制规避了这一问题。
为什么要用mPendingData而非直接赋值 mData?Why
首先,Livedata需要一个可以子线程更新数据的功能;
那么就要分为setValue、postValue;
postValue最终要用setValue实现,因为Livedata主要是为UI数据服务。
设计成什么样子?What
尽可能减少中间态(连续多次的数据状态,是不必要的,会造成UI过度刷新);
使用中介mPendingData做一个缓冲区的效果,只推送新数据(保证最少次数的推送),也就是延迟推送;
否则多次实时推送,大量Runnable容易造成性能问题,Runnable先后完成的顺序也无法保证。
如何推送?How
使用任务调度到主线程。在局部时间内只开一个任务。
什么时候推送?When
如果mPendingData 没有值->那么不推送,有值->推送。没有值就用NOT_SET来表示。
为什么不直接使用mData?
第一点,因为必须要有一个变量暴露出来,用于存储、分发数据,因为推送不推送、开不开新任务,都要通过NOT_SET的这个状态辅助,mData不可能持有这个状态又有数据。第二点,即使使用KV之类的保证持有状态又有数据,那么如果直接使用mData,那么版本号究竟应该如何更新?
所以,选择使用一个mPendingData中介。
新数据如何判断(什么时候有新数据)/哪里有新数据?Where(局部性的“新”)
我们不能保证判断是否新。但是我们保证知道在哪会有新数据。
postValue中会有新数据。但是我们不知道在局部时间内是否还会调用postValue。
那么就先用任务推送。同时使用锁:
-
如果任务占有了锁,那么直接推送即可,说明没有
postValue在任务之前抢占锁,去发布新值,当前mPendingData自然就是新值:读取mPendingData,写入newValue,设置mPendingData = NOT_SET准备下一次任务;public void run() { Object newValue; //mPendingData的读 synchronized (mDataLock) { newValue = mPendingData; mPendingData = NOT_SET; } setValue((T) newValue); } -
如果
postValue占有了锁,那么任务被阻塞/或者没有任务:判断是否要开任务postTask,写入mPendingData = value,这就是新值(volatile能刷新给任务新值)protected void postValue(T value) { boolean postTask; synchronized (mDataLock) { postTask = mPendingData == NOT_SET; mPendingData = value; } if (!postTask) { return; } ArchTaskExecutor.getInstance().postToMainThread(mPostValueRunnable); }
同时锁+volatile也保证了,在mPendingData推送时,任务不会突然把mPendingData写为NOT_SET;在读取mPendingData时,postValue不会突然把mPendingData写为某个新值。
版本号的作用?
mVersion 的初始值是多少?
版本号确保每次数据更新都被跟踪。
Livedata维护一个版本号,观察者也维护一个版本号。
如果观察者版本号落后于Livedata,那么就会分发数据。
如果观察者版本号大于Livedata,那么就会跳过分发,以免重复数据,消耗额外资源(基本没遇到这种情况)。
static final int START_VERSION = -1;

public LiveData(T value) {
 	mData = value;
 	mVersion = START_VERSION + 1;
}


public LiveData() {
 	mData = NOT_SET;
 	mVersion = START_VERSION;
}

// 初始值不为null,版本号 0
val liveDataWithValue = MutableLiveData("init")

// 初始值为 null,版本号 -1
val liveDataEmpty = MutableLiveData<String>()
liveDataEmpty.value = "data" // 版本号变为 0
dispatchingValue() 方法中 initiator 参数的作用?
具体的数据分发流程?
分发数据时是如何保证不重复分发?
(注意:不重复不是指两次同一个值就不分发)
observe -> onStateChanged -> activeStateChanged -> dispatchingValue -> considerNotify
observeForever -> activeStateChanged -> dispatchingValue -> considerNotify
activeStateChanged -> changingActiveCounter
void dispatchingValue(@Nullable ObserverWrapper initiator) {
    //mDispatchingValue为true说明重入了。
    //如果在分发数据的回调OnChange中,改变了Owenr状态或者添加了observer
    //就说明之前的分发无效,用mDispatchInvalidated做标识
    //提醒调用栈下的(或者说父dispatchingValue),需要重新分发
    //然后return,没必要再开一个循环,否则容易出现死循环
    if (mDispatchingValue) {
        mDispatchInvalidated = true;
        return;
    }
    //用于处理重入的flag,表明已经有一个分发数据的任务了
    mDispatchingValue = true;
    do {
        //保证如果没有重入,循环就会结束
        mDispatchInvalidated = false;
 		//调用dispatchingValue传入的就两个值,一个this,一个null
        //this说明只用把数据分发给传入的观察者就好
        //null说明数据需要分发给全体观察者
        if (initiator != null) {
            considerNotify(initiator);
            initiator = null;
        } else {
            for (Iterator<Map.Entry<Observer<? super T>, ObserverWrapper>> iterator =
                 	//使用iteratorWithAdditions迭代器,保证在回调中添加新的Observer也能接收到新的数据分发
                    mObservers.iteratorWithAdditions(); iterator.hasNext(); ) {
                considerNotify(iterator.next().getValue());
                if (mDispatchInvalidated) {
                    break;
                }
            }
        }
        //之前的分发无效,继续循环
    } while (mDispatchInvalidated);
    mDispatchingValue = false;
}

//负责判断是否触发观察者的 onChanged 回调。此时需要确保:
//观察者处于活跃状态(如 STARTED 或 RESUMED 的 Activity/Fragment)。
//数据版本号(mVersion)比观察者记录的版本号(observer.mLastVersion)更高,避免重复通知。
private void considerNotify(ObserverWrapper observer) {
    //如果是setValue触发的数据分发给所有观察者
    //那么可能有一部分观察Livedata的观察者是不活跃的(Livedata可能是全局共享的),跳过
    if (!observer.mActive) {
        return;
    }

    //由于 Lifecycle 有可能状态值 State 已经切换到了非活跃状态,但 LifecycleBoundObserver 还未收到通知
    //所以为了避免意外情况,此处主动检查Observer的Owner的活跃状态并判断是否需要更新其活跃状态
    //(注意AlwaysActiveObserver#shouldBeActive() 总是返回true)
    if (!observer.shouldBeActive()) {
        //说明Owner不活跃,把Observer设置为不活跃先
        observer.activeStateChanged(false);
        return;
    }
    //现在我们假设已经分发过一次,Livedata版本为1,使得观察者版本为1
    //现在Owner进入非活跃,又再次活跃
    //那么就会触发activeStateChanged -> dispatchingValue(this) -> considerNotify,所以需要判断>=,
    //确保了同一个数据不会被重复发送给同一个观察者,从而减少了不必要的 UI 刷新或其他处理逻辑。
    //如果判断!=的话,observer.mLastVersion < mVersion需要更新这种情况,也会跳过,使得分发不到新数据。
    if (observer.mLastVersion >= mVersion) {
        return;
    }
    //更新观察者的版本号为Livedata的
    //(注意如果想要用Livedata实现事件总线,建议不要从版本号下手)
    observer.mLastVersion = mVersion;
    //数据分发回调
    observer.mObserver.onChanged((T) mData);
}
调用dispatchingValue传入的就两个值,一个this,一个null:
this说明只用把数据分发给传入的观察者就好;
null说明数据需要分发给全体观察者。
自定义LiveData需要重写哪些方法?
一般会选择重写,onActive()/onInactive()。
否则,直接使用MutableLivedata即可。
onActive()
- 触发时机:当
LiveData首次有活跃的观察者(例如Activity/Fragment处于STARTED或RESUMED状态)时调用。 - 作用:在此方法中注册数据源的监听(如网络请求、传感器、数据库监听等),开始获取数据。
onInactive()
- 触发时机:当
LiveData最后一个活跃的观察者变为非活跃状态时调用。 - 作用:在此方法中释放资源或停止监听,避免内存泄漏或无效更新。
举例:
class LocationLiveData(context: Context) : LiveData<Location>() {
    private val locationManager = context.getSystemService(LOCATION_SERVICE) as LocationManager
    private val listener = LocationListener { location ->
        value = location // 位置变化时更新数据
    }

    override fun onActive() {
        super.onActive()
        // 有活跃观察者时开始监听
        locationManager.requestLocationUpdates(
            LocationManager.GPS_PROVIDER,
            0L,
            0f,
            listener
        )
    }

    override fun onInactive() {
        super.onInactive()
        // 无活跃观察者时停止监听
        locationManager.removeUpdates(listener)
    }
}
MediatorLiveData 的使用场景/如何合并多个Livedata?
为什么MediatorLiveData内部类Source与Livedata对版本号检查的逻辑不同?
//MutableLiveData仅仅是public了 set、postValue,其他相对于Livedata不变。
//具体应用比如:联网状态 + 本地缓存 -> UI 显示
public class MediatorLiveData<T> extends MutableLiveData<T> {
    private SafeIterableMap<LiveData<?>, Source<?>> mSources = new SafeIterableMap<>();

    public MediatorLiveData() {
        super();
    }

    public MediatorLiveData(T value) {
        super(value);
    }

	//注意:addSource 不限制源的数据类型
    @MainThread
    public <S> void addSource(@NonNull LiveData<S> source, @NonNull Observer<? super S> onChanged) {
        if (source == null) {
            throw new NullPointerException("source cannot be null");
        }
        //可以理解为,传入的onChanged:Observer是一个转换器,source数据分发后
        //onChanged把数据进行一次map变换,或者是满足某个条件后截断/更换其他数据源
        //此时只需要再observe MediatorLiveData,即可获得符合要求的数据

        //给传入的onChanged:Observer进行包装,绑定对应的source
        Source<S> e = new Source<>(source, onChanged);
        Source<?> existing = mSources.putIfAbsent(source, e);
        //如果给定的 LiveData 已添加为源,但传入不同的 Observer,会抛出异常。
        //也就是认为onChanged对source的转化只需要一次/只需要一个转换器即可,以免浪费资源。

        //MediatorLivedata可以添加多个源Livedata,多个源Livedata可以有同一个Observer
        //也就是认为多个数据源,可能都要一个转换器就能处理。
        //也就是一个源对一个转化器,一个转换器对多个源。
        if (existing != null && existing.mObserver != onChanged) {
            throw new IllegalArgumentException(
                    "This source was already added with the different observer");
        }
        if (existing != null) {
            return;
        }
        //如果MediatorLivedata有活跃观察者(调用了observe/observeForver分发添加的观察者,而不是addSource),那么启动转化器onChanged对源Livedata进行观察。
        if (hasActiveObservers()) {
            e.plug();
        }
    }

	//截断数据源Livedata,同时停止 转化器 对源LiveData进行观察
    @MainThread
    public <S> void removeSource(@NonNull LiveData<S> toRemote) {
        Source<?> source = mSources.remove(toRemote);
        if (source != null) {
            source.unplug();
        }
    }

    @CallSuper
    @Override
    protected void onActive() {
        //当 MediatorLiveData 变为活跃状态时,启动转化器 对 对应的源Livedata进行观察
        for (Map.Entry<LiveData<?>, Source<?>> source : mSources) {
            source.getValue().plug();
        }
    }

    @CallSuper
    @Override
    protected void onInactive() {
        //当 MediatorLiveData 变为非活跃状态时,停止转化器对 对应的源Livedata进行观察
        //这里重写onInactive()的关键在于,Source观察数据源使用的observeForever
        //所以必须手动释放资源
        for (Map.Entry<LiveData<?>, Source<?>> source : mSources) {
            source.getValue().unplug();
        }
    }

    //注意:Source本质也是一个观察者,具有onChanged回调
    private static class Source<V> implements Observer<V> {
        final LiveData<V> mLiveData;
        //维护的这个mObserver就是转换器
        final Observer<? super V> mObserver;
        //注意这里维护了一个版本号
        int mVersion = START_VERSION;

        Source(LiveData<V> liveData, final Observer<? super V> observer) {
            mLiveData = liveData;
            mObserver = observer;
        }

        //由于本身本质也是一个观察者,所以可以观察数据源Livedata
        //使用observeForever,是希望监听数据源不受到Owner的生命周期影响,
        //所有数据都能监听,只有不被需要时才不会监听
        //同时也可以确保仅当自身活跃时才监听源数据,与外部组件的生命周期解耦。
        void plug() {
            mLiveData.observeForever(this);
        }

        void unplug() {
            mLiveData.removeObserver(this);
        }

        @Override
        public void onChanged(@Nullable V v) {
            //当数据源 LiveData 分发数据时,检查版本号
            //Source起到了一个Adapter的作用,使得用户不用关心数据源的状态
            //只要观察MediatorLivedata即可得到符合要求的数据。

            //与Livedata判断版本号的逻辑不同,Livedata判断是<时需要回调;Source判断是不等于就要回调。
            //这有什么区别?我认为没有区别。因为版本号是严格递增的,
            //如果不一样就一定说明观察者版本号 一定小于 Livedata。
            //以及观察者版本号 > Livedata版本号这种事情不可能发生,除非反射或自定义
            if (mVersion != mLiveData.getVersion()) {
                mVersion = mLiveData.getVersion();
                //转发给包装的转换器mObserver
                mObserver.onChanged(v);
            }
        }
    }
}
Transformations#map 和 switchMap 的区别?底层如何实现?
//this Livedata<X> -> MediatorLivedata<Y> -> Y
fun <X, Y> LiveData<X>.map(
    //transform是一个函数,把X类型转化为Y类型
    transform: (@JvmSuppressWildcards X) -> (@JvmSuppressWildcards Y)
): LiveData<Y> {
    //注意这里使用了MeidatorLivedata完成,算是对MeidatorLivedata的包装
    //如果this Livedata有值,那么先进行transform,响应初始态
    val result = if (isInitialized) {
        MediatorLiveData(transform(value as X))
    } else {
        MediatorLiveData()
    }
    //监听this Livedata,把Livedata<X>的新数据X转化为Y
    //map函数返回的是Livedata<Y>,也就是MediatorLivedata<Y>
    //(result.value =..., 这里调用了setValue,进行分发数据Y)
    result.addSource(this) { x -> result.value = transform(x) }
    return result
}

//this Livedata<X> -> old switch to new Livedata<Y> -> MediatorLivedata<Y> -> Y
fun <X, Y> LiveData<X>.switchMap(
    //transform是一个函数,把X类型转化为Livedata<Y>类型
    transform: (@JvmSuppressWildcards X) -> (@JvmSuppressWildcards LiveData<Y>)?
): LiveData<Y> {
    //这里liveData虽然是一个局部变量,但是后续被result.addSource闭包使用
    //从而升级,与MediatorLivedata的生命周期相同
    //相对于缓存了每一次新的数据源
    var liveData: LiveData<Y>? = null
    //如果this Livedata<X>有值value
    val result = if (isInitialized) {
        //那么先进行transform 变成新的Livedata<Y>,响应初始态
        //这里使用了泛型所以需要value as X
        val initialLiveData = transform(value as X)
        //transform后,判断转化结果是否为无效值
        if (initialLiveData != null && initialLiveData.isInitialized) {
            MediatorLiveData<Y>(initialLiveData.value)
        } else {
            //可能是this Livedata<X>的值是无效的,比如用户输入空格字符" "
            //或者转化出现问题
            MediatorLiveData<Y>()
        }
    } else {
        MediatorLiveData<Y>()
    }
    result.addSource(this) { value: X ->
        //MediatorLivedata作为中介,使用这个匿名类onChanged:Observer转化器
        //中介观察this Livedata来了新值value,也就是源值变化
        //那么把新值转发给转化器,进行transform
        val newLiveData = transform(value)
        //如果转化结果与上一次没有差异,就没有必要往下走,直接返回,节省资源
        if (liveData !== newLiveData) {
            //有新的livedata了,如果旧livedata不为null,移除旧livedata作为数据源
            if (liveData != null) {
                result.removeSource(liveData!!)
            }
            liveData = newLiveData
            //允许 transform 返回 null,也就是可能this Livedata是无效的
            //比如用户输入空格字符" "
            if (liveData != null) {
                //进行监听新的 LiveData,如果有新的值,那么转发到结果 MediatorLiveData
                //与map不同的是,map监听的始终是this Livedata,而switchMap是可以切换数据源的
                //setValue分发新的数据Y
                //这里 { y -> result.setValue(y) } 是转化器,也就是onChanged:Observer
                result.addSource(liveData!!) { y -> result.setValue(y) }
                //在addSource中addSource
                //这两次的Livedata<Y>, Y数据类型不一致
                //转化器也不一致
                //可以认为MediatorLivedata实际上 是工具类
            }
        }
    }
    //本质上返回的是 MediatorLivedata,这就是最终的Livedata<Y>
    return result
}
总结一下:
| 方法 | map | switchMap |
|---|---|---|
| 返回值类型 | LiveData |
LiveData |
| 数据源管理 | 永久监听同一源 | 动态切换监听源 |
| 内存管理 | 始终持有源 LiveData 的监听 | 自动清理旧源监听 |
| 适用场景 | 简单数据类型转换(如字符串处理) | 数据源需要动态变化(如搜索关键词) |
| 执行次数 | 每次源变化都执行转换 | 仅当产生新 LiveData 时执行转换 |
例子
// ViewModel 中定义
class UserViewModel : ViewModel() {
    private val _userLiveData = MutableLiveData<User>()
    val userDescription: LiveData<String> =
        Transformations.map(_userLiveData) { user ->
            "${user.name} 的年龄是 ${user.age} 岁" // 直接转换
        }

    fun updateUser(user: User) {
        _userLiveData.value = user
    }
}

// Activity/Fragment 中观察
userViewModel.userDescription.observe(viewLifecycleOwner) { description ->
    textView.text = description
}

// ViewModel 中定义
class UserDetailViewModel : ViewModel() {
    private val _userIdLiveData = MutableLiveData<String>()
    val userDetail: LiveData<UserDetail> =
        Transformations.switchMap(_userIdLiveData) { userId ->
            repository.loadUserDetail(userId) // 返回新的 LiveData
        }

    fun setUserId(userId: String) {
        _userIdLiveData.value = userId
    }
}

// Repository 中定义
class UserRepository {
    fun loadUserDetail(userId: String): LiveData<UserDetail> {
        // 模拟从网络或数据库获取数据
        val result = MutableLiveData<UserDetail>()
        viewModelScope.launch {
            val detail = apiService.fetchUserDetail(userId)
            result.postValue(detail)
        }
        return result
    }
}
Transformations#distinctUntilChanged是如何实现防抖的?
//创建一个新的[LiveData]对象,仅在源LiveData(this)的值发生变化时发射值。
@JvmName("distinctUntilChanged")
@MainThread
@CheckResult
fun <X> LiveData<X>.distinctUntilChanged(): LiveData<X> {
    //强制发射第一次的值
    var firstTime = true
    //检查this LiveData是否有初始值,有初始值,如果观察了那么就会发送一次(Livedata特性:粘性数据)
    //设置firstTime = false,防止后续如果还是这个值,从而造成的重复发送
    val outputLiveData = if (isInitialized) {
        firstTime = false
        MediatorLiveData<X>(value)
    } else {
        MediatorLiveData<X>()
    }
    //使用MediatorLivedata监听this Livedata
    outputLiveData.addSource(this) { value ->
        //这里是匿名类 转换器 onChanged:Observer
        //this Livedata分发新值,先保存上一次的值
        val previousValue = outputLiveData.value
            //第一次赋值过来,直接发送
        if (firstTime ||
            //前一次没有值/或者置空,新发的值不为空;发送该值
            previousValue == null && value != null ||
            //前一次有值,而且不等于新发的值:发送该值
            previousValue != null && previousValue != value
        ) {
            //直接设置为false,保证后续不会强制发送值
            //只有满足以上三种情况,才会发送
            firstTime = false
            //MediatorLivedata setValue分发新值
            outputLiveData.value = value
        }
    }
    return outputLiveData
}
ComputableLiveData是什么?有什么作用?
ComputableLiveData 提供了一种更加安全地执行耗时任务的思路,其特点是:以 LiveData 作为中介,分发任务执行结果,从而实现带有生命周期的、响应式的触发耗时任务。
//能够在有活跃观察者时被无效化并重新计算值。
//通过调用 [invalidate] 方法使其无效,若有活跃观察者则触发 [compute] 方法重新计算。
@RestrictTo(RestrictTo.Scope.LIBRARY_GROUP_PREFIX)
abstract class ComputableLiveData<T> @JvmOverloads
constructor(
    //默认实现的线程池
    //也可以自己传入
    internal val executor: Executor = ArchTaskExecutor.getIOThreadExecutor()
) {
	//内部管理的LiveData实例,重写onActive方法以在有观察者时触发计算
    //refreshRunnable最终调用compute方法
    private val _liveData: LiveData<T?> =
        object : LiveData<T?>() {
            //当Livedata的观察者数量从 0 到 1 时触发,其他情况不触发
            override fun onActive() {
                // 在指定执行器上启动计算任务
                executor.execute(refreshRunnable)
            }
    }
    /**
     * The LiveData managed by this class.
     */
    open val liveData: LiveData<T?> = _liveData
    //标记当前数据是否无效(需要重新计算)
    internal val invalid = AtomicBoolean(true)
    //标记当前是否正在计算中(防止并发计算),用AtomicBoolean实现锁的效果(CAS机制)
    internal val computing = AtomicBoolean(false)

    @JvmField
    @VisibleForTesting
    //在后台持续执行的Runnable
    internal val refreshRunnable = Runnable {
        var computed: Boolean // 标记是否执行过一次计算
        //do-while 保证无论如何先执行一次
        do {
            //说明没有计算过
            computed = false
            //计算只能在 1 个线程中发生,但没有必要用锁。
            //将computing从false→true
            if (computing.compareAndSet(false, true)) {
                try {
                    var value: T? = null
                    //只要invalid为true,在这里阻塞循环,直到没有invalid为true的通知
                    //invalid如果不等于期望值(这里是true),CAS返回false
                    //CAS返回false,也就是invalid为false,那么就不会执行计算
                    //(其他线程处理完invalid执行计算后,置invalid为false,当前线程抢占锁,同时又没有invalid为true通知)
                    while (invalid.compareAndSet(true, false)) {
                        computed = true
                        value = compute()
                    }
                    if (computed) {
                        //走到这里说明,执行过计算 和 没有invalid为true的通知,那么进行分发
                        //注意,可能在post中又来了invalid为true的通知,所以外面有一个循环while
                        liveData.postValue(value)
                    }
                } finally {
                    //释放computing lock,使得其他线程可以抢占锁
                    //其他线程一看computing为false,那么可以尝试执行compute方法了
                    //computing设置为false
                    computing.set(false)
                }
            }
          //如果计算过一次,同时数据失效,那么再循环一次
          //为什么需要判断computed?computed为false说明本次循环未执行计算;
          //比如,当computing 被其他线程占用,computed为false,此时会跳过计算
          //加入对computed判断的原因是:
          //1、防止没有抢占到computing锁的,持续自旋,造成资源浪费(大家都订阅一个生产者,新数据来了都能收到,没有必要自旋)
          //2、请求合并:在完成一次计算后(computed = true),主动检查是否仍有新的无效化请求(invalid = true);
          //如果有,则立即继续循环处理,无需重新提交任务到Runnable,实现了请求合并,减少计算次数。
        } while (computed && invalid.get())
    }

    //使 LiveData 失效。当有活跃的观察者时,这将触发对 [compute] 的调用。
   	//在主线程执行
    open fun invalidate() {
        ArchTaskExecutor.getInstance().executeOnMainThread(invalidationRunnable)
    }

    //只在主线程触发 executeOnMainThread
    @JvmField
    @VisibleForTesting
    internal val invalidationRunnable = Runnable {
        // 检查是否有活跃观察者
        val isActive = liveData.hasActiveObservers()
        // CAS操作将invalid从false→true,若成功且存在活跃观察者,则触发计算
        if (invalid.compareAndSet(false, true)) {
            if (isActive) {
                //最终触发compute()
                executor.execute(refreshRunnable)
            }
        }
    }

   	//自己实现的耗时任务
    @WorkerThread
    protected abstract fun compute(): T
}
LiveData如何与ViewModel配合?为什么推荐在 ViewModel 中持有 LiveData?
见Viewmodel源码阅读篇
补充
请注意,如果使用的LiveData有关于UI,请不要选择 Fragment 作为 LiveData 的 Owner,LiveData虽然会在DESTROYED状态解绑,但是Fragment#View的生命周期是比Fragment短的。
1.当 Fragment 的 View 被销毁(onDestroyView() 已调用),但 Fragment 实例仍存活时,LiveData 的观察者未被自动移除。此时如果 LiveData 更新数据,回调中尝试操作已销毁的 View,会引发崩溃。
2.当使用FragmentManager#replace 的页面跳转,如果 Framgent 实例被复用,也就是并没有发生 onDestroy, 但是 Fragment的 View 会重建,导致重新 onCreateView, 这使得 Observer 在onCreateView会被 add 两次,而没有 remove 旧的 Observer 。导致同一回调会执行两次,可能出现数据异常或者资源浪费。
解决办法就是,使用Fragment#View作为Owner,也就是ViewLifecycleOwner。
不过,从当前最佳实践来看,也请不要 使用 Fragment#View 作为 Owner。LiveData 应该只被ViewModel持有,而非UI。
UI的职责是只应该订阅Data的状态是否发生变化,从而更新UI。
总结经验
- 解耦与感知:UI与数据解耦,自动生命周期管理。
- 线程安全:封装线程切换细节。
- 粘性事件:版本号机制确保数据同步。
- 可扩展性:通过
MediatorLiveData组合多个数据源。
设计哲学迁移
- 生命周期解耦: 任何框架可引入类似观察者包装机制(如 Web 路由监听 + 页面状态)。
- 数据版本控制: 在状态管理中避免重复触发(如 Redux 的 action 序列号)。
- 线程安全透明化: 封装底层线程切换(如 Kotlin 协程
withContext)。
参考
https://github.com/leavesCZY/AndroidGuide/blob/master/从源码看 Jetpack(3)LiveData 源码详解.md
- 发现问题
- 解决思路
- 解决方案(核心源码)
- 源码流程图(关键流程)
- 注意
observe()与observeForever()区别?何时需手动移除观察者?- 新观察者如何收到数据?
- LiveData 如何避免内存泄漏?
- LifecycleBoundObserver 的作用是什么?
- LifecycleOwner状态是如何影响数据分发的?
Lifecycle.State.STARTED与RESUMED对 LiveData 的影响差异?- onInactive能不能判断是否还存在观察者?
- 粘性数据是什么?
- Livedata是如何实现粘性的?
- 如何避免重复消费(非粘性Livedata的实现)?
- setValue和postValue的区别及使用场景?
- 为什么 要在主线程中设置值/LiveData的观察回调在主线程?
- 为何用
mPendingData而非直接赋值mData? - postValue() 的线程切换如何实现?
- 多次调用会合并吗?
- 版本号的作用?
- mVersion 的初始值是多少?
- dispatchingValue() 方法中
initiator参数的作用? - 具体的数据分发流程?
- 分发数据时是如何保证不重复分发?
- 自定义LiveData需要重写哪些方法?
- MediatorLiveData 的使用场景/如何合并多个Livedata?
- 为什么MediatorLiveData内部类Source与Livedata对版本号检查的逻辑不同?
- Transformations#map 和 switchMap 的区别?底层如何实现?
- Transformations#distinctUntilChanged是如何实现防抖的?
- ComputableLiveData是什么?有什么作用?
- LiveData如何与ViewModel配合?为什么推荐在 ViewModel 中持有 LiveData?
- 补充
- 总结经验
- 设计哲学迁移
- 参考