
Android Binder 笔记
https://android.googlesource.com/kernel/common/+/refs/heads/android-mainline/drivers/android
C/C++ 语法
柔性数组
柔性数组Flexible Array Member,是 C99 标准引入的一种特殊语法,用于在结构体的末尾声明一个长度未知的数组,目的是优化内存分配和管理,一般用于处理通信协议附带的可变长度数据。
比如:
// old version code: service_manager.c
struct svcinfo
{
    struct svcinfo *next;
	//...
    size_t len; //必须,因为name_len获取需要成本,减少成本,直接记录即可
    /* 柔性数组: 存放实际的服务名称 */
    uint16_t name[0];
};

struct binder_buffer {
    struct list_head entry;
    //...
    size_t data_size;       // 数据区大小,由发送方传递
    size_t offsets_size;    // 偏移数组大小,由发送方传递
    /* 柔性数组:存放实际的事务数据和偏移数组 */
    uint8_t data[0];
};
传统做法是:使用指针处理,可变长度的数据
// 方法1:使用指针处理
struct Packet {
    //other data
    size_t len;
    char *payload; // 指向另一块内存
};

size_t payload_size = xxx; //通信发送方传来的长度
// 创建一个包
struct Packet *p = malloc(sizeof(struct Packet));
p->len = payload_size;
p->payload = malloc(p->len); // 第二次分配!
memcpy(p->payload, actual_data, p->len)

//或者 方法2:指针处理+手动偏移 一次分配
//struct Packet *p = malloc(sizeof(struct Packet) + payload_size);
//p->payload = (char*)(p + 1) //手动移动指针

// 销毁时
free(p->payload); // 必须先释放payload
free(p);          // 再释放结构体
先分配结构体的内存空间,再为字符串分配内存。
两次分配内存不一定连续,对CPU不友好,效率低。
柔性数组是:
struct Packet {
    size_t len; //必须,因为payload_size获取需要成本,减少成本,直接记录即可
    char payload[]; // 不是指针,是柔性数组!
};

size_t payload_size = ...;
//一次分配
struct Packet *p = malloc(sizeof(struct Packet) + payload_size);
// p->payload 自动地、隐式地 指向了结构体之后的内存!
// 无需任何手动指针赋值!
p->len = payload_size;
memcpy(p->payload, actual_data, payload_size);
//一次释放
free(p);
len字段在编译规则上不是必要,但是很重要而且获取有成本,需要记录。其能够提供 “自描述性(Self-descriptiveness)”:
- 描述内容:它描述了其后柔性数组中有效数据的量(字节数、元素个数等)。
- 解耦:它使得处理该结构体的代码无需依赖外部信息或约定(如以
\0结尾)就能正确地解析和使用数据。结构体自身就包含了理解其内容所需的全部元数据。 - 安全:它是进行边界检查、防止缓冲区溢出等安全漏洞的第一道防线。
模版
C++ 模板 = 编译期的泛型 + 代码生成器。让算法/数据结构与类型解耦,既灵活又高效,允许你编写与具体类型无关的通用代码。
模版需要在.cpp使用前,进行完整的实现,最佳实践姿态是在.h中实现。
不能像普通函数、类那样:先只声明在头文件,具体实现藏在某个 .cpp 里等链接。
**因为模板是在编译期实例化生成代码的,不是链接期。**编译器在编译期时,会为每一个使用模板的函数、类专门生成一份代码。
比如说,libbinder中BnInterface、BpInterface继承INTERFACE模版类(先简单把INTERFACE理解为一个泛型I)。
由于宏(预处理器指令,它可以让我们在编译之前进行简单的文本替换,生成特定代码)内有类型转化,这个泛型I 必须 extend IInterface。
如果我创建一个类 IMyService 继承 IInterface,调用INTERFACE模版类的宏:DECLARE_META_INTERFACE 和 IMPLEMENT_META_INTERFACE ,声明具体的业务虚方法。
编译器在编译期就会帮我实现一份专门类型IMyService的代码。(不同于Java的泛型机制,其是运行时)
此时再创建一个类BnMyService 继承 BnInterface<IMyService>,即指定INTERFACE为IMyService类。那么编译时自动生成的IMyService、BnInterface<IMyService>代码就可以为 BnMyService 所用,从而减少了模版代码的编写。
Binder
Binder Diver (Native)
介绍
Binder驱动是Android专用的 IPC 驱动,但实现方式和Linux驱动一样。Binder驱动以misc设备注册在Linux 作为虚拟字符设备,没有直接操作硬件,而是通过 内核内存管理方法与队列机制 实现进程间通信。
初始化、驱动如何开启工作
Binder 驱动利用 initcall 机制,将它的初始化函数 binder_init() 添加到 initcall 队列中。当内核启动时,binder_init() 函数就会被执行,从而完成 Binder 驱动的初始化。
binder_init() 主要工作是:
-
注册
binder设备:调用misc_register(),向虚拟文件系统(VFS)注册一个名为 "binder" 的 misc 设备,并绑定其file_operations(如binder_open、binder_ioctl、binder_mmap等)。static const struct file_operations binder_fops = { .owner = THIS_MODULE, .poll = binder_poll, .unlocked_ioctl = binder_ioctl, .compat_ioctl = binder_ioctl,//IO 控制函数 .mmap = binder_mmap,// 内存映射函数 .open = binder_open,//binder 文件打开函数 .flush = binder_flush, .release = binder_release, }; -
注册
binder文件系统(binderfs):调用register_filesystem(),注册 binderfs 到虚拟文件系统,binderfs 会在 init 进程阶段(Android启动)被挂载,用于 创建和管理 Binder 相关设备节点。
当用户进程调用 open("/dev/binder") 时:
- 用户态
open()触发系统调用sys_openat,进入 VFS 打开流程 - VFS 进行路径解析,识别
/dev/binder为一个 字符设备 inode,创建struct file - VFS 通过
chrdev_open / misc_open(inode设备号)定位到 Binder 驱动注册的file_operations - 设置
file->f_op = binder_fops,并调用其open,进入驱动方法binder_open() - 在
binder_open()中为当前进程创建binder_proc进程上下文,并绑定到file->private_data open()返回文件描述符 fd,fd 与struct file关联
此后,用户进程即可通过该 fd 执行 ioctl、mmap 等方法与 Binder 驱动交互,实现跨进程通信。
mmap(fd, ...)
ioctl(fd, BINDER_WRITE_READ, ...)
假定一个场景:App 调用系统服务获取电池电量,用于理解结构体。
int level = batteryService.getBatteryLevel(参数);
App 进程(Client)向 SystemServer 进程中的 BatteryService(Server)发起一次 Binder IPC。
结构体
struct binder_proc —— 每个进程的 Binder 上下文
Binder 为**每个加入 Binder 世界的 进程 **都建立一个“代表”。
你可以把 binder_proc(process) 理解为“一个进程在 Binder 世界里的根容器”,所有属于此进程的 Binder 信息都存放在这里。
用户进程有一个 binder_proc,服务进程也有一个 binder_proc。
**每当一个 Android 应用或系统进程第一次调用 open("/dev/binder") 访问 Binder 驱动时,内核就会为它创建一个 binder_proc 结构体,用来记录这个进程所有和 Binder 相关的状态。**该结构体被加入全局链表 binder_procs,以便驱动全局管理。
在此例子中
| 角色 | 结构体 | 说明 |
|---|---|---|
| App 进程(Client) | binder_proc A | 存放自己持有的 binder 对象引用、待处理事务、buffer 等 |
| SystemServer(Server) | binder_proc B | 包含 BatteryService 在 Binder 世界里的真正实体对象binder_node |
struct binder_thread —— 每个线程的通信上下文
为每个执行 ioctl(fd,BINDER_WRITE_READ) 的线程创建的通信上下文,用于记录调用栈、待办任务和线程状态。
线程是负责:
- 发送事务(client 线程)
- 从 todo 队列取事务(transaction)并执行(server 线程)
在此例子中:
客户端:App main thread 或 Binder proxy 调用线程 → binder_thread A1
服务端:SystemServer 中 在 Binder 线程池中的线程 → binder_thread B1
struct binder_node —— Server对象在驱动中的唯一实体
你看到的每个系统服务(如 BatteryService)都有一个对应的 AIDL。
AIDL 编译器生成两个关键类:
| 生成物 | 所处进程/位置 | 作用 |
|---|---|---|
| Stub | 服务端(SystemServer) | binder_node的实际注册者(extends Binder) |
| Proxy | 客户端(App) | 代理,将 “handle + 参数数据” 提交给Binder驱动,驱动再转发给 Stub |
BatteryService 对应的 Binder 对象(Stub),当进程把这个对象第一次注册进 Binder 驱动时,驱动为它创建:
binder_node(Server对象在驱动中的唯一实体)
代表“这个对象真正长什么样,它真正属于哪个进程”。
注意:binder_node 在它所属的进程(Server )中创建,挂在其struct binder_proc下;
一个 Server 进程可能同时提供 多个不同的 Binder 服务对象。例如:
ActivityManagerService对象(ptr = 0x1000)PackageManagerService对象(ptr = 0x2000)
当 Server 的 Binder 线程调用 ioctl(fd, BINDER_WRITE_READ) 读取数据时,Server会从驱动获取到 ptr 和 cookie,然后Server判断需要调用哪个服务对象来提供服务。
struct binder_ref —— 对远程服务对象的引用
客户端(Client)看到的是 binder_ref(引用),而不是 binder_node 本身。
binder_ref(指向服务端 binder_node 的引用)
引用中记录:
- 指向真实 binder_node
- 分配给
Client的 handle(如 handle=3)
所以Client看到的是一个计数器 handle,而驱动内部通过 binder_ref 再找到 binder_node。
Java 层的 IBinder 代理对象底层就是 handle。
struct binder_buffer —— 存放一次事务的数据
当客户端要调用:
getBatteryLevel(参数)
需要把参数序列化(Parcel)写进buffer,这个buffer就是事务buffer。
Binder 驱动为每个进程 mmap 一片连续的虚拟地址区域,binder_buffer 就位于这片区域内。
**binder_mmap() 中会创建一个初始的 binder_buffer**并放入当前binder_proc的proc->buffers链表,但它 只是代表整个 mmap 区域的“空闲块”,不是事务 buffer。
真正的事务用的 binder_buffer 是在 binder_transaction() 中通过 binder_alloc_new_buf 动态分配的。
binder_buffer 是header+data的结构,header字段们描述当前还剩多少空间、事务数据大小;data[0]是实际上存放事务的数据的位置,空闲的空间用于后续继续分割创建新binder_buffer。
包括:
- *transaction:指向该缓冲区关联的 binder_transaction 事务上下文
- *target_node:指向需要使用该缓冲区的 binder_node 提供实际服务的Server对象实体
- data_size:事务数据的总大小。
- offsets_size:存放了几组对象
- data[0]:实际事务数据起始地址(存放data+offset数组)
| 项目 | Request | Reply |
|---|---|---|
| 发起方 | Client | Server |
| 接收方 | Server | Client |
binder_transaction |
1 个 | 1 个(另一个) |
binder_buffer |
挂在 Server 的 proc上,分配在Server内核虚拟空间中 |
挂在 Client 的 proc上,分配在Client内核虚拟空间中 |
| 物理页 | Server 的内核、用户mmap区对应的物理页 | Client 的内核、用户 mmap区 对应的物理页 |
因为 在单次事务(request 或 reply)内部,Client/Server 共享同一物理页:
- 比如 request:Client 数据 → 拷贝到 Server 的 buffer 对应的物理页 → Server 直接读;
- 这个过程中,没有第二次拷贝,所以叫“一次拷贝”。
但 request 和 reply 是两个方向的独立事务,各自有自己的接收方,因此:
- 两个 buffer
- 两块物理内存
- 两次
copy_from_user(一次 request,一次 reply)
struct binder_transaction —— 一次事务的完整上下文
binder_transaction方法,会构造事务上下文结构体binder_transaction包含:
- 发送端线程(from= binder_thread A1)
- 接收端进程、接收端线程(to_proc = binder_thread B,to_thread = 指定或空)
- 使用哪个 buffer(binder_buffer X)
- 事务码(code,AIDL 定义的方法编号,例如 TRANSACTION_getBatteryLevel)
新结构体 struct binder_alloc —— 进程的mmap区管理器
在 binder_proc 内嵌一个 binder_alloc 。 binder_alloc 是 Binder 驱动 为“每个进程”维护的一个专用内存管理器 struct binder_alloc,负责管理该进程 mmap 出来的 Binder 共享缓冲区中所有 buffer 的分配、回收和页映射。它是新版本 Binder 内存模型的核心,不再使用 user offset,而是转向“页级管理 + 懒映射”模型的核心数据结构。
struct binder_proc {
    ...
    struct binder_alloc alloc;
    ...
};
其结构体
struct binder_alloc {
    struct mutex mutex;

    unsigned long vm_start;     // 用户态 mmap 起始地址
    size_t buffer_size;        // mmap 总大小

    struct page **pages;       // 每一页对应的 struct page*
    struct mm_struct *mm;

    struct list_head buffers;  // 所有 binder_buffer 链表
    struct rb_root free_buffers; // 空闲 buffer 红黑树

    size_t free_async_space;
};
管理形式:
binder_alloc
   ├── 管理 pages[]
   ├── 管理 free_buffers
   └── 管理 buffers(list)
            ├── binder_buffer A
            ├── binder_buffer B
            └── ...
其他结构体
| 结构体 | 说明 |
|---|---|
| flat_binder_object | 描述在 Binder IPC 过程传递的特殊对象 |
| binder_write_read | 描述存储读写操作(是描述操作:要写读的地址、大小) |
| binder_version | 描述 Binder 的版本号 |
| transaction_flags | 描述事务的 flag,例如是否是异步请求,是否支持 fd |
| binder_transaction_data | 描述一次事务数据的相关数据 |
驱动核心方法
binder_open
New Version。主要多了安全检查、支持多Context、以及初始化binder_alloc。
static int binder_open(struct inode *nodp, struct file *filp)
{
	struct binder_proc *proc, *itr;
	struct binder_device *binder_dev;
	struct binderfs_info *info;
	struct dentry *binder_binderfs_dir_entry_proc = NULL;
	bool existing_pid = false;

    //分配并初始化 binder_proc
	proc = kzalloc(sizeof(*proc), GFP_KERNEL);
	if (proc == NULL)
		return -ENOMEM;


	spin_lock_init(&proc->inner_lock);
	spin_lock_init(&proc->outer_lock);

    //绑定到当前进程 task
	get_task_struct(current->group_leader);
	proc->tsk = current->group_leader;

    //记录打开 binder 设备时的 安全凭据
	proc->cred = get_cred(filp->f_cred

    //初始化 todo / wait
	INIT_LIST_HEAD(&proc->todo);
	init_waitqueue_head(&proc->freeze_wait);

    //保存进程初始调度策略
	if (binder_supported_policy(current->policy)) {
		proc->default_priority.sched_policy = current->policy;
		proc->default_priority.prio = current->normal_prio;
	} else {
		proc->default_priority.sched_policy = SCHED_NORMAL;
		proc->default_priority.prio = NICE_TO_PRIO(0);
	}

	//识别是 miscdev 还是 binderfs 设备
    //传统 misc 设备:/dev/binder, /dev/hwbinder, /dev/vndbinder
	//binderfs 动态设备:/dev/binderfs/<name>
	if (is_binderfs_device(nodp)) {
		binder_dev = nodp->i_private;
		info = nodp->i_sb->s_fs_info;
		binder_binderfs_dir_entry_proc = info->proc_log_dir;
	} else {
		binder_dev = container_of(filp->private_data,
					  struct binder_device, miscdev);
	}

    //增加 device 引用 & 绑定 context
	refcount_inc(&binder_dev->ref);
	proc->context = &binder_dev->context;

    //初始化 binder_alloc(mmap 用)
	binder_alloc_init(&proc->alloc);

	binder_stats_created(BINDER_STAT_PROC);
	proc->pid = current->group_leader->pid;

    //初始化各种链表
	INIT_LIST_HEAD(&proc->delivered_death);
	INIT_LIST_HEAD(&proc->delivered_freeze);
	INIT_LIST_HEAD(&proc->waiting_threads);

    //把 proc 挂到 file->private_data
    //之后:ioctl、mmap
   	//都通过 filp->private_data 拿到 binder_proc。
	filp->private_data = proc;

    //加入全局 binder_procs 表
	mutex_lock(&binder_procs_lock);
	hlist_for_each_entry(itr, &binder_procs, proc_node) {
		if (itr->pid == proc->pid) {
			existing_pid = true;
			break;
		}
	}
	hlist_add_head(&proc->proc_node, &binder_procs);
	mutex_unlock(&binder_procs_lock);
	//...
	return 0;
}
binder_mmap
*vma是指向用户虚拟内存mmap区的结构体指针。
New Version Binder mmap:
static int binder_mmap(struct file *filp, struct vm_area_struct *vma)
{
	struct binder_proc *proc = filp->private_data;
    //只允许进程主线程 mmap Binder(防止多线程乱映射),禁止危险 flag
	if (proc->tsk != current->group_leader)
		return -EINVAL;

	if (vma->vm_flags & FORBIDDEN_MMAP_FLAGS) {
		return -EPERM;
	}
    //设置:VM_DONTCOPY:fork不复制, VM_MIXEDMAP:允许VMA内既有普通页也有PFN映射页
	vm_flags_mod(vma, VM_DONTCOPY | VM_MIXEDMAP, VM_MAYWRITE);
    //安装 binder_vm_ops:后续触发缺页时,能走 Binder 自己的 fault 逻辑
    //Binder 不在 mmap 时分配物理页,而是交给 page fault 机制。
	vma->vm_ops = &binder_vm_ops;
	vma->vm_private_data = proc;
	return binder_alloc_mmap_handler(&proc->alloc, vma);
}
在进程调用 mmap(fd) 时,内核先在用户虚拟地址空间建立一段连续的 vm_area_struct,Binder 驱动仅记录该区间的起始地址和大小(不超过 4MB),并初始化页指针数组 alloc->pages[] 与 buffer 元数据,但此时并不分配任何物理页,也不建立内核侧的连续虚拟映射区。
物理页的分配完全按需进行,页大小固定为 PAGE_SIZE,分配数量由实际事务数据所覆盖的地址范围决定,而非在 mmap 阶段一次性分配。
后续在驱动copy、转发时,当驱动需要申请新buffer 地址时,调用binder_alloc_new_buf,Binder 驱动才按页分配 PAGE_SIZE 大小的物理页,并记录在 alloc->pages[index] 中。
因此,用户空间 Buffer 与内核 copy 操作之所以保持数据同步,并非依赖 user/kernel 地址差值,而是因为二者都会访问同一组由 struct page 管理的物理页。
总结(很重要)
相对于老版本,新版本
1.没有内核虚拟空间永久映射到物理页
2.没有计算offset定位数据,而是直接用buffer->user_data进行定位。
新版本定位:
在新 Binder 中:
-
binder_buffer->user_data: 永远是 该 buffer 在“目标进程用户地址空间”中的起始虚拟地址。 -
alloc->vm_start: mmap 区起始用户起始虚拟地址。 -
buffer_offset来源:整个buffer 是 0
offsets数组 是
ALIGN(data_size, sizeof(void *))某个fbo对象 是 offsets数组各元素
tr里的data_size
user_addr = buffer->user_data  + buffer_offset
//实际数据地址
调用binder_alloc_get_page(user_addr) 得到 page index (pages数组index) & pgoff(页内偏移):
//一个PAGE能存的数据数量是固定的,因此地址大小也是固定。
//计算出 从mmap区开始地址到实际数据地址距离 再除以 PAGE_SIZE 就可以得到 第几个Page能到达
//计算出 从mmap区开始地址到实际数据地址距离 模 PAGE_SIZE 就可以得到 这个Page装了多少数据
index = (user_addr - alloc->vm_start) / PAGE_SIZE;
pgoff = (user_addr - alloc->vm_start) % PAGE_SIZE;
可以通过 alloc->pages[index] 得到对应页结构体 struct page。
在Native层:
内核(驱动)读取客户端、服务端发来的数据 (copy):根据 user_addr = buffer->user_data(来自tr) + buffer_offset 计算 page index,然后进行kmap(page) ,将对应的 struct page 临时映射到内核虚拟地址空间,利用pgoff即可访问对应物理页的特定地址进行copy。
内核转发数据:先使用binder_alloc_new_buf在目标进程的 binder_alloc 中分配 buffer、 struct page物理页,通过 vm_insert_page(vma, addr, page) 将对应的 struct page 映射到用户虚拟空间地址,确定新 buffer->user_data(buffer起始地址)。再由新buffer->user_data反推出 page index,通过 kmap_local_page() 临时映射到物理页,然后把服务端的数据写入物理页;同时把buffer->user_data作为 tr.data.ptr.buffer返回。
用户空间读取内核发来的数据:内核返回的tr.data.ptr.buffer == buffer->user_data,直接访问tr.data.ptr.buffer读取数据即可。
Old Version Binder mmap:
在进程在
mmap(fd)初始化时,内核先在进程的用户空间分配一块连续区域vm_area_struct,传给Binder 驱动用于计算在内核空间需要分配的大小,驱动根据大小(不超过4MB)会在进程的内核空间分配一块连续区域vm_struct,然后再申请只有1个page大小的物理内存(后续会增加),再将这同一块物理内存分别映射到内核虚拟地址空间和用户虚拟内存空间,从而实现了用户空间的Buffer和内核空间的Buffer同步操作的功能。同时计算了
user_buffer_offset,其是同一进程下,虚拟用户mmap区地址与虚拟内核mmap区地址的差值(该值为负数)。这个
user_buffer_offset用于定位数据:假设
kadd是内核虚拟内存mmap区开始地址,uadd是用户虚拟内存mmap区开始地址,offset=uadd-kadd。驱动把事务数据写入Server内核虚拟地址时,写入某个特定的地址kaddd,那么由于两个mmap区是映射同一个物理页,因此用户地址uaddd=kaddd+offset上就有事务数据。
内存管理
binder_alloc_mmap_handler
继续初始化mmap区。
int binder_alloc_mmap_handler(struct binder_alloc *alloc,
			      struct vm_area_struct *vma)
{
	struct binder_buffer *buffer;
	const char *failure_string;
	int ret;

    //校验 mm 结构体
	if (unlikely(vma->vm_mm != alloc->mm)) {}
	mutex_lock(&binder_alloc_mmap_lock);
    //每个进程只能有一个 Binder 映射区。
	if (alloc->buffer_size) {}
    //记录:用户虚拟地址起点 vm_start,总大小 buffer_size
    //返回两者之间的最小值 vma->vm_end - vma->vm_start or SZ_4M SZ_4M一般等于4MB
	alloc->buffer_size = min_t(unsigned long, vma->vm_end - vma->vm_start,
				   SZ_4M);
	mutex_unlock(&binder_alloc_mmap_lock);
	alloc->vm_start = vma->vm_start;

	alloc->pages = kvcalloc(alloc->buffer_size / PAGE_SIZE,
				sizeof(alloc->pages[0]),
				GFP_KERNEL);
	if (!alloc->pages) {}

	buffer = kzalloc(sizeof(*buffer), GFP_KERNEL);
	if (!buffer) {}

    //创建一个初始 free buffer
	buffer->user_data = alloc->vm_start;
    //插入到链表
	list_add(&buffer->entry, &alloc->buffers);
	buffer->free = 1;
    //插入到红黑树
	binder_insert_free_buffer(alloc, buffer);
	alloc->free_async_space = alloc->buffer_size / 2;

	//标记 alloc 已经 mapped
	binder_alloc_set_mapped(alloc, true);
	return 0;

}
binder_alloc_copy_user_to_buffer、binder_alloc_do_buffer_copy
只使用物理页,没有分配。
unsigned long
binder_alloc_copy_user_to_buffer(struct binder_alloc *alloc,
				 struct binder_buffer *buffer,
				 binder_size_t buffer_offset,
				 const void __user *from,
				 size_t bytes)
{
    //检查对齐和数据大小
	if (!check_buffer(alloc, buffer, buffer_offset, bytes))
		return bytes;

	while (bytes) {
		unsigned long size;
		unsigned long ret;
		struct page *page;
		pgoff_t pgoff;
		void *kptr;

        // 在获取buffer时 已经分配好物理页了
        //获取:这个进程的这个buffer 在buffer_offset、pgoff偏移下对应的page index
		page = binder_alloc_get_page(alloc, buffer,
					     buffer_offset, &pgoff);

		size = min_t(size_t, bytes, PAGE_SIZE - pgoff);
        //临时映射 kptr指向page
		kptr = kmap_local_page(page) + pgoff;
        //从用户空间copy到page上
		ret = copy_from_user(kptr, from, size);
        //取消映射
		kunmap_local(kptr);

		if (ret)
            //失败了 就返回还剩多少没copy
			return bytes - size + ret;
        //没失败就继续
		bytes -= size;
		from += size;
		buffer_offset += size;
	}
	return 0;
}

static int binder_alloc_do_buffer_copy(
    				   struct binder_alloc *alloc,
				       bool to_buffer,
				       struct binder_buffer *buffer,
				       binder_size_t buffer_offset,
    				   //source
				       void *ptr,
				       size_t bytes)
{
	//检查对齐和数据大小
	if (!check_buffer(alloc, buffer, buffer_offset, bytes))
		return -EINVAL;

    //循环
	while (bytes) {
		unsigned long size;
		struct page *page;
		pgoff_t pgoff;

        // 在获取buffer时 已经分配好物理页了
        //获取:这个进程的这个buffer 在buffer_offset、pgoff偏移下对应的page index
		page = binder_alloc_get_page(alloc, buffer,
					     buffer_offset, &pgoff);

		size = min_t(size_t, bytes, PAGE_SIZE - pgoff);
        //传入的 to_buffer 为true,说明要把 ptr指向的数据 写到 buffer对应的page 上
		if (to_buffer)
			memcpy_to_page(page, pgoff, ptr, size);
		else
        //传入的 to_buffer 为false,说明要把 buffer对应的page 上的数据 写到 ptr
			memcpy_from_page(ptr, page, pgoff, size);
		bytes -= size;
		pgoff = 0;
		ptr = ptr + size;
		buffer_offset += size;
	}
	return 0;
}

int binder_alloc_copy_to_buffer(struct binder_alloc *alloc,
				struct binder_buffer *buffer,
				binder_size_t buffer_offset,
				void *src,
				size_t bytes)
{
	return binder_alloc_do_buffer_copy(alloc, true, buffer, buffer_offset,
					   src, bytes);
}

int binder_alloc_copy_from_buffer(struct binder_alloc *alloc,
				  void *dest,
				  struct binder_buffer *buffer,
				  binder_size_t buffer_offset,
				  size_t bytes)
{
	return binder_alloc_do_buffer_copy(alloc, false, buffer, buffer_offset,
					   dest, bytes);
}
binder_alloc_get_page
被binder_alloc_copy_user_to_buffer、binder_alloc_do_buffer_copy调用。查找要使用的物理页。
static struct page *binder_alloc_get_page(struct binder_alloc *alloc,
					  struct binder_buffer *buffer,
					  binder_size_t buffer_offset,
					  pgoff_t *pgoffp)
{
	binder_size_t buffer_space_offset = buffer_offset +
		(buffer->user_data - alloc->vm_start);
	pgoff_t pgoff = buffer_space_offset & ~PAGE_MASK;
	size_t index = buffer_space_offset >> PAGE_SHIFT;

	*pgoffp = pgoff;

	return alloc->pages[index];
}
分配物理页
binder_alloc_new_buf()
 → binder_install_buffer_pages()
   → binder_install_single_page()
     → binder_page_alloc()   // alloc_page() 分配 真正向 buddy allocator 申请物理页
     → binder_page_insert()  // vm_insert_page() 映射插入页表
注意,vm_insert_page(struct vm_area_struct *vma, unsigned long addr,struct page *page)已经把 用户空间的虚拟地址 映射到 对应的物理页上了。
这个vma就是描述用户空间虚拟地址的一块区域。
因此用户空间可以直接访问其vma区域内的 tr.data.ptr.buffer对应的地址,从而访问到物理页(不会缺页错误)。
binder_ioctl
最频繁调用的函数。
New Version
//ioctl(文件描述符,ioctl命令,用户操作相关数据)
static long binder_ioctl(struct file *filp, unsigned int cmd, unsigned long arg){

    //从binder_proc获取binder_thread结构体
    thread = binder_get_thread(proc);

    switch (cmd) {
        case BINDER_WRITE_READ:
            ret = binder_ioctl_write_read(filp, arg, thread);
            if (ret)
                goto err;
            break;

        // 注册成为 binder 的上下文管理者,也就是 ServiceManager的注册命令
        case BINDER_SET_CONTEXT_MGR:
            ret = binder_ioctl_set_ctx_mgr(filp, NULL);
            if (ret)
                goto err;
            break;
    }
}
不同的命令对应可能不同的数据类型。
BINDER_WRITE_READ命令最常见,会调用binder_ioctl_write_read函数。
binder_get_thread
从binder_proc中查找binder_thread,如果当前线程已经加入到proc的线程队列则直接返回,如果不存在则创建binder_thread,并将当前线程添加到当前的proc。
binder_ioctl_write_read
New Version
static int binder_ioctl_write_read(
    			struct file *filp,
                unsigned int cmd, unsigned long arg,
                struct binder_thread *thread){

    void __user *ubuf = (void __user *)arg;
    struct binder_write_read bwr;
    //拷贝ubuf到内核bwr,不对用户指针负责
    if (copy_from_user(&bwr, ubuf, sizeof(bwr))) {
        ret = -EFAULT;
        goto out;
    }

    if (bwr.write_size > 0) {
        //当写缓存有空间,则执行binder写操作
        ret = binder_thread_write(proc, thread,
                      bwr.write_buffer, bwr.write_size, &bwr.write_consumed);

        //...
    }
    if (bwr.read_size > 0) {
        //当读缓存有空间,则执行binder读操作
        ret = binder_thread_read(proc, thread,
                      bwr.read_buffer, bwr.read_size, &bwr.read_consumed,
                      filp->f_flags & O_NONBLOCK);

		binder_inner_proc_lock(proc);
        //如果proc->todo不为空,需要处理work事务
		if (!binder_worklist_empty_ilocked(&proc->todo))
			binder_wakeup_proc_ilocked(proc); //唤醒在proc->waiting_threads等待的线程
		binder_inner_proc_unlock(proc);

		//...
    }

}
arg是一个binder_write_read结构体。
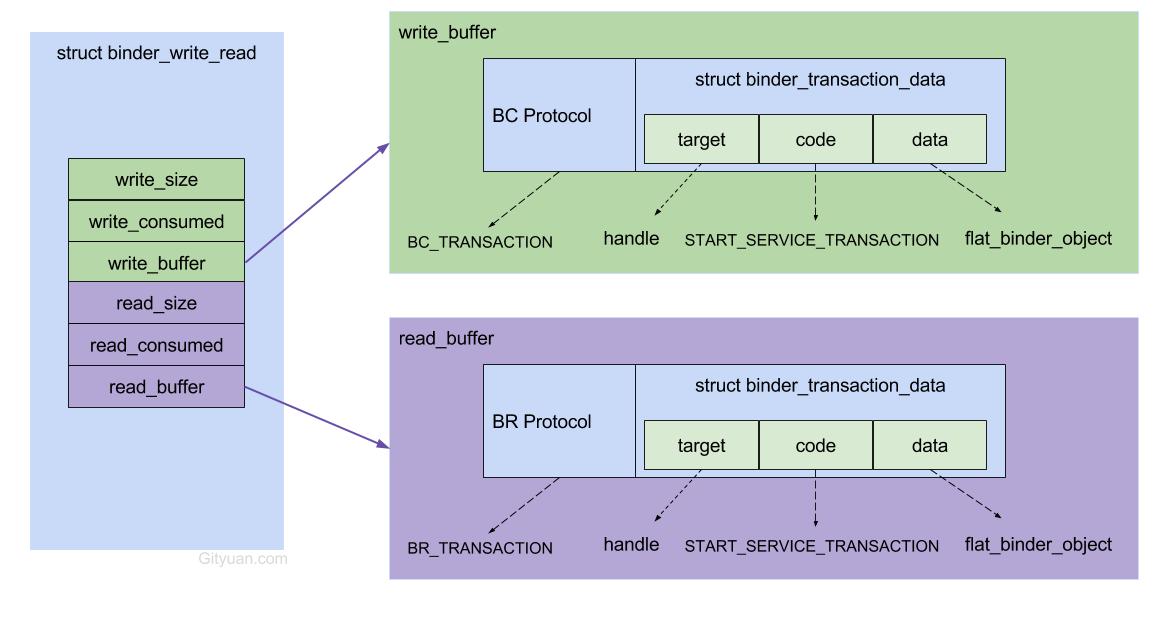
在命令之后,会跟一个 struct binder_transaction_data 结构体。
| 问题 | 答案 |
|---|---|
write_buffer/read_buffer 在哪? |
用户虚拟地址空间,通常由 malloc 分配(在堆上) |
| 命令流如何带结构体? | 命令码(4B) + binder_transaction_data(64B)连续存放 |
| 事务数据也在其中吗? | 不在! 事务数据在 binder_transaction_data.ptr.buffer 指向的另一块用户内存 |
| 内核如何解析? | 通过指针偏移,命令码固定4B大小。 |
流程:
bwr.write_size>0 代表写缓存有空间,可以调用 binder_thread_write(),
bwr.read_size>0 则代表读缓存有空间,可以调用 binder_thread_read(),
若都大于 0 则先写入,后读取。
最后,把bwr拷贝回到用户ubuf,告知消费完,或是没有消费完需要重试。
通信码
Binder驱动通过制定一系列的通信码,形成了协议,分为两类:
BINDER_COMMAND_PROTOCOL:binder请求码,以”BC_“开头,简称BC码,用于从进程层传递到Binder Driver层;BINDER_RETURN_PROTOCOL:binder响应码,以”BR_“开头,简称BR码,用于从Binder Driver层传递到进程层;
binder_thread_write
主要是消费write_buffer。把BC_+ tr[payload],通过binder_transaction转为 work+buffer。
New Version
static int binder_thread_write(struct binder_proc *proc,
                               struct binder_thread *thread,
                               //注意这里 binder_buffer 是在当前进程用户空间的堆上
                               //命令区buffer
                               binder_uintptr_t binder_buffer,
                               size_t size,
                               binder_size_t *consumed){

    //buffer mmap区起始地址
    void __user *buffer = (void __user *)(uintptr_t)binder_buffer;
    //上次消费 + 起始地址 = 这次要消费的起始地址
	void __user *ptr = buffer + *consumed
    //结束地址
	void __user *end = buffer + size;

    //循环
    while (ptr < end && thread->return_error == BR_OK) {
        //获取write_buffer数据中的Binder通信码(BC码)
        get_user(cmd, (uint32_t __user *)ptr);
        ptr += sizeof(uint32_t);

        switch (cmd) {
            //...
            //注意这里BC_TRANSACTION、BC_REPLY都会调用binder_transaction
            //Client 调用 transact() → 发送 BC_TRANSACTION
            //Server 调用 reply() → 发送 BC_REPLY
            case BC_TRANSACTION:
            case BC_REPLY:
                struct binder_transaction_data tr;
                // 拷贝tr,从用户空间到内核 没有使用alloc相关方法是因为tr只是作为临时的
                // 一次性拷贝整个 binder_transaction_data
                // 注意tr结构体只是描述了事务数据的相关数据
                // 真正的数据在tr结构体中的:
                // data.ptr.buffer 和 data.ptr.offsets 是 用户空间mmap指针,指向真正的事务数据。
                if (copy_from_user(&tr, ptr, sizeof(tr)))
                    return -EFAULT;
                //移动指针,跳过tr结构体,下次循环直接处理命令
                ptr += sizeof(tr);

                //注意这里判断了 cmd == BC_REPLY,从而影响这次binder_transaction
                //最关键的是cmd == BC_REPLY,binder_transaction内创建的t会不设置target_node
                //在后续binder_thread_read中,因为t没有target_node,因此返回的指令是BR_REPLY
                binder_transaction(proc, thread, &tr, cmd == BC_REPLY);
                break;
			//...
            }
        }
    }
}
binder_transaction
New Version
static void binder_transaction(
    		   struct binder_proc *proc,
               struct binder_thread *thread,
               struct binder_transaction_data *tr,
               int reply){

    //分配两个结构体内存
    struct binder_transaction *t = kzalloc(sizeof(*t), GFP_KERNEL);
    struct binder_work *tcomplete = kzalloc(sizeof(*tcomplete), GFP_KERNEL);

    //指向用户空间mmap区的buffer 的指针
    const void __user *user_buffer =
    (const void __user *)(uintptr_t)tr->data.ptr.buffer;


    struct binder_node *target_node;    //目标binder节点
    struct binder_proc *target_proc;    //目标进程
    struct binder_thread *target_thread; //目标线程
    struct list_head *target_list;      //目标进程TODO队列
    wait_queue_head_t *target_wait;     //目标等待队列

    //请求阶段:
    //target_node:
    //handle != 0 →
        //binder_ref = binder_get_ref_olocked(proc, tr->target.handle, true);
        //binder_ref->node
  	//handle == 0 → context->binder_context_mgr_node
    //-----------------------------------------------
    //target_node 确定 target_proc = target_node->proc;
    //target_thread:
    //    如果是嵌套调用,使用while循环赋值
    //    否则为NULL。
    //-----------------------------------------------
    //补充:如果为NULL,那么后续binder_proc_transaction()方法会通过
    //binder_select_thread_ilocked(proc)选一个
    //-----------------------------------------------
    //target_list	NULL 后续方法会决定的,但是不使用这个变量
	//target_wait	NULL 后续方法会决定的,但是不使用这个变量

    //回复阶段:
    //in_reply_to (需要被回复线程的事务上下文) = thread->transaction_stack 确定 target_thread = binder_get_txn_from_and_acq_inner(in_reply_to)
    //target_thread 确定 target_proc = target_thread->proc
    //target_thread 确定 target_list = &target_thread->todo
	//target_thread 确定 target_wait = &target_thread->wait
    //target_node 为 NULL 🌟


    //关键!!!!!!👉 t->work被投递,t->work可以还原整个t,因此可以读到t->buffer
    //从target_proc分配一块buffer,分配的是 目标进程的用户空间mmap区内存,且分配了物理页
    t->buffer = binder_alloc_new_buf(
        &target_proc->alloc,
        tr->data_size,
		tr->offsets_size,
        extra_buffers_size,
		!reply && (t->flags & TF_ONE_WAY));

	//驱动在内核态 把数据 拷贝 从 Client 用户空间 → Server 内核空间:
   	//分多次处理:先拷贝offsets 数组,开启循环:提取单个flat object处理,再提取普通数据
    //拷到内核一般是临时变量,经过处理再拷到用户空间buffer;有的无需处理的,直接拷贝到用户空间buffer

    //拷贝 offsets 数组(事务数据) 到 当前进程的buffer
    //除了这个方法外还可能会用到 所以 to buffer
    if (binder_alloc_copy_user_to_buffer(
				&target_proc->alloc,
				t->buffer,
				ALIGN(tr->data_size, sizeof(void *)),
				(const void __user *) (uintptr_t)tr->data.ptr.offsets,
				tr->offsets_size)){}


    //遍历 offsets,处理内嵌对象(核心!!!)
    //对每个 flat_binder_object 做转换

    //data 区中,普通字节:直接拷 flat_binder_object:需要先读出来 → 处理 → 再写回
	//所以内核在:上一个对象末尾 ~ 下一个对象起始 之间,调用拷贝普通数据
    for (buffer_offset = off_start_offset; buffer_offset < off_end_offset;
	     buffer_offset += sizeof(binder_size_t)) {
        //...

        //拷贝用户buffer内的 offsets数组[x]  到 当前内核
        if(binder_alloc_copy_from_buffer(
            			  &target_proc->alloc,
						  &object_offset,
						  t->buffer,
						  buffer_offset,
						  sizeof(object_offset))){}


        if (copy_size && (user_offset > object_offset ||
				object_offset > tr->data_size ||
				//拷贝 普通数据(事务数据)到 当前进程的buffer
				binder_alloc_copy_user_to_buffer(
					&target_proc->alloc,
					t->buffer,
                    user_offset,
					user_buffer + user_offset,
					copy_size))){}

        //...
        object_size = binder_get_object(target_proc, user_buffer,
				t->buffer, object_offset, &object)
        hdr = &object.hdr;
        switch (hdr->type) {
        case BINDER_TYPE_WEAK_BINDER:
        case BINDER_TYPE_BINDER:
            //如果是 BINDER_TYPE_BINDER(一般是Server → Client)
            //binder_node 转 handle
            //binder_node 强引用计数增加
            ...
            fp = to_flat_binder_object(hdr);
            //拷贝 单个flat_binder_object(刚拷贝到内核)到 当前进程的buffer
            binder_alloc_copy_to_buffer(
                			&target_proc->alloc,
							t->buffer,
							object_offset,
							fp,
                            sizeof(*fp))
           	...

        case BINDER_TYPE_WEAK_HANDLE:
        case BINDER_TYPE_HANDLE: ...
            //如果是 BINDER_TYPE_HANDLE(一般是Client → Server)
            	//handle要么处理为本地binder_node,要么处理为另一个handle(目标在其他进程)
            	//binder_node 引用计数增加
            ...
            fp = to_flat_binder_object(hdr);
            binder_alloc_copy_to_buffer(
                			&target_proc->alloc,
							t->buffer,
							object_offset,
							fp,
                            sizeof(*fp))
           	...
        case BINDER_TYPE_FD: //同一个文件描述符 FD 跨进程传递
        }
    }


    //发送work,在binder_thread_read把work转化为BR码
    if (reply) {
        //reply 永远是线程级调度,不经过 proc->todo

        //给当前线程的todo队列一个BR_TRANSACTION_COMPLETE work
        //(即现在发reply的服务端线程)
		//表示:reply 已提交给驱动,将来可返回用户态
		binder_enqueue_thread_work(thread, tcomplete);
		binder_inner_proc_lock(target_proc);

		if (target_thread->is_dead) {} //若它已经死了 → 返回 BR_DEAD_REPLY
		//弹出调用栈中的请求事务上下文,因为现在要完成它了
		binder_pop_transaction_ilocked(target_thread, in_reply_to);
        //把 reply 事务 t 放入:target_thread->todo
		binder_enqueue_thread_work_ilocked(target_thread, &t->work);

		binder_inner_proc_unlock(target_proc);

        //唤醒正在 talkWithDriver() 里睡眠的客户端线程
		wake_up_interruptible_sync(&target_thread->wait);
		//释放请求事务
		binder_free_transaction(in_reply_to);
	} else if (!(t->flags & TF_ONE_WAY)) {
		//不是回复,而且是同步的请求

		binder_inner_proc_lock(proc);
		//延迟给客户端 TRANSACTION_COMPLETE,目标进程可立即处理请求,减少一次上下文切换
		binder_enqueue_deferred_thread_work_ilocked(thread, tcomplete);
        //维护调用栈,把当前事务压入客户端线程的调用栈
		//用于:reply 回溯、嵌套调用检测
		t->from_parent = thread->transaction_stack;
		thread->transaction_stack = t;

		binder_inner_proc_unlock(proc);

        //真正投递到目标,线程级 or 进程级

        //在 binder_proc_transaction() 里:
		//若 target_thread != NULL:投递到thread->todo

		//若 target_thread == NULL:
        //		如果有空闲线程,唤醒,投递到线程thread->todo
        //		如果没有,投递到进程proc->todo
		return_error = binder_proc_transaction(t,
				target_proc, target_thread);
		if (return_error) {
            //出错进行回滚
        }
	}

    return;
}
binder_transaction后续流程:
事务投递后,不会立即执行,而是放入目标线程/进程的 todo 队列,等待 目标进程主动调用 ioctl(BINDER_WRITE_READ) 触发处理,走一遍binder_ioctl_write_read -> binder_thread_write/read。
补充
struct binder_transaction_data {
	//...
    union {
        struct {
            binder_uintptr_t buffer;    /* ← 关键:事务数据起始地址 */
            binder_uintptr_t offsets;   /* ← 指向对象偏移数组 */
        } ptr;
        __u8 buf[8]; /* 小事务可直接内联(不常用) */
    } data;
};
tr.data.ptr.buffer:在用户虚拟空间mmap区中这一次事务数据起始地址(比如 Parcel 序列化后的字节流)
tr.data.ptr.offsets:偏移数组(binder_size_t[]),每个元素是一个相对于 buffer 起始位置的偏移量,主要标识特殊的对象。
假设你发送一个 Parcel,内容是:
Parcel p = new Parcel();
p.writeString("Hello");
p.writeStrongBinder(myService); // ← 这是一个 IBinder 对象!
p.writeFileDescriptor(fd);     // ← 这是一个 FD!
放入buffer中内存布局
[buffer 起始地址]
│
├─ 0x00: "Hello\0"              ← 普通字符串
├─ 0x08: flat_binder_object{    ← IBinder 对象(16 字节)
│        .type = BINDER_TYPE_BINDER,
│        .binder = 0x12345678,  ← Server 本地指针
│        .cookie = 0xabcdef00
│      }
├─ 0x18: flat_binder_object{    ← FD 对象
│        .type = BINDER_TYPE_FD,
│        .handle = 10            ← 当前进程 fd=10
│      }
需要构造一个 offsets 数组:
offsets[0] = 0x08;  // 表示 0x08 处是一个 flat_binder_object
offsets[1] = 0x18;  // 表示 0x18 处也是一个 flat_binder_object
binder_thread_read
主要是写入read_buffer。处理binder_work,转为BR_+ tr[payload],同时写入read_buffer。
New Version
static int binder_thread_read(struct binder_proc *proc,
                              struct binder_thread *thread,
                              binder_uintptr_t binder_buffer,
                              size_t size,
                              binder_size_t *consumed,
                              int non_block){

    //buffer mmap区起始地址
    void __user *buffer = (void __user *)(uintptr_t)binder_buffer;
    //上次写入 + 起始地址 = 这次要写入的起始地址
	void __user *ptr = buffer + *consumed
    //结束地址
	void __user *end = buffer + size;

    //根据wait_for_proc_work,来决定wait在哪个等待队列
    // wait_for_proc_work == true 说明本线程无私有事务,需从进程公共队列取事务
    binder_inner_proc_lock(proc);
	wait_for_proc_work = binder_available_for_proc_work_ilocked(thread);
	binder_inner_proc_unlock(proc);

    // 加 一个状态 描述线程
    thread->looper |= BINDER_LOOPER_STATE_WAITING;

    if (wait_for_proc_work) {
        //注意这里 对线程状态进行了判断
        //只有设置了ENTERED 或 REGISTERED 的线程,才允许从 proc->todo 队列中取事务。
		if (!(thread->looper &
              (BINDER_LOOPER_STATE_REGISTERED |
					BINDER_LOOPER_STATE_ENTERED))) {
			//报错
		}
		binder_restore_priority(thread, &proc->default_priority);
	}

    //判断是否需要阻塞等待
    if (non_block) {
		if (!binder_has_work(thread, wait_for_proc_work))
			ret = -EAGAIN;
	} else {
		ret = binder_wait_for_work(thread, wait_for_proc_work);
	}

    //减一个状态
    thread->looper &= ~BINDER_LOOPER_STATE_WAITING;

    while (1) {
        //当&thread->todo和&proc->todo都为空时,goto到retry标志处等待,否则往下执行:
        struct binder_transaction_data_secctx tr;
		struct binder_transaction_data *trd = &tr.transaction_data;
        struct binder_work *w = NULL;
		struct list_head *list = NULL;
        size_t trsize = sizeof(*trd);

        binder_inner_proc_lock(proc);
		if (!binder_worklist_empty_ilocked(&thread->todo))
			list = &thread->todo; //私有的当前线程todo队列
		else if (!binder_worklist_empty_ilocked(&proc->todo) &&
			   wait_for_proc_work)
			list = &proc->todo; //进程的当前线程todo队列
		else {
			binder_inner_proc_unlock(proc);
			/* no data added */
			if (ptr - buffer == 4 && !thread->looper_need_return)
				goto retry;
			break;
		}

        //从队列取事务
        w = binder_dequeue_work_head_ilocked(list);

        switch (w->type) {
            case BINDER_WORK_TRANSACTION: {
                //把 work 还原成 transaction 对象,最后使用统一逻辑处理
				binder_inner_proc_unlock(proc);
				t = container_of(w, struct binder_transaction, work);
			}
            case BINDER_WORK_TRANSACTION_COMPLETE:
                // binder_transaction 投递的事务在这这里处理!!!
                // 返回 BR_TRANSACTION_COMPLETE
                // 通知发送方:“你的 BC_TRANSACTION 已成功投递到目标进程”
            case BINDER_WORK_NODE:
                // 返回 BR_ACQUIRE / BR_RELEASE
                // 通知 Server:“有新的强引用,请保持对象存活”
            case BINDER_WORK_DEAD_BINDER:
                //返回BR_DEAD_BINDER
                //通知 Client:“你持有的远程对象已死亡”
            case BINDER_WORK_DEAD_BINDER_AND_CLEAR: ...
            case BINDER_WORK_CLEAR_DEATH_NOTIFICATION: ...
        }


        //work处理BINDER_WORK_TRANSACTION
        if (!t) //不是BINDER_WORK_TRANSACTION,那么t就为null,继续循环
			continue;
        //work 生成 BR 命令

        //返回 BR_TRANSACTION / BR_REPLY
        if (t->buffer->target_node) {
            //这次事务是发送给Server的,后续可能需要回复
			struct binder_node *target_node = t->buffer->target_node;
			trd->target.ptr = target_node->ptr;
			trd->cookie = target_node->cookie;
			binder_transaction_priority(thread, t, target_node);
			cmd = BR_TRANSACTION;
		} else {
            //这次事务是回复给Client的
			trd->target.ptr = 0;
			trd->cookie = 0;
			cmd = BR_REPLY;
		}

        //复用 binder_transaction_data trd,填充trd 并返回给用户空间
        //注意:t是事务的上下文,描述谁发给谁,事务数据在哪个地址
        //trd是事务的具体数据的相关数据,描述具体数据的大小、在哪个地址
        trd->code = t->code;
		trd->flags = t->flags;

        trd->data_size = t->buffer->data_size;
		trd->offsets_size = t->buffer->offsets_size;
		trd->data.ptr.buffer = t->buffer->user_data;
		trd->data.ptr.offsets = trd->data.ptr.buffer +
					ALIGN(t->buffer->data_size,
					    sizeof(void *));
        trsize = sizeof(tr)

        // 往read_buffer(在堆上)写入 BR_TRANSACTION 或 BR_REPLY
        put_user(cmd, (uint32_t __user *)ptr);

        ptr += sizeof(uint32_t);
        // 往read_buffer BR_TRANSACTION 或 BR_REPLY之后写上 tr

        // tr的trd已经被填充完成
		// 关键!!!:从内核空间拷贝 tr 结构体(~64 字节)到用户空间,
        // 用户空间收到后,直接读 tr.data.ptr.buffer 获取事务具体数据(零拷贝)
        copy_to_user(ptr, &tr, trsize);
		ptr += trsize;

        // 允许用户调用 BC_FREE_BUFFER 释放 t结构体
        // (t->buffer->transaction 指向 t,标明这个buffer在被t使用)
        t->buffer->allow_user_free = 1;


        if (cmd != BR_REPLY && !(t->flags & TF_ONE_WAY)) {
            // 说明cmd = BR_TRANSACTION可能需要回复
            // 防止同步嵌套调用:把t压入栈
            // 如果是嵌套,以便回复的顺序正确:
            //.A调用B的方法;B在处理中,又调用C的方法;先C回复B,B才能回复A
			binder_inner_proc_lock(thread->proc);
			t->to_parent = thread->transaction_stack;
			t->to_thread = thread;
			thread->transaction_stack = t;
			binder_inner_proc_unlock(thread->proc);
		} else {
            // cmd已经是 回复了 or 异步调用:直接释放 t结构体占的内存
			binder_free_transaction(t);
		}


    }
    done:
    //使用ptr计算消费了多少
    *consumed = ptr - buffer;
    //当前 没有空闲线程(ready_threads == 0)
    //也没有 已请求但未启动的线程(requested_threads == 0)
    //且 已启动线程数 < 最大线程数(requested_threads_started < max_threads)
    //且当前线程是合法 Binder 线程(已注册)
    if (proc->requested_threads + proc->ready_threads == 0 &&
        proc->requested_threads_started < proc->max_threads &&
        (thread->looper & (BINDER_LOOPER_STATE_REGISTERED |
                           BINDER_LOOPER_STATE_ENTERED))) {
        proc->requested_threads++;
        // 生成BR_SPAWN_LOOPER命令,通知Server创建新线程处理todo队列
        put_user(BR_SPAWN_LOOPER, (uint32_t __user *)buffer);
    }
    return 0;
}
case BINDER_WORK_TRANSACTION后续流程:
假定先在Server 进程的read_buffer写入了BR_TRANSACTION+tr。
Server 进程后续:
-
Server 进程的某一线程ioctl(BINDER_WRITE_READ, &bwr) 。
-
进入内核,驱动执行到
binder_thread_read():从todo队列取出BINDER_WORK_TRANSACTION事务,
驱动构造
BR_TRANSACTION命令和binder_transaction_data tr结构体到 Server进程read_buffer。 -
Server进程中代码执行
BBinder::onTransact()处理read_buffer,构造回复数据。 -
驱动将数据写入 Client 内核空间mmap区 。
-
Server进程执行ioctl,驱动在binder_transaction(..., reply=1) 构造 binder_transaction(其内部
t->buffer->target_node == NULL,表示是 reply)和BINDER_WORK_TRANSACTION事务,将其加入 Client 原始调用线程的thread->todo队列。 -
唤醒阻塞在
thread->wait上的 Client 线程。
Client 进程后续:
-
Client 对应线程被唤醒,从
wait_event返回,驱动继续执行binder_thread_read() : -
从
thread->todo队列头部取出BINDER_WORK_TRANSACTION事务(其内部t->buffer->target_node == NULL,表示是 reply),判断
t->buffer->target_node == NULL,设置cmd = BR_REPLY,驱动构造
binder_transaction_data tr,将BR_REPLY和tr写入 Client 的bwr.read_buffer。 -
Client进程中的代码执行到
IPCThreadState::executeCommand(),从read_buffer解析出BR_REPLY和tr,直接读取Server 的回复数据(零拷贝)。 -
驱动还原出
binder_buffer结构体指针,释放内部引用,合并内存块回free_buffers。
小结
| 方法 | 创建的结构体 | 核心作用 |
|---|---|---|
binder_open |
binder_proc |
进程级上下文初始化 |
binder_mmap |
binder_buffer(初始) |
建立共享内存,零拷贝基础 |
BINDER_SET_CONTEXT_MGR |
binder_node(ServiceManager) |
注册全局服务管理器(内核驱动级别) |
binder_get_thread |
binder_thread |
线程级上下文初始化、获取 |
binder_thread_write |
(间接创建,调用binder_transaction方法) | 解析命令BC_XXX,处理部分事务或委托给binder_transaction |
binder_transaction |
binder_transaction, binder_work, (特定命令会创建binder_node、binder_ref) |
跨进程调用核心,来回传递事务数据,生成binder_work投递到todo队列 |
binder_thread_read |
主要是消费结构体 | 将binder_work转换为 BR_XXX 返回用户,拷贝binder_transaction到进程用户空间 |
BC_FREE_BUFFER |
无 | 安全释放内存,同步引用 |
binder_release |
无 | 进程退出,全局清理 |
libbinder (Framework)
libbinder 是 Android Binder 机制在 C++ 层的实现库,编译成 libbinder.so。它负责:
- 封装与 Binder 驱动的交互(通过 ioctl 与驱动交互)
- 管理进程(ProcessState)、线程状态(IPCThreadState)
- 提供跨进程通信(IPC)的接口模型(本地
BBinder/远程BpBinder等) - 包装 IPC 传输的数据(Parcel)
- 自动管理 Binder 对象的生命周期(引用计数)
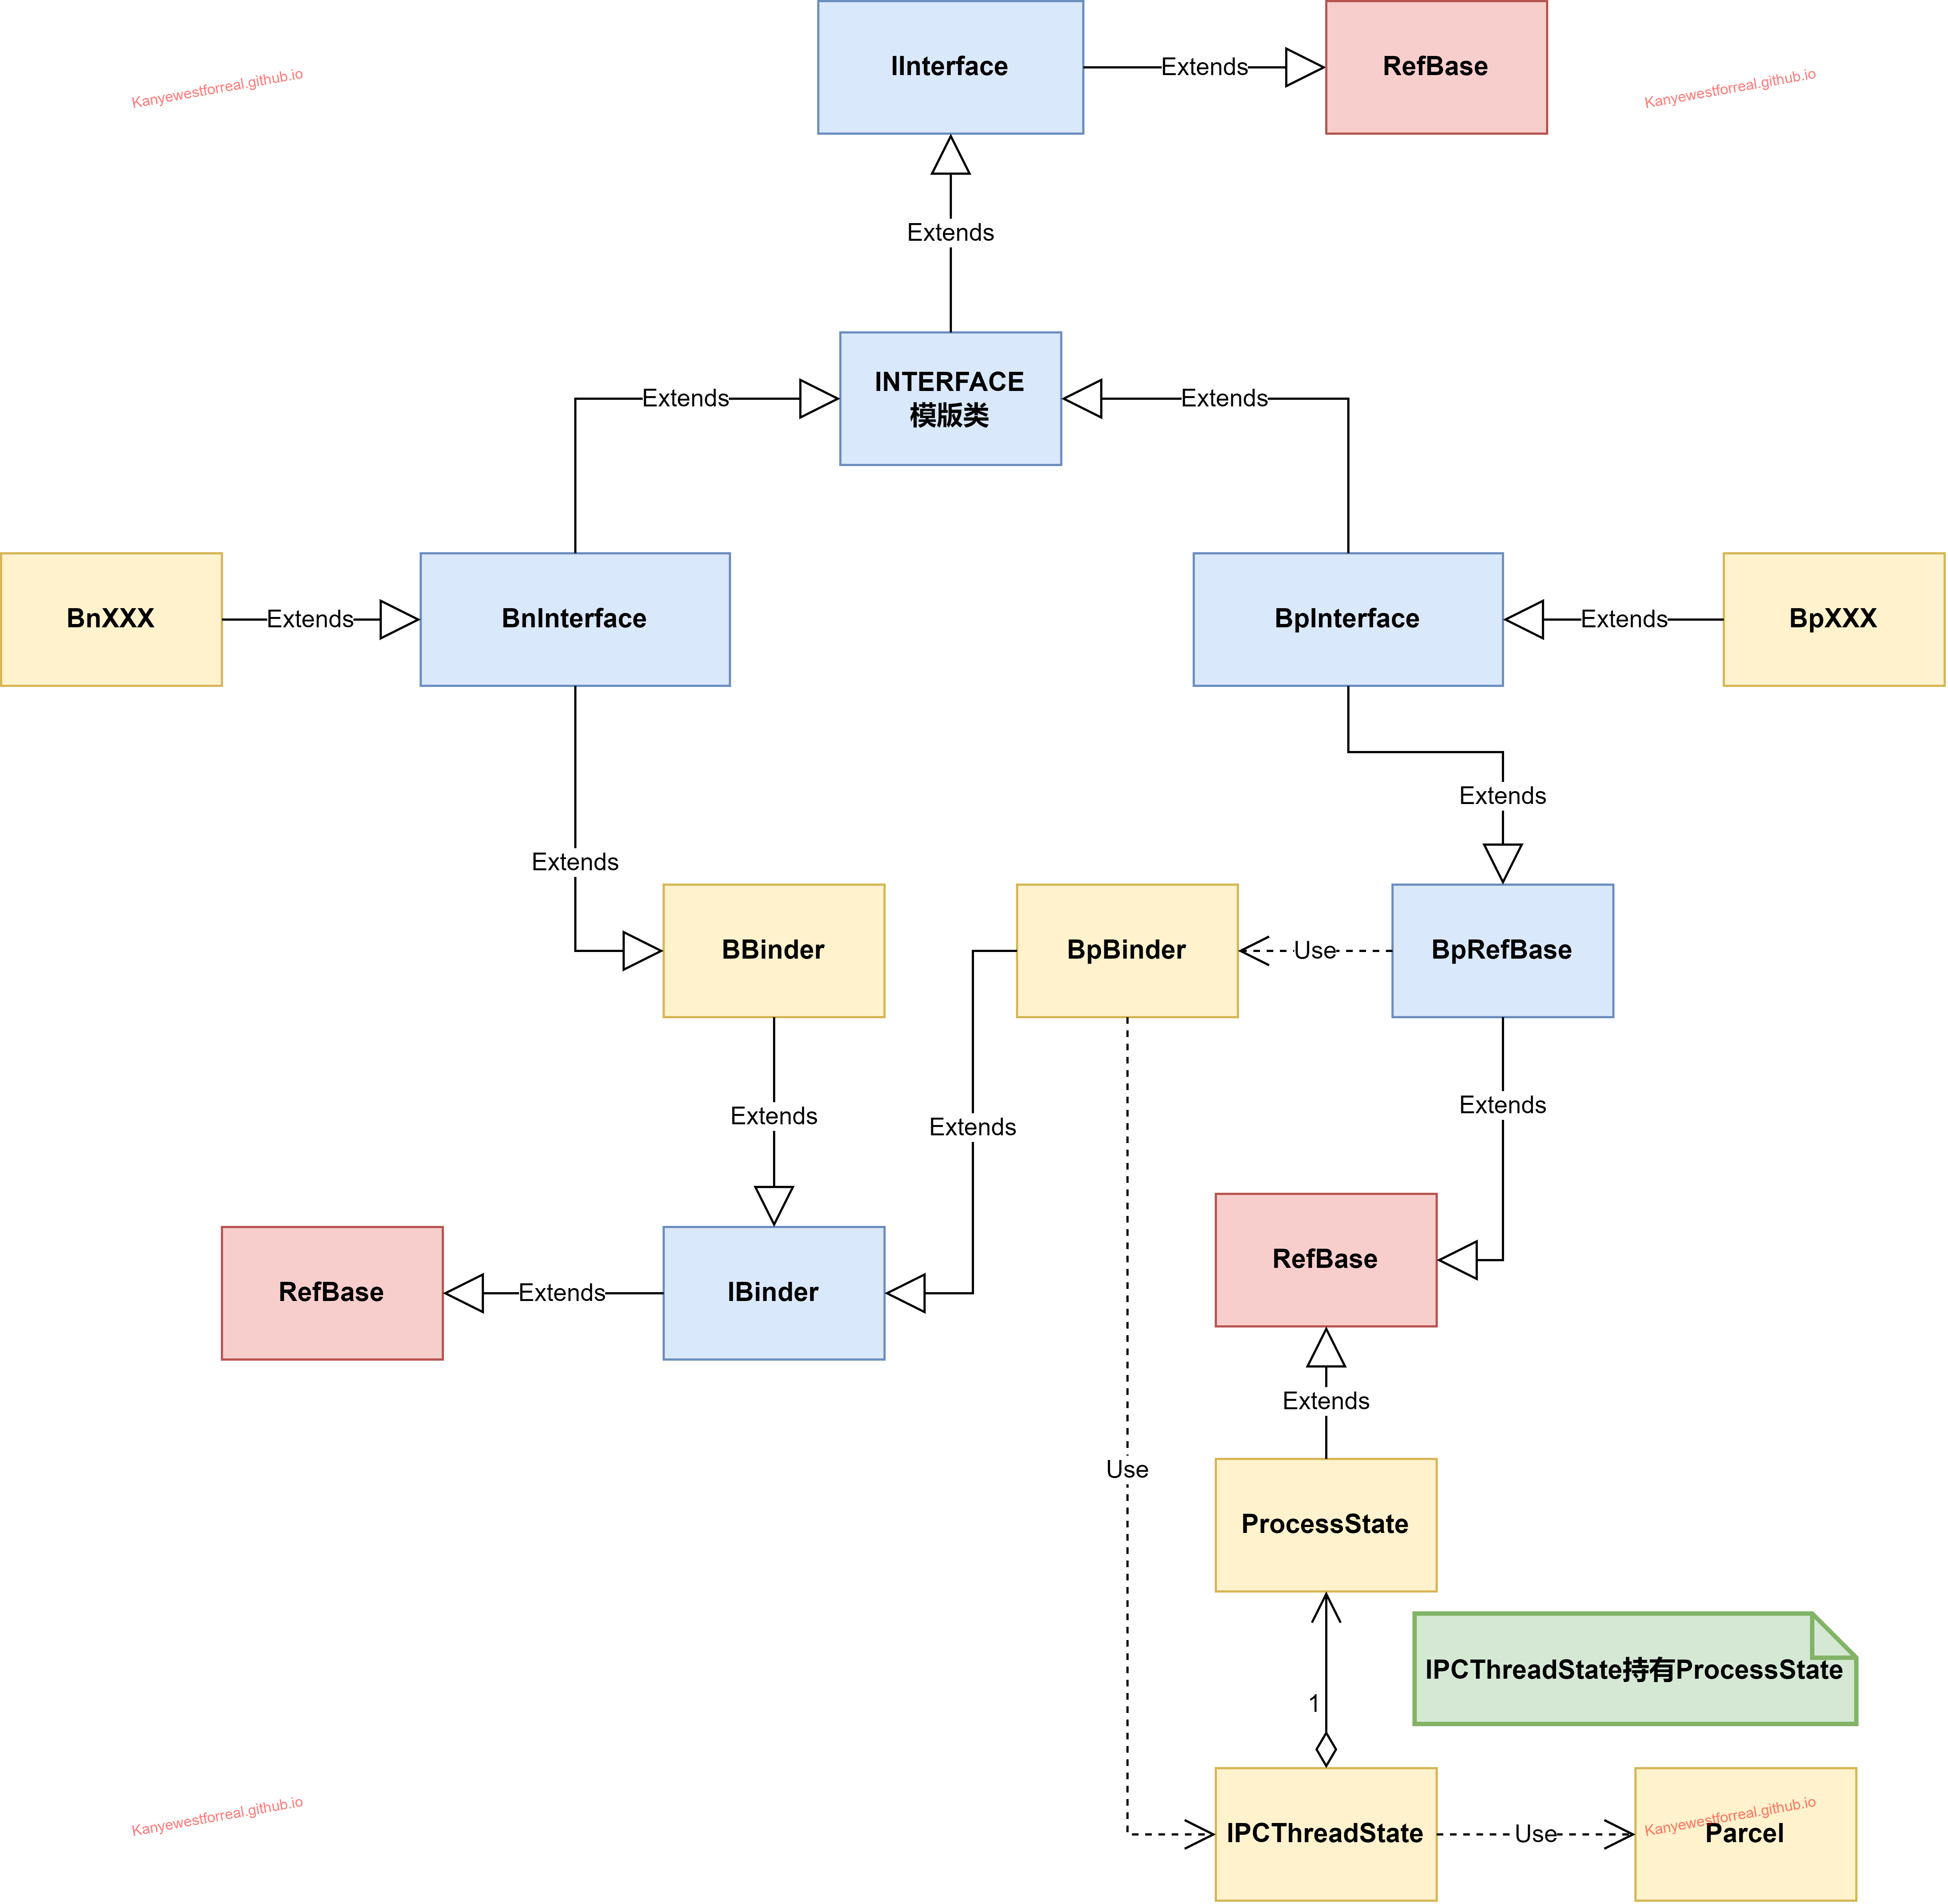
命名规则
| 前缀 | 含义 | 运行位置 | 作用 |
|---|---|---|---|
Bp |
Binder Proxy(代理) | 客户端进程 | 封装远程调用 |
Bn |
Binder Native(本地实现) | 服务端进程 | 实现服务逻辑 |
常见类
| 类名 | 扮演角色 | 所属端 | 关键作用简述 |
|---|---|---|---|
IBinder |
Binder 对象的抽象基类 | 通用 | 定义了所有 Binder 对象(无论是本地还是远程)都必须实现的核心能力,如 transact。(BBinder、BpBinder的基类) |
BBinder |
本地 Binder 实现基类 | Server (Native) | 代表一个服务的本地实现。所有真正的服务(如 BnServiceManager)都继承自它。它的 onTransact 方法是所有 IPC 请求的服务端入口。调用transact会转发给onTransact 。 |
BpBinder |
远程 Binder 代理基类 | Client (Proxy) | 代表一个远程服务的代理。客户端持有的就是此类的实例。它的 transact 方法负责将请求序列化并发送给驱动。 |
IInterface |
服务接口的抽象基类 | 通用 | 为具体的业务服务(如 IServiceManager)提供一个标准的 C++ 接口基类,并提供从接口到 IBinder 的转换 (asBinder)。 |
BnInterface |
服务本地接口模板 | Server (Native) | 模板类,将 BBinder 和 IInterface 的子类组合起来,是所有服务本地实现(BnXXX)的直接父类。 |
BpInterface |
服务远程接口模板 | Client (Proxy) | 模板类,将 BpBinder 和 IInterface 的子类组合起来,是所有服务远程代理(BpXXX)的直接父类。 |
ProcessState |
进程的 Binder 状态 | 通用 | 单例。代表当前进程与 Binder 驱动的连接。它负责打开 /dev/binder 设备、mmap 一块共享内存,并管理进程内所有线程共用的全局状态,如上下文管理者(Context Manager)。 |
IPCThreadState |
线程的 Binder 状态 | 通用 | 线程局部变量 (TLS)。代表当前线程与 Binder 驱动的交互状态。它持有 ProcessState 的引用,并管理该线程专用的 输入/输出 Parcel 缓冲区,是 transact 调用真正的执行者。 |
Parcel |
IPC 数据包装器 | 通用 | 负责序列化(写入)和反序列化(读取)在 Binder 上传输的数据。所有跨进程传递的数据(包括基本类型、字符串、文件描述符、甚至其他 IBinder 对象)都必须通过 Parcel。 |
IBinder
IBinder 是 所有 Binder 对象的公共抽象基类,无论是本地服务(BBinder)还是远程代理(BpBinder),都直接继承自它。它定义了 Binder 对象必须具备的通用能力,使得转化类型代码(如 IInterface)无需关心对象是本地还是远程,只需通过统一接口操作,让跨进程调用看起来像本地函数调用。
关键方法与源码逻辑
transact
//code:事务码,标识要调用的服务接口(必须与 BnXXX::onTransact 中的 switch(code) 匹配)。
//data:输入参数(序列化后的数据)。
//reply:输出参数(反序列化后的返回数据)。
//flags:标志位(如 IBinder::FLAG_ONEWAY 表示异步调用,无需等待回复)。
virtual status_t transact(uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags = 0) = 0;
作用:让所有 IBinder 子类(无论本地/远程对象)都能发起一次 Binder 事务。
使用方式:
- Client 端:BpBinder继承IBinder。客户端通过
BpBinder::transact调用,将请求事务发送到驱动。 - Server 端:BBinder继承IBinder。由
IPCThreadState在收到驱动请求后,调用BBinder::transact,进而触发onTransact。
localBinder
virtual BBinder* localBinder();
作用:让所有 IBinder 子类(无论本地/远程对象)都能被问,能不能将当前 IBinder 转换为本地 Binder 对象。
默认实现:返回 nullptr。
重写:
BBinder 重写了此方法,返回 this(表示能转化)。
Bpinder 没有重写。(意味着不能转换)
用途:在同进程内(如 ServiceManager 自身调用获取 BBinder(BnServiceManager)),可直接调用本地方法返回,避免走 IPC, 额外开销。
remoteBinder
virtual BpBinder* remoteBinder();
作用:让所有 IBinder 子类(无论本地/远程对象)都能被问,能不能将当前 IBinder对象转换为远程 Binder 代理。
默认实现:返回 nullptr。
重写:
BpBinder 重写了此方法,返回 this(表示能转换)。
BBinder 没有重写(意味着不能转换)。
用途:用于类型判断或特殊处理远程对象。
queryLocalInterface
virtual sp<IInterface> queryLocalInterface(const String16& descriptor);
作用:让所有 IBinder 子类(无论本地/远程对象)都能被问“你是不是本地接口(的实现)?”
默认实现:返回 nullptr。
重写:
当拿到一个 IBinder 对象(比如从 ServiceManager::getService("xxx") 拿到的),通常会把它转换成具体的业务接口,才能使用对应的方法,主要通过interface_cast转换:
// 客户端获取服务代理
// 1. 从 ServiceManager 获取 IBinder(handle=0 是 ServiceManager 自身)
sp<IServiceManager> sm = defaultServiceManager();

// 2. 获取 "media.camera" 服务的 IBinder
// getService返回的是IBinder (实际是BpBinder)
sp<IBinder> binder = sm->getService(String16("media.camera"));

// 3. 转换为 ICameraService 接口实现
sp<ICameraService> cameraService = interface_cast<ICameraService>(binder);

if (cameraService != nullptr) {
    // 调用业务方法,实际触发 BpCameraService::connect()
    // 内部调用 BpBinder::transact 跨进程
    cameraService->connect();
}

// 同进程内“直连”优化
// 1. 在服务进程内部,创建一个本地服务实现 BnXXX
sp<BnCameraService> localImpl = new BnCameraService();
// 2. 由于 通用代码的编写 或者 某些实现 不想区分本地对象、远程Binder
// 那么转为IBinder使用
sp<IBinder> binder = localImpl->asBinder();

// 某处:需要使用具体业务时
// 3. 转换为 ICameraService 接口实现
sp<ICameraService> localInterface = interface_cast<ICameraService>(binder);

// 4. 调用时直接跳转到 BnCameraService::connect(),无 IPC 开销
localInterface->connect(); // 本地函数调用!
interface_cast实现
//尝试将一个 IBinder 对象转换为本地的 INTERFACE实现。与 asBinder对照。
//interface_cast 实际调用 INTERFACE::asInterface
template<typename INTERFACE>
inline sp<INTERFACE> interface_cast(const sp<IBinder>& obj)
{
    return INTERFACE::asInterface(obj);
}

//宏生成的逻辑 类似:
sp<ICameraService> IInterface::asInterface(const sp<IBinder>& obj)
{
    sp<IInterface> intr = obj-
        //这里调用queryLocalInterface
        //检查obj是否实现了 ICameraService 接口
        >queryLocalInterface(ICameraService::descriptor);
    if (intr != nullptr) {
        // 同进程!直接返回本地接口,绕过 BpCameraService 代理!
        return static_cast<ICameraService*>(intr.get());
    }
    //跨进程!创建 BpCameraService 代理
    return new BpCameraService(obj);
}
因此BnInterface(BBinder子类) 重写queryLocalInterface方法:若 descriptor 匹配则直接返回一个指向 this 的 sp<IInterface> 智能指针。(descriptor接口的字符串描述符,在调用IMPLEMENT_META_INTERFACE宏时指定)
BpInterface (Bpinder子类)没有重写queryLocalInterface方法,返回nullptr。
即:
- 如果
obj是本地对象(BBinder),queryLocalInterface返回非空,直接使用本地对象。 - 如果
obj是远程对象(BpBinder),queryLocalInterface返回nullptr,创建BpCameraService代理。
用途:用于判断 IBinder 是否在本地 且 实现descriptor对应的接口,如果是,则直接返回,避免 IPC。
isBinderAlive
virtual bool isBinderAlive() const;
作用:检查 Binder 服务是否存活。
BBinder 实现:BBinder 返回 true(本地对象肯定存活)。
BpBinder 实现:检查本地 mAlive 字段,mAlive字段初始化为true,如果transact时,被通知DEAD_OBJECT,设置为false。
pingBinder
virtual status_t pingBinder();
作用:发送一个空事务 PING_TRANSACTION(code = 0),用于检测服务是否响应。
用途:轻量级的存活检测。
// BpBinder 通过 transact 发送 PING
status_t BpBinder::pingBinder()
{
    Parcel data, reply;
    return transact(IBinder::PING_TRANSACTION, data, &reply, FLAGS);
}

status_t BBinder::pingBinder()
{
    return NO_ERROR;
}
在 IPC 流程中的作用
屏蔽本地/远程差异:
IInterface::asBinder()返回IBinder*,屏蔽本地/远程差异。- 使得
Parcel::writeStrongBinder()可以统一处理任何 Binder 对象。
定义能力:规定 Binder 对象能做什么(transact、引用计数、death 通知等)
它既是客户端发起 IPC 的入口,也是服务端接收事务的基类
BBinder
BBinder 是 本地 Binder 对象的具体实现,所有真正的系统服务都必须直接或间接继承自它。它是 IBinder 的子类,代表一个在当前进程内真实存在的、可被调用的服务对象。
BBinder 是整个 Binder IPC 机制中“服务端”的抽象入口。当驱动将一个事务(transaction)派发给你的进程时,最终会调用到 BBinder::transact,继而触发其子类重写的 onTransact 方法,进行具体的事务处理。
关键方法与源码逻辑
transact
这是 IBinder::transact 在 本地端(服务端)的实现。它不是由客户端直接调用,而是由 IPCThreadState 在收到驱动分发的请求后调用。
它首先会处理 Binder 机制预定义的一些通用事务(如 PING_TRANSACTION)。
对于服务自定义的事务码,它会无条件地转发给 onTransact 方法。这使得 BBinder 本身成为一个不可绕过的、通用的服务入口。
status_t BBinder::transact(
    uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags)
{
    data.setDataPosition(0);
    // ... 处理一些内置事务码 (PING, DUMP, SHELL等)
    switch (code) {
        case PING_TRANSACTION:
            err = pingBinder(); // 内置的存活检测
            break;
        // ... 其他内置事务
        default:
            // 【核心】转发调用,子类服务对象自己的实现
            err = onTransact(code, data, reply, flags);
            break;
    }
    // ... 记录日志等
    return err;
}
onTransact
这是所有服务端必须实现的核心方法,是处理所有自定义 IPC 请求的统一入口。
status_t BBinder::onTransact(
    uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags)
{
    switch (code) {
        case INTERFACE_TRANSACTION:
            // 返回服务的接口描述符(如 "android.os.IServiceManager")
            reply->writeString16(getInterfaceDescriptor());
            return NO_ERROR;
        case DUMP_TRANSACTION: {
            // 处理 dump 请求(用于调试)
            int fd = data.readFileDescriptor();
            // ... 调用 dump(fd, args);
            return dump(fd, args);
        }
        case SHELL_COMMAND_TRANSACTION: {
            // 处理 shell 命令
            return NO_ERROR;
        }
        default:
            return UNKNOWN_TRANSACTION;
    }
}
一个真正的服务(如 BnServiceManager)会(间接)继承 BBinder(通常是通过继承其子类BnInterface)。
在其 onTransact 中,使用 switch(code) 匹配自己定义的事务码,并从 data 中解析参数,向 reply 中写入返回值。
// 伪代码示例:自定义服务
status_t MyService::onTransact(uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags) {
    switch(code) {
        case MY_ADD_CODE: {
            int32_t a = data.readInt32();
            int32_t b = data.readInt32();
            reply->writeInt32(a + b);
            return NO_ERROR;
        }
        // ... 其他code
        default:
            // 先自己处理 child-first
            // 委托给父类处理通用事务
            return BBinder::onTransact(code, data, reply, flags);
    }
}
死亡通知
linkToDeath、unlinkToDeath
status_t BBinder::linkToDeath(const sp<DeathRecipient>& recipient, void* cookie, uint32_t flags) {
    // BBinder 是本地对象,拥有该对象的进程即为服务所在进程。
    // 如果服务进程挂了,整个进程都挂了,不需要“死亡通知”。
    // 因此该操作在 BBinder 上是无效的。
    return INVALID_OPERATION;
}

status_t BBinder::unlinkToDeath(
    const wp<DeathRecipient>& recipient, void* cookie, uint32_t flags,
    wp<DeathRecipient>* outRecipient)
{
    return INVALID_OPERATION;
}
在 IPC 流程中的作用
- 服务端初始化:
- 服务进程创建一个
BBinder的子类实例(如BnServiceManager)。 - 通过
ServiceManager的addService接口,将这个本地 Binder 对象注册到 Binder 驱动中。
- 服务进程创建一个
- 接收请求:
- 当客户端发起请求时,请求事务最终会通过驱动传递到服务进程。
IPCThreadState(工作线程被分配到事务)从mIn缓冲区读取到BR_TRANSACTION命令。IPCThreadState调用executeCommand,进而调用BBinder::transact。
- 处理请求:
BBinder::transact解析事务码,调用onTransact。- 实际服务子类在
onTransact中执行具体的业务逻辑,并填充reply。
- 返回结果:
onTransact返回后,BBinder::transact完成。IPCThreadState负责将reply的内容通过BC_REPLY命令写回驱动,驱动再将其转发给客户端。
BpBinder
BpBinder 是 远程 Binder 对象的代理实现,客户端持有的 Binder 对象都是此类的实例(或其子类 BpXXX)。它指代一个运行在其他进程中的服务,实际上本身不包含业务逻辑,只负责将客户端的请求序列化并通过 Binder 驱动转发给服务端,给Client一种在本地实现调用的感觉,屏蔽了IPC的感知。
它与 BBinder 构成对称结构,使得 IBinder 的 transact 方法在客户端和服务端有完全不同的实现。
关键方法与源码逻辑
binderHandle
返回此代理对象所持有的 Binder 句柄(handle)。
用途:这个句柄是 Binder 通信的核心标识符。IPCThreadState 在调用 transact 时,会将此 handle 传递给驱动,驱动根据它找到对应的binder_node,服务端 BBinder。
//BpBinder.h
Handle mHandle;
struct BinderHandle {
	int32_t handle;
};

//BpBinder.cpp
int32_t BpBinder::binderHandle() const {
    return std::get<BinderHandle>(mHandle).handle;
}
BpBinder构造函数
BpBinder::BpBinder(Handle&& handle)
      : mStability(0),
		//mHandle被赋值
        mHandle(handle),
        mAlive(true),
        mObitsSent(false),
        mObituaries(nullptr),
        mDescriptorCache(kDescriptorUninit),
        mTrackedUid(-1) {
    //延长对象的生命周期
    //告诉智能指针系统,BpBinder 对象的销毁不应仅仅依赖于 C++ 的强引用计数 (sp count),
    //还必须等待 Binder 驱动的弱引用计数也归零。
    extendObjectLifetime(OBJECT_LIFETIME_WEAK);
}

// BpBinder.cpp
BpBinder::BpBinder(BinderHandle&& handle, int32_t trackedUid)
    : BpBinder(Handle(handle)) // 委托给另一个构造函数
{
    if constexpr (!kEnableKernelIpc) {
        LOG_ALWAYS_FATAL("Binder kernel driver disabled at build time");
        return;
    }
    //安全审计和权限检查使用uid
    mTrackedUid = trackedUid;
    // 【核心】这里是注册弱引用
    //弱引用计数保存在 Binder 驱动中,用于跟踪有多少个 代理(Proxy) 在引用这个远程服务。
    //弱引用它主要用于死亡通知(Death Notification) 机制。
    IPCThreadState::self()->incWeakHandle(this->binderHandle(), this);
}
BinderHandle 是一个结构体,内有字段handle,是 Binder 驱动分配的整数句柄,是客户端访问远程服务的唯一“钥匙”。
在某个进程中,有新的 sp<IBinder> 指向某个 BpBinder 对象时(BpBinder强引用增加时),主要发生在:
getStrongProxyForHandle(int32_t handle)创建 BpBinder 时Parcel::readStrongBinder()/acquire_object()反序列化远程对象时- 任何
sp<BpBinder>拷贝、保存该对象时
与内核 binder_node 的 strong ref 增减不一致;
后者由 BC_ACQUIRE/RELEASE 控制,用于 Binder 实体的跨进程生命周期管理。
真正触发 BC_ACQUIRE 的是 BpBinder 在强引用从 0 变为 1 时调用的 onFirstRef(),向 Binder 驱动发送 BC_ACQUIRE。
transact
这是 IBinder::transact 在 客户端的实现。它是客户端发起 IPC 调用的真正起点。
// 伪代码,简化自 BpBinder.cpp
status_t BpBinder::transact(
    uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags)
{
    // Once a binder has died, it will never come back to life.
    if (mAlive) {
      	//安全检查、稳定性检查...

        status_t status;
        //build time 检查

		//binderHandle 返回当前BBinder 的句柄(handle)
        status = IPCThreadState::self()->transact(binderHandle(), code, data, reply, flags);

        if (data.dataSize() > binder::kLogTransactionsOverBytes) {
            RpcMutexUniqueLock _l(mLock);
            //如果本次 IPC 传输的数据量超过阈值
            //(通常是 160KB-1MB),就打印一条警告日志。
        }
        if (status == DEAD_OBJECT) mAlive = 0;

        return status;
    }

    return DEAD_OBJECT;
}
- 前置检查:检查
BpBinder是否有效(mAlive标志),如果服务已死,则直接返回DEAD_OBJECT。 - 获取线程状态:调用
IPCThreadState::self()获取当前线程的IPCThreadState对象。 - 委托执行:调用
IPCThreadState::transact(...),将事务请求交给它处理。
BpBinder 本身不与驱动打交道,它只是一个薄薄的代理层,真正的 IPC 通信逻辑封装在 IPCThreadState 中。
死亡通知
死亡通知的触发流程
- 服务进程崩溃 → Binder 驱动检测到 Binder 节点无强引用。
- 驱动向所有注册了死亡通知的客户端发送
BR_DEAD_BINDER命令。 - 客户端的
IPCThreadState在executeCommand中处理BR_DEAD_BINDER
//executeCommand
case BR_DEAD_BINDER: {
    BpBinder* proxy = (BpBinder*)mIn.readInt32();
    //遍历所有注册的 DeathRecipient 并调用其 binderDied 方法。
    proxy->sendObituary(); // 触发 DeathRecipient::binderDied
    mOut.writeInt32(BC_DEAD_BINDER_DONE);
    mOut.writeInt32((int32_t)proxy);
} break;
DeathRecipient
//死亡通知接收类 收到死亡通知时会调用其binderDied方法
class DeathRecipient : public virtual RefBase
{
    public:
    virtual void binderDied(const wp<IBinder>& who) = 0;
};


class MyDeathRecipient : public IBinder::DeathRecipient {
public:
    void binderDied(const wp<IBinder>& who) override {
        ALOGW("Service died! Reconnecting...");
        // 重新获取服务或清理资源
    }
};

sp<IServiceManager> sm = defaultServiceManager();
sp<IBinder> service = sm->getService(String16("my_service"));

sp<MyDeathRecipient> dr = new MyDeathRecipient();
service->linkToDeath(dr); // 注册死亡通知
linkToDeath、unlinkToDeath
struct Obituary {
    wp<DeathRecipient> recipient; // 死亡回调对象(弱引用)
    void* cookie;                 // 用户自定义上下文数据
    uint32_t flags;               // 标志位
};


//BpBinder内部维护一个Vector<Obituary>* mObituaries,用于存储所有已注册的死亡通知回调
//mObitsSent 是一个布尔标志,用于标记是否已经触发过死亡通知(防止重复触发)。

//确保 BpBinder 存活,并通知驱动
status_t BpBinder::linkToDeath(
    const sp<DeathRecipient>& recipient, void* cookie, uint32_t flags)
{
    if (isRpcBinder()) {
        //socket 实现的 binder 不走内核
    } else if constexpr (!kEnableKernelIpc) {
        // build time check
    } else {
        if (ProcessState::self()->getThreadPoolMaxTotalThreadCount() == 0) {
			//如果没有启动 Binder 线程池,死亡通知可能无法被处理!
            //死亡通知是由 Binder 驱动主动推送的 BR_DEAD_BINDER 命令。
            //如果客户端进程没有调用 ProcessState::startThreadPool() 启动监听线程,这个命令将永远无法被处理
        }
    }

    Obituary ob;
    ob.recipient = recipient;
    ob.cookie = cookie;
    ob.flags = flags;

    {
        RpcMutexUniqueLock _l(mLock);
		//如果 mObitsSent 为 true,说明服务已死,直接返回 DEAD_OBJECT。
        if (!mObitsSent) {
            //没有初始化mObituaries,注册
            //当前BpBinder对象可能被多个对象使用,他们都想监听BpBinder的死亡通知
            //以免获取到僵尸服务,因此需要使用Vector
            if (!mObituaries) {
                mObituaries = new Vector<Obituary>;
                // 【核心】向驱动 注册 死亡通知:
                //BpBinder 需要保证在驱动发送 BR_DEAD_BINDER 之前,自身BpBinder不能被销毁。
                //通过增加一个弱引用,即使所有强引用都消失了,只要死亡通知未触发,对象就不会被析构。
                getWeakRefs()->incWeak(this);
                //获取实际干活对象
                IPCThreadState* self = IPCThreadState::self();
                // 发送 BC_REQUEST_DEATH_NOTIFICATION
                self->requestDeathNotification(binderHandle(), this);
                // 确保注册命令立即发送给驱动,而不是等待下一次 transact。
                self->flushCommands();

                }
            }
        	//添加到本地列表并返回
            ssize_t res = mObituaries->add(ob);
            return res >= (ssize_t)NO_ERROR ? (status_t)NO_ERROR : res;
        }
    }

    return DEAD_OBJECT;
}

//清理资源,通知驱动停止通知
status_t BpBinder::unlinkToDeath(
    const wp<DeathRecipient>& recipient, void* cookie, uint32_t flags,
    wp<DeathRecipient>* outRecipient)
{
    if (!kEnableKernelIpc && !isRpcBinder()) {
    }

    RpcMutexUniqueLock _l(mLock);

	// 服务已死,无法通知驱动停止通知
    if (mObitsSent) {
        return DEAD_OBJECT;
    }

    const size_t N = mObituaries ? mObituaries->size() : 0;
    for (size_t i=0; i<N; i++) {
        const Obituary& obit = mObituaries->itemAt(i);
        // 匹配条件:recipient 相同,或 recipient 为 nullptr 且 cookie 相同
        if ((obit.recipient == recipient
                    || (recipient == nullptr && obit.cookie == cookie))
                && obit.flags == flags) {

            //【可选】返回被移除的 recipient
            if (outRecipient != nullptr) {
                *outRecipient = mObituaries->itemAt(i).recipient;
            }

            // 从列表中移除
            mObituaries->removeAt(i);
            //最后一次取消:向驱动注销
            //只有当 mObituaries 为空时,才向驱动发送注销命令
            if (mObituaries->size() == 0) {

                if (!isRpcBinder()) {
                    if constexpr (kEnableKernelIpc) {
                        IPCThreadState* self = IPCThreadState::self();
                        // 发送 BC_CLEAR_DEATH_NOTIFICATION
                        self->clearDeathNotification(binderHandle(), this);
                        self->flushCommands();
                    }
                }
                delete mObituaries;
                mObituaries = nullptr;
            }
            return NO_ERROR;
        }
    }

    return NAME_NOT_FOUND;
}
sendObituary
遍历所有注册的 DeathRecipient 并调用其 binderDied 方法。
void BpBinder::sendObituary()
{
    mAlive = 0; // 标记此代理已失效
    if (mObitsSent) return; // 防止重复发送

    mLock.lock();
    Vector<Obituary>* obits = mObituaries;
    if(obits != nullptr) {
        // 【关键】向驱动确认已收到死亡通知
        // 这里的发送注销命令,是向驱动确认:“我已经收到了死亡通知,请不要再发了”。
        // 这是一个必须的同步步骤。
        IPCThreadState* self = IPCThreadState::self();
        self->clearDeathNotification(binderHandle(), this);
        self->flushCommands();
        mObituaries = nullptr;
    }

    mObitsSent = 1; // 标记死亡通知已发送
    mLock.unlock();
	//触发所有回调
    if (obits != nullptr) {
        const size_t N = obits->size();
        for (size_t i=0; i<N; i++) {
            // 调用 DeathRecipient::binderDied
            reportOneDeath(obits->itemAt(i));
        }

        delete obits;
    }
}

void BpBinder::reportOneDeath(const Obituary& obit) {
    // sp<DeathRecipient>(强引用)
    //这保证了在 reportOneDeath 执行期间,DeathRecipient 对象不会被销毁。
    sp<DeathRecipient> recipient = obit.recipient.promote();
    if (recipient != nullptr) {
        recipient->binderDied(this); // 【核心回调】
    }
    // `obit` 是栈上对象,其析构会释放 `sp<DeathRecipient>` 的强引用
}
在 IPC 流程中的作用
- 客户端初始化:
- 客户端通过
getService从ServiceManager获取一个服务的IBinder对象。 - 此对象实际上是一个
BpBinder实例,其内部持有服务的handle。
- 客户端通过
- 发起请求:
- 客户端调用
BpXXX(BpBinder的子类)的某个业务方法(如add(...))。 BpXXX将参数写入Parcel,并调用基类BpBinder::transact。
- 客户端调用
- 代理转发:
BpBinder::transact获取当前线程的IPCThreadState。IPCThreadState将handle、code、data封装成驱动命令(BC_TRANSACTION),并通过ioctl发送给 Binder 驱动。
- 接收回复:
IPCThreadState阻塞等待驱动的回复(BR_REPLY)。- 收到回复后,
BpBinder::transact将replyParcel 填充好并返回,BpXXX从中解析出返回值。
ProcessState
ProcessState 是 每个使用 Binder 的进程的全局状态管理器。它是 libbinder 中最重要的单例(Singleton)类之一,代表了当前进程与 Binder 驱动(/dev/binder) 的连接。
ProcessState 负责管理进程内所有线程共用的资源,如:
- 打开并持有
/dev/binder的文件描述符(mDriverFD) - 通过
mmap映射的一块共享内存(用于高效传输数据) - 句柄(handle)到 IBinder 对象的映射表(
mHandleToObject) - 线程池的启动与配置
它是 IPCThreadState 的“父级”依赖,所有线程的 IPC 操作最终都通过 ProcessState 与驱动交互。
关键方法与源码逻辑
self
这是获取 ProcessState 实例的唯一入口,保证了一个进程只有一个 ProcessState 实例。
sp<ProcessState> ProcessState::self()
{
    return init(kDefaultDriver, false);
}

sp<ProcessState> ProcessState::init(const char* driver, bool requireDefault) {
    //相当于getter
    if (driver == nullptr) {
        std::lock_guard<std::mutex> l(gProcessMutex);
        if (gProcess) {
            //如果已经存在:
			//调用 verifyNotForked,检查是否发生过 fork 后非法使用
            verifyNotForked(gProcess->mForked);
        }
        return gProcess;
    }

    //no_destroy:避免进程退出时析构顺序问题
    //std::once_flag:保证只初始化一次
    [[clang::no_destroy]] static std::once_flag gProcessOnce;
    std::call_once(gProcessOnce, [&](){
        //校验驱动节点是否可用
        if (access(driver, R_OK) == -1) {
            driver = "/dev/binder";
        }
		//如果用 /dev/vndbinder,但系统没启 vndservicemanager,提醒
        if (0 == strcmp(driver, "/dev/vndbinder") && !isVndservicemanagerEnabled()) {

        }

        //注册 fork 回调,失败则fatal
        //ProcessState 必须感知 fork,并在子进程中禁用/重置 Binder。
        int ret = pthread_atfork(ProcessState::onFork, ProcessState::parentPostFork,ProcessState::childPostFork);

		//真正的初始化 创建全局实例
        std::lock_guard<std::mutex> l(gProcessMutex);
        gProcess = sp<ProcessState>::make(driver);
    });

    if (requireDefault) {
        //如果已经初始化过,又尝试用不同 driver 再 init,直接 fatal
    }

    verifyNotForked(gProcess->mForked);
    return gProcess;
}
它会调用内部的 init 方法,如果单例尚未创建,则用默认驱动(/dev/binder)初始化。
线程安全:通过 std::mutex(gProcessMutex)保护单例的创建。
禁止 fork 后使用:通过 verifyNotForked(mForked) 检查,因为 fork 后的子进程不能安全复用父进程的 Binder 状态。
ProcessState 构造函数
这里详细声明了一个进程的mmap区大小。
ProcessState::ProcessState(const char* driver)
      : mDriverName(String8(driver)),
        mDriverFD(-1),
        mVMStart(MAP_FAILED),
        mExecutingThreadsCount(0),
		// 通常是15
        mMaxThreads(DEFAULT_MAX_BINDER_THREADS),
        mCurrentThreads(0),
        mKernelStartedThreads(0),
        mStarvationStartTime(never()),
        mForked(false),
        mThreadPoolStarted(false),
        mThreadPoolSeq(1),
        mCallRestriction(CallRestriction::NONE) {
    String8 error;
    //打开驱动设备 返回驱动fd
    unique_fd opened = open_driver(driver, &error);

    if (opened.ok()) {
        //BINDER_VM_SIZE 通常为 1MB - 2 * PAGE_SIZE
        //可以修改为其他,但是最大 BINDER_VM_SIZE + 2*PAGE_SIZE 不超过4MB

        //在 binder_mmap() 中大致是:
		//分配 BINDER_VM_SIZE + 2*PAGE_SIZE 的 VMA
		//把首尾两页标记为不可访问,作为保护页防止溢出、越界访问
		//只把中间区域作为 Binder 的 buffer 池
		//因此直接把可用大小定义为:BINDER_VM_SIZE - 2 * PAGE_SIZE

        //如果buffer超过可用大小就会报错 出现异常
        mVMStart = mmap(nullptr, BINDER_VM_SIZE, PROT_READ, MAP_PRIVATE | MAP_NORESERVE, opened.get(), 0);
        if (mVMStart == MAP_FAILED) {
            //回退
            opened.reset();
            mDriverName.clear();
        }
    }
关键数据结构 mHandleToObject
Vector<handle_entry> mHandleToObject; //handle to BpBinder 缓存表

struct handle_entry {
    IBinder* binder; // 实际是 BpBinder*
    //为什么要用 weakref 这套逻辑?
    //允许 BpBinder 在进程内无人持有强引用时析构,
	//不会因为缓存表导致对象“永生”
    RefBase::weakref_type* refs;

};
key:handle(驱动分配的整型句柄)
value:当前进程里对应的 BpBinder 代理
目的:同一 handle 复用同一个 BpBinder 对象
getStrongProxyForHandle
根据一个 Binder 句柄(handle),获取对应的 IBinder 代理对象(BpBinder)
extern sp<BBinder> the_context_object;

sp<IBinder> ProcessState::getStrongProxyForHandle(int32_t handle)
{
    sp<IBinder> result;
    std::function<void()> postTask;

    std::unique_lock<std::mutex> _l(mLock);

    //handle == 0:约定为 Context Manager
	//如果本进程本身就是 servicemanager:
	//the_context_object 不为空 指向本地 BBinder(BnServiceManager)
	//直接返回本地对象 BBinder,不走 proxy (因为ProcessState是客户端、服务端通用的,需要优化)
    if (handle == 0 && the_context_object != nullptr) return the_context_object;

    //查表:是否已有该 handle 的代理
    handle_entry* e = lookupHandleLocked(handle);

    if (e != nullptr) {

        IBinder* b = e->binder;

        //handle对应的 BpBinder 不存在 / 已失效 → 新建 BpBinder
        //attemptIncWeak 是关键:“尝试从 weak 引用提升,如果对象还活着就成功”
		//成功:对象还在
		//失败:对象已经析构 or 从未存在 需要新建
        if (b == nullptr || !e->refs->attemptIncWeak(this)) {
            //如果 handle == 0 那么新建BpBinder前需要确认 ContextManager是否还存在
            //否则:后面创建 BpBinder 没有ContextManager就拿不到引用
            if (handle == 0) {

                IPCThreadState* ipc = IPCThreadState::self();

                Parcel data;
                //PING
                status_t status = ipc->transact(
                        0, IBinder::PING_TRANSACTION, data, nullptr, 0);

                if (status == DEAD_OBJECT)
                   return nullptr;
            }

            //创建一个新的 BpBinder(handle)
			//postTask:延后执行的任务(通常是发 BC_ACQUIRE)
            sp<BpBinder> b = BpBinder::PrivateAccessor::create(handle, &postTask);
            //更新缓存表  会被缓存到 mHandleToObject 中,供后续复用。
            e->binder = b.get();
            if (b) e->refs = b->getWeakRefs();
            result = b;
        } else {
            //handle 对应的 BpBinder 已有且还活着 → 直接复用
			//attemptIncWeak 成功时:我们临时加了一个 weak、现在要把它变成 strong:
            result.force_set(b);
            //再把刚才加的 weak 减掉:
            e->refs->decWeak(this);
        }
    }

    _l.unlock();
	//在 BpBinder::PrivateAccessor::create 里设置了postTask
	//典型是:向驱动发送 BC_ACQUIRE,为远端 binder_node 增加强引用
    if (postTask) postTask();

    return result;
}
startThreadPool
启动 Binder 线程池,用于接收和处理来自其他进程的 IPC 请求。
void ProcessState::startThreadPool()
{
    if (!mThreadPoolStarted) {
        mThreadPoolStarted = true;
        spawnPooledThread(true); // 启动主线程
    }
}
它会调用 spawnPooledThread 创建一个新的线程,该线程会执行 IPCThreadState::joinThreadPool,线程从而进入一个无限循环,等待并处理驱动的 BR_ 命令。(尤其是BR_TRANSACTION)
服务端进程必须调用此方法,否则即使注册了服务,也无法响应任何请求。
spawnPooledThread
void ProcessState::spawnPooledThread(bool isMain)
{
    if (mThreadPoolStarted) {
        String8 name = makeBinderThreadName();
        //调用PoolThread构造方法
        sp<Thread> t = sp<PoolThread>::make(isMain);
        //PoolThread 继承自 android::Thread

		//run() 会创建一个新的 native 线程
		//新线程入口是 PoolThread::threadLoop()
        t->run(name.c_str());
        mKernelStartedThreads++;
    }
}

bool PoolThread::threadLoop() {
    IPCThreadState::self()->joinThreadPool(mIsMain);
    return false; // 线程结束
}
线程一启动,就进入 IPCThreadState::joinThreadPool()。
becomeContextManager
将当前进程注册为 Context Manager,即 ServiceManager。
bool ProcessState::becomeContextManager()
{
    flat_binder_object obj {
        .flags = FLAT_BINDER_FLAG_TXN_SECURITY_CTX,
    };
    int result = ioctl(mDriverFD, BINDER_SET_CONTEXT_MGR_EXT, &obj);
    // ... 错误处理和回退
    return result == 0;
}
这是一个特权操作,只有 servicemanager 进程有权限成功调用。
调用成功后,该进程就成为了系统中所有 Binder 服务的“总注册表”,其他服务通过 addService、getService 与之交互。
giveThreadPoolName
为当前线程池中的线程设置一个有意义的名字,例如 "Binder:1234_1"。
用于调试,做Framework开发比较有用。
expungeHandle
当一个 BpBinder 对象被销毁时,通知 ProcessState 清理其在 mHandleToObject 中的缓存。
void ProcessState::expungeHandle(int32_t handle, IBinder* binder)
{
    if (e && e->binder == binder) e->binder = nullptr;
}
这是 打破 BpBinder 和 ProcessState 之间循环引用的关键,确保对象可以被正确回收。
在 IPC 流程中的作用
-
ServiceManager初始化:
- 提供了
becomeContextManager()方法,这是 将ServiceManager进程注册为 Binder 驱动上下文管理者(Context Manager) 的关键入口。ServiceManager 进程 在启动时会调用此方法,向 Binder 驱动注册自己为handle = 0的全局服务。 - 一旦注册成功,所有其他进程都可以使用
handle = 0通过ProcessState与驱动交互来获取 ServiceManager 的代理对象(BpBinder),从而使用其addService/getService接口。
- 提供了
-
获取ServiceManager:
- 进程首次调用
defaultServiceManager()获取 ServiceManager 代理时,底层会调用ProcessState::getStrongProxyForHandle(0), - 然后创建并缓存一个
BpBinder实例作为ServiceManager代理对象,这保证了 每个进程内只有一个 ServiceManager 代理对象,避免重复创建和资源浪费。
- 进程首次调用
-
客户端初始化:
- 进程首次使用 Binder 时,
ProcessState::self()被调用,打开驱动并mmap内存。 - 调用
getService时,ProcessState根据句柄创建并缓存BpBinder。
- 进程首次使用 Binder 时,
-
服务端初始化:
- 服务进程创建
BBinder子类实例。 - 调用
ProcessState::self()->startThreadPool()启动接收线程。 - 通过
ServiceManager::addService将自己注册到驱动,驱动会为该服务分配一个唯一的handle。
- 服务进程创建
-
服务端接收请求:
- 内核驱动收到客户端的请求后,会唤醒服务端进程中的一个 Binder 线程。
- 该线程的
IPCThreadState会从ProcessState的mmap内存中读取事务数据。
-
对象生命周期管理:
ProcessState作为handle到BpBinder的中央缓存,确保了同一个远程服务在进程中只有一个代理对象,避免了资源浪费。- 通过
expungeHandle确保了对象的及时清理。
与 IPCThreadState 的关系
ProcessState是进程级单例,IPCThreadState是线程级局部变量(TLS)。- 每个
IPCThreadState都持有一个sp<ProcessState>的引用。
IPCThreadState
IPCThreadState 是 每个使用 Binder 的线程的状态管理器(mIn, mOut 缓冲区)。它封装了与 Binder 驱动交互的核心逻辑,负责管理线程私有的 Parcel 缓冲区(mIn, mOut)和执行具体的 ioctl 通信。
关键方法与源码逻辑
self
self的结果就是 每个线程有同一个TLS Key,但是对应的IPCThreadState不同,存储在各自的TLS上。
为什么需要各线程一个IPCThreadState,因为 IPCThreadState 内部持有一对 线程私有的 Parcel 缓冲区:
mIn:用于接收 Binder 驱动返回的命令(如BR_TRANSACTION、BR_REPLY)。mOut:用于暂存要发送给驱动的命令(如BC_TRANSACTION)。
如果多个线程共享同一个 IPCThreadState,就会导致 mIn/mOut 的读写发生竞争(race condition),造成命令错乱或数据损坏。
IPCThreadState* IPCThreadState::self()
{
    //std::memory_order_acquire load 屏障
    //gHaveTLS 是一个全局的原子布尔变量,标记 TLS key 是否已经初始化成功。
    if (gHaveTLS.load(std::memory_order_acquire)) {
	restart: //注意这个tag
        //读TLS key
        const pthread_key_t k = gTLS;
        //尝试从当前线程的 TLS 中获取与 key k 关联的值。
        IPCThreadState* st = (IPCThreadState*)pthread_getspecific(k);
        //如果 TLS 中已有对象,直接返回。这是最常见、最高效的场景。
		//如果 TLS 中没有对象,说明是当前线程第一次调用 self()。
		//此时,在不加锁的情况下直接 new 一个 IPCThreadState 对象。(TLS无需锁)
		//IPCThreadState的构造函数内部会自动调用 pthread_setspecific(gTLS, this),
        //将自己与当前线程的 TLS 绑定。这样,下次再调用 self() 就能直接命中。
        if (st) return st;
        return new IPCThreadState;
    }

    //gShutdown 是另一个全局原子变量,用于标记 libbinder 是否正在被关闭(例如进程退出时)。
	//在关闭过程中,TLS key 可能会被销毁。
    //此时再创建新的 IPCThreadState 对象是不安全的,会导致未定义行为。
    //std::memory_order_relaxed 无内存屏障 只保证原子性
    if (gShutdown.load(std::memory_order_relaxed)) {
        return nullptr;
    }

    //lock 保护 TLS key 的初始化过程,由于key表是在全局(程序级别)的,分配需要锁
    //因为 pthread_key_create 只需要调用一次
    pthread_mutex_lock(&gTLSMutex);
    if (!gHaveTLS.load(std::memory_order_relaxed)) {
        //gTLS:这是一个全局的变量,用于存储 TLS key。
        int key_create_value = pthread_key_create(&gTLS, threadDestructor);
        //初始化成功后,将 gHaveTLS 设为 true,
        //store屏障 std::memory_order_release
        gHaveTLS.store(true, std::memory_order_release);
    }
    pthread_mutex_unlock(&gTLSMutex);

	//释放锁后,跳转回 restart 标签,重新走“快速路径”。
	//此时 gHaveTLS 已经是 true,并且 gTLS 也已初始化好,
    //所以会成功进入 pthread_getspecific 的逻辑,并最终 new 出对象。
    goto restart;
}
关键数据结构
由于IPCThreadState是主要的事务类,所以有很多关键的数据结构。
Parcel mIn; //存放即将通过 ioctl 发送给驱动的 命令+tr
Parcel mOut; //存放从驱动读回的 命令+tr

struct TransactionState {
    binder_transaction_data tr;
    TransactionState* next;
};
TransactionState* mTransactionStack;
//当线程收到 BR_TRANSACTION:push 一个 TransactionState
//当处理完并 reply:pop
//支持场景:A 调 B,B 在 onTransact 里又调 C,C 返回 → B → A


sp<ProcessState> mProcess;
//指向进程唯一的 ProcessState,
//提供:
//binder fd:mDriverFD
//驱动名:/dev/binder、/dev/vndbinder
//线程池状态:mMaxThreads mCurrentThreads mExecutingThreadsCount
//handle → BpBinder 映射表
//mmap 的 binder VM 区域
writeTransactionData
status_t IPCThreadState::writeTransactionData(
    int32_t cmd,
    uint32_t binderFlags,
    int32_t handle,
    uint32_t code,
    const Parcel& data,
    status_t* statusBuffer)
{
    binder_transaction_data tr;

    tr.target.ptr = 0;
    tr.target.handle = handle;
    tr.code = code;
    tr.flags = binderFlags;
    tr.cookie = 0;
    tr.sender_pid = 0;
    tr.sender_euid = 0;

    const status_t err = data.errorCheck();
    if (err == NO_ERROR) {
        //size在发送前就计算了 考虑柔性数组
        tr.data_size = data.ipcDataSize();
        //指向 Parcel 内部 buffer 的指针
        tr.data.ptr.buffer = data.ipcData();
        //size在发送前就计算了 考虑柔性数组
        tr.offsets_size = data.ipcObjectsCount()*sizeof(binder_size_t);
        //指向 offsets 数组的指针
        tr.data.ptr.offsets = data.ipcObjects();
    } else if (statusBuffer) {
        //如果 Parcel 本身有 error
        tr.flags |= TF_STATUS_CODE;
        *statusBuffer = err;
        tr.data_size = sizeof(status_t);
        //把错误码当成 transaction data 发送。
        tr.data.ptr.buffer = reinterpret_cast<uintptr_t>(statusBuffer);
        tr.offsets_size = 0;
        tr.data.ptr.offsets = 0;
    } else {
        return (mLastError = err);
    }


    //命令 cmd(如 BC_TRANSACTION)以及 tr
	//顺序写入到 mOut 缓冲区:
    //这个缓冲区很眼熟:[BC_XXX][tr(payload)] [BC_YYY][tr(payload)]...
    mOut.writeInt32(cmd);
    mOut.write(&tr, sizeof(tr));

    return NO_ERROR;
}
之后在 talkWithDriver() / waitForResponse() 中:
把 mOut.data() 指向的内存交给binder_write_read bwr,调用ioctl(... &bwr),作为arg参数,传递给驱动,然后驱动拷贝这个bwr到内核空间上的bwr使用,然后进行binder_ioctl_write_read。
transact
这是 BpBinder::transact 的最终委托对象,负责发起一次完整的 Binder 事务。
源码逻辑(核心流程):
- 写入
mOut缓冲区:- 调用
writeTransactionData(BC_TRANSACTION, ...),将handle,code,data序列化成驱动命令,写入mOut缓冲区。
- 调用
- 与驱动通信:
- 调用
waitForResponse(reply, &acquireResult),阻塞等待回复。
- 调用
status_t IPCThreadState::transact(int32_t handle,
                                  uint32_t code,
                                  const Parcel& data,
					//这里是BpBinder传过来的,希望接收到命令+tr[payload]的地址
                                  Parcel* reply,
                                  uint32_t flags)
{
    status_t err;
    flags |= TF_ACCEPT_FDS;

    //把用户态参数打包成 binder_transaction_data tr
	//写入到:mOut
	//通过 ioctl(BINDER_WRITE_READ) 送到驱动,常见code是:BC_TRANSACTION
    //向 Binder 驱动发起一次事务,请求发送给 handle 对应的远端 binder_node。

    //注意:writeTransactionData中把 payload 地址 & 大小填入 tr
    err = writeTransactionData(BC_TRANSACTION, flags, handle, code, data, nullptr);

    if (err != NO_ERROR) {
        if (reply) reply->setError(err);
        return (mLastError = err);
    }

    //TF_ONE_WAY:异步调用
	//客户端不阻塞
	//服务端也不回 BR_REPLY
    if ((flags & TF_ONE_WAY) == 0) {
        // 同步调用,需要等 reply

        //进入阻塞
        //内部会循环:ioctl(BINDER_WRITE_READ),读取驱动返回的 BR_* 命令
        //直到收到:BR_REPLY 或 BR_DEAD_REPLY 或 错误
        if (reply) {
            //需要回复,那么需要填充reply,不用返回,BpBinder读地址即可
            err = waitForResponse(reply);
        } else {
            //不用回复
            Parcel fakeReply;
            err = waitForResponse(&fakeReply);
        }

    } else {
        // 异步调用,不等 reply
        // why 也调用了 waitForResponse?
        // 但仍需要刷新 mOut buffer 从而处理驱动返回的控制命令(如BR_TRANSACTION_COMPLETE)
        err = waitForResponse(nullptr, nullptr);
    }

    return err;
}
waitForResponse
向 Binder 驱动发送请求后,不断和驱动交互,直到等到服务端返回的 BR_REPLY(或特定的命令、错误),并把结果填到 reply 中。(有的BR_命令是不会结束循环的)
waitForResponse(): 开启循环调用talkWithDriver,读 cmd,调用executeCommand()
talkWithDriver(): ioctl 交换数据
executeCommand(): 真正处理每个 BR_ 命令*
status_t IPCThreadState::waitForResponse(Parcel* reply, status_t* acquireResult){
    while (1) {
        // ioctl 和驱动交互,发送命令+数据,直到读回命令+数据到 mIn
        if ((err=talkWithDriver()) < NO_ERROR) break;

        if (mIn.dataAvail() == 0)
            continue;

        uint32_t cmd = mIn.readInt32();
        //处理传回来的命令+数据
        switch (cmd) {
            case BR_TRANSACTION_COMPLETE:
                // 驱动通知:请求已送达对端
                // 没有return 继续循环
                break;
            case BR_REPLY: {
                binder_transaction_data tr;
                //读取服务端回复的,经过驱动转发的tr
                mIn.read(&tr, sizeof(tr));

                //ipcSetDataReference() 并不拷贝数据
                //而是让 Parcel 直接指向mmap区里的那块buffer
                //并注册freeBuffer回调,在Parcel析构时通知驱动释放这块 buffer。
                reply->ipcSetDataReference(
                    (uint8_t*)tr.data.ptr.buffer,
                    tr.data_size,
                    (binder_size_t*)tr.data.ptr.offsets,
                    tr.offsets_size / sizeof(binder_size_t),
                    freeBuffer);

                return NO_ERROR;
            }

            case BR_DEAD_REPLY:
                return DEAD_OBJECT;

            default:
                executeCommand(cmd);   // 处理别的BR命令
                break;
        }
    }
	return err;
}
talkWithDriver
与 Binder 驱动进行实际的 ioctl 通信。这是 libbinder 与内核交互的唯一入口。 根据 ioctl 返回结果,更新 mOut 和 mIn 的数据指针和大小。
status_t IPCThreadState::talkWithDriver(bool doReceive) {
    binder_write_read bwr;

   	//是否需要读?
    //mIn:上一次从驱动读回来的命令流
    //如果已经读完,才需要再向驱动要新数据
    bool needRead = mIn.dataPosition() >= mIn.dataSize();
    //本次能写多少?mOut.dataSize() 还是 0 ?
    //如果:不要求接收新的 || 要接收新的且当前读完了
	//才把 mOut 里的命令发给驱动
	//否则先消费完旧输入,再允许写,以避免乱序
    size_t outAvail = (!doReceive || needRead) ? mOut.dataSize() : 0;

    bwr.write_size   = outAvail;
    //指向mOut缓冲区 用于发送数据
    bwr.write_buffer = (uintptr_t)mOut.data();

    if (doReceive && needRead) {
        bwr.read_size   = mIn.dataCapacity();
        //指向mIn缓冲区 用于接收数据
        bwr.read_buffer = (uintptr_t)mIn.data();
    } else {
        bwr.read_size = 0;
        bwr.read_buffer = 0;
    }

    //没事可做就返回
    if (bwr.write_size == 0 && bwr.read_size == 0)
        return NO_ERROR;

    do {
        //陷入系统调用 进入 binder_ioctl() 传递bwr
        //内核会:解析 bwr.write_buffer 里的:BC_
		//处理后,把返回命令写入 bwr.read_buffer:BR_
		//更新:bwr.write_consumed、bwr.read_consumed
        err = ioctl(fd, BINDER_WRITE_READ, &bwr);
    } while (err == -EINTR);

    if (err >= 0) {
        //写缓冲已被消费
        if (bwr.write_consumed > 0){
            //清空 mOut
			//处理写后需要做的释放引用,节约空间
            mOut.setDataSize(0);
        	processPostWriteDerefs();
		}

        //从驱动读回:BR_REPLY或其它事件(死亡通知、引用管理等)
		//结果放进 mIn 这个 Parcel 缓冲区
        if (bwr.read_consumed > 0) {
            //驱动往 mIn.data() 里写了命令流,设置可读大小
			//后续 waitForResponse() 会解析:
            mIn.setDataSize(bwr.read_consumed);
            mIn.setDataPosition(0);
        }
        return NO_ERROR;
    }
    return err;
}
executeCommand
用户态处理 BR 命令的解释器(不处理BR_REPLY),执行各种动作:
- 同步 RefBase 引用计数
- 分发远程调用到
BBinder::onTransact() - 处理死亡通知、线程管理和错误
- 并在需要时回写对应的
BC_*命令给驱动。
status_t IPCThreadState::executeCommand(int32_t cmd)
{
    BBinder* obj;
    RefBase::weakref_type* refs;
    status_t result = NO_ERROR;

    switch ((uint32_t)cmd) {

        //驱动要你增加强引用
        case BR_ACQUIRE:
            //...
            break;

        case BR_RELEASE:
            //... 有两个队列 另外一个是mPendingWeakDerefs 解弱引用用的
            mPendingStrongDerefs.push(obj);
            break;

            //驱动要你增加弱引用
        case BR_INCREFS:
            //需要你在用户态对应的 BBinder 上 incWeak()
            //然后回复驱动:我已经处理完了
            refs = (RefBase::weakref_type*)mIn.readPointer();
            obj = (BBinder*)mIn.readPointer();
            refs->incWeak(mProcess.get());
            //回复驱动:我已经处理完
            mOut.writeInt32(BC_INCREFS_DONE);
            mOut.writePointer((uintptr_t)refs);
            mOut.writePointer((uintptr_t)obj);
            break;

        case BR_DECREFS:
            //这里只是先放入队列,真正的解引用会在:
            //写操作完成后(processPostWriteDerefs)统一处理,
            //避免和正在使用对象的代码冲突。
            refs = (RefBase::weakref_type*)mIn.readPointer();
            obj = (BBinder*)mIn.readPointer();
            mPendingWeakDerefs.push(refs);
            break;

        case BR_TRANSACTION_SEC_CTX:
        case BR_TRANSACTION:
            {
                binder_transaction_data_secctx tr_secctx;
                binder_transaction_data& tr = tr_secctx.transaction_data;

                result = mIn.read(&tr, sizeof(tr));
                tr_secctx.secctx = 0;

                Parcel buffer;
                //让 Parcel 直接指向当前进程mmap共享区里的 事务数据(客户端发来的)

                buffer.ipcSetDataReference(
                    reinterpret_cast<const uint8_t*>(tr.data.ptr.buffer),
                    tr.data_size,
                    reinterpret_cast<const binder_size_t*>(tr.data.ptr.offsets),
                    tr.offsets_size/sizeof(binder_size_t),
                    freeBuffer
                );


                Parcel reply; //回复的具体事务数据 具体在BBinder transact中被设置
                status_t error;


                //tr.target.ptr 指向 本进程中某个 BBinder 的 weakref(弱引用控制块)
				//tr.cookie 指向 该 BBinder 对象本身

                //关键!!!!!!!!!!!
                //根据内核传回的事务信息,找到本进程中的目标 BBinder 对象
                if (tr.target.ptr) { //确认是本地对象,不是则为null (false)

                    //通过弱引用临时转强引用保证其存活
                    if (reinterpret_cast<RefBase::weakref_type*>(tr.target.ptr)->attemptIncStrong(this)) {
                        //然后调用其 transact()、onTransact() 执行业务逻辑
                        error =
                            reinterpret_cast<BBinder*>(tr.cookie)->transact(tr.code, buffer, &reply, tr.flags);
                        //最后释放引用
                        reinterpret_cast<BBinder*>(tr.cookie)->decStrong(this);
                    }

                }
                //BBinder transact调用后 Parcel reply被填充

                //没有 TF_ONE_WAY → 同步调用 → 必须回 BR_REPLY
				//有 TF_ONE_WAY → 异步调用 → 不回包
                if ((tr.flags & TF_ONE_WAY) == 0) {
                    buffer.setDataSize(0);

                    //里面调用了waitForResponse,发送BC_REPLY,让驱动协调回BR_REPLY
                    sendReply(reply, (tr.flags & kForwardReplyFlags));
                } else {
                    //不回包
                    if (error != OK) {}
                }

            }
            break;

        case BR_DEAD_BINDER:
            //发送死亡通知
            {
                BpBinder *proxy = (BpBinder*)mIn.readPointer();
                proxy->sendObituary();
                mOut.writeInt32(BC_DEAD_BINDER_DONE);
                mOut.writePointer((uintptr_t)proxy);
            } break;

        case BR_CLEAR_DEATH_NOTIFICATION_DONE:{
            //注销 需要死亡通知
            BpBinder *proxy = (BpBinder*)mIn.readPointer();
            proxy->getWeakRefs()->decWeak(proxy);
        } break;

        case BR_SPAWN_LOOPER:
            //让你多开线程
            mProcess->spawnPooledThread(false);
            break;

        default:
            result = UNKNOWN_ERROR;
            break;
    }

    if (result != NO_ERROR) {
        mLastError = result;
    }

    return result;
}

status_t IPCThreadState::sendReply(const Parcel& reply, uint32_t flags)
{
    status_t err;
    status_t statusBuffer;
    err = writeTransactionData(BC_REPLY, flags, -1, 0, reply, &statusBuffer);
    if (err < NO_ERROR) return err;

    return waitForResponse(nullptr, nullptr);
}
joinThreadPool
调用joinThreadPool、getAndExecuteCommand 的 looper 线程是“服务端线程”,它不会收到 BR_REPLY。
BR_REPLY 是发给发起同步调用、正在 waitForResponse() 的客户端线程的。
void IPCThreadState::joinThreadPool(bool isMain)
{

    mProcess->checkExpectingThreadPoolStart();
    mProcess->mCurrentThreads++;
    //向驱动声明:我要当 looper 了:主线程进入循环 或者 普通工作线程注册
    //这样在binder_thread_read中才能被投递事务到todo队列 然后唤醒
    //不是立即发送 而是等待talkWithDriver进行下一次ioctl
    mOut.writeInt32(isMain ? BC_ENTER_LOOPER : BC_REGISTER_LOOPER);

    //表示这是一个可以被驱动调度来处理事务的线程。
    mIsLooper = true;
    status_t result;
    do {
        // 1. 清理之前积累的 待处理的弱/强引用释放请求
        processPendingDerefs();
        //调用了 talkWithDriver excuteCommand
        //从驱动取下一条 BR_* 命令,并立刻执行
        result = getAndExecuteCommand();

        //普通线程:超时 TIMED_OUT 可退出,节省资源
		//主线程:常驻,除非触发以下
		//连接断开 / fd 无效:必须退出

        if (result < NO_ERROR && result != TIMED_OUT && result != -ECONNREFUSED && result != -EBADF) {
            FATAL
        }

        if(result == TIMED_OUT && !isMain) {
            break;
        }
    } while (result != -ECONNREFUSED && result != -EBADF);

    //退出线程池时通知驱动
    mOut.writeInt32(BC_EXIT_LOOPER);
    mIsLooper = false;
    talkWithDriver(false);

    size_t oldCount = mProcess->mCurrentThreads.fetch_sub(1);
    //空池 fatal
}
getAndExecuteCommand
status_t IPCThreadState::getAndExecuteCommand()
{
    status_t result;
    int32_t cmd;

    //进行ioctl 交换 BC_/BR_
    result = talkWithDriver();

    if (result >= NO_ERROR) {
        size_t IN = mIn.dataAvail();
        if (IN < sizeof(int32_t)) return result;
        //读一个 BR_
        cmd = mIn.readInt32();

        //统计“正在执行的线程数”
        size_t newThreadsCount = mProcess->mExecutingThreadsCount.fetch_add(1) + 1;
        //如果执行中的线程 ≥ 最大值,就记录开始饥饿时间。
        if (newThreadsCount >= mProcess->mMaxThreads) {
            auto expected = ProcessState::never();
            mProcess->mStarvationStartTime
                    .compare_exchange_strong(expected, std::chrono::steady_clock::now());
        }

		// 真正处理
        result = executeCommand(cmd);

        //结束一次处理,减少计数
        size_t maxThreads = mProcess->mMaxThreads;
        newThreadsCount = mProcess->mExecutingThreadsCount.fetch_sub(1) - 1;

        if (newThreadsCount < maxThreads) {
            if (starvationStartTime != ProcessState::never()) {
                if (starvationTime > 100ms) {
                    //如果之前发生过饥饿,且持续时间 > 100ms
                }
            }
        }


        //唤醒等待“空闲线程”的
        if (mProcess->mOnThreadAvailableWaiting > 0) {
            std::lock_guard lock_guard_(mProcess->mOnThreadAvailableLock);
            mProcess->mOnThreadAvailableCondVar.notify_all();
        }
    }

    return result;
}
线程执行方法逻辑
客户端线程调用:
(BpBinder::transact转发给IPCThreadState::transact)
IPCThreadState::transact → 向驱动发送BC_TRANSACTION → waitForResponse→ talkWithDriver获取命令 & 主要处理 BR_REPLY,如果是其他命令 →executeCommand→ 处理 BR_
服务端线程调用:
joinThreadPool → getAndExecuteCommand → talkWithDriver获取命令 → executeCommand → 处理 BR_ → BBinder::transact获取要返回的数据reply → sendReply向驱动送BC_REPLY+reply
驱动找到发起BC_TRANSACTION ,转发BR_REPLY + reply 。
一个进程既可以当服务端也可以当客户端(注意优先是服务端,才能再是客户端):
(looper线程)
IPCThreadState::joinThreadPool
    -> IPCThreadState::executeCommand(BR_TRANSACTION)   // 服务端角色
      -> BBinder::onTransact() //!如果调用了其他进程的服务
          -> BpBinder->getBattery()
              -> IPCThreadState::transact()
                  -> waitForResponse()   // 此时线程临时变成客户端角色
                  -> 收到 BR_REPLY
      <- onTransact() //继续executeCommand
      -> sendReply()  // 回给最初的客户端
<- joinThreadPool() //继续joinThreadPool
同步调用时:
发起调用的线程进入 transaction stack,睡眠等待 reply,reply 只会被投递回这个等待的线程。
服务端处理完:通过 BC_REPLY,驱动找到原始调用线程,给它一个 BR_REPLY。
因此:BR_REPLY 是“定向投递”的,只发给发起 transact 的线程。
flushCommands
强制将 mOut 中的命令立即发送给驱动。
void IPCThreadState::flushCommands()
{
    if (mProcess->mDriverFD < 0)
        return;
    talkWithDriver(false);
    //刷新操作可能导致写入后引用计数递减操作被执行,
    //这反过来又可能导致BC_RELEASE/BC_DECREFS被排队到 mOut 中。
    //因此,如果需要,请再次刷新。
    if (mOut.dataSize() > 0) {
        talkWithDriver(false);
    }
    if (mOut.dataSize() > 0) {
        ALOGW("mOut.dataSize() > 0 after flushCommands()");
    }
}
在 IPC 流程中的作用
客户端视角
- 发起调用:
BpXXX->BpBinder::transact->IPCThreadState::transact。 - 序列化:
IPCThreadState::transact调用writeTransactionData将请求写入mOut。 - 阻塞等待:
IPCThreadState::transact调用waitForResponse,进入talkWithDriver的ioctl。 - 接收回复:驱动将
BR_REPLY写入mmap内存,ioctl返回,waitForResponse解析mIn并填充reply。
服务端视角
- 接收请求:
joinThreadPool循环中,talkWithDriver收到BR_TRANSACTION命令。 - 分发处理:
executeCommand(BR_TRANSACTION)调用BBinder::transact。 - 发送回复:
BBinder::transact执行完毕后,sendReply将结果写入mOut,并通过talkWithDriver发回。
与 ProcessState 和 Bp/BBinder 的协作
- 数据载体:
IPCThreadState的mIn/mOut是Parcel,它依赖ProcessState的mmap内存来高效传递数据。 - 对象桥梁:
- 客户端:
BpBinder提供handle,IPCThreadState用它构造BC_TRANSACTION。 - 服务端:驱动提供
BBinder的指针,IPCThreadState用它调用 对应的BBinder::transact。
- 客户端:
- 生命周期:
IPCThreadState负责处理BR_ACQUIRE/BR_RELEASE,维护BBinder的引用计数。
BnInterface
服务端对象模板
Bn、BpInterface 将 业务接口(IInterface 的子类) 与 Binder 的本地/远程实现(BB、Bpinder) 无缝粘合在一起。是 代码生成的桥梁,使得我们可以用 AIDL 或手动编写的方式,定义一个干净的业务接口(如 IMyService),然后 libbinder 自动为我们生成客户端代理(BpMyService)和服务端存根(BnMyService)的代码框架。
它们是 libbinder “面向接口编程” 思想的最终体现。
//IInterface.h
template <typename INTERFACE>
class LIBBINDER_EXPORTED BnInterface : public INTERFACE, public BBinder {
public:
    virtual sp<IInterface>      queryLocalInterface(const String16& _descriptor);
    virtual const String16&     getInterfaceDescriptor() const;
    typedef INTERFACE BaseInterface;

protected:
    virtual IBinder*            onAsBinder();
};
BnInterface 同时继承自 INTERFACE(实际写的业务接口,如 IMyService)和 BBinder。
最终服务实现类:写的真正服务类(如 MyService)会继承 BnInterface<IMyService>,从而变成:
class MyService : public BnInterface<IMyService> {
    // 实现 IMyService、BBinder、BnInterface 的所有业务方法
    // 继承了 BBinder::transact,其内部会调用 onTransact
};
关键方法与源码逻辑
onAsBinder
当上层代码调用 IInterface::asBinder() 时,会委托给 onAsBinder。当 服务端对象 (BnXXX) 需要将自己转换为 IBinder 时(例如注册到 ServiceManager),asBinder() 会返回一个指向自身的 IBinder 指针(即 BBinder),表明这是一个本地对象。
template<typename INTERFACE>
IBinder* BnInterface<INTERFACE>::onAsBinder()
{
    return this; // 返回 this,继承BnInterface,那么服务就在本地
}
getInterfaceDescriptor
template<typename INTERFACE>
inline const String16& BnInterface<INTERFACE>::getInterfaceDescriptor() const
{
    return INTERFACE::getInterfaceDescriptor();
}
返回接口的唯一描述符(如 "com.example.IMyService")。
用途:在 Parcel 传输 IBinder 对象和 onTransact 的 INTERFACE_TRANSACTION 中用于校验接口类型。
queryLocalInterface
调用queryLocalInterface时,传入的是 期望的业务接口::descriptor。
template<typename INTERFACE>
inline sp<IInterface> BnInterface<INTERFACE>::queryLocalInterface(
        const String16& _descriptor)
{
    //如果 _descriptor 等于当前接口的descriptor,那么返回一个this指针
    // _descriptor 理解为 待检测obj的INTERFACE::descriptor
    // 这里 INTERFACE::descriptor理解为 this INTERFACE::descriptor
    if (_descriptor == INTERFACE::descriptor) return sp<IInterface>::fromExisting(this);
    //否则返回 nullptr
    return nullptr;
}
**检查是否是 _descriptor 所代表的接口的本地实现?如果是,返回指向自己的 IInterface 指针;如果不是,返回 nullptr。**用于转换业务对象的判断,优化、减少IPC。
详细作用见 IBinder#queryLocalInterface。
BpInterface
注意:BpInterface 并非直接继承 BpBinder,而是继承 BpRefBase。BpBinder 本身继承自 BpRefBase,因此 BpXXX 会通过组合持有 BpBinder。
客户端对象模板
template <typename INTERFACE>
class LIBBINDER_EXPORTED BpInterface : public INTERFACE, public BpRefBase {
public:
    explicit                    BpInterface(const sp<IBinder>& remote);
    typedef INTERFACE BaseInterface;

protected:
    virtual IBinder*            onAsBinder();
};
关键方法与源码逻辑
onAsBinder
当上层代码调用 IInterface::asBinder() 时,会委托给 onAsBinder。当 客户端 需要将代理对象(BpXXX)转换为 IBinder 时(例如传递给另一个进程),asBinder() 会返回内部的 BpBinder 对象。
template<typename INTERFACE>
sp<IInterface> BpInterface<INTERFACE>::onAsBinder()
{
    return remote(); // 返回 BpBinder 的基类指针
}

//Binder.h
LIBBINDER_EXPORTED inline IBinder* remote() const { return mRemote; }
getInterfaceDescriptor
//默认实现
sp<IInterface> BpInterface<INTERFACE>::queryLocalInterface(
        const String16& _descriptor)
{
    //返回 nullptr
    return nullptr;
}
详细作用见 IBinder#queryLocalInterface。
构造函数 BpInterface
template<typename INTERFACE>
inline BpInterface<INTERFACE>::BpInterface(const sp<IBinder>& remote)
    : BpRefBase(remote)
{
}
客户端代理对象(BpXXX)通过这个构造函数,将一个通用的 IBinder(从 ServiceManager 获取的)通过此构造函数将 BpXXX 与一个 BpBinder(由 handle 创建)关联起来,使得 remote()、onAsBinder能工作。
BpRefBase 的作用:持有一个 IBinder* mRemote。这使得 BpXXX 可以通过 remote() 方法获取到对应的 BpBinder。
在 IPC 流程中的作用
BnInterface 自动继承了 BBinder 和 业务接口,你只需专注 onTransact 中的业务逻辑(或交给 AIDL)。
BpInterface 自动继承了业务接口,组合了BpBinder ,AIDL 会生成所有代理方法。
服务端(BnInterface)
- 实现
MyService : public BnInterface<IMyService>。 onTransact(由 AIDL 生成),处理IMyService的所有方法。- 通过
asBinder()拿到IBinder,注册到ServiceManager。
客户端(BpInterface)
- 通过
ServiceManager::getService()拿到一个IBinder(实际上是BpBinder)。 - 将其转换为
BpMyService(new BpMyService(remote))。 - 调用
BpMyService的myMethod(),该方法内部会自动调用BpBinder::transact。
以Parcel开始的数据流动视角(重点)
介绍
- 作为数据载体,保存数据、对象、偏移表
- 给开发者提供
write/readAPI
uint8_t* mData;      // 数据区
size_t   mDataSize; // 已用大小
size_t   mDataPos;  // 读写位置
binder_size_t*  mObjects;  // offsets 表(flat_binder_object 等)
size_t          mObjectsSize;

status_t            writeInt32(int32_t val);
status_t            writeUint32(uint32_t val);
status_t            writeInt64(int64_t val);
status_t            writeUint64(uint64_t val);
status_t            writeFloat(float val);
status_t            writeDouble(double val);
status_t            writeCString(const char* str);
status_t            writeString8(const String8& str);
...
status_t            readInt32(int32_t *pArg) const;
uint32_t            readUint32() const;
status_t            readUint32(uint32_t *pArg) const;
int64_t             readInt64() const;
status_t            readInt64(int64_t *pArg) const;
uint64_t            readUint64() const;
status_t            readUint64(uint64_t *pArg) const;
...

//传递IBinder对象
status_t Parcel::writeStrongBinder(const sp<IBinder>& val)
{
    return flatten_binder(ProcessState::self(), val, this);
}
数据是如何流动的
Native层简介
【请求阶段:Client → Server】
- Client Parcel 的 buffer 用户虚拟地址 → 内核通过 kmap 临时映射到同一物理页,拷贝数据到内核。
- 内核在 Server 进程的 proc->binder_alloc 中分配 新的 buffer ,并为其分配物理页,即用户空间虚拟地址映射物理页。
- 内核根据 新的 buffer的起始地址 反推出对应的物理页,通过 kmap 写入数据,并返回新 buffer 的用户虚拟地址给 Server。
- Binder驱动已经把用户虚拟地址映射到物理页,Server 直接读返回的用户虚拟地址2 得到数据。
【回复阶段:Server → Client】
- Server Parcel 的 buffer 用户虚拟地址 → 内核通过 kmap 临时映射到同一物理页,拷贝数据到内核。
- 内核在 Client 进程的 proc->binder_alloc 中分配 新的 buffer ,并为其分配物理页,即用户空间虚拟地址映射物理页。
- 内核根据 新的 buffer的起始地址 反推出对应的物理页,通过 kmap 写入数据,并返回新 buffer 的用户虚拟地址给 Client。
- Binder驱动已经把用户虚拟地址映射到物理页,Client 直接读返回的用户虚拟地址 得到数据。
Native + Framework层
关键:Parcel 并不自己拷贝数据,而是把 buffer 地址交给驱动。
请求阶段:
客户端发送
Parcel 具体事务数据在的堆地址 变成 BC_TRANSACTION + tr[payload]
//客户端
//BpBinder::transact
//	IPCThreadState::transact
//		writeTransactionData: 把数据写入 mOut
//		waitForResponse
//			talkWithDriver 发起实际ioctl
status_t BpBinder::transact(
    uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags)
{
    IPCThreadState* state = IPCThreadState::self();
    // 委托给 IPCThreadState
    return state->transact(mHandle, code, data, reply, flags);
}

status_t IPCThreadState::transact(int32_t handle, uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags)
{
    // ... flags |= TF_ACCEPT_FDS;
    if (err == NO_ERROR) {
        //👇 准备要发送的命令 + tr + payload
        err = writeTransactionData(BC_TRANSACTION, flags, handle, code, data, nullptr);
    }
    // ...
    waitForResponse(reply)
}

status_t IPCThreadState::writeTransactionData(int32_t cmd, uint32_t binderFlags,
    int32_t handle, uint32_t code, const Parcel& data, status_t* statusBuffer)
{
    binder_transaction_data tr;
    //填充payload的相关数据...

    // 关键⭐⭐⭐⭐⭐⭐⭐⭐:将 Parcel 的 payload 地址 & 大小填入 tr 👈
    const status_t err = data.errorCheck();
    if (err == NO_ERROR) {
        tr.data_size = data.ipcDataSize();         // payload 字节数
        tr.data.ptr.buffer = data.ipcData();       // payload 起始地址(在 mmap 内存中)
        tr.offsets_size = data.ipcObjectsCount() * sizeof(size_t);
        tr.data.ptr.offsets = data.ipcObjects();   // flat_binder_object 偏移表
    } else { /* 错误处理 */ }

    // 将 `cmd (BC_TRANSACTION)` 和 `tr` 写入 mOut 缓冲区
    mOut.writeInt32(cmd);
    mOut.write(&tr, sizeof(tr));
    return NO_ERROR;
}

//IPCThreadState::transact → IPCThreadState::waitForResponse
status_t IPCThreadState::waitForResponse(Parcel *reply, status_t *acquireResult)
{
    while (1) {
        if ((err = talkWithDriver()) < NO_ERROR) break; // 👈 核心通信
        // ... 从 mIn 读取回复
        cmd = (uint32_t)mIn.readInt32();
        switch (cmd) {}
    }
}

//IPCThreadState::waitForResponse → talkWithDriver
status_t IPCThreadState::talkWithDriver(bool doReceive)
{
    binder_write_read bwr;
    bwr.write_size = mOut.dataSize();
    bwr.write_buffer = (uintptr_t)mOut.data(); // 👈 指向 mOut 中的 BC_TRANSACTION + tr

    if (doReceive) {
        bwr.read_size = mIn.dataCapacity();
        bwr.read_buffer = (uintptr_t)mIn.data(); // 👈 指向接收缓冲区
    }

    // 👇 最终系统调用,将命令+数据发给 /dev/binder
    status_t err = ioctl(mProcess->mDriverFD, BINDER_WRITE_READ, &bwr);
    // ... 更新 mOut/mIn 的读写位置
}
驱动copy
BC_TRANSACTION + tr[payload] 变成 work + buffer
//内核在 Client 进程的 binder_alloc 中分配新的 buffer与物理页,得到其用户虚拟地址(新 buffer 起始地址)。
//内核根据该用户地址反推出对应的物理页,通过 kmap 写入数据,并返回新 buffer 的用户虚拟地址给 Client。
//也就是executeCommand中的tr.data.ptr.buffer!!!!!!!!!!!

//经过binder_ioctl ➡️ binder_ioctl_write_read ➡️ binder_thread_write ➡️ binder_transaction
static void binder_transaction(struct binder_proc *proc,
               struct binder_thread *thread,
               struct binder_transaction_data *tr, int reply){
    //根据各种判定,获取以下信息:
    struct binder_proc *target_proc;    //目标进程
    struct list_head *target_list;      //目标进程TODO队列
    ...
    //指向用户空间mmap区的buffer 的指针
    const void __user *user_buffer =
    (const void __user *)(uintptr_t)tr->data.ptr.buffer;

    //分配两个结构体内存
    struct binder_transaction *t = kzalloc(sizeof(*t), GFP_KERNEL);
    struct binder_work *tcomplete = kzalloc(sizeof(*tcomplete), GFP_KERNEL);

    //关键⭐⭐⭐⭐👉 t->work被投递,t->work可以还原整个t,因此可以读到t->buffer
    //从target_proc分配一块buffer,分配的是 目标进程的用户空间mmap区内存,且分配了物理页
    t->buffer = binder_alloc_new_buf(
        &target_proc->alloc,
        tr->data_size,
		tr->offsets_size,
        extra_buffers_size,
		!reply && (t->flags & TF_ONE_WAY));

	//驱动在内核态 把数据 拷贝 从 Client 用户空间 → Server 内核空间:
   	//分多次处理:先拷贝offsets 数组,开启循环:提取单个flat object处理,再提取普通数据

    //拷贝 offsets 数组(事务数据) 到 当前进程的buffer
    //除了这个方法外还可能会用到 所以 to buffer
    if (binder_alloc_copy_user_to_buffer(
				&target_proc->alloc,
				t->buffer,
				ALIGN(tr->data_size, sizeof(void *)),
				(const void __user *) (uintptr_t)tr->data.ptr.offsets,
				tr->offsets_size)){}


    //遍历 offsets,处理内嵌对象(核心!!!)
    //对每个 flat_binder_object 做转换

    //data 区中,普通字节:直接拷 flat_binder_object:需要先读出来 → 处理 → 再写回
	//所以内核在:上一个对象末尾 ~ 下一个对象起始 之间,调用拷贝普通数据
    for (buffer_offset = off_start_offset; buffer_offset < off_end_offset;
	     buffer_offset += sizeof(binder_size_t)) {
        //...

        //拷贝用户buffer内的 offsets数组[x]  到 当前内核
        if(binder_alloc_copy_from_buffer(
            			  &target_proc->alloc,
						  &object_offset,
						  t->buffer,
						  buffer_offset,
						  sizeof(object_offset))){}


        if (copy_size && (user_offset > object_offset ||
				object_offset > tr->data_size ||
				//拷贝 普通数据(事务数据)到 当前进程的buffer
				binder_alloc_copy_user_to_buffer(
					&target_proc->alloc,
					t->buffer,
                    user_offset,
					user_buffer + user_offset,
					copy_size))){}


    }


    //向目标进程的target_list添加BINDER_WORK_TRANSACTION事务
    t->work.type = BINDER_WORK_TRANSACTION;
    list_add_tail(&t->work.entry, target_list);

    //向当前线程的todo队列添加BINDER_WORK_TRANSACTION_COMPLETE事务
    tcomplete->type = BINDER_WORK_TRANSACTION_COMPLETE;
    list_add_tail(&tcomplete->entry, &thread->todo);
    if (target_wait)
        // 唤醒目标线程
        wake_up_interruptible(target_wait);
    return;
}
服务端读取、驱动转发请求
work + buffer 变成 BR_TRANSACTION + tr[payload]
数据转换发生在驱动转发请求,但是这个转换需要服务端读取触发。
//IPCThreadState::joinThreadPool :无限循环
//		getAndExecuteCommand
//			talkWithDriver 执行ioctl,直到收到BR_
//--------------切换到驱动
//binder_ioctl ➡️ binder_ioctl_write_read ➡️ binder_thread_read

void IPCThreadState::joinThreadPool(bool isMain)
{
    do {
        //调用了 talkWithDriver excuteCommand
        result = getAndExecuteCommand();
    } while (...);
}


status_t IPCThreadState::getAndExecuteCommand()
{
    status_t result;
    int32_t cmd;

    //进行ioctl 交换 BC_/BR_
    result = talkWithDriver();
    //先看talkWithDriver函数
    //...
}

//与驱动交互 结果是:驱动BR_ + tr[payload] 会写入bwr.read_buffer
status_t IPCThreadState::talkWithDriver(bool doReceive) {
    binder_write_read bwr;

    do {
        //陷入系统调用 进入 binder_ioctl() 传递bwr
        //进入binder_thread_read
        err = ioctl(fd, BINDER_WRITE_READ, &bwr);
    } while (err == -EINTR);

    if (err >= 0) {
		//...
        return NO_ERROR; //talkWithDriver 出口
    }
    return err; //talkWithDriver 出口

}

//-------------------------------------------------------------------------
//触发数据转换关键:需要服务端也执行ioctl,才能到驱动处理work⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐

// binder_ioctl ➡️ binder_ioctl_write_read ➡️ binder_thread_read
// 驱动(使用IPCThreadState对应的线程) 处理BINDER_WORK_TRANSACTION事务
// 也就是 处理驱动 copy的客户端 而生成的 work + buffer
static int binder_thread_read(struct binder_proc *proc,
                              struct binder_thread *thread,
                              binder_uintptr_t binder_buffer,
                              size_t size,
                              binder_size_t *consumed,
                              int non_block){

    //buffer mmap区起始地址
    void __user *buffer = (void __user *)(uintptr_t)binder_buffer;
    //上次写入 + 起始地址 = 这次要写入的起始地址
	void __user *ptr = buffer + *consumed
    //结束地址
	void __user *end = buffer + size;


    while (1) {
        //当&thread->todo和&proc->todo都为空时,goto到retry标志处等待,否则往下执行:
        struct binder_transaction_data_secctx tr;
		struct binder_transaction_data *trd = &tr.transaction_data;
        struct binder_work *w = NULL;
		struct list_head *list = NULL;
        size_t trsize = sizeof(*trd);

        //从队列取事务
        w = binder_dequeue_work_head_ilocked(list);

        switch (w->type) {
            case BINDER_WORK_TRANSACTION: {
                //关键⭐⭐⭐⭐⭐ 👉把 work 还原成 transaction 对象
				binder_inner_proc_unlock(proc);
				t = container_of(w, struct binder_transaction, work);
			}
        }


        //work处理:简化版,只张贴了BINDER_WORK_TRANSACTION相关逻辑

        //返回 BR_TRANSACTION / BR_REPLY
        if (t->buffer->target_node) {
			struct binder_node *target_node = t->buffer->target_node;
			trd->target.ptr = target_node->ptr;
			trd->cookie = target_node->cookie;
			binder_transaction_priority(thread, t, target_node);
			cmd = BR_TRANSACTION;
		} else {
			trd->target.ptr = 0;
			trd->cookie = 0;
			cmd = BR_REPLY;
		}

        //binder_transaction_data trd,填充trd 并拷贝给用户空间
        //注意:t是事务的上下文,描述谁发给谁,事务数据在哪个地址
        //trd是事务的具体数据的相关数据,描述具体数据的大小、在哪个地址

        trd->data_size = t->buffer->data_size;
		trd->offsets_size = t->buffer->offsets_size;
		trd->data.ptr.buffer = t->buffer->user_data;
		trd->data.ptr.offsets = trd->data.ptr.buffer +
					ALIGN(t->buffer->data_size,
					    sizeof(void *));
        trsize = sizeof(tr)

        // 往read_buffer(在堆上)写入 BR_TRANSACTION 或 BR_REPLY
        put_user(cmd, (uint32_t __user *)ptr);

        ptr += sizeof(uint32_t);
        // 往read_buffer BR_TRANSACTION 或 BR_REPLY之后写上 tr

        // tr的trd已经被填充完成
		// 关键⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐:
        // 👇 从内核空间拷贝 tr 结构体(~64 字节)到用户空间,
        // 用户空间收到后,直接读 tr.data.ptr.buffer 获取事务具体数据(零拷贝)
        copy_to_user(ptr, &tr, trsize);

		ptr += trsize;

        // 允许用户调用 BC_FREE_BUFFER 释放 t结构体
        // (t->buffer->transaction 指向 t,标明这个buffer在被t使用)
        t->buffer->allow_user_free = 1;

    }
}
服务端处理
BR_TRANSACTION + tr[payload] 变成 Parcel 指向payload在的buffer地址
驱动转发结束后,继续执行服务端getAndExecuteCommand的下一步,服务端处理。
//IPCThreadState::joinThreadPool() →
//getAndExecuteCommand() →
//		talkWithDriver() : 收到 `BR_TRANSACTION` 命令。
//		executeCommand(BR_TRANSACTION) : 调用 `BBinder::transact`。

//驱动转发结束后,继续执行服务端`getAndExecuteCommand`的下一步executeCommand
status_t IPCThreadState::getAndExecuteCommand()
{
    status_t result;
    int32_t cmd;

    //进行ioctl 交换 BC_/BR_
    result = talkWithDriver();
    //talkWithDriver函数结束后
    //------------------------------------------------------------

    //读一个 BR_
    cmd = mIn.readInt32();
	// 真正处理
    result = executeCommand(cmd);

    return result;
}

//处理在 服务端的 bwr.read_buffer(即mIn) 读出的 BR_TRANSACTION 命令
status_t IPCThreadState::executeCommand(int32_t cmd)
{
    switch (cmd) {
        case BR_TRANSACTION:
        {
            binder_transaction_data tr;
            result = mIn.read(&tr, sizeof(tr)); // 👈 1. 从 mIn 读出事务元数据

            //客户端发来的,经过驱动转发
            Parcel buffer;
            // 👇 2. 让 Parcel 直接引用用户空间的mmap区虚拟地址
            // 因为驱动拷贝到了 用户空间的mmap区虚拟地址 对应的 物理页上
            buffer.ipcSetDataReference(
                reinterpret_cast<const uint8_t*>(tr.data.ptr.buffer),
                tr.data_size,
                reinterpret_cast<const size_t*>(tr.data.ptr.offsets),
                tr.offsets_size / sizeof(size_t),
                freeBuffer, this
            );

			// 从这里开始算回复阶段!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
            // ⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐
            // 👇 3. 调用 BBinder::transact → BnXXX::onTransact
            // BBinder::transact 使用buffer Parcel里的数据
			sp<BBinder> b((BBinder*)tr.target.ptr);
  			const status_t error = b->transact(tr.code, buffer, &reply, tr.flags);

            // 4. 如果不是 ONE_WAY,就 sendReply
            sendReply(reply, 0);
            break;
        }
    }
}
回复阶段:
服务端回复
Parcel 具体事务数据在的堆地址 变成 BC_REPLY + tr[payload]
//IPCThreadState::joinThreadPool() →
//getAndExecuteCommand() →
//		talkWithDriver() : 收到 `BR_TRANSACTION` 命令。
//		executeCommand(BR_TRANSACTION) 🌟服务端处理到此结束

//服务端回复开始
//IPCThreadState::executeCommand
//		BBinder::transact
//			BnXXX::onTransact :将结果写入 `reply`
//		sendReply :reply被写入 mOut
//			waitForResponse
//				talkWithDriver :进行ioctl,发送回复
status_t IPCThreadState::executeCommand(int32_t cmd)
{
    switch (cmd) {
        case BR_TRANSACTION:
        {
			Parcel reply; //回复的具体事务数据 具体在BBinder transact中被设置

			// 从这里开始算回复阶段!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
            // ⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐
            // 👇 调用 BBinder::transact → BnXXX::onTransact
			sp<BBinder> b((BBinder*)tr.target.ptr);
  			const status_t error = b->transact(tr.code, buffer, &reply, tr.flags);

            // 如果不是 ONE_WAY,就 sendReply
            sendReply(reply, 0);
            break;
        }
    }
}

status_t BBinder::transact(
    uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags)
{
    switch (code) {
        default:
            // 【核心】转发调用,子类服务对象自己的实现
            err = onTransact(code, data, reply, flags);
            break;
    }
}

// 伪代码示例:自定义服务
status_t MyService::onTransact(uint32_t code, const Parcel& data, Parcel* reply, uint32_t flags) {
    switch(code) {
        case MY_CODE: {
            int32_t a = data.readInt32();
            int32_t b = data.readInt32();
            //往 reply 写入数据
            reply->writeInt32(a + b);
            return NO_ERROR;
        }
    }
}

status_t IPCThreadState::sendReply(const Parcel& reply, uint32_t flags)
{
    status_t err;
    status_t statusBuffer;
    //reply 被写入到 mOut
    err = writeTransactionData(BC_REPLY, flags, -1, 0, reply, &statusBuffer);
    if (err < NO_ERROR) return err;
	//进入talkWithDriver,调用ioctl
    return waitForResponse(nullptr, nullptr);
}
驱动copy
BC_REPLY + tr[payload] 变成 work + buffer
//内核在 Client 进程的 binder_alloc 中分配新的 buffer与物理页,得到其用户虚拟地址(新 buffer 起始地址)。
//内核根据该用户地址反推出对应的物理页,通过 kmap 写入数据,并返回新 buffer 的用户虚拟地址给 Client。
//也就是executeCommand中的tr.data.ptr.buffer!!!!!!!!!!!

//经过binder_ioctl ➡️ binder_ioctl_write_read ➡️ binder_thread_write ➡️ binder_transaction
static void binder_transaction(struct binder_proc *proc,
               struct binder_thread *thread,
               struct binder_transaction_data *tr, int reply){
	//重复上面的 驱动copy

}
驱动转发回复、客户端读取
work + buffer 变成 BR_REPLY + tr[payload]
数据转换发生在驱动转发回复,但是这个转换需要客户端触发。
//客户端发送时:
//BpBinder::transact
//	IPCThreadState::transact
//		writeTransactionData: 把数据写入 mOut
//		waitForResponse 无限循环调用talkWithDriver
//			talkWithDriver 发起实际ioctl

//客户端已经无限循环在waitForResponse,一直执行talkWithDriver直到返回BR_REPLY 或者 error
//如果是TF_ONE_WAY 异步调用 则不会等待,快速返回
status_t IPCThreadState::talkWithDriver(bool doReceive) {
    binder_write_read bwr;

    do {
        //陷入系统调用 进入 binder_ioctl() 传递bwr
        //内核会:解析 bwr.write_buffer 里的:BC_
		//处理后,把返回命令写入 bwr.read_buffer:BR_
		//更新:bwr.write_consumed、bwr.read_consumed
        err = ioctl(fd, BINDER_WRITE_READ, &bwr);
    } while (err == -EINTR);

    if (err >= 0) {
		//...
        return NO_ERROR; //talkWithDriver 出口
    }
    return err; //talkWithDriver 出口
}

//-------------------------------------------------------
//接下来看看驱动是如何转发回复数据的
//触发数据转换关键:客户端已经无限循环在waitForResponse,一直执行talkWithDriver,调用ioctl
// 到驱动处理work⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐
// binder_ioctl ➡️ binder_ioctl_write_read ➡️ binder_thread_read

// 驱动(使用IPCThreadState对应的线程) 处理BINDER_WORK_TRANSACTION事务
// 也就是处理:驱动 copy的客户端 而生成的 work + buffer
static int binder_thread_read(struct binder_proc *proc,
                              struct binder_thread *thread,
                              binder_uintptr_t binder_buffer,
                              size_t size,
                              binder_size_t *consumed,
                              int non_block){

    //buffer mmap区起始地址
    void __user *buffer = (void __user *)(uintptr_t)binder_buffer;
    //上次写入 + 起始地址 = 这次要写入的起始地址
	void __user *ptr = buffer + *consumed
    //结束地址
	void __user *end = buffer + size;


    while (1) {

        struct binder_transaction_data_secctx tr;
		struct binder_transaction_data *trd = &tr.transaction_data;
        struct binder_work *w = NULL;
		struct list_head *list = NULL;
        size_t trsize = sizeof(*trd);

        //从队列取work
        w = binder_dequeue_work_head_ilocked(list);

        switch (w->type) {
            case BINDER_WORK_TRANSACTION: {
                //关键⭐⭐⭐⭐⭐ 👉把 work 还原成 事务上下文t
				binder_inner_proc_unlock(proc);
				t = container_of(w, struct binder_transaction, work);
			}
        }


        if (!t) //不是BINDER_WORK_TRANSACTION,那么t就为null,继续循环
			continue;

        //根据事务上下文t 生成 BR 命令:BR_TRANSACTION / BR_REPLY
        //在binder_transaction中,如果不是BC_REPLY,那么事务上下文t->buffer->target_node不可能为空
        if (t->buffer->target_node) {
			struct binder_node *target_node = t->buffer->target_node;
			trd->target.ptr = target_node->ptr;
			trd->cookie = target_node->cookie;
			binder_transaction_priority(thread, t, target_node);
			cmd = BR_TRANSACTION;
		} else {
        	//BC_REPLY 生成的 事务上下文,会走到这
			trd->target.ptr = 0;
			trd->cookie = 0;
			cmd = BR_REPLY;
		}

        //binder_transaction_data trd,填充trd 并拷贝给用户空间
        //注意:t是事务的上下文,描述谁发给谁,事务数据在哪个地址
        //trd是事务的具体数据的相关数据,描述具体数据的大小、在哪个地址

        trd->data_size = t->buffer->data_size;
		trd->offsets_size = t->buffer->offsets_size;
        //这里data.ptr.buffer 已经指向 用户空间mmap区中buffer的起始地址了
		trd->data.ptr.buffer = t->buffer->user_data;
		trd->data.ptr.offsets = trd->data.ptr.buffer +
					ALIGN(t->buffer->data_size,
					    sizeof(void *));
        trsize = sizeof(tr)

        // 使用系统函数 往用户空间mmap区写入 BR_REPLY
        put_user(cmd, (uint32_t __user *)ptr);

        // 指针移动到BR_REPLY之后
        ptr += sizeof(uint32_t);


        // tr的trd已经被填充完成
		// 关键⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐:
        // 👇 使用系统函数,从内核空间拷贝 tr 结构体(~64 字节)到用户空间,
        // 用户空间收到后,直接读 tr.data.ptr.buffer 获取事务具体数据(零拷贝)
        copy_to_user(ptr, &tr, trsize);

		ptr += trsize;

        // 允许用户调用 BC_FREE_BUFFER 释放 事务上下文t结构体
        // (buffer->transaction 指向 t,标明这个buffer在被t使用)
        t->buffer->allow_user_free = 1;

    }
}
客户端处理
BR_REPLY + tr[payload] 变成 Parcel 指向payload在的buffer地址
//talkWithDriver触发的binder_thread_read结束了,返回到waitForResponse
status_t IPCThreadState::waitForResponse(Parcel* reply, status_t* acquireResult){
    while (1) {
        // talkWithDriver结束 BR_REPLY + tr[payload] 被写入到 mIn
        if ((err=talkWithDriver()) < NO_ERROR) break;

        if (mIn.dataAvail() == 0)
            continue;

        uint32_t cmd = mIn.readInt32();
        //处理传回来的BR_REPLY + tr[payload]
        switch (cmd) {

            case BR_REPLY: {
                binder_transaction_data tr;
                //读取服务端回复的,经过驱动转发的BR_REPLY + tr[payload]
                mIn.read(&tr, sizeof(tr));

                //ipcSetDataReference() 并不拷贝数据
                //而是让 Parcel 直接指向驱动返回的 buffer地址
                //并注册freeBuffer回调,在Parcel析构时通知驱动释放这块 buffer。
                reply->ipcSetDataReference(
                    (uint8_t*)tr.data.ptr.buffer,
                    tr.data_size,
                    (binder_size_t*)tr.data.ptr.offsets,
                    tr.offsets_size / sizeof(binder_size_t),
                    freeBuffer);

                return NO_ERROR;
            }
        }
    }
	return err;
}
ServiceManager的启动 (Context Manager)(Framework)
main
int main(int argc, char** argv) {
    android::base::InitLogging(argv, android::base::KernelLogger);

    const char* driver = argc == 2 ? argv[1] : "/dev/binder";

    sp<ProcessState> ps = ProcessState::initWithDriver(driver);
    ps->setThreadPoolMaxThreadCount(0);
    ps->setCallRestriction(ProcessState::CallRestriction::FATAL_IF_NOT_ONEWAY);

    IPCThreadState::self()->disableBackgroundScheduling(true);

    sp<ServiceManager> manager = sp<ServiceManager>::make(std::make_unique<Access>());
    manager->setRequestingSid(true);
    if (!manager->addService("manager", manager, false /*allowIsolated*/, IServiceManager::DUMP_FLAG_PRIORITY_DEFAULT).isOk()) {
        LOG(ERROR) << "Could not self register servicemanager";
    }

    IPCThreadState::self()->setTheContextObject(manager);
    if (!ps->becomeContextManager()) {
        LOG(FATAL) << "Could not become context manager";
    }

    sp<Looper> looper = Looper::prepare(false /*allowNonCallbacks*/);

    sp<BinderCallback> binderCallback = BinderCallback::setupTo(looper);
    ClientCallbackCallback::setupTo(looper, manager, binderCallback);

    while(true) {
        looper->pollAll(-1);
    }

    // should not be reached
    return EXIT_FAILURE;
}
获取ServiceManager (Framework)
获取 ServiceManager 对象采用单例模式,当gDefaultServiceManager存在,则直接返回,否则创建一个新对象。
[[clang::no_destroy]] static sp<IServiceManager> gDefaultServiceManager;

sp<IServiceManager> defaultServiceManager()
{
    //使用 C++11 的 线程安全一次性初始化机制。
	//gSmOnce 是一个全局的 std::once_flag 变量。
	//保证 lambda 表达式中的初始化代码在整个程序生命周期中只执行一次,即使多线程并发调用
    //确保 ServiceManager 代理的 单例性 和 初始化原子性
    std::call_once(gSmOnce, []() {
        gDefaultServiceManager = sp<CppBackendShim>::make(getBackendUnifiedServiceManager());
    });
    return gDefaultServiceManager;
}

sp<BackendUnifiedServiceManager> getBackendUnifiedServiceManager() {
    std::call_once(gUSmOnce, []() {

//等待 servicemanager.ready 属性
//确保 servicemanager 进程(/system/bin/servicemanager)已经启动并 ready
//避免客户端进程早于 servicemanager 启动,导致 getContextObject(nullptr) 返回空。
#if defined(__BIONIC__) && !defined(__ANDROID_VNDK__)
        /* wait for service manager */ {
            using std::literals::chrono_literals::operator""s;
            using android::base::WaitForProperty;
            while (!WaitForProperty("servicemanager.ready", "true", 1s)) {
                ALOGE("Waited for servicemanager.ready for a second, waiting another...");
            }
        }
#endif
        //循环获取 AidlServiceManager
        sp<AidlServiceManager> sm = nullptr;
        while (sm == nullptr) {
            //调用 ProcessState::self()->getContextObject(nullptr) 获取 handle=0 的 ServiceManager 的远程代理。
			//使用 interface_cast<AidlServiceManager>(...) 将其转换为 AIDL 接口。
            sm = interface_cast<AidlServiceManager>(
                    ProcessState::self()->getContextObject(nullptr));
            if (sm == nullptr) {
                //若失败(返回 nullptr),sleep 1s 后重试。
                //在启动初期(如 zygote 启动时),
                //Binder 驱动可能还未将 ServiceManager 注册到 handle 0,因此需重试。
                sleep(1);
            }
        }
        gUnifiedServiceManager = sp<BackendUnifiedServiceManager>::make(sm);
    });
    return gUnifiedServiceManager;
}

void setDefaultServiceManager(const sp<IServiceManager>& sm) {
    bool called = false;
    std::call_once(gSmOnce, [&]() {
        gDefaultServiceManager = sm;
        called = true;
    });
    if (!called) {
        LOG_ALWAYS_FATAL("setDefaultServiceManager() called after defaultServiceManager().");
    }
}
注册服务(Framework)
获取服务(Framework)
参考
https://gityuan.com/2015/11/01/binder-driver/
https://gityuan.com/2015/11/02/binder-driver-2/
https://oacia.dev/android-binder/
- C/C++ 语法
- Binder
- 参考