
Android IPC 笔记
Binder
Binder Diver
场景:App 调用系统服务获取电池电量。
int level = batteryService.getBatteryLevel();
App 进程(Client)向 SystemServer 进程中的 BatteryService(Server)发起一次 Binder IPC。
结构体
struct binder_proc —— 每个进程的 Binder 上下文
Binder 为**每个加入 Binder 世界的 进程 **都建立一个“代表”。
你可以把 binder_proc(process) 理解为“一个进程在 Binder 世界里的根容器”,所有属于此进程的 Binder 信息都存放在这里。
用户进程有一个 binder_proc,服务进程也有一个 binder_proc。
**每当一个 Android 应用或系统进程第一次调用 ioctl 访问 Binder 驱动时,内核就会为它创建一个 binder_proc 结构体,用来记录这个进程所有和 Binder 相关的状态。**该结构体被加入全局链表 binder_procs,以便驱动全局管理。
在此例子中
| 角色 | 结构体 | 说明 |
|---|---|---|
| App 进程(Client) | binder_proc A | 存放自己持有的 binder 对象引用、待处理事务、buffer 等 |
| SystemServer(Server) | binder_proc B | 包含 BatteryService 在 Binder 世界里的真正实体对象binder_node |
struct binder_thread —— 每个线程的通信上下文
为每个执行 ioctl(BINDER_WRITE_READ) 的线程创建的通信上下文,用于记录调用栈、待办任务和线程状态。
线程是负责:
- 发送事务(client 线程)
- 从 todo 队列取事务(transaction)并执行(server 线程)
在此例子中:
客户端:App main thread 或 Binder proxy 调用线程 → binder_thread A1
服务端:SystemServer 中 在 Binder 线程池中的线程 → binder_thread B1
struct binder_node —— Server对象在驱动中的唯一实体
你看到的每个系统服务(如 BatteryService)都有一个对应的 AIDL。
AIDL 编译器生成两个关键类:
| 生成物 | 所处进程/位置 | 作用 |
|---|---|---|
| Stub | 服务端(SystemServer) | binder_node的实际注册者(extends Binder) |
| Proxy | 客户端(App) | 代理,将 “handle + 参数数据” 提交给Binder驱动,驱动再转发给 Stub |
BatteryService 对应的 Binder 对象(Stub),当进程把这个对象第一次注册进 Binder 驱动时,驱动为它创建:
binder_node(Server对象在驱动中的唯一实体)
代表“这个对象真正长什么样,它真正属于哪个进程”。
注意:binder_node 在它所属的进程(Server )中创建,挂在其struct binder_proc下;
一个 Server 进程可能同时提供 多个不同的 Binder 服务对象。例如:
ActivityManagerService对象(ptr = 0x1000)PackageManagerService对象(ptr = 0x2000)
当 Server 的 Binder 线程调用 ioctl(BINDER_WRITE_READ) 读取数据时,Server会从驱动获取到 ptr 和 cookie,然后Server判断需要调用哪个服务对象来提供服务。
struct binder_ref —— 对远程服务对象的引用
客户端(Client)看到的是 binder_ref(引用),而不是 binder_node 本身。
binder_ref(指向服务端 binder_node 的引用)
引用中记录:
- 指向真实 binder_node
- 分配给
Client的 handle(如 handle=3)
所以Client看到的是一个计数器 handle,而驱动内部通过 binder_ref 再找到 binder_node。
Java 层的 IBinder 代理对象底层就是 handle。
struct binder_buffer —— 存放一次事务的数据
当客户端要调用:
getBatteryLevel(参数)
需要把参数序列化(Parcel)写进一个临时的“buffer”。
在进程在open("/dev/binder")初始化时,Binder 驱动会在进程的内核空间分配一块连续区域vm_struct,再在进程的用户空间分配一块连续区域vm_area_struct,两者同时映射到同一个物理页上。
当 Binder 驱动在内核态处理 BC_TRANSACTION 时,会为目标 Server 进程的 mmap 区(创建)分配一个 binder_buffer,然后调用 copy_from_user,将 Client 用户空间的数据拷贝到目标 Server 进程 buffer 所映射的物理页上。由于该物理页同时映射到 Server 的用户空间和内核空间,Server 可直接读取,实现高效 IPC。
binder_buffer 用于存放一次事务的数据。
包括:
- *transaction:指向该缓冲区关联的 binder_transaction 事务上下文
- *target_node:指向需要使用该缓冲区的 binder_node 提供实际服务的Server对象实体
- data_size:transaction 数据的大小。
- offsets_size:offsets 数组的大小。
buffer 属于哪个进程? ——属于事务目标进程的 binder_proc
Binder 驱动为每个进程 mmap 一片连续的虚拟地址区域,binder_buffer 就位于这片区域内。
| 项目 | Request | Reply |
|---|---|---|
| 发起方 | Client | Server |
| 接收方 | Server | Client |
binder_transaction |
1 个 | 1 个(另一个) |
binder_buffer |
挂在 Server 的 proc上,分配在Server内核虚拟空间中 |
挂在 Client 的 proc上,分配在Client内核虚拟空间中 |
| 物理页 | Server 的内核、用户mmap区对应的物理页 | Client 的内核、用户 mmap区 对应的物理页 |
因为 在单次事务(request 或 reply)内部,Client/Server 共享同一物理页:
- 比如 request:Client 数据 → 拷贝到 Server 的 buffer 对应的物理页 → Server 直接读;
- 这个过程中,没有第二次拷贝,所以叫“一次拷贝”。
但 request 和 reply 是两个方向的独立事务,各自有自己的接收方,因此:
- 两个 buffer
- 两块物理内存
- 两次
copy_from_user(一次 request,一次 reply)
struct binder_transaction —— 一次事务的完整上下文
binder_transaction方法,构造一个事务对象binder_transaction
包含:
- 发送端线程(from= binder_thread A1)
- 接收端进程、接收端线程(to_proc = binder_thread B,to_thread = 指定或空)
- 使用哪个 buffer(binder_buffer X)
- 事务码(code,AIDL 定义的方法编号,例如 TRANSACTION_getBatteryLevel)
其他结构体
| 结构体 | 说明 |
|---|---|
| flat_binder_object | 描述在 Binder IPC 过程传递的特殊对象 |
| binder_write_read | 描述存储读写操作(是描述操作:要写读的地址、大小) |
| binder_version | 描述 Binder 的版本号 |
| transaction_flags | 描述事务的 flag,例如是否是异步请求,是否支持 fd |
| binder_transaction_data | 描述一次事务数据的相关数据 |
驱动核心方法
binder_mmap
static int binder_mmap(struct file *filp, struct vm_area_struct *vma)
//binder_mmap(文件描述符,用户虚拟内存空间)
*vma是指向用户虚拟内存mmap区的结构体指针。
在内核虚拟地址空间,申请一块与用户虚拟内存mmap区相同大小的内存(不超过4MB);然后再申请只有1个page大小的物理内存(后续会增加),再将这同一块物理内存分别映射到内核虚拟地址空间和用户虚拟内存空间,从而实现了用户空间的Buffer和内核空间的Buffer同步操作的功能。
同时计算了user_buffer_offset,其是同一进程下,虚拟用户mmap区地址与虚拟内核mmap区地址的差值(该值为负数)。
这个offset用于定位数据:
假设kadd是内核虚拟内存mmap区开始地址,uadd是用户虚拟内存mmap区开始地址,offset=uadd-kadd。驱动把事务数据写入Server内核虚拟地址时,写入某个特定的地址kaddd,那么由于两个mmap区是映射同一个物理页,因此用户地址uaddd=kaddd+offset上就有事务数据。
binder_ioctl
最频繁调用的函数。
//ioctl(文件描述符,ioctl命令,用户操作相关数据)
static long binder_ioctl(struct file *filp, unsigned int cmd, unsigned long arg){

    thread = binder_get_thread(proc);

    switch (cmd) {
        case BINDER_WRITE_READ:
            ret = binder_ioctl_write_read(filp, cmd, arg, thread);
            if (ret)
                goto err;
            break;
    }
}
不同的命令对应可能不同的数据类型。
BINDER_WRITE_READ命令最常见,会调用binder_ioctl_write_read函数。
binder_get_thread
从binder_proc中查找binder_thread,如果当前线程已经加入到proc的线程队列则直接返回,如果不存在则创建binder_thread,并将当前线程添加到当前的proc。
binder_ioctl_write_read
static int binder_ioctl_write_read(struct file *filp,
                unsigned int cmd, unsigned long arg,
                struct binder_thread *thread){

    void __user *ubuf = (void __user *)arg;
    struct binder_write_read bwr;
    //拷贝ubuf到内核bwr,不对用户指针负责
    if (copy_from_user(&bwr, ubuf, sizeof(bwr))) {
        ret = -EFAULT;
        goto out;
    }

    if (bwr.write_size > 0) {
        //当写缓存有空间,则执行binder写操作
        ret = binder_thread_write(proc, thread,
                      bwr.write_buffer, bwr.write_size, &bwr.write_consumed);
        trace_binder_write_done(ret);
        //...
    }
    if (bwr.read_size > 0) {
        //当读缓存有空间,则执行binder读操作
        ret = binder_thread_read(proc, thread,
                      bwr.read_buffer, bwr.read_size, &bwr.read_consumed,
                      filp->f_flags & O_NONBLOCK);
        trace_binder_read_done(ret);
        if (!list_empty(&proc->todo))
            wake_up_interruptible(&proc->wait); //唤醒等待状态的线程
		//...
    }

}
arg是一个binder_write_read结构体。
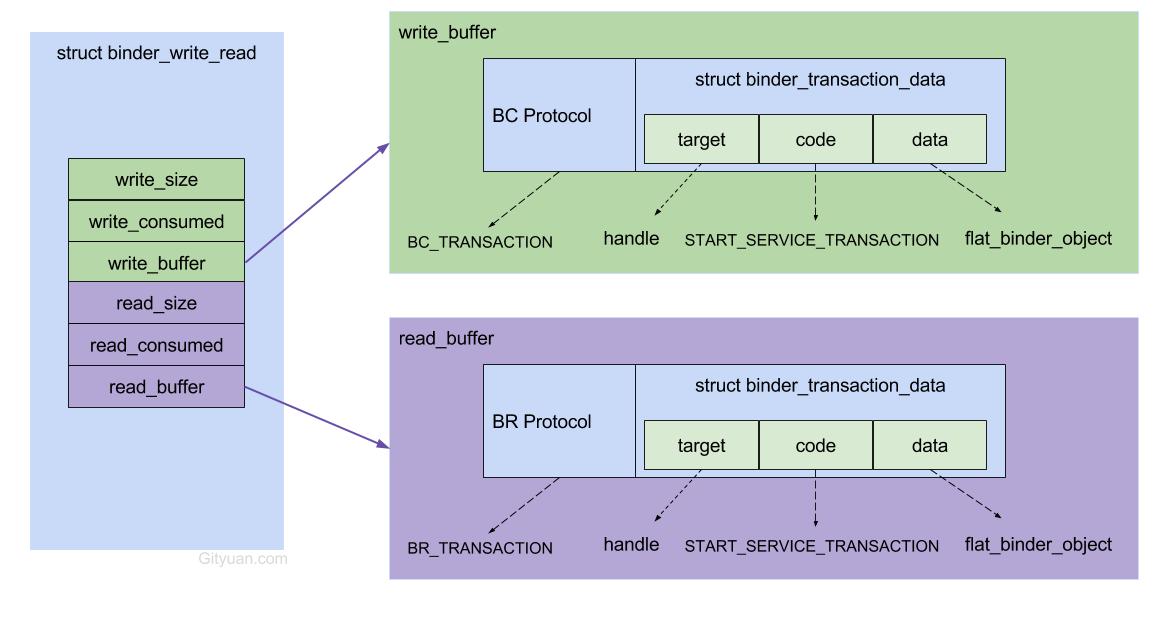
在命令之后,会跟一个 struct binder_transaction_data 结构体。
| 问题 | 答案 |
|---|---|
write_buffer/read_buffer 在哪? |
用户虚拟地址空间,通常由 malloc 分配(在堆上) |
| 命令流如何带结构体? | 命令码(4B) + binder_transaction_data(64B)连续存放 |
| 事务数据也在其中吗? | 不在! 事务数据在 binder_transaction_data.ptr.buffer 指向的另一块用户内存 |
| 内核如何解析? | 通过指针偏移,命令码固定4B大小。 |
流程:
bwr.write_size>0 代表写缓存有空间,可以调用 binder_thread_write(),
bwr.read_size>0 则代表读缓存有空间,可以调用 binder_thread_read(),
若都大于 0 则先写入,后读取。
最后,把bwr拷贝回到用户ubuf,告知消费完,或是没有消费完需要重试。
通信码
Binder驱动通过制定一系列的通信码,形成了协议,分为两类:
BINDER_COMMAND_PROTOCOL:binder请求码,以”BC_“开头,简称BC码,用于从进程层传递到Binder Driver层;BINDER_RETURN_PROTOCOL:binder响应码,以”BR_“开头,简称BR码,用于从Binder Driver层传递到进程层;
binder_thread_write
static int binder_thread_write(struct binder_proc *proc,
                               struct binder_thread *thread,
                               //注意这里binder_buffer 是在当前进程用户空间的堆上
                               //命令区buffer
                               binder_uintptr_t binder_buffer,
                               size_t size,
                               binder_size_t *consumed){
    //循环
    while (ptr < end && thread->return_error == BR_OK) {
        //获取write_buffer数据中的Binder通信码(BC码)
        get_user(cmd, (uint32_t __user *)ptr);
        switch (cmd) {
            //...
            //注意这里BC_TRANSACTION、BC_REPLY都会调用binder_transaction
            //Client 调用 transact() → 发送 BC_TRANSACTION
            //Server 调用 reply() → 发送 BC_REPLY
            case BC_TRANSACTION:
            case BC_REPLY:
                struct binder_transaction_data tr;
                // 拷贝tr用户空间到内核
                // 一次性拷贝整个 binder_transaction_data
                // 注意tr结构体只是描述了事务数据的相关数据
                // 真正的数据在tr结构体中的:
                // data.ptr.buffer 和 data.ptr.offsets 是 用户空间mmap指针,指向真正的事务数据。
                if (copy_from_user(&tr, ptr, sizeof(tr)))
                    return -EFAULT;
                ptr += sizeof(tr);  //移动指针,跳过tr结构体,下次循环直接处理命令
                binder_transaction(proc, thread, &tr, cmd == BC_REPLY);
                break;
			//...
            }
        }
    }
}
binder_transaction
static void binder_transaction(struct binder_proc *proc,
               struct binder_thread *thread,
               struct binder_transaction_data *tr, int reply){
    //根据各种判定,获取以下信息:
    struct binder_thread *target_thread; //目标线程
    struct binder_proc *target_proc;    //目标进程
    struct binder_node *target_node;    //目标binder节点
    struct list_head *target_list;      //目标进程TODO队列
    wait_queue_head_t *target_wait;     //目标等待队列
    ...

    //分配两个结构体内存
    struct binder_transaction *t = kzalloc(sizeof(*t), GFP_KERNEL);
    struct binder_work *tcomplete = kzalloc(sizeof(*tcomplete), GFP_KERNEL);
    //从target_proc分配一块buffer,分配的是 目标进程的内核虚拟空间内存
    t->buffer = binder_alloc_buf(target_proc, tr->data_size, tr->offsets_size, is_async);

    //这是唯一一次 copy_from_user(对具体的事务数据)
	//驱动在内核态 把数据 拷贝 从 Client 用户空间 → Server 内核空间
    if (copy_from_user(t->buffer->data, (void __user *)(uintptr_t)tr->data.ptr.buffer, tr->data_size))
    goto err_copy_data_failed;

	if (copy_from_user(offp, (void __user *)(uintptr_t)tr->data.ptr.offsets, tr->offsets_size))
    goto err_copy_data_failed;

    //遍历 offsets,处理内嵌对象(核心!!!)
    //对每个 flat_binder_object 做跨进程转换
    for (; offp < off_end; offp++) {
        switch (fp->type) {
        case BINDER_TYPE_BINDER:
                //如果是 BINDER_TYPE_BINDER(一般是Server → Client)
                //binder_node 转 handle
                //binder_node 强引用计数增加
        case BINDER_TYPE_WEAK_BINDER: //weak reference走这里
        case BINDER_TYPE_HANDLE: ...
            	//如果是 BINDER_TYPE_HANDLE(一般是Client → Server)
            	//handle要么处理为本地binder_node,要么处理为另一个handle(目标在其他进程)
            	//binder_node 强引用计数增加
        case BINDER_TYPE_WEAK_HANDLE: //weak reference走这里
        case BINDER_TYPE_FD: //同一个文件描述符 FD 跨进程传递
        }
    }

    //设置事务上下文
    if (!reply && !(tr->flags & TF_ONE_WAY)) {
        // 同步调用需记录调用方
        t->from = thread;
        t->from_parent = thread->transaction_stack;
        // 压入调用栈
        thread->transaction_stack = t;
        //阻塞,需要等待回复(need_reply=1)
        t->need_reply = 1;
    } else if (tr->flags & TF_ONE_WAY) {
        //无需回复(TF_ONE_WAY),走 async_todo 队列
        t->async_transaction = 1;
        if (target_node->has_async_transaction)
            target_list = &target_node->async_todo; // 异步队列
    }

    //向目标进程的target_list添加BINDER_WORK_TRANSACTION事务
    t->work.type = BINDER_WORK_TRANSACTION;
    list_add_tail(&t->work.entry, target_list);

    //向当前线程的todo队列添加BINDER_WORK_TRANSACTION_COMPLETE事务
    tcomplete->type = BINDER_WORK_TRANSACTION_COMPLETE;
    list_add_tail(&tcomplete->entry, &thread->todo);
    if (target_wait)
        // 唤醒目标线程
        wake_up_interruptible(target_wait);
    return;
}
binder_transaction后续流程:
事务投递后,不会立即执行,而是放入目标线程/进程的 todo 队列,等待 目标进程主动调用 ioctl(BINDER_WRITE_READ) 触发处理,走一遍binder_ioctl_write_read -> binder_ioctl_write/read。
补充
struct binder_transaction_data {
	//...
    union {
        struct {
            binder_uintptr_t buffer;    /* ← 关键:事务数据起始地址 */
            binder_uintptr_t offsets;   /* ← 指向对象偏移数组 */
        } ptr;
        __u8 buf[8]; /* 小事务可直接内联(不常用) */
    } data;
};
tr.data.ptr.buffer:在用户虚拟空间mmap区中这一次事务数据起始地址(比如 Parcel 序列化后的字节流)
tr.data.ptr.offsets:偏移数组(binder_size_t[]),每个元素是一个相对于 buffer 起始位置的偏移量,主要标识特殊的对象。
假设你发送一个 Parcel,内容是:
Parcel p = new Parcel();
p.writeString("Hello");
p.writeStrongBinder(myService); // ← 这是一个 IBinder 对象!
p.writeFileDescriptor(fd);     // ← 这是一个 FD!
放入buffer中内存布局
[buffer 起始地址]
│
├─ 0x00: "Hello\0"              ← 普通字符串
├─ 0x08: flat_binder_object{    ← IBinder 对象(16 字节)
│        .type = BINDER_TYPE_BINDER,
│        .binder = 0x12345678,  ← Server 本地指针
│        .cookie = 0xabcdef00
│      }
├─ 0x18: flat_binder_object{    ← FD 对象
│        .type = BINDER_TYPE_FD,
│        .handle = 10            ← 当前进程 fd=10
│      }
需要构造一个 offsets 数组:
offsets[0] = 0x08;  // 表示 0x08 处是一个 flat_binder_object
offsets[1] = 0x18;  // 表示 0x18 处也是一个 flat_binder_object
binder_thread_read
static int binder_thread_read(struct binder_proc *proc,
                              struct binder_thread *thread,
                              binder_uintptr_t binder_buffer,
                              size_t size,
                              binder_size_t *consumed,
                              int non_block){

    //根据wait_for_proc_work,来决定wait在哪个等待队列
    wait_for_proc_work = (thread->transaction_stack == NULL) && list_empty(&thread->todo);

    if (wait_for_proc_work) {
        // 等待 proc->todo(全局队列)
        ret = wait_event_freezable_exclusive(proc->wait, ...);
    } else {
        // 等待 thread->todo(线程私有队列)
        ret = wait_event_freezable(thread->wait, ...);
    }

    //从 todo 队列取 work
    if (!list_empty(&thread->todo))
        w = list_first_entry(&thread->todo, ...);
    else if (!list_empty(&proc->todo) && wait_for_proc_work)
        w = list_first_entry(&proc->todo, ...);

    while (1) {
        //当&thread->todo和&proc->todo都为空时,goto到retry标志处等待,否则往下执行:
        struct binder_transaction_data tr;
        struct binder_transaction *t = NULL;
        switch (w->type) {
            case BINDER_WORK_TRANSACTION:
                //binder_transaction 投递的事务在这这里处理!!!
                //返回 BR_TRANSACTION / BR_REPLY
                if (t->buffer->target_node) {
                    //这次事务是发送给Server的,后续可能需要回复
                    tr.target.ptr = target_node->ptr;
                    tr.cookie = target_node->cookie;
                    cmd = BR_TRANSACTION;
                } else {
                    //这次事务是回复给Client的
                    tr.target.ptr = 0;
                    tr.cookie = 0;
                    cmd = BR_REPLY;
                }

                //填充 binder_transaction_data tr 并返回给用户空间
                //注意:t是事务的上下文,描述谁发给谁,事务数据在哪个地址
                //tr是事务的具体数据的相关数据,描述具体数据的大小、在哪个地址
                tr.code = t->code;
                tr.flags = t->flags;
                tr.data_size = t->buffer->data_size;
                tr.data.ptr.buffer = (uintptr_t)t->buffer->data + proc->user_buffer_offset;
                // 往read_buffer(在堆上)写入 BR_TRANSACTION 或 BR_REPLY
                put_user(cmd, (uint32_t __user *)ptr);
                // 从内核空间拷贝 tr 结构体(~64 字节)到用户空间(没拷贝事务具体数据),用户空间收到后,直接读 tr.data.ptr.buffer 获取事务具体数据(零拷贝)
                ptr += sizeof(uint32_t);
                // 往read_buffer BR_TRANSACTION 或 BR_REPLY之后写上 tr
                copy_to_user(ptr, &tr, sizeof(tr));

                // 从 todo 队列移除,表示处理完这个事务
                list_del(&t->work.entry);
                // 允许用户调用 BC_FREE_BUFFER 释放 t结构体
                // (t->buffer->transaction 指向 t,标明这个buffer在被t使用)
                t->buffer->allow_user_free = 1;

                if (cmd == BR_TRANSACTION && !(t->flags & TF_ONE_WAY)) {
                    // cmd = BR_TRANSACTION可能需要回复
                    // 防止同步嵌套调用:把t压入栈
                    // 如果是嵌套,以便回复的顺序正确:
                    //1.Server 在处理Client的请求时,又同步调用了 Client 的某个方法(回调方法),那么Server需要先等待Client 回调方法的reply。
                    //2.A调用B的方法;B在处理中,又调用C的方法;先C回复B,B才能回复A
                    t->to_parent = thread->transaction_stack;
                    t->to_thread = thread;
                    thread->transaction_stack = t;
                } else {
                    // cmd已经是回复了 or 异步调用:直接释放 t结构体占的内存
                    t->buffer->transaction = NULL;
                    kfree(t);
                    binder_stats_deleted(BINDER_STAT_TRANSACTION);
                }

            case BINDER_WORK_TRANSACTION_COMPLETE:
                // binder_transaction 投递的事务在这这里处理!!!
                // 返回 BR_TRANSACTION_COMPLETE
                // 通知发送方:“你的 BC_TRANSACTION 已成功投递到目标进程”
            case BINDER_WORK_NODE:
                // 返回 BR_ACQUIRE / BR_RELEASE
                // 通知 Server:“有新的强引用,请保持对象存活”
            case BINDER_WORK_DEAD_BINDER:
                //返回BR_DEAD_BINDER
                //通知 Client:“你持有的远程对象已死亡”
            case BINDER_WORK_DEAD_BINDER_AND_CLEAR: ...
                case BINDER_WORK_CLEAR_DEATH_NOTIFICATION: ...
        }
        ...
    }
    done:
    *consumed = ptr - buffer;
    //当前 没有空闲线程(ready_threads == 0)
    //也没有 已请求但未启动的线程(requested_threads == 0)
    //且 已启动线程数 < 最大线程数(requested_threads_started < max_threads)
    //且当前线程是合法 Binder 线程(已注册)
    if (proc->requested_threads + proc->ready_threads == 0 &&
        proc->requested_threads_started < proc->max_threads &&
        (thread->looper & (BINDER_LOOPER_STATE_REGISTERED |
                           BINDER_LOOPER_STATE_ENTERED))) {
        proc->requested_threads++;
        // 生成BR_SPAWN_LOOPER命令,通知Server创建新线程处理todo队列
        put_user(BR_SPAWN_LOOPER, (uint32_t __user *)buffer);
    }
    return 0;
}
case BINDER_WORK_TRANSACTION后续流程:
假定先在Server 进程的read_buffer写入了BR_TRANSACTION+tr。
Server 进程后续:
-
Server 进程的某一线程ioctl(BINDER_WRITE_READ, &bwr) 。
-
进入内核,驱动执行到
binder_thread_read():从todo队列取出BINDER_WORK_TRANSACTION事务,
驱动构造
BR_TRANSACTION命令和binder_transaction_data tr结构体到 Server进程read_buffer。 -
Server进程中代码执行
BBinder::onTransact()处理read_buffer,构造回复数据。 -
驱动将数据写入 Client 内核空间mmap区 。
-
Server进程执行ioctl,驱动在binder_transaction(..., reply=1) 构造 binder_transaction(其内部
t->buffer->target_node == NULL,表示是 reply)和BINDER_WORK_TRANSACTION事务,将其加入 Client 原始调用线程的thread->todo队列。 -
唤醒阻塞在
thread->wait上的 Client 线程。
Client 进程后续:
-
Client 对应线程被唤醒,从
wait_event返回,驱动继续执行binder_thread_read() : -
从
thread->todo队列头部取出BINDER_WORK_TRANSACTION事务(其内部t->buffer->target_node == NULL,表示是 reply),判断
t->buffer->target_node == NULL,设置cmd = BR_REPLY,驱动构造
binder_transaction_data tr,将BR_REPLY和tr写入 Client 的bwr.read_buffer。 -
Client进程中的代码执行到
IPCThreadState::executeCommand(),从read_buffer解析出BR_REPLY和tr,直接读取Server 的回复数据(零拷贝)。 -
驱动还原出
binder_buffer结构体指针,释放内部引用,合并内存块回free_buffers。
小结
| 方法 | 创建的结构体 | 核心作用 |
|---|---|---|
binder_open |
binder_proc |
进程级上下文初始化 |
binder_mmap |
binder_buffer(初始) |
建立共享内存,零拷贝基础 |
BINDER_SET_CONTEXT_MGR |
binder_node(ServiceManager) |
注册全局服务管理器(内核驱动级别) |
binder_get_thread |
binder_thread |
线程级上下文初始化、获取 |
binder_thread_write |
(间接创建,调用binder_transaction方法) | 解析命令BC_XXX,处理部分事务或委托给binder_transaction |
binder_transaction |
binder_transaction, binder_work, (特定命令会创建binder_node、binder_ref) |
跨进程调用核心,来回传递事务数据,生成binder_work投递到todo队列 |
binder_thread_read |
主要是消费结构体 | 将binder_work转换为 BR_XXX 返回用户,拷贝binder_transaction到进程用户空间 |
BC_FREE_BUFFER |
无 | 安全释放内存,同步引用 |
binder_release |
无 | 进程退出,全局清理 |
参考
https://gityuan.com/2015/11/01/binder-driver/
https://gityuan.com/2015/11/02/binder-driver-2/